


Krátká verze
- Vzal jsem jeden skutečný issue z backlogu FlowHuntu a nechal jsem Claude Code implementovat ho 13krát na Opus 5.5 v sedmi různých nastaveních instrukcí. Každý běh začal ze stejného commitu, ve vlastním klonu s vlastní databází, a prošel naším skutečným GitHub CI. Každý výsledek ohodnotily dvě slepé recenze od Opusu.
- 33KB CLAUDE.md v repozitáři nepřinesl měřitelnou kvalitu. Běhy s ním měly 2,0 nálezů úrovně blocker a major na recenzi. Běh úplně bez souboru s instrukcemi měl stejně. Soubor o 5,5 KB měl 1,0.
- Samostatná fáze plánování všechno zhoršila. Obě nastavení, která nejprve spustila plánovací prompt a poté implementační, stála více než jejich dvojčata s prostým promptem a vyprodukovala čtyři z pěti blockerů ve všech 26 recenzích.
- Vítězem byl 8KB CLAUDE.md, tři skilly, pracovníci Sonnet a prostý prompt. Jeho dva běhy stály v průměru 6,68 USD při ceníkových cenách API. Plné nastavení s pipeline prompty stálo v průměru 11,49 USD, tedy asi 1,7krát více, a mělo více nálezů.
- Z celé struktury, kterou jsem vybudoval, přežilo zadání: krátký, rozhodnutý popis jednoho dílu práce, který hlavní model píše pro levnějšího pracovníka. Plány pro samotný hlavní model se nevyplatily. Model plánuje dobře sám.
Tento text navazuje na příspěvek o vzoru architect , který měřil, kdo by měl psát kód. Tento se ptá, kolik toho hlavnímu modelu musíme říct, než začne.
Proč jsem to spustil
Náš monorepo nasbíral spoustu instrukcí pro agenty. Kořenový CLAUDE.md měl 33 KB: příkazy pro build, kadenci testů, styl kódu, architekturu, kritické cesty, bezpečnostní pravidla, pravidla pro oprávnění a kredity, obě agentní rozhraní, zakládání issue, konvence pro PR. Deset skillů leželo v .claude/skills/. K tomu navíc náš CI pipeline (říkáme mu harnext) proháněl issue přes tagger, krok triage, krok plánování, který psal plán jako komentář k issue, a krok implementace, který plán načetl zpět a napsal kód — každý s vlastním dlouhým systémovým promptem.
Každý řádek z toho přibyl z nějakého důvodu, obvykle poté, co agent něco pokazil. Otázku, kterou si nikdo nepoložil, byla ta, jestli to ještě pomáhá. CLAUDE.md se načítá do každé session a znovu se posílá v každém tahu. Pokud by model udělal správnou věc i tak, jsou ty tokeny daň, a jak vysvětluje článek kolik skutečně stojí kontextové okno , daň za každý tah se nasčítá rychleji, než to vypadá.

Připraveni rozšířit své podnikání?
Začněte svou bezplatnou zkušební verzi ještě dnes a viďte výsledky během několika dní.
Test
Šlo o časově řízenou e-mailovou sekvenci pro nové registrace: administrátor definuje kroky jako “den 0: uvítání” a “den 5: vaše zkušební verze brzy skončí”, a úloha na pozadí pošle e-mail každému účtu ve správný den, zastaví se, jakmile si daný člověk koupí placený tarif, a přeskočí účty vytvořené před spuštěním. Potřebuje migraci, repozitář, službu, Celery beat úlohu, REST endpointy, MCP nástroje pro agenty a konzolové UI v 11 jazycích. To je realistická funkce na první týden a má několik okrajových případů, které se snadno přehlédnou.
Každý běh byla headless session Claude Code na Opus 5.5, uzavřená v sandboxu s vlastním klonem a databází, se skriptem, který poslal její commit do draft PR a vrátil výsledek CI zpět do session, maximálně ve třech kolech. Náklady jsou vlastní total_cost_usd Claude Code pro hlavní session plus každý subagent, oceněné podle ceníkových cen API. Platím předplatné, takže jde o měřítko práce, ne mého účtu.
Sedm nastavení:
| Nastavení | Běhy | |
|---|---|---|
| A | Plný 33KB CLAUDE.md a deset skillů, pipeline prompty (plán, pak implementace) | 2 |
| B | Plný CLAUDE.md a skilly, prostý prompt | 3 |
| C | Bez CLAUDE.md, bez skillů, prostý prompt | 2 |
| D | Plný CLAUDE.md plus skill architect, prostý prompt | 2 |
| E | 8KB CLAUDE.md, architect, grain-ponytail a unslop, pipeline prompty | 1 |
| F | 5,5KB CLAUDE.md, bez skillů, prostý prompt | 1 |
| G | 8KB CLAUDE.md, architect, grain-ponytail a unslop, prostý prompt | 2 |
A až D přišly první. E až G vznikly z toho, co ukázaly, a třetí běh B šel vedle nich jako kontrola. Soubor o 8 KB je ten o 5,5 KB plus krátký seznam skillů a toho, kdy je načíst, a pravidla směrování modelů, díky nimž skill architect deleguje na Sonnet.
Každý výsledek pak dostali dva recenzenti Opus, kteří viděli jen písmeno, diff, repozitář a issue. Vypsali každou změnu, kterou by požadovali před schválením, ohodnotili ji jako blocker, major, minor nebo nit a ověřili každé akceptační kritérium proti souboru a řádku.
Náklady
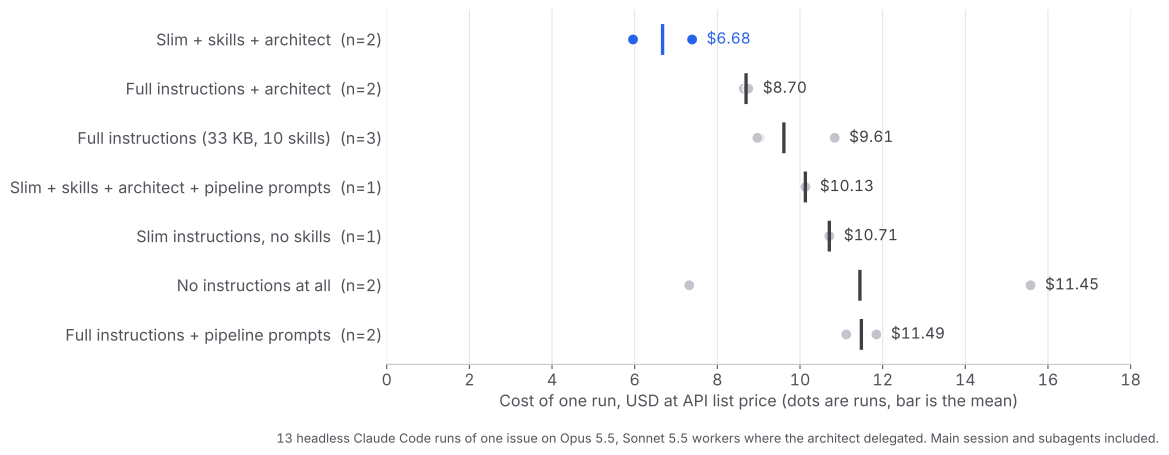
Vítězné nastavení G stálo 5,96 a 7,39 USD. Plné nastavení s pipeline prompty, A, stálo 11,12 a 11,85 USD. Rozdíl je většinou v počtu tahů a v tom, co každý tah nese. Hlavní session A běžely 172 a 144 tahů na Opusu s 24 až 28 miliony vstupních tokenů. G běžely 79 a 95 tahů s 13 až 16 miliony a předaly asi o 60 tahů více pracovníkům Sonnet, kteří účtují zlomek sazby. G také dokončilo práci asi za 21 minut proti 45 minutám u A.
Dvě věci na tomto grafu mě překvapily. Žádné instrukce vůbec nejsou levná varianta: její dva běhy stály 7,32 a 15,58 USD a ten dražší také neprošel CI a napsal největší diff v testu. A soubor o 5,5 KB bez skillů, F, nebyl levnější než plné nastavení. Napsal více kódu, 1 601 produktových řádků, a zaplatil za to. Úspora v G nepochází jen z krátkého souboru. Pochází z krátkého souboru plus dvou skillů, které mění způsob, jakým se práce dělá.
Přihlaste se k odběru newsletteru
Získejte nejnovější tipy, trendy a nabídky zdarma.
Kvalita
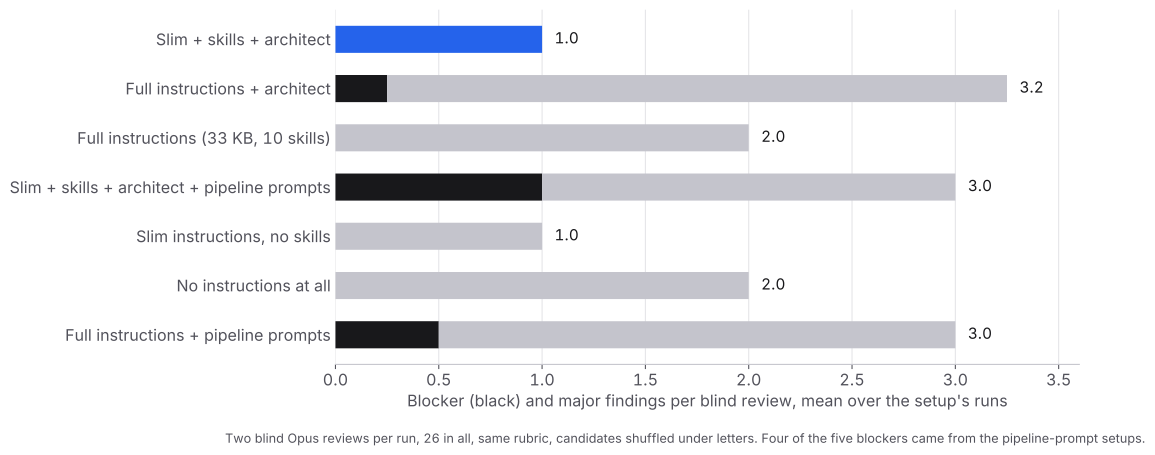
Nejlevnější nastavení mělo také nejméně závažných nálezů: žádné blockery a 1,5 a 0,5 major nálezů na recenzi ve svých dvou bězích. Plný CLAUDE.md, B, měl 2,0 major nálezů ve všech třech bězích, tedy stejně jako úplná absence CLAUDE.md.
Tohle je výsledek, který mě zajímá nejvíce. Soubor má dlouhé sekce o bezpečnosti, oprávněních a kreditech, napsané proto, že je jednou nějaký agent přeskočil. Se souborem i bez něj recenzenti našli stejný počet vážných problémů a napříč nastaveními se vracely stejné druhy: registrovaný uživatel, který zaplatí a pak zruší předplatné; e-mail, který se ztratí nebo odejde dvakrát, když pracovník selže v polovině; editor, který přepíše obsah, jenž nedokáže zobrazit. To jsou mezery v uvažování o stavu v čase. Žádný seznam pravidel v CLAUDE.md je nepokrýval, protože pravidlo pro okrajový případ, který jste ještě nepromysleli, napsat nelze.
Co je pokrylo, byla změna skillu architect mezi koly. Než hlavní model napíše jakékoli zadání, nyní sepíše tabulku: každé akceptační kritérium, co se stane, když se stav, na kterém závisí, v čase změní, a rozhodnuté chování. Každý řádek se pak dostane do zadání s pojmenovaným testem. Běhy G napsaly 774 a 818 řádků testů, proti 510 až 670 u B.
Fáze plánování
A a E jsou dvě nastavení, která spouštěla prompty našeho CI pipeline: plánovací prompt, který napíše plán, a pak implementační prompt, který plán načte a vykoná ho. Srovnejte každé z nich s jeho dvojčetem, které dostalo místo toho prostý prompt. A stálo 11,49 USD na běh proti 9,61 USD u B a mělo blockery tam, kde B nemělo žádné. E stálo 10,13 USD proti 6,68 USD u G a mělo blocker v každé své recenzi, zatímco G nemělo žádný.
Myslím, že důvod je ten, že plán je dokument, který model píše sám pro sebe a pak ho musí číst zpět jako vnější instrukci. Druhá session považuje plán za specifikaci, následuje ho i tam, kde je chybný, a utrácí tahy za jeho slaďování s tím, co najde v kódu. Takto schopný model plánuje lépe uvnitř session, která se chystá práci udělat, kde jsou plán i kód ve stejném kontextu.
Část plánování, která přežila, je zadání. Když hlavní model předá díl práce pracovníkovi Sonnet, pracovník začíná s prázdným kontextem a postaví přesně to, co mu bylo řečeno. To předání potřebuje písemný, rozhodnutý popis: cíl, soubory, vzor k napodobení, okrajové případy, test, který má napsat. Plán pro sebe sama je režie navíc. Zadání pro někoho jiného je jediný způsob, jak práci předat.
Co udělal grain-ponytail
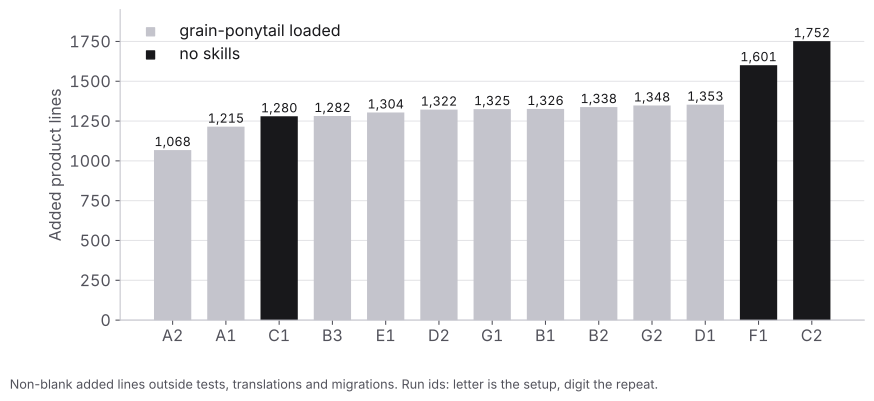
Skill z článku kód po vlákně říká modelu, aby napodobil nejbližší existující příklad a odevzdal co nejméně kódu, který funguje. Každý běh, který ho měl načtený, napsal mezi 1 068 a 1 353 produktovými řádky. Dva největší diffy, 1 601 a 1 752, přišly z běhů bez skillů. Jeden běh bez skillů zůstal na 1 280, takže skill neurčuje velikost sám o sobě, ale odstranil ten ocas.
Je to také nejjasnější případ toho, jaký druh instrukce se ještě vyplácí. “Napodob nejbližší příklad” mění to, co model dělá u každého souboru, který píše. “Používej snake_case pro funkce” jen opakuje něco, co už dělá.
Co recenze přesto odhalily
Vítězný běh nebyl čistý. Po testu jsem rebasoval práci G2 na main a prohnal ji naší plnou PR kontrolou, která recenzuje diff, dokazuje každý nález padajícím testem a projíždí změnu ve skutečném prohlížeči. Zjistila, že editor kroků zahodil každý blok kromě prvního HTML, když administrátor upravoval krok vytvořený přes MCP, a že neúspěšné uvolnění rezervace mohlo některým uživatelům poslat e-mail dvakrát. Obě chyby byly opraveny, s testy, než PR šel k lidské recenzi.
Slepí recenzenti také označili více over-engineeringu v bězích s architectem než v těch s plnými instrukcemi: 2,5 položky na recenzi u G proti 0 až 1,0 u běhů A a B. Méně vážných nálezů, více drobností. Ten obchod bych bral, ale je to obchod.
Co jsem změnil
- Z 33KB CLAUDE.md se stal 12KB AGENTS.md, který čte i Codex, a CLAUDE.md ho nyní jen importuje. Zachovává příkazy, kadenci testů, architekturu a pravidla, která model nemůže odvodit z kódu, jako které cesty jsou kritické a že obě agentní rozhraní musí zůstat v souladu.
- Fáze plánování z pipeline zmizela. Triage předá issue přímo do fáze implementace, jejíž prompt se zkrátil na šest kroků: přečti issue, založ branch, načti skilly architect a grain-ponytail, testuj, commitni, otevři draft PR.
- Skill architect dostal tabulku okrajových případů, pole Tests v zadání a závěrečný průchod, který kontroluje celý diff proti issue, nikoli proti zadáním. Ta verze je veřejná na github.com/LivinTribunal/architect-skill .
Změna v repozitáři je v době psaní v recenzi.
Co si z toho odnést
Pokud váš CLAUDE.md rostl incident po incidentu, pravděpodobně platíte za pravidla, která model už dodržuje. Zkraťte ho na to, co model nemůže zjistit čtením kódu, a měřte před a po na skutečném úkolu, místo abyste věřili, že více vedení je bezpečnější.
Ponechte instrukce, které mění způsob, jakým se práce dělá: kdo píše kód, jak se zadává díl práce, který existující vzor kopírovat. Zrušte pipeline plán-pak-vykonej, pokud je váš hlavní model současný špičkový. Pište zadání pro pracovníky, ne plány pro sebe.
Metoda
13 headless běhů Claude Code 2.1.289 dne 5. října 2026, hlavní model Opus 5.5, pracovníci Sonnet 5.5 tam, kde skill architect delegoval. Všechny běhy začaly z jednoho commitu monorepa FlowHunt, každý v APFS klonu s vlastní Postgres databází, v sandboxu odděleném od ostatních běhů i od souborů experimentu. Broker poslal commit každého běhu do draft PR proti zmrazené základní branch a obnovil session s výsledkem CI, maximálně ve třech kolech. Náklady jsou maximální total_cost_usd na session, sečtené za hlavní session a její subagenty. Produktové řádky jsou neprázdné přidané řádky mimo testy, překlady a migrace.
Každý výsledek dostal dvě slepé recenze od Opusu podle jedné rubriky: správnost, akceptační kritéria, vlákno, privátní pole a skrytý stav, over-engineering, bezpečnost a oprávnění, testy, migrace. Kandidáti byli promícháni pod písmeny a recenzenti mohli repozitář číst, ale ne nic spouštět. Nálezy na recenzi jsou zprůměrované přes běhy daného nastavení. Při jednom až třech bězích na nastavení berte průměr jednoho nastavení jako zašuměný. Výše uvedené závěry jsou ty, které obstály v obou kolech.
