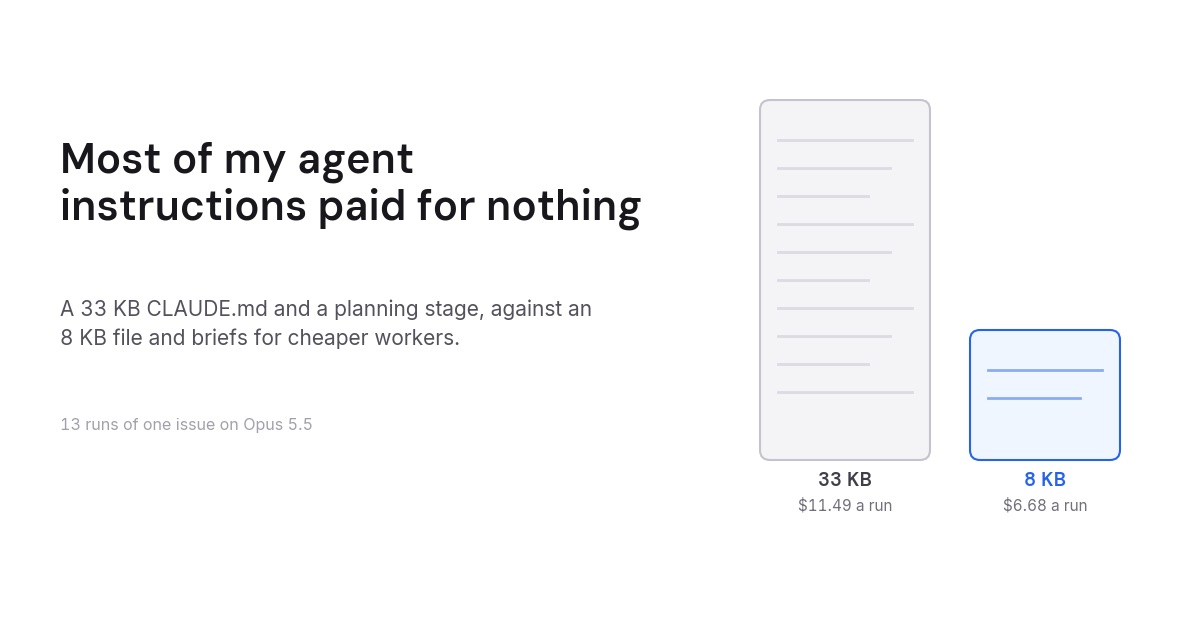
Jeg A/B-testede min kodeagents instruktioner. De fleste gav ingenting for pengene
Jeg kørte ét rigtigt issue 13 gange gennem Claude Code på Opus 5.5 med syv forskellige instruktionsopsætninger, med rigtig CI og blind bedømmelse. En CLAUDE.md ...
Štefan er en AI- og softwareingeniør, der bygger FlowHunt. Ud over selve produktet designer han agentic software-engineering workflows for udviklere, der reducerer udviklingskostnaderne, mens kodekvaliteten forbedres.


Jeg kørte ét rigtigt issue 13 gange gennem Claude Code på Opus 5.5 med syv forskellige instruktionsopsætninger, med rigtig CI og blind bedømmelse. En CLAUDE.md ...

AI-kodeagenter tilføjer. De skriver en anden helper ved siden af den første, et nyt lag ved siden af det eksisterende, en wrapper omkring en funktion der allere...

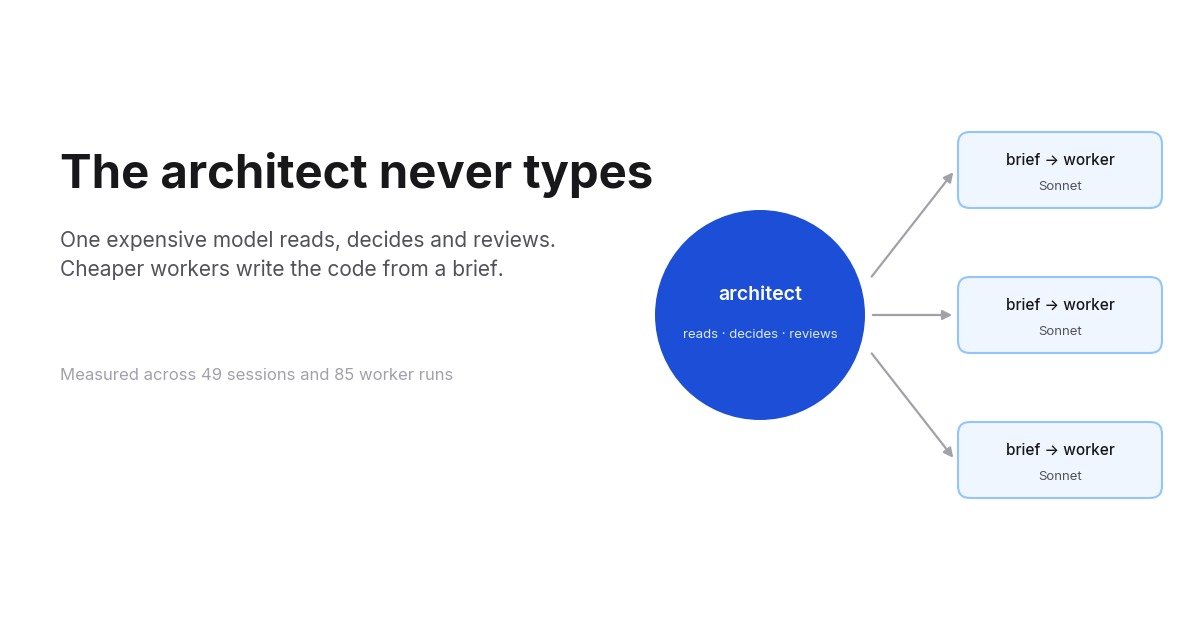
Jeg holdt op med at lade min dyreste model skrive kode. Den læser, beslutter, briefer en billigere worker og reviewer diffen. Fem uger og 49 sessioners transskr...

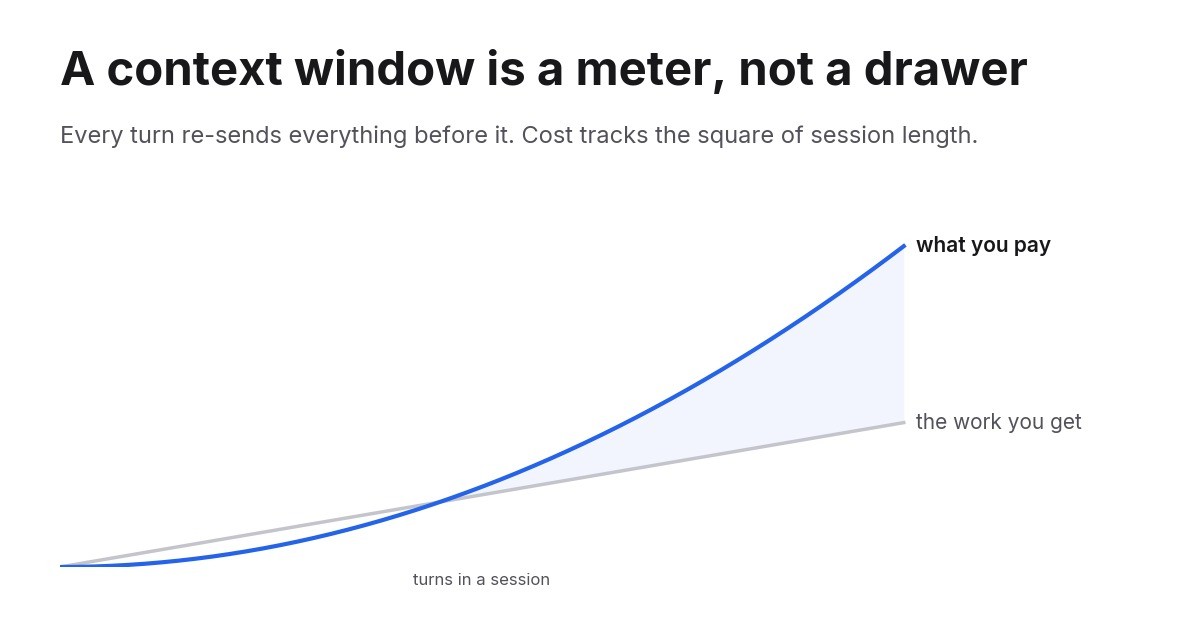
Et kontekstvindue er en løbende måler, ikke lagerplads. Hvad der fylder det, hvorfor en lang agentsession koster langt mere end det arbejde, den udfører, hvorda...

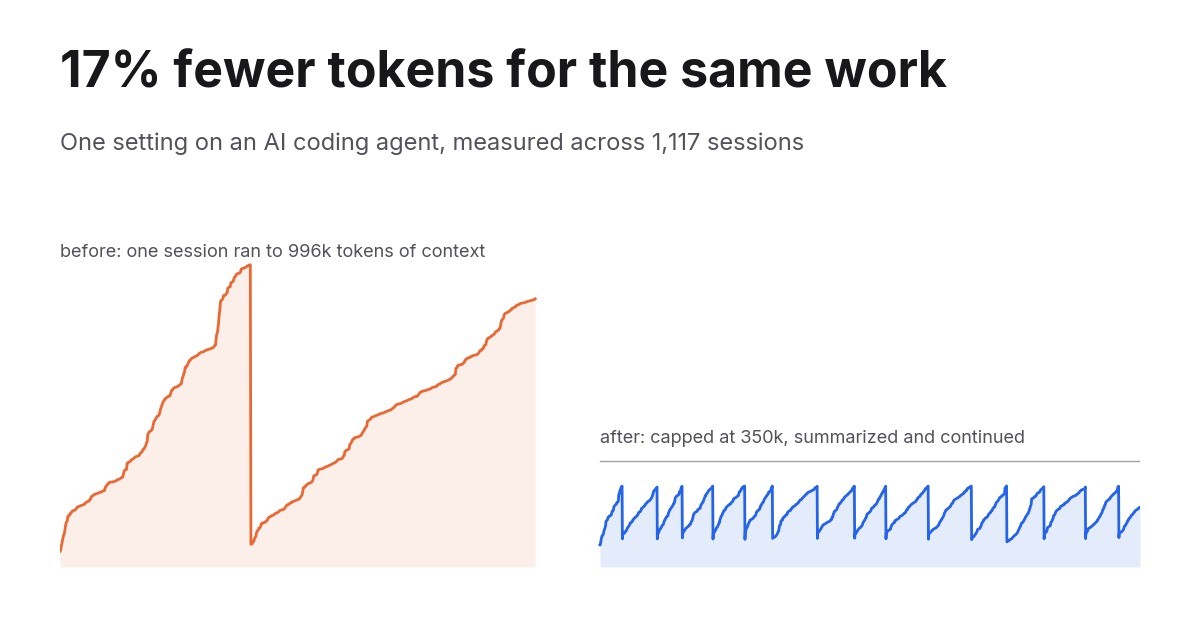
Jeg satte et loft over, hvor stor min AI-kodeagents kontekst måtte blive, og målte derefter resultatet på tværs af 1.117 sessionstranskriptioner. Samme antal pr...

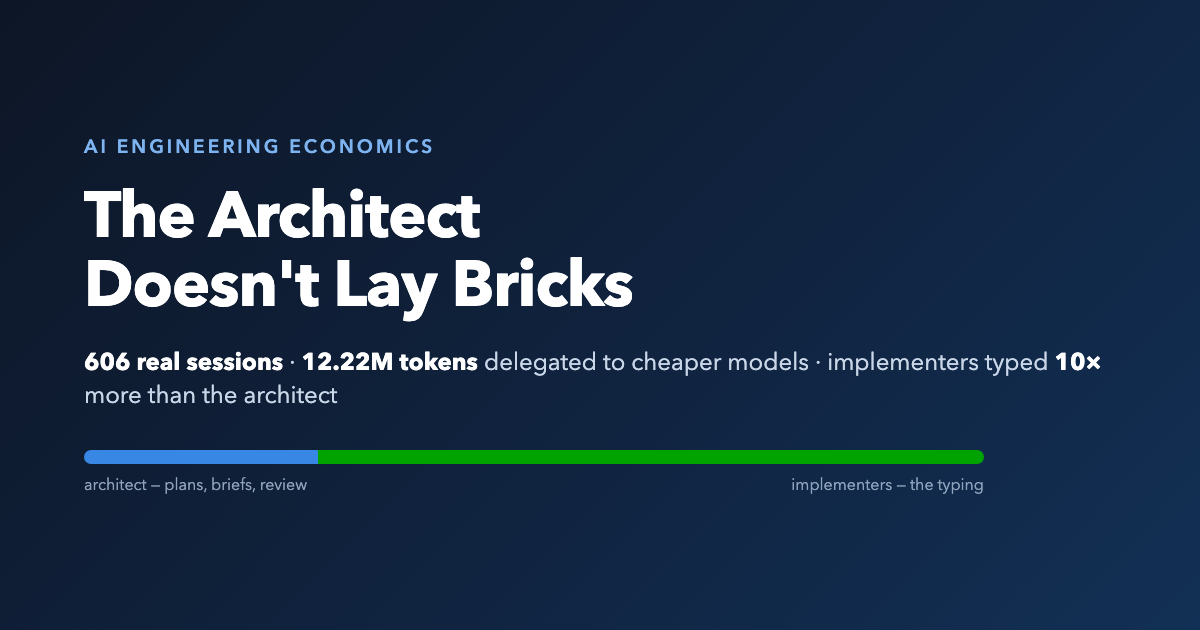
Vi forbød vores dyreste AI-model at skrive kode. Token-kvitteringer fra 606 rigtige sessioner viser, hvordan opdelingen mellem arkitekt og implementør skærer ne...

Ladt alene tilføjer AI-kodeagenter duplikering, drift og ubeviste rettelser. Tre komponerbare færdigheder fjernede 821 linjer på tværs af fem Tier-3-PR'er, mens...

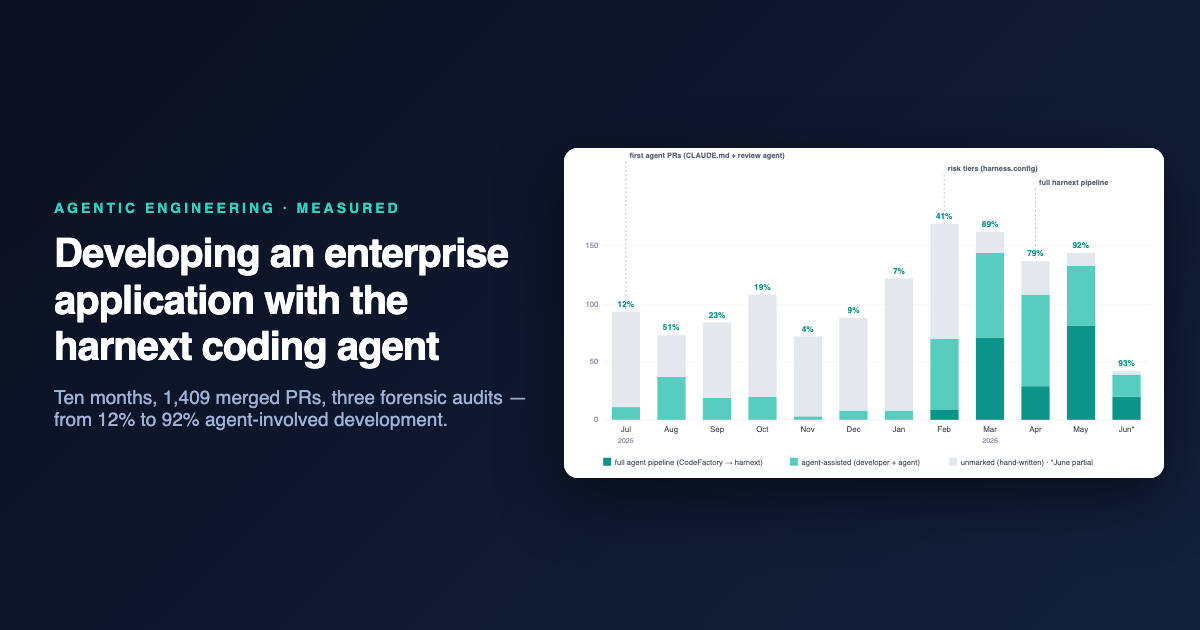
Ti måneder, 1.409 fusionerede PR'er, tre retsmedicinske revisioner: hvordan en trinvis agent-pipeline tog en enterprise-kodebas fra 12% til 92% agent-involveret...

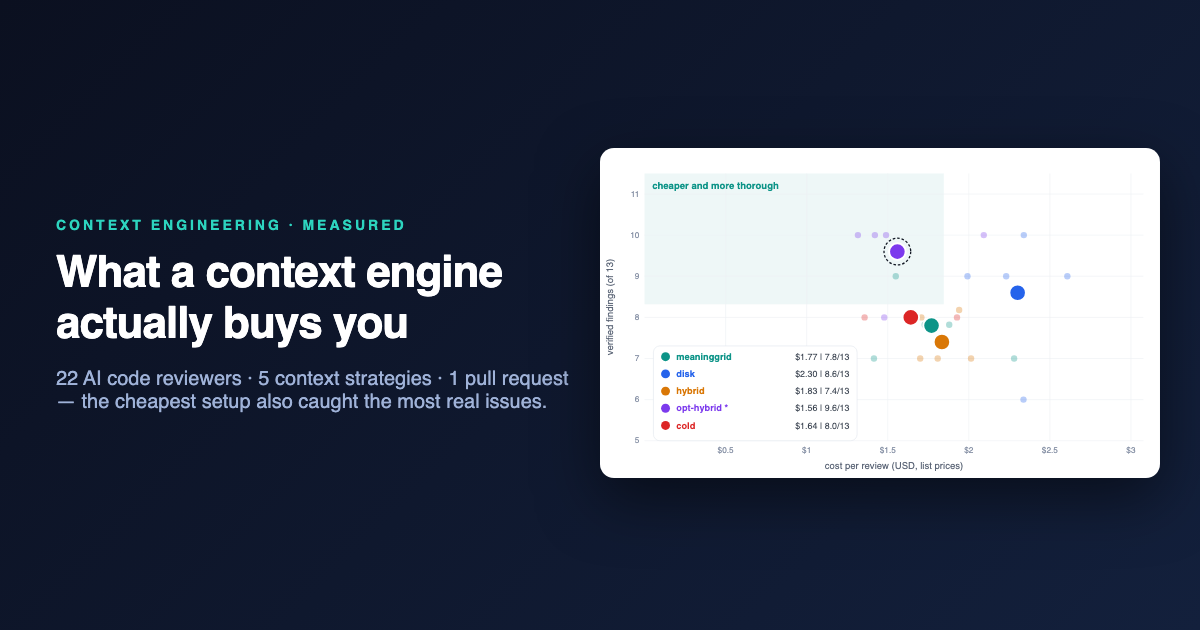
Samme pull request, samme prompt, samme model — kun kontekstindlæsningen var forskellig. En kontekstmotor-digest plus en politik-fil-læsning slog dokumentations...