


Den korte version
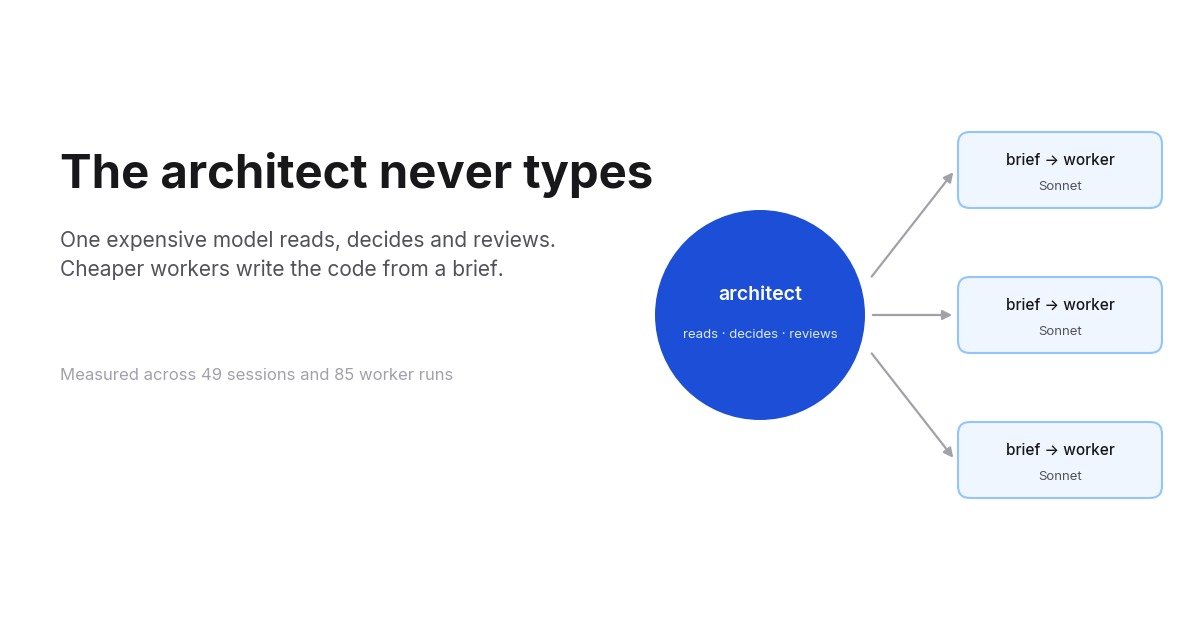
- I fem uger kørte jeg min coding agent i en opdeling: hovedmodellen, Opus og senere Fable, læser, beslutter og reviewer, og en worker-agent skriver koden ud fra en skriftlig brief. Jeg kalder det arkitektmønsteret, og det er nu en offentlig skill: architect-skill på GitHub , MIT-licenseret.
- Hovedmodellen holdt op med at skrive. På tværs af 49 arkitektsessioner redigerede den en kildefil 6 gange i 1.467 prompts. I 275 almindelige sessioner i de samme uger redigerede den 244 filer i 3.081 prompts. Det er 0,4 mod 7,9 pr. 100 prompts.
- Det samlede antal tokens pr. prompt faldt ikke. De steg, voldsomt, i to uger og kom derefter tilbage til det niveau, almindelige sessioner ligger på. Det, der ændrede sig, er, hvem der brugte dem: Opus’ andel af worker-tokens gik fra 100% til omkring 4%, og siden 14. september koster en prompt i en arkitektsession 364k vægtede tokens på hovedmodellen, 205k på Sonnet-workere og 80k på Opus-workere.
- Den opdeling er det, et abonnement interesserer sig for. Claude Max måler sin ugentlige grænse på tværs af alle modeller efter hver models sats, så et Sonnet-token trækker på den med 40% af et Opus-tokens sats, og Fable har sin egen, strammere ugentlige grænse, som ingen worker rører ved.
- Jeg prøvede også at rute workere til DeepSeek gennem en headless Claude Code. Regnet til listepris kostede den samme trafik $10 i stedet for $202 på Sonnet eller $505 på Opus. På et abonnement findes den besparelse ikke, fordi abonnementet allerede er betalt. Jeg droppede det. Hvis du betaler pr. token, så læs alligevel det afsnit, for tallene er pointen.
Dette er det tredje indlæg i en serie. Det første målte, hvad én indstilling gjorde ved et kontekstvindue, 17% færre tokens , og det andet forklarer hvad et kontekstvindue koster og hvorfor. Dette handler om den anden løftestang: ikke hvor stor konteksten er, men hvilken model der holder den.
Hvad mønsteret er
En coding agent-session udfører to slags arbejde. Den tænker: læser kodebasen, finder ud af, hvad der skal ændres, beslutter navne og signaturer og edge cases, tjekker diffen. Og den skriver: skriver koden, kører testfilen, retter lint. Det er tænkningen, hvor en frontier-model tjener sin pris. Det er skrivningen ikke. Det meste af den er bestemt af den beslutning, der kom før den, og en mindre model udfører en besluttet plan omtrent lige så godt som en stor.
Så skillen opdeler sessionen. Hovedmodellen er arkitekten. Den gør alt i hovedløkken undtagen at redigere en kildefil:
- Afhør kravet og udforsk kodebasen.
- Træf designbeslutningerne: tilgang, dataflow, navne, signaturer, edge cases. Det nærmeste eksisterende mønster at spejle. Den mindste ændring, der løser den egentlige årsag.
- Opdel i slices, der ejer disjunkte sæt af filer.
- Skriv én implementeringsbrief pr. slice.
- Review den diff, der kommer tilbage, kør gates, commit.
Workeren er en subagent med et frisk kontekstvindue. Den får briefen og intet andet, skriver koden, kører de testfiler, briefen nævner, og returnerer en kort struktureret rapport. Derefter smides dens kontekst væk. Den bliver aldrig en del af hovedsessionens historik, hvilket betyder mere, end det lyder som: alt, hvad hovedsessionen læser, sendes igen ved hvert efterfølgende kald, så en worker, der læser tolv filer og en testlog i sin egen kontekst, holder alt det væk fra arkitektens regning.
Briefen er hele kontrakten. Min har syv felter, og skillen handler mest om at udfylde dem godt:
## Implementation brief: <slice>
Goal: one sentence, observable outcome
Context: what exploration found: excerpts, the pattern to mirror, line anchors, gotchas
Files: paths to create/modify, exclusive ownership for this slice
Design: the decided approach: data flow, names, signatures, edge cases
Constraints: project rules that apply: style, layers, security
Out of scope: what not to touch, including files owned by other slices
Verify: exact commands and expected outcome
En brief indeholder beslutninger, ikke muligheder. Hvis jeg stadig afvejer to tilgange, er jeg ikke klar til at delegere.
Der er én undtagelse. Delegation har en fast overhead: at skrive briefen, worker-opstart, læse rapporten, reviewe diffen. En tastefejlrettelse, en konfigurationsværdi, en versionsbump, sletning af en død nøgle, en enkeltlinje-rettelse og dens regressionstest: dem redigerer arkitekten direkte, fordi briefen ville koste mere end redigeringen. Testen er omkostning, ikke antal linjer. I det øjeblik redigeringen kræver en designvurdering eller rører en sti, som repoet markerer som kritisk, går den til en worker.

Klar til at vokse din virksomhed?
Start din gratis prøveperiode i dag og se resultater inden for få dage.
Hvorfor et abonnement ændrer regnestykket
Hvis du betaler pr. token, er sagen enkel. Opus 5 koster $5 pr. million input-tokens og $25 pr. million output; Sonnet 5 $2 og $10. Hvert token implementering, der flyttes fra Opus til Sonnet, koster 40% af, hvad det gjorde.
Jeg betaler et abonnement, og der er sagen en anden og, synes jeg, stærkere. Claude Max har to ugentlige grænser, ikke én: en grænse på tværs af alle modeller, som hvert token trækker på efter sin models sats, og en separat, strammere grænse, som kun Fable trækker på. Opus har ingen egen grænse. Det giver opdelingen to effekter. Arbejde, som en Sonnet-worker udfører, trækker på den fælles grænse med 40% af den sats, en Opus-worker ville gøre, så at flytte to tredjedele af en sessions tokens til Sonnet gør ugen længere, selv om det samlede antal tokens er uændret. Og når arkitekten er Fable, er hvert token, den ikke bruger på at skrive, et token, der er tilbage på den grænse, der løber tør først. Så selv hvis arkitektmønsteret brugte præcis samme antal tokens som en almindelig session, ville det stadig være hvem-der-bruger-dem, der bestemte, hvornår ugen slutter.
Det “selv hvis” viste sig at gøre et stort stykke arbejde.
Hvad transskriptionerne siger
Claude Code skriver hver session til en JSONL-transskription og hver worker-kørsel til en sideløbende fil under sessionens mappe. Jeg har dem alle siden 19. august: 324 interaktive sessioner med tre eller flere prompts, hvoraf 49 brugte mønsteret, dvs. de startede en implementer-agent eller sendte en brief til en. Tokens er vægtet, som regningen er: frisk input ved 1, cache-skrivninger ved 1,25 eller 2, cache-læsninger ved 0,1. CI-kørsler er udeladt.
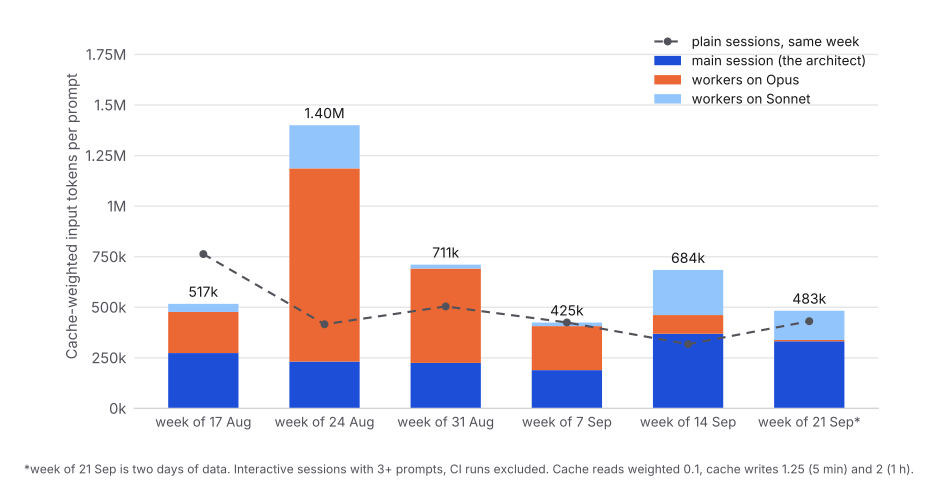
Læs den fra venstre mod højre, og det er ikke en succeshistorie de første to uger.
I ugen den 24. august kostede en arkitektsession 1,40M vægtede tokens pr. prompt. Almindelige sessioner samme uge kostede 0,42M. Tre en halv gange mere, og næsten hele overskuddet var orange: Opus-workere. Jeg havde givet workerne en god model og ingen regler, og de opførte sig som en god model uden regler. Den mediane Opus-worker-kørsel den uge var 176 ture. Flere kørte den fulde backend-testsuite, hvilket lægger omkring 100 KB output ind i en kontekst, der sendes igen ved hver tur efter. En session med seks workere den 14. september, efter jeg allerede var begyndt at stramme tingene, brændte stadig 245M input-tokens over 1.585 ture for at producere omkring seks tusind linjers diff. Prompt-caching fungerede med en hitrate på 91,6% hele tiden. Regningen var volumen, ikke prissætning.
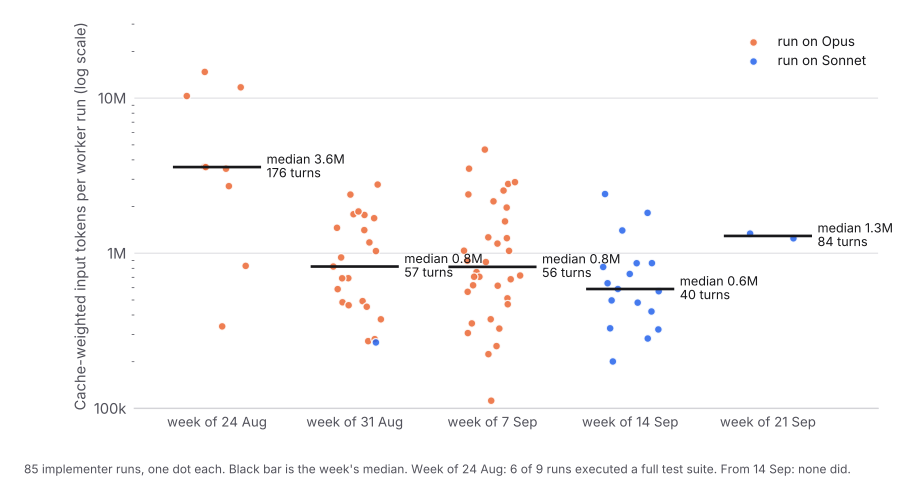
Worker-strimlen viser, hvor reglerne landede. Tre af dem gjorde det meste af arbejdet, og jeg skrev dem ind i agentdefinitionerne i stedet for i briefen, så de gælder, uanset om jeg husker det:
- En worker kører aldrig en fuld testsuite. Den kører de testfiler, dens brief nævner. Arkitekten kører gates.
maxTurnser begrænset i agentdefinitionen, 140 for Sonnet og 160 for Opus. En slice, der har brug for 250 ture, var briefet forkert.- En slice holder sig under omkring tolv filer, og briefen under omkring 8 KB. Briefen sendes også igen ved hver tur.
I ugen den 31. august var den mediane worker-kørsel 57 ture og 0,8M vægtede tokens. Fra 14. september, hvor jeg flyttede standardruten til Sonnet, var den 40 ture og 0,6M, og ingen worker har kørt en fuld suite siden.
Totalen pr. prompt fulgte efter: 711k, 425k, 684k, 483k over de sidste fire uger, mod almindelige sessioner på 505k, 425k, 318k, 431k. Arkitektsessioner koster nu omtrent det samme som almindelige sessioner. Lidt mere i to af de fire uger, lidt mindre i én. Hvad de køber for det, viser de næste to grafer.
Tilmeld dig vores nyhedsbrev
Få de seneste tips, trends og tilbud gratis.
Hovedmodellen holdt op med at skrive
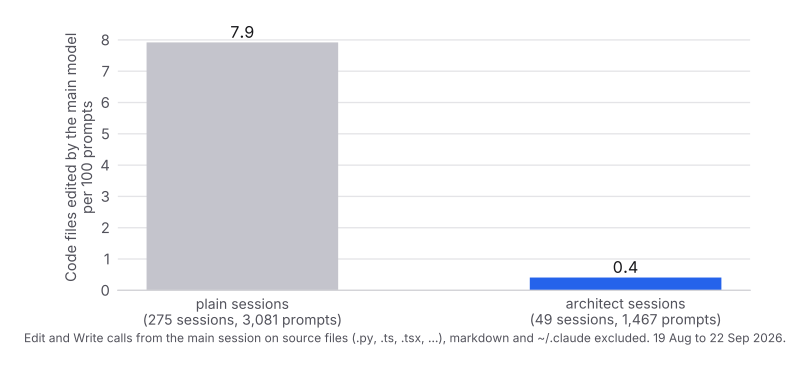
Dette er det tal, jeg satte mig for at ændre, og det ændrede sig. I almindelige sessioner lavede hovedmodellen 244 Edit- eller Write-kald på kildefiler på tværs af 3.081 prompts. I arkitektsessioner lavede den 6 på tværs af 1.467. De 6 er alle undtagelser for små rettelser, som jeg kan redegøre for.
I mellemtiden var workerne produktive. De 85 worker-kørsler lavede 2.510 kildefil-redigeringer. Tæller man hovedløkke og workere sammen, producerede en arkitektsession 2.516 koderedigeringer ud fra 1.467 prompts; almindelige sessioner producerede 943 ud fra 3.081. Pr. koderedigering brugte en arkitektsession 403k vægtede tokens i alt og 330k på Opus-familien. En almindelig session brugte 1.410k og 1.324k. Jeg vil være forsigtig med den sammenligning, fordi de to populationer ikke er det samme arbejde: en session klassificeres som arkitekt ved at delegere kode, så arkitektsessioner er kodetunge af konstruktion, og almindelige sessioner inkluderer research, reviews og debugging, der aldrig redigerer noget. Læs det som “mønsteret får skrevet en masse kode pr. token”, ikke som en påstand om fire gange effektivitet.
Den renere påstand er modelopdelingen. Siden 14. september koster en prompt i en arkitektsession 364k vægtede tokens i hovedløkken, 205k i Sonnet-workere og 80k i Opus-workere. Opus-workernes andel af alle worker-tokens var 100% i august og omkring 4% i ugen den 21. september. På en Max-plan betyder det, at den fælles ugentlige grænse trækkes på med Sonnets sats i stedet for Opus’ for næsten alt implementeringsarbejde, og at intet af det rører Fable-grænsen.
To ting blev ikke bedre, og det vil jeg hellere sige end lade graferne antyde det modsatte. Hovedsessionens egen kontekst blev ikke mindre: arkitektsessioner komprimerede 8,7 gange pr. 100 prompts mod 4,7 for almindelige sessioner, fordi arkitekten læser meget, før den briefer. Og mønsteret er langsommere i wall-clock-tid på små opgaver, fordi en workers opstart og rapport er minutter, du ikke betaler, når du bare laver redigeringen. Undtagelsen for små rettelser findes, fordi den første version af skillen ikke havde nogen, og jeg så mig selv skrive en 3 KB brief for en tolinjers ændring.
DeepSeek-omvejen
Da workerne var Sonnet, var det næste oplagte spørgsmål, om de overhovedet skulle være en Claude-model. Fra 13. til 18. september pegede jeg workeren mod DeepSeek V4.1 Flash gennem en headless Claude Code med ANTHROPIC_BASE_URL sat til et kompatibelt endpoint, først gennem OpenRouter og derefter native. Samme brief-format, samme rapportformat, samme arkitekt. 2.732 kald, 431M input-tokens, hvoraf 88% var cache-læsninger, 1,7M output-tokens.
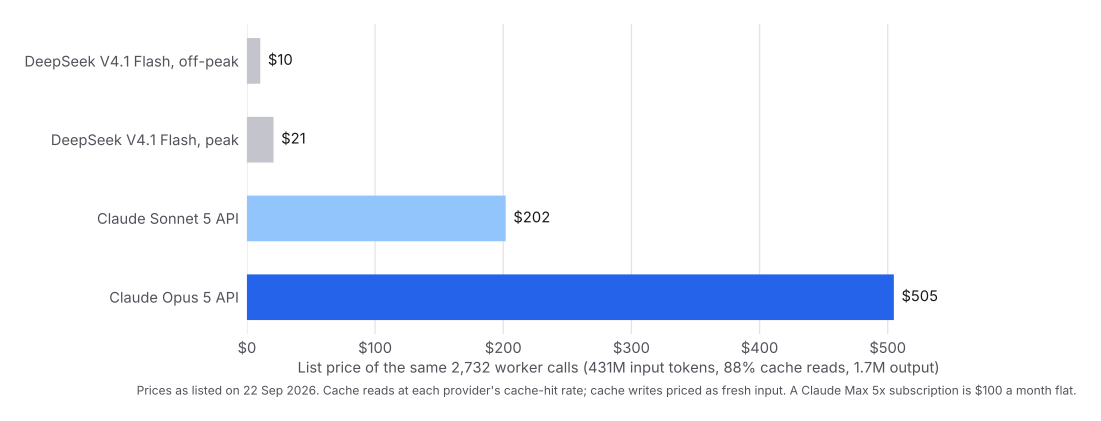
Til listepriser den 22. september koster den trafik omkring $10 på DeepSeek off-peak, $21 ved peak, $202 på Sonnet API og $505 på Opus API. Hvis jeg betalte pr. token, ville det være overskriften på indlægget, og jeg ville have beholdt det.
Jeg betaler ikke pr. token, og det er hele argumentet. Et Max-abonnement koster $100 om måneden, uanset om jeg bruger 30% af den ugentlige grænse eller 100%. At flytte worker-trafik til DeepSeek sænkede ikke den regning med en cent. Det tilføjede en ekstra regning på $10 til $21 om ugen oveni, for at spare kapacitet på en plan, hvis kapacitet jeg allerede havde betalt for. Jeg havde forvekslet “billigere end API’en” med “billigere end det, jeg betaler”, og de er ikke det samme, når det, du betaler, er fast. Den rigtige sammenligning for en abonnent er DeepSeek mod et ekstra abonnement, og der koster en ekstra Claude-plan eller en ChatGPT-plan med Codex omtrent det samme som en måneds moderat DeepSeek-brug og kommer med sin egen ugentlige grænse, sin egen model og ingen måling at holde øje med.
Kvalitet var den anden halvdel. Fem backend-slices kom rent tilbage og blev committet, som de var. Én frontend-slice fjernede et eksporteret symbol og lod alle dets forbrugere være urørt, så træet kompilerede ikke, og en senere slice måtte rydde op. Det er præcis den fejl, en model, der udfører en specifikation, har, og en model, der udleder en komponents form ud fra dens søskende, ikke har, og skillen siger det nu: ændringer i fælles API-flader går til Sonnet, og worker-reglen lyder “fjern eller omdøb aldrig et eksporteret symbol uden at migrere hver forbruger i samme kørsel”. DeepSeek Flash er en god udfører. Arkitektmønsteret har brug for en worker, der bemærker, når briefen undervurderede forbrugerne, og det er den ene ting, en brief ikke kan levere.
Så rutetabellen i dag har to rækker. Rutinearbejde, backend-arbejde mod en detaljeret brief med tests, der skal opfyldes, frontend-arbejde der følger en eksisterende designgrammatik, og enhver ændring af en fælles API-flade går til sonnet-implementer. Arbejde, hvis sværhedsgrad ligger i ræsonnementet, går til opus-implementer: et async race, en refaktorering på flere steder, hvis korrekthed afhænger af steder, briefen ikke kan opregne, en backfill-migrering, som ingen enkelt test beviser. Rut efter form, aldrig efter risiko. Risiko ændrer, hvor hårdt diffen bliver reviewet, og om et menneske underskriver den. Det ændrer aldrig, hvem der skriver den.
Review-løkken, hvor mønsteret tjener eller mister sin berettigelse
En workers rapport er en påstand. Skillens review-løkke er kort, og hver linje kom af at være blevet brændt:
- Læs rapporten og den faktiske
git diff. Krydstjek den diffstat, workeren citerer, mod den, du ser. - Kør den vigtigste verifikation igen selv, når påstanden betyder noget.
- Fundet et problem? Send rettelsen til den samme worker. Den har stadig sin kontekst og fortsætter, hvor den stoppede. Ret det ikke i hånden, og start ikke en ny.
- To mislykkede rettelser betyder, at briefen var underspecificeret, ikke at modellen er for lille. Opdel, sæt det manglende uddrag i Context, kør igen. Klatr ikke op til en større model, for den vil implementere den samme misforståelse mere flydende.
- Kør de afgrænsede gates, før du accepterer noget: de berørte tests, linteren på de berørte filer, hvad end konventionsscript repoet har.
I transskriptionerne sendte jeg omkring én rettelse pr. worker-kørsel, 52 over 85 kørsler, og 7 Opus-kørsler ramte deres 160-turs-grænse, alle på en slice, jeg i dag ville opdele. Det er de to tal, jeg holder øje med. Hvis rettelser pr. kørsel stiger, bliver mine briefer dovne. Hvis workere rammer grænsen, er mine slices for store.
Hvad du kan tage med herfra
Hvis du betaler pr. token: sæt den dyre model på beslutninger og review, sæt en billig på implementering, og prissæt din worker-trafik til listepris, før du vælger hvilken billig. Diagrammet med fire søjler er argumentet.
Hvis du betaler et abonnement: mønsteret skærer ikke dit antal tokens ned. Det flytter implementeringstokens til den model, der trækker den fælles ugentlige grænse langsomst, holder Fable-grænsen til det arbejde, kun Fable bør gøre, og forhindrer din dyreste model i at bruge sine ture på at skrive. Tilføj ikke en målt API ved siden af for at “spare” kapacitet, du allerede har købt. Hvis du løber tør for worker-kapacitet, så køb et ekstra abonnement.
Uanset hvad var reglerne, der fik det til at virke, de kedelige. Ingen fulde testsuiter i en worker. Begræns ture. Små slices, korte briefer. Ret den samme worker én gang, ret derefter briefen.
Skillen, de tre agentdefinitioner og guard-hooken ligger på github.com/LivinTribunal/architect-skill under MIT. Den ledsagende skill, der fortæller workeren, hvordan den skriver kode, der matcher det repo, den lander i, er grain-skill , og indlægget om den er kode med åren .
Metode
Alt, hvad indlægget beskriver, ligger i github.com/LivinTribunal/architect-skill : selve skillen, brief-skabelonen, rutetabellen, de tre implementer-agentdefinitioner med deres tur-grænser og kontekstregler samt guard-hooken. Installer den, og du har det setup, tallene nedenfor kom fra.
Sessioner er Claude Code JSONL-transskriptioner fra 19. august til 22. september 2026, entrypoint cli, tre eller flere bruger-prompts. En session klassificeres som arkitekt, hvis den startede opus-implementer, opus-implementer-xhigh eller sonnet-implementer, kørte en ds-slice-worker, kaldte architect-skillen eller sendte en besked med en implementeringsbrief til en general-purpose-agent, hvilket er sådan de tidlige uger fungerede, før de navngivne agenter fandtes. Worker-kørsler er subagent-transskriptionerne under hver sessions mappe. Forbrug er dedupliceret efter request-id og vægtet frisk input 1, fem-minutters cache-skrivning 1,25, en-times cache-skrivning 2, cache-læsning 0,1. “Koderedigering” er et Edit- eller Write-kald på en .py, .ts, .tsx, .js, .sql eller lignende kildefil, ekskl. markdown og alt under ~/.claude. DeepSeek-priser er native listepris den 22. september 2026, off-peak og peak, med cache-læsninger til cache-hit-raten og cache-skrivninger prissat som frisk input; Claude API-priser er de offentliggjorte listepriser for Opus 5 og Sonnet 5 med cache-læsninger til en tiendedel af input. Ugen den 21. september er to dages data.
