


Den korte version
- Jeg tog et rigtigt issue fra FlowHunt-backloggen og lod Claude Code implementere det 13 gange på Opus 5.5 under syv forskellige instruktionsopsætninger. Hver kørsel startede fra samme commit, i sin egen klon med sin egen database, og gik gennem vores rigtige GitHub CI. To blinde Opus-bedømmelser vurderede hvert resultat.
- Repositoriets CLAUDE.md på 33 KB købte ikke målbar kvalitet. Kørsler med den fik 2.0 blocker- og major-anmærkninger pr. bedømmelse. En kørsel helt uden instruktionsfil fik det samme. En fil på 5.5 KB fik 1.0.
- En separat planlægningsfase gjorde tingene værre. Begge opsætninger, der kørte en planlægningsprompt og derefter en implementeringsprompt, kostede mere end deres tvillinger med almindelig prompt, og de stod for fire af de fem blockere i alle 26 bedømmelser.
- Vinderen var en CLAUDE.md på 8 KB, tre skills, Sonnet-arbejdere og en almindelig prompt. Dens to kørsler kostede i gennemsnit $6.68 til API-listepris. Den fulde opsætning med pipeline-prompts kostede i gennemsnit $11.49, omkring 1.7 gange så meget, og havde flere anmærkninger.
- Det, der overlevede fra hele den struktur, jeg havde bygget, er briefingen: en kort, besluttet beskrivelse af én slice arbejde, som hovedmodellen skriver til en billigere arbejdsagent. Planer for hovedmodellen selv betalte sig ikke. Modellen planlægger fint på egen hånd.
Dette følger op på indlægget om arkitektmønsteret , som målte, hvem der bør skrive koden. Dette spørger, hvor meget hovedmodellen har brug for at få at vide, før den begynder.
Hvorfor jeg kørte det
Vores monorepo havde samlet en masse agentinstruktioner. Rod-CLAUDE.md var på 33 KB: build-kommandoer, testkadence, kodestil, arkitektur, kritiske stier, sikkerhedsregler, regler for tilladelser og credits, de to agentflader, oprettelse af issues, PR-konventioner. Ti skills lå under .claude/skills/. Oveni det kørte vores CI-pipeline (vi kalder den harnext) et issue gennem en tagger, et triage-trin, et planlægningstrin, der skrev en plan som en issue-kommentar, og et implementeringstrin, der læste planen tilbage og skrev koden, hver med sin egen lange systemprompt.
Hver linje i det blev tilføjet af en grund, som regel efter en agent gjorde noget forkert. Spørgsmålet, ingen havde stillet, var, om det stadig hjalp. En CLAUDE.md indlæses i hver session og sendes igen for hver tur. Hvis modellen alligevel ville have gjort det rigtige, er de tokens en skat, og som hvad et kontekstvindue koster forklarer, løber en skat på hver tur hurtigere op, end det ser ud.

Klar til at vokse din virksomhed?
Start din gratis prøveperiode i dag og se resultater inden for få dage.
Testen
Issuet var en tidsstyret e-mailsekvens til nye tilmeldinger: en admin definerer trin som “dag 0: velkomst” og “dag 5: din prøveperiode slutter snart”, og en baggrundsopgave sender mail til hver konto på den rigtige dag, stopper når personen køber et betalt abonnement, og springer konti over, der blev oprettet før lanceringen. Det kræver en migrering, et repository, en service, en Celery beat-opgave, REST-endpoints, MCP-værktøjer til agenter og en konsol-UI på 11 sprog. Det er en realistisk uge-et-funktion, og den har flere edge cases, der er nemme at overse.
Hver kørsel var en headless Claude Code-session på Opus 5.5, sandboxet til sin egen klon og database, med et script, der pushede dens commit til en draft-PR og førte CI-resultatet tilbage i sessionen, op til tre runder. Prisen er Claude Codes egen total_cost_usd for hovedsessionen plus hver subagent, prissat til API-listepris. Jeg betaler et abonnement, så dette er et mål for arbejde, ikke for min regning.
De syv opsætninger:
| Opsætning | Kørsler | |
|---|---|---|
| A | Fuld CLAUDE.md på 33 KB og ti skills, pipeline-prompts (planlæg, derefter implementer) | 2 |
| B | Fuld CLAUDE.md og skills, almindelig prompt | 3 |
| C | Ingen CLAUDE.md, ingen skills, almindelig prompt | 2 |
| D | Fuld CLAUDE.md plus architect-skillen, almindelig prompt | 2 |
| E | CLAUDE.md på 8 KB, architect, grain-ponytail og unslop, pipeline-prompts | 1 |
| F | CLAUDE.md på 5.5 KB, ingen skills, almindelig prompt | 1 |
| G | CLAUDE.md på 8 KB, architect, grain-ponytail og unslop, almindelig prompt | 2 |
A til D kom først. E til G blev bygget ud fra, hvad de viste, og den tredje B-kørsel gik ved siden af dem som kontrol. Filen på 8 KB er den på 5.5 KB plus en kort liste over skillene og hvornår de skal indlæses, samt reglerne for modelrouting, der får architect-skillen til at delegere til Sonnet.
Hvert resultat gik derefter til to Opus-bedømmere, der kun så et bogstav, diffen, repositoriet og issuet. De listede enhver ændring, de ville bede om før godkendelse, gradefinddelte dem som blocker, major, minor eller nit og tjekkede hvert acceptkriterium mod en fil og linje.
Pris
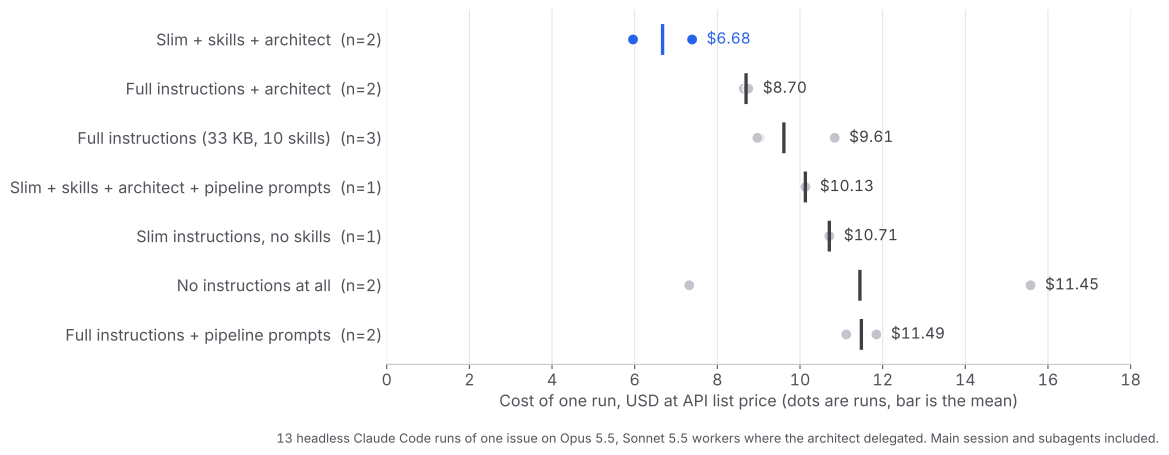
Den vindende opsætning, G, kostede $5.96 og $7.39. Den fulde opsætning med pipeline-prompts, A, kostede $11.12 og $11.85. Forskellen er mest ture og hvad hver tur bærer. A’s hovedsessioner kørte 172 og 144 ture på Opus med 24 til 28 millioner input-tokens. G’s kørte 79 og 95 ture med 13 til 16 millioner og gav omkring 60 flere ture videre til Sonnet-arbejdere, der faktureres til en brøkdel af prisen. G blev også færdig med sit arbejde på omkring 21 minutter mod A’s 45.
To ting på dette diagram overraskede mig. Ingen instruktioner overhovedet er ikke den billige løsning: dens to kørsler kostede $7.32 og $15.58, og den dyre fejlede også CI og skrev testens største diff. Og filen på 5.5 KB uden skills, F, var ikke billigere end den fulde opsætning. Den skrev mere kode, 1,601 produktlinjer, og betalte for det. Besparelsen i G kommer ikke fra den korte fil alene. Den kommer fra den korte fil plus de to skills, der ændrer, hvordan arbejdet udføres.
Tilmeld dig vores nyhedsbrev
Få de seneste tips, trends og tilbud gratis.
Kvalitet
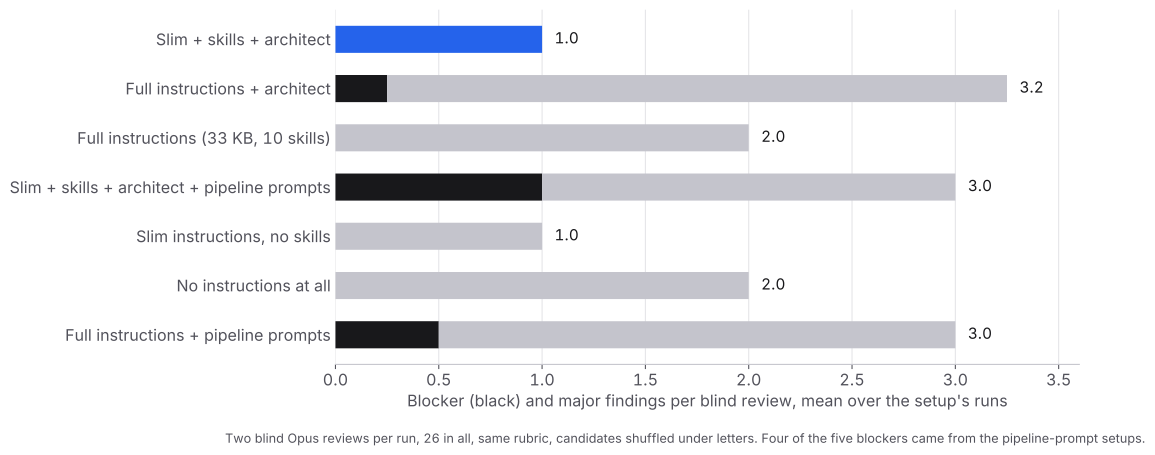
Den billigste opsætning havde også færrest alvorlige anmærkninger: ingen blockere og 1.5 og 0.5 major pr. bedømmelse i sine to kørsler. Den fulde CLAUDE.md, B, lå på 2.0 major i alle tre af sine kørsler, det samme som helt uden CLAUDE.md.
Dette er det resultat, jeg vægter højest. Filen har lange afsnit om sikkerhed, tilladelser og credits, skrevet fordi en agent engang sprang dem over. Med eller uden filen fandt bedømmerne det samme antal alvorlige problemer, og de samme slags dukkede op på tværs af opsætninger: en tilmelding, der betaler og derefter opsiger, en e-mail, der går tabt eller sendes to gange, når en worker fejler halvvejs, en editor, der overskriver indhold, den ikke kan vise. Det er ræsonnementshuller om tilstand over tid. Ingen regelliste i CLAUDE.md dækkede dem, for man kan ikke skrive en regel for en edge case, man ikke har tænkt på endnu.
Det, der dækkede dem, var en ændring af architect-skillen mellem runderne. Før hovedmodellen skriver nogen briefing, skriver den nu en tabel: hvert acceptkriterium, hvad der sker, når den tilstand, det afhænger af, ændrer sig over tid, og den besluttede adfærd. Hver række går derefter ind i briefingen med en navngivet test. G’s kørsler skrev 774 og 818 testlinjer, mod 510 til 670 for B.
Planlægningsfasen
A og E er de to opsætninger, der kørte vores CI-pipelines prompts: en planlægningsprompt, der skriver en plan, derefter en implementeringsprompt, der læser planen og udfører den. Sammenlign hver med dens tvilling, der i stedet fik en almindelig prompt. A kostede $11.49 pr. kørsel mod B’s $9.61 og havde blockere, hvor B ingen havde. E kostede $10.13 mod G’s $6.68 og havde en blocker i hver af sine bedømmelser, hvor G ingen havde.
Jeg tror, grunden er, at en plan er et dokument, modellen skriver til sig selv og derefter skal læse tilbage som en udefrakommende instruktion. Den anden session behandler planen som en specifikation, følger den, hvor den er forkert, og bruger ture på at afstemme den med det, den finder i koden. En model, der er så dygtig, planlægger bedre inde i den session, der skal udføre arbejdet, hvor planen og koden er i samme kontekst.
Den del af planlægningen, der overlevede, er briefingen. Når hovedmodellen giver en slice videre til en Sonnet-arbejder, starter arbejderen med en tom kontekst og bygger præcis det, den får besked på. Den overdragelse kræver en skreven, besluttet beskrivelse: målet, filerne, mønsteret der skal spejles, edge cases, testen der skal skrives. En plan til sig selv er overhead. En briefing til en anden er den eneste måde, arbejdet kommer over.
Hvad grain-ponytail gjorde
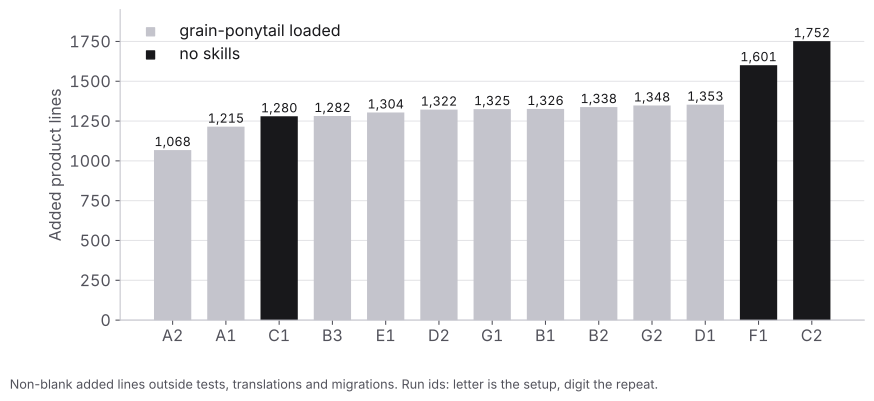
Skillen fra kode i tråd med kodebasen fortæller modellen at spejle det nærmeste eksisterende eksempel og levere den mindste kode, der virker. Hver kørsel, der havde den indlæst, skrev mellem 1,068 og 1,353 produktlinjer. De to største diffs, 1,601 og 1,752, kom fra kørsler uden skills. En kørsel uden skills holdt sig på 1,280, så skillen bestemmer ikke størrelsen alene, men den fjernede halen.
Det er også det klareste eksempel på, hvilken slags instruktion der stadig betaler sig. “Spejl det nærmeste eksempel” ændrer, hvad modellen gør ved hver fil, den skriver. “Brug snake_case til funktioner” gentager noget, den allerede gør.
Hvad bedømmelserne stadig fangede
Den vindende kørsel var ikke ren. Efter testen rebasede jeg G2’s arbejde over på main og kørte det gennem vores fulde PR-tjek, som gennemgår diffen, beviser hver anmærkning med en fejlende test og driver ændringen i en rigtig browser. Det fandt, at trin-editoren tabte hver blok bortset fra den første HTML-blok, når en admin redigerede et trin oprettet via MCP, og at en mislykket claim release kunne sende mail til nogle brugere to gange. Begge blev rettet, med tests, før PR’en gik til menneskelig gennemgang.
De blinde bedømmere markerede også mere over-engineering i architect-kørslerne end i dem med fulde instruktioner: 2.5 punkter pr. bedømmelse for G mod 0 til 1.0 for kørslerne af A og B. Færre alvorlige anmærkninger, flere nits. Jeg ville tage den byttehandel, men det er en byttehandel.
Hvad jeg ændrede
- CLAUDE.md på 33 KB blev en AGENTS.md på 12 KB, som Codex også læser, og CLAUDE.md importerer den nu bare. Den beholder kommandoerne, testkadencen, arkitekturen og de regler, en model ikke kan udlede af koden, såsom hvilke stier der er kritiske, og at de to agentflader skal følges ad.
- Planlægningsfasen er væk fra pipelinen. Triage giver issuet direkte videre til et implementeringstrin, hvis prompt er skrumpet til seks trin: læs issuet, lav en branch, indlæs architect- og grain-ponytail-skillene, test, commit, åbn en draft-PR.
- Architect-skillen fik tabellen over edge cases, et Tests-felt i briefingen og en sidste gennemgang, der tjekker hele diffen mod issuet i stedet for mod briefingene. Den version er offentlig på github.com/LivinTribunal/architect-skill .
Ændringen i repositoriet er til gennemgang på skrivetidspunktet.
Hvad du kan tage med fra dette
Hvis din CLAUDE.md voksede en hændelse ad gangen, betaler den sandsynligvis for regler, modellen allerede følger. Skær den ned til det, modellen ikke kan finde ud af ved at læse koden, og mål før og efter på en rigtig opgave i stedet for at stole på, at mere vejledning er sikrere.
Behold de instruktioner, der ændrer, hvordan arbejdet udføres: hvem der skriver koden, hvordan en slice briefes, hvilket eksisterende mønster der skal kopieres. Drop planlæg-så-udfør-pipelinen, hvis din hovedmodel er en aktuel frontier-model. Skriv briefinger til arbejdere, ikke planer til dig selv.
Metode
13 headless kørsler af Claude Code 2.1.289 den 5. oktober 2026, hovedmodel Opus 5.5, arbejdere Sonnet 5.5 hvor architect-skillen delegerede. Alle kørsler startede fra én commit af FlowHunt-monorepoet, hver i en APFS-klon med sin egen Postgres-database, sandboxet fra de andre kørsler og fra eksperimentets egne filer. En broker pushede hver kørsels commit til en draft-PR mod en frosset base-branch og genoptog sessionen med CI-resultatet, op til tre runder. Prisen er den maksimale total_cost_usd pr. session, summeret over hovedsessionen og dens subagenter. Produktlinjer er ikke-tomme tilføjede linjer uden for tests, oversættelser og migreringer.
Hvert resultat fik to blinde bedømmelser af Opus med én rubric: korrekthed, acceptkriterier, grain, private felter og skjult tilstand, over-engineering, sikkerhed og tilladelser, tests, migreringer. Kandidaterne blev blandet under bogstaver, og bedømmerne kunne læse repositoriet, men ikke køre noget. Anmærkninger pr. bedømmelse er gennemsnit over en opsætnings kørsler. Med en til tre kørsler pr. opsætning skal et enkelt gennemsnit betragtes som støjende. Konklusionerne ovenfor er dem, der holdt i begge runder.
