


For et par dage siden gjorde Anthropic Fable til en permanent del af Max-abonnementerne. Tidspunktet fortæller historien: det landede lige efter, at OpenAI udgav GPT-5.6 Sol, og — endnu vigtigere — lige efter at Kimi K3 frigav sine vægte. Det krævede en open source-model at tvinge det største AI-laboratorium til at se virkeligheden i øjnene og afslutte markedsføringsspektaklet omkring deres flagskib. Det alene fortjener en skål fra enhver, der betaler disse regninger.
Men “inkluderet i dit abonnement” er ikke det samme som “billigt”, og det er bestemt ikke det samme som “billigt for evigt”. Derfor genopbyggede vi vores workflow, mens Fable stadig var forbrugsafregnet, så den dyre model er mekanisk blokeret fra at skrive kode. Den tænker, planlægger og reviewer. Billigere modeller taster. Dette indlæg viser, hvordan det fungerer, og hvad det faktisk målte ud til på tværs af hver eneste transskription, vi har — 606 rigtige sessioner fordelt over et produktions-SaaS-monorepo, en droneoperationsapp, et marketingsite og de CI-agenter, der betjener dem.
Del 1 — Fælden og princippet
Her er vores ærlige udgangspunkt: vi kan ikke længere fungere uden frontier-modeller. Ingen på teamet kunne opretholde den nuværende produktion uden dem — og den afhængighed er præcis den løftestang, de store laboratorier har. Efter vores læsning leverer nutidens AI-abonnementer markant mere compute, end de koster; det er land-grab-priser, og land-grab-priser slutter. Når de gør, betaler enhver, der har bygget sin engineering-kultur op omkring “ubegrænsede frontier-tokens”, hvad der end bliver forlangt.
Der er to forsvar. Det første er at holde en troværdig udvej: åbne modeller som DeepSeek og Kimi er det, der tvang ugens prisjustering igennem, og de er kun en løftestang, hvis vi faktisk holder vores workflows portable til dem. Det andet er workflow-disciplin: brug kun frontier-tokens, hvor intet billigere virker. Dette indlæg handler om det andet — for det er det, du kan begynde på mandag.
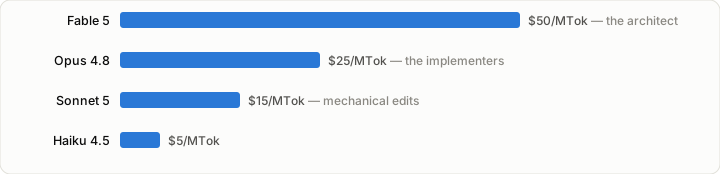
Princippet er gammelt nok til at have en bygning opkaldt efter sig: arkitekten lægger ikke mursten. En frontier-models forspring over en mellemklassemodel er enormt inden for design, nedbrydning og review — og tæt på nul, når man skal taste en omdøbning igennem fyrre filer. Så opdel rollerne. Prisstigen siger det samme i dollars:
Sådan fungerer fable-architect-mønsteret
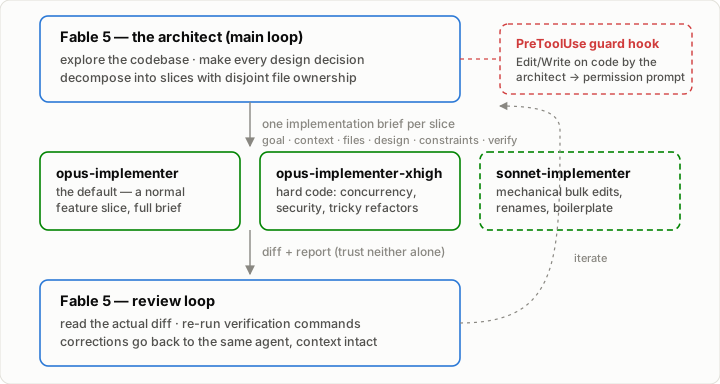
fable-architect-skillen er en markdown-fil på ~100 linjer plus én shell-hook, der indlæses, hver gang en Claude Code-session kører på frontier-modellen. Den håndhæver en arbejdsdeling:
- Arkitekten gør: afdækker kravet, udforsker kodebasen, træffer enhver designbeslutning — tilgang, dataflow, navne, signaturer, edge cases — nedbryder arbejdet i uafhængige slices, reviewer de returnerede diffs, kører verifikation og skriver al prosa (planer, briefs, PR-tekster, commit-beskeder).
- Arkitekten gør aldrig: skriver eller redigerer en kildefil. Ingen kode i chatten ud over korte signaturer inde i en brief.
Tre ting gør, at dette virker i praksis frem for på en slide.
1. Briefen er interfacet
Hver slice får én implementeringsbrief. Implementøren starter med et frisk kontekstvindue — alt, der ikke står i briefen, må den genopdage eller gætte. Den begrænsning er en feature: den tvinger arkitekten til at færdigbeslutte, før der delegeres. En brief indeholder beslutninger, ikke valgmuligheder.
## Implementation brief: <slice>
Goal:         én sætning, observerbart resultat
Context:      hvad udforskningen allerede fandt — uddrag, det nærmeste
              mønster at spejle, linjeankre, faldgruber
Files:        stier der skal oprettes/ændres — denne slices eksklusive ejerskab
Design:       den besluttede tilgang — dataflow, navne, signaturer, kanter
Constraints:  projektregler der gælder: stil, lag, sikkerhed
Out of scope: hvad der ikke må røres, inklusive filer ejet af andre slices
Delegation:   må denne slice starte sub-implementører, og hvor mange
Verify:       præcise kommandoer og forventet resultat
To af de linjer er nyere end resten, og de findes, fordi implementørtrinnet ændrede sig under os — se opdateringen nedenfor.
2. Håndhævelse, ikke fornemmelser
En PreToolUse-guard-hook overvåger sessionen: hvis arkitekten forsøger at redigere en fil, der ikke er prosa, udløses en tilladelsesprompt. At godkende prompten er den dokumenterede undtagelse for trivielle redigeringer (en tastefejl, et versionsbump — tilfælde hvor delegationsoverhead koster mere end at taste selv). Friktion er politikken. Uden hooken holder “den dyre model bør ikke kode” præcis indtil den første deadline.
3. Review-loopet lukker kvalitetsgabet
Arkitekten læser agentens rapport og det faktiske diff — og stoler ikke på noget af det alene — og kører de vigtigste verifikationskommandoer igen, når påstanden betyder noget. Fundet et problem? Rettelsen går tilbage til den samme agent, som stadig har hele sin arbejdskontekst. Ingen manuel rettelse, ingen ny opstart.
Bemærk, at dette er arkitektens verifikation, og den bliver. Det, vi er begyndt at fjerne, er den verifikation, vi plejede at skrive ind i briefs — instruktioner, der beder implementøren om at tjekke sig selv efter. Nyere implementørmodeller gør det uopfordret, og at bede dem gøre det igen køber et andet gennemløb, du allerede har betalt for.

Klar til at vokse din virksomhed?
Start din gratis prøveperiode i dag og se resultater inden for få dage.
Hvad vi målte
For at kontrollere, om dette er en reel økonomisk mekanisme eller bare et behageligt ritual, gennemgik vi hver eneste Claude Code-transskription på tværs af vores projekter, deduplikerede API-forespørgsler og prissatte hver token efter gældende listepriser. Tre hypoteser, registreret før vi kiggede på tallene pr. session:
- H1 — Implementørerne står for tastetrykkene. Hvis sandt, bør implementør-subagenter producere flere output-tokens end arkitektens hovedloop i delegerede sessioner.
- H2 — Delegering er billigere. Hvis sandt, bør en omprisning af implementørernes arbejde til arkitektmodellens takster vise sig markant dyrere end det, vi faktisk betalte.
- H3 — Kvaliteten holder. Den svære: delegeret kode bør ikke kræve mere omarbejde end kode, arkitekten selv har tastet.
Grundregler. Én API-forespørgsel spænder over mange transskriptionslinjer, der gentager det samme usage-objekt — vi grupperede efter request-ID, talte input- og cache-tokens én gang pr. forespørgsel og tog det maksimale output-snapshot (naiv summering pr. linje overvurderer 2–3×). Omkostninger bruger Anthropics gældende listepriser — Fable $10/$50, Opus $5/$25, Sonnet $3/$15 pr. million input-/output-tokens — med cache-læsninger til 10 % af inputprisen og cache-skrivninger til deres priser pr. TTL. 31 af 354 sessioner i den interaktive butik kvalificerer som fable-architect-sessioner under en konservativ klassificering; figurerne viser de otte dyreste. Vi rapporterer forhold og procenter frem for vores absolutte forbrug.
Del 2 — Kvitteringerne
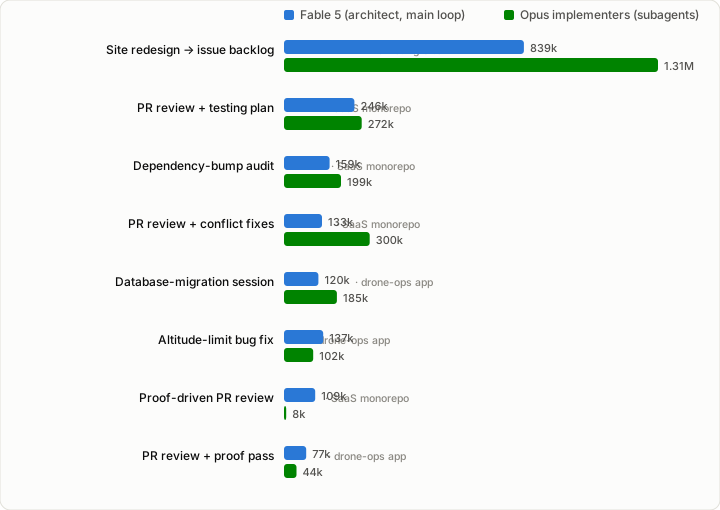
H1 — Blandet… sagde den første bogføring. I de største delegationssessioner holder hypotesen afgjort — op til 2,3× mere implementør-output end arkitekt-output. Men på tværs af alle 31 fable-architect-sessioner producerede arkitekten stadig mere end implementørerne, 3,59 mio. mod 3,15 mio. tokens. Delvist er det fair — arkitektens output inkluderer alle planer, briefs og review-prosa, hvilket netop er dens job — og delvist lignede det sessioner, der delegerede én slice og beholdt resten. Så huskede vi, at vores redesign af sitet slet ikke havde føltes arkitekt-tungt, og gik på jagt efter de tokens, som subagent-bogføringen ikke kunne se.
Tilmeld dig vores nyhedsbrev
Få de seneste tips, trends og tilbud gratis.
Den anden kanal: issue-trackeren som delegationsbus
Subagent-bogføring har et blindt punkt: den ser kun den delegering, der sker inde i en session. Sessionen med site-redesignet — den største post i diagrammet ovenfor — viste sig at være noget helt andet: en enkelt arkitekt-loop-session, der kørte i 107 timer i træk (292 planlagte wakeups), brød redesignet ned i GitHub-issues, taggede dem til vores CI-pipeline og derefter superviserede: polle-de kørsler, reviewede pipelinens pull requests og oprettede follow-up-issues, efterhånden som QA afdækkede fejl.
Tastetrykkene skete et sted, vores mining pr. session slet ikke havde kigget: en separat flåde af selvhostede runners, hvor pipelinens stadier plan → implement → gap-evaluering → review blev eksekveret som 252 uafhængige Opus-sessioner over 4,5 dage, der berørte 48 forskellige issues og PR’er.
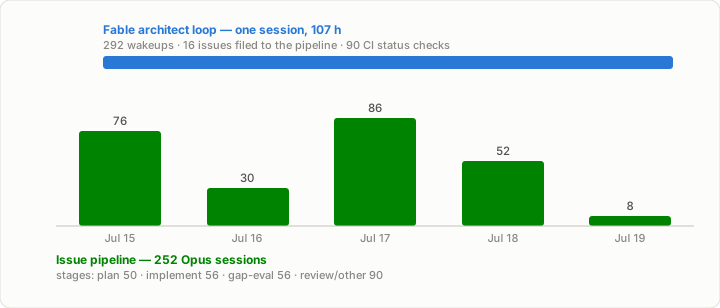
H1, revideret — Bekræftet i projektmålestok. Tæl begge kanaler med, og billedet vender: pipelinen tastede 10× flere output-tokens end det arkitekt-loop, der udsendte den (9,07 mio. mod 877k), alt til Opus-takster. At køre den implementeringsbølge på arkitektens model ville have kostet 2,1× så meget — på ét redesign, i én uge, før man tæller subagenterne i sessionen med. Et issue er bare en grovere brief: samme interface, samme økonomi, ét niveau op.
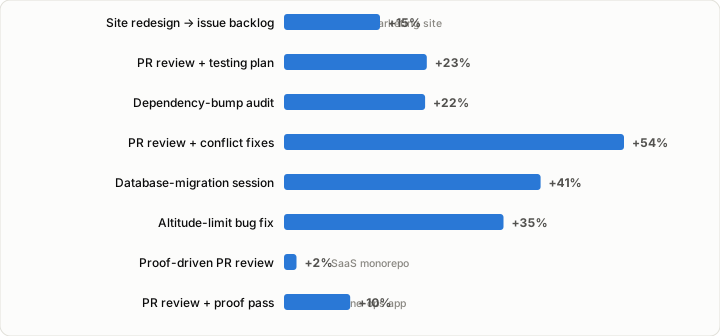
H2 — Bekræftet, med et twist. En omprisning af implementørernes præcise tokenvolumener til arkitektmodellens takster gør hver session dyrere — fra +2 % til +54 %, 17 % på tværs af de otte øverste. Rigtige penge, men mindre, end det 2× store outputprisgab antyder. Twisten: output er ikke der, pengene går hen. I den største session kostede arkitektens cache-læsninger omkring 13× så meget som alt, den tastede — det dominerende forbrug er den dyre model, der holder og genlæser en stor orkestreringskontekst, ikke tastetryk. Delegering sætter loft over outputregningen; den næste løftestang er at holde arkitektens kontekst slank.
H3 — Ikke målt her. Tokenbogføring kan ikke se kodekvalitet. Det, vi kan sige observationelt: review-loopet er bærende — rapporter og diffs er uenige ofte nok til, at det er ufravigeligt at læse begge — og rettelser, der sendes tilbage til en kontekstvarm agent, konvergerer hurtigt. Hvis du replikerer dette og måler omarbejde ordentligt, vil vi gerne se det, især hvis det modbeviser os.
Hvad de bredere data lærte os
- Adoption er en gradient, ikke en kontakt. På droneops-appen — mindre og hurtigere bevægelig — kører 18 % af sessionerne fable-architect-mønsteret; på det ældre SaaS-monorepo er det 9 %. Projektet, der delegerede mest, gjorde det i begge kornstørrelser på én gang: implementør-briefs i sessionen og 252 pipeline-sessioner udsendt gennem issue-trackeren.
- CI-flåden kører ikke skillen — fordi den er implementøren. Vores automatiserede runner-sessioner starter aldrig en implementør-subagent, og i starten læste vi det som manglende adoption. Prompterne siger noget andet: hver eneste er et pipeline-stadium — verify, review, gap-evaluering — og cirka seks ud af ti arbejder mod et specifikt issue eller PR. I projektmålestok er pipeline-runnerne implementørtrinnet.
- Det billigste trin har ikke haft sin første arbejdsdag endnu. Alle 78+ implementør-kørsler var Opus-klasse; Sonnet-trinnet til mekaniske redigeringer blev først tilføjet for nylig og er aldrig blevet aktiveret. Uanset hvilke besparelser dette måler, er de et gulv.
Interfacet er pointen: brief ind, diff ud — issue ind, PR ud. Den dag prisstigningen lander, skifter du mureren ud, ikke processen.
Fuld åbenhed. Modeller verificeret ud fra transskriptionsstrenge, ikke antaget. Vi rettede os selv to gange (en overoptælling af tokens pr. linje, derefter en pladsholder-pristabel). Kontrafaktualiteten antager, at arkitekten ville have brugt de samme tokenvolumener, som implementørerne gjorde — fejlmargener løber i begge retninger. Pipeline-sessionerne ligger i et transskriptionslager, som vores første to mining-gennemløb ikke havde afgrænset; en bogføringsgænse skjulte en delegationskanal på 9 mio. tokens for os, og din har sandsynligvis også en. Én engineers projekter, mest review-and-fix og feature-arbejde — ikke et kontrolleret benchmark. Korpuset lukker desuden, før Opus 5 blev udgivet: hver figur ovenfor er Fable-som-arkitekt over implementører af Opus-4-klasse. Trinnenes priser flyttede sig ikke, da Opus 5 landede, så de målte forhold holder — men se næste afsnit for, hvad der til gengæld flyttede sig.
Opdatering — stigen flyttede sig under os
Opus 5 blev udgivet, efter disse målinger blev lukket, og intet i prisstigen ændrede sig: Opus er stadig $5/$25 pr. million input-/output-tokens, Fable er stadig $10/$50, og diagrammet ovenfor er stadig korrekt. Det, der ændrede sig, er kapaciteten på hvert trin. Anthropic positionerer Opus 5 som et spring i dyb ræsonnering og langhorisont-agentarbejde — det vil sige på præcis det arbejde, som arkitektrollen består af, til halvdelen af arkitekttrinnets pris.
Det peger direkte på vores eget H2-twist. Hvis den dominerende arkitektomkostning er cache-læsninger, og cache-læsninger faktureres til 10 % af inputprisen, så genlæser en arkitekt, der kører på Opus 5, sin orkestreringskontekst til $0,50 pr. million tokens i stedet for Fables $1,00. Den post, der kostede 13× alt, hvad arkitekten tastede, halveres. Vi har ikke målt dette — det er aritmetik under den samme antagelse om ensartede tokenvolumener, som vi flaggade for 2,1×-kontrafaktualiteten, og det er det næste, vi har tænkt os at teste. Hvis det holder, ophører det interessante spørgsmål med at være hvilke modeltyper og bliver hvorvidt arkitekten overhovedet har brug for det øverste trin.
Tre ting ved det nye implementørtrin ændrer selve mønsteret, ikke bare dets pris:
- Den griber hurtigt efter subagenter — det modsatte af sin forgænger, som måtte overtales til at delegere overhovedet. En implementør, der stille og roligt starter sine egne implementører, mangedobler regningen, uden at nogen holder øje. Deraf
Delegation:-linjen i briefen: en slice angiver nu, om den må forgrene sig, og hvor bredt. - Den verificerer sit eget arbejde uopfordret. Verifikationsinstruktioner skrevet til ældre modeller køber nu et overflødigt andet gennemløb, så de ryger ud af briefs. Arkitektens review-loop er urørt.
- Den udvider scope.
Out of scope:holder op med at være boilerplate og bliver den linje, der holder en slice som en slice.
Og det trin, vi aldrig brugte, blev skarpere, mens vi ikke kiggede: Sonnet 5 nærmer sig Opus-kvalitet på kodearbejde til $3/$15, med introduktionspriser under det frem til udgangen af august. “Uanset hvilke besparelser dette måler, er de et gulv” var et forbehold, da vi skrev det. Det læses som en underdrivelse nu.
Del 3 — Hvor det bevidst er på vej hen
Vi styrer med vilje mod en opdeling, som vi tror, enhver engineering-organisation til sidst tvinges ind i: dyre frontier-modeller kun til brainstorming, arkitektur og review; stadig billigere modeller til selve programmeringen. I dag er vores implementører Opus-klasse. Intet i workflowet ændrer sig, når de bliver Sonnet-klasse, DeepSeek-klasse eller Kimi-klasse — interfacet er modelagnostisk af konstruktion. Det er hele den strategiske værdi: den dag subsidiet slutter og regningen fordobles, ændrer teams med denne disciplin én konfigurationslinje. Teams uden den genforhandler hele deres omkostningsstruktur under pres.
Fable-architect er et babyskridt — adoptionen er delvis, og det billigste trin har ikke set sin første kørsel. Men det er skridtet, der opbygger musklen: at skrive briefs, der fuldt ud specificerer en slice, at reviewe diffs, du ikke selv har tastet, at behandle den dyre models opmærksomhed som et budget. Og redesign-bølgen viser, hvor musklen fører hen: når briefs virker, virker issues også, og den dyre model holder helt op med at deltage i implementeringen.
Hvad du kan gøre på mandag
- Opdel rollerne i dit agent-harness. Én regel på sessionsniveau: frontier-modellen planlægger og reviewer; deleger alle filredigeringer til en billigere implementør-agent. I Claude Code er det en skill plus subagent-definitioner — en eftermiddag med opsætning.
- Gør grænsen mekanisk. Tilføj en pre-edit-hook, der udfordrer den dyre models egne filskrivninger. En regel, der ikke koster noget at bryde, bliver brudt inden fredag.
- Skriv briefs med en fast skabelon. Mål, kontekst, filer, design, begrænsninger, out-of-scope, delegationsbudget, verify. Skabelonen er disciplinen — og delegationsbudgettet er det, der forhindrer en implementør i stille at ansætte sine egne.
- Review både rapporten og diffet. Stol aldrig på noget af det alene; kør de verifikationskommandoer igen, der betyder noget.
- Mål din egen opdeling. Dine transskriptioner indeholder allerede dataene — gruppér efter request, prissæt efter model, og se hvem der faktisk taster. Vores viste os et ubrugt billigt trin og en delegationskanal på 9 mio. tokens, vi ikke kendte til.
- Udvid interfacet fra briefs til issues. En brief delegerer en times arbejde; et issue delegerer en dag. Når dine issues bærer acceptkriterier, som en pipeline kan handle på, kan den dyre model oprette arbejde i trackeren og supervisere i stedet for at sidde i loopet for hver slice.
- Hold en udvej varm. Kør en billig eller åben model som implementør på én lavrisiko-slice om ugen. Portabilitet, du aldrig bruger, er portabilitet, du ikke har.
- Ompris arkitekten, ikke bare mureren. Hver modeludgivelse flytter trinnene uden at flytte stigen. Hvis størstedelen af dit arkitektforbrug er kontekst frem for tastetryk, er et billigere arkitekttrin mere værd end et billigere implementørtrin — tjek, hvilket af dem dine egne transskriptioner siger, du køber.
Laboratorierne vil fortsætte med at fortælle os, at deres topmodeller er enhver pris værd, og — irriterende nok — for dømmekraftsarbejde har de for det meste ret. Trækket er ikke at afstå. Det er at holde op med at betale frontier-priser for for-loops.
