


Die Kurzfassung
- Ich habe ein echtes Issue aus dem FlowHunt-Backlog genommen und Claude Code dazu gebracht, es 13-mal auf Opus 5.5 umzusetzen – unter sieben verschiedenen Anweisungs-Setups. Jeder Lauf startete vom selben Commit, in seinem eigenen Clone mit eigener Datenbank, und lief durch unsere echte GitHub-CI. Zwei blinde Opus-Reviews bewerteten jedes Ergebnis.
- Die 33 KB große CLAUDE.md des Repositories brachte keine messbare Qualität. Läufe damit kamen auf 2,0 Blocker- und Major-Findings pro Review. Ein Lauf ganz ohne Anweisungsdatei kam auf dasselbe. Eine 5,5 KB große Datei kam auf 1,0.
- Eine separate Planungsphase machte es schlimmer. Beide Setups, die einen Planungs-Prompt und dann einen Implementierungs-Prompt ausführten, kosteten mehr als ihre Zwillinge mit schlichtem Prompt, und sie produzierten vier der fünf Blocker über alle 26 Reviews hinweg.
- Der Gewinner war eine 8 KB große CLAUDE.md, drei Skills, Sonnet-Worker und ein schlichter Prompt. Seine zwei Läufe kosteten im Schnitt 6,68 $ zum API-Listenpreis. Das volle Setup mit den Pipeline-Prompts kostete im Schnitt 11,49 $, etwa 1,7-mal so viel, und hatte mehr Findings.
- Was von all der Struktur, die ich gebaut hatte, übrig geblieben ist, ist das Briefing: eine kurze, entschiedene Beschreibung eines Arbeitsabschnitts, die das Hauptmodell für einen günstigeren Worker schreibt. Pläne für das Hauptmodell selbst haben sich nicht ausgezahlt. Das Modell plant von allein gut genug.
Dieser Beitrag knüpft an den Post Architect-Pattern an, der gemessen hat, wer den Code tippen sollte. Dieser hier fragt, wie viel man dem Hauptmodell sagen muss, bevor es loslegt.
Warum ich das getestet habe
Unser Monorepo hatte eine Menge Agent-Anweisungen angesammelt. Die Root-CLAUDE.md war 33 KB groß: Build-Befehle, Test-Rhythmus, Code-Stil, Architektur, kritische Pfade, Sicherheitsregeln, Berechtigungs- und Credit-Regeln, die zwei Agent-Oberflächen, Issue-Anlage, PR-Konventionen. Zehn Skills lagen unter .claude/skills/. Dazu kam, dass unsere CI-Pipeline (wir nennen sie harnext) ein Issue durch einen Tagger, einen Triage-Schritt, einen Planungsschritt, der einen Plan als Issue-Kommentar schrieb, und einen Implementierungsschritt schickte, der den Plan zurücklas und den Code schrieb – jeder mit seinem eigenen langen System-Prompt.
Jede Zeile davon wurde aus einem Grund hinzugefügt, meistens nachdem ein Agent etwas falsch gemacht hatte. Die Frage, die niemand gestellt hatte, war, ob es noch half. Eine CLAUDE.md wird in jede Session geladen und in jedem Turn erneut gesendet. Wenn das Modell ohnehin das Richtige getan hätte, sind diese Tokens eine Steuer, und wie Was ein Kontextfenster kostet erklärt, summiert sich eine Steuer auf jeden Turn schneller, als es aussieht.

Bereit, Ihr Geschäft zu erweitern?
Starten Sie heute Ihre kostenlose Testversion und sehen Sie innerhalb weniger Tage Ergebnisse.
Der Test
Das Issue war eine zeitgesteuerte E-Mail-Sequenz für neue Anmeldungen: Ein Admin definiert Schritte wie „Tag 0: Willkommen“ und „Tag 5: Deine Testphase endet bald“, und ein Hintergrundtask mailt jedes Konto am richtigen Tag an, stoppt, sobald die Person einen bezahlten Plan kauft, und überspringt Konten, die vor dem Launch angelegt wurden. Es braucht eine Migration, ein Repository, einen Service, einen Celery-Beat-Task, REST-Endpunkte, MCP-Tools für Agents und eine Konsolen-UI in 11 Sprachen. Das ist ein realistisches Feature für die erste Woche, und es hat mehrere Edge Cases, die leicht übersehen werden.
Jeder Lauf war eine headless Claude-Code-Session auf Opus 5.5, abgeschottet in seinem eigenen Clone und seiner eigenen Datenbank, mit einem Skript, das den Commit in einen Draft-PR pushte und das CI-Ergebnis bis zu drei Runden lang in die Session zurückspielte. Die Kosten sind Claude Codes eigener total_cost_usd für die Hauptsession plus jeden Subagenten, zum API-Listenpreis. Ich zahle ein Abo, es ist also ein Maß für die Arbeit, nicht für meine Rechnung.
Die sieben Setups:
| Setup | Läufe | |
|---|---|---|
| A | Volle 33 KB CLAUDE.md und zehn Skills, Pipeline-Prompts (planen, dann umsetzen) | 2 |
| B | Volle CLAUDE.md und Skills, schlichter Prompt | 3 |
| C | Keine CLAUDE.md, keine Skills, schlichter Prompt | 2 |
| D | Volle CLAUDE.md plus den architect-Skill, schlichter Prompt | 2 |
| E | 8 KB CLAUDE.md, architect, grain-ponytail und unslop, Pipeline-Prompts | 1 |
| F | 5,5 KB CLAUDE.md, keine Skills, schlichter Prompt | 1 |
| G | 8 KB CLAUDE.md, architect, grain-ponytail und unslop, schlichter Prompt | 2 |
A bis D kamen zuerst. E bis G wurden aus deren Ergebnissen gebaut, und der dritte B-Lauf lief als Kontrolle daneben mit. Die 8-KB-Datei ist die 5,5-KB-Datei plus eine kurze Liste der Skills und wann sie geladen werden, plus die Modell-Routing-Regeln, die den architect-Skill an Sonnet delegieren lassen.
Jedes Ergebnis ging dann an zwei Opus-Reviewer, die nur einen Buchstaben, das Diff, das Repository und das Issue sahen. Sie listeten jede Änderung auf, die sie vor einer Freigabe verlangen würden, bewerteten sie als Blocker, Major, Minor oder Nit und prüften jedes Akzeptanzkriterium anhand von Datei und Zeile.
Kosten
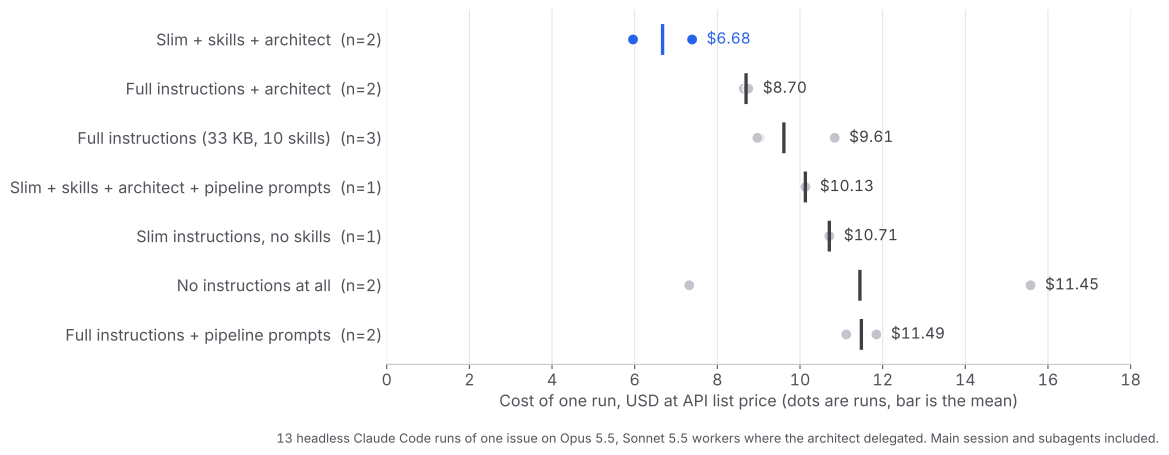
Das Gewinner-Setup G kostete 5,96 $ und 7,39 $. Das volle Setup mit Pipeline-Prompts, A, kostete 11,12 $ und 11,85 $. Die Lücke besteht überwiegend aus Turns und daraus, was jeder Turn mit sich trägt. Die Hauptsessions von A liefen 172 und 144 Turns auf Opus mit 24 bis 28 Millionen Input-Tokens. Die von G liefen 79 und 95 Turns mit 13 bis 16 Millionen und gaben etwa 60 weitere Turns an Sonnet-Worker ab, die zu einem Bruchteil des Satzes abgerechnet werden. G erledigte seine Arbeit außerdem in etwa 21 Minuten gegenüber 45 bei A.
Zwei Dinge in diesem Chart haben mich überrascht. Gar keine Anweisungen ist nicht die günstige Option: Seine zwei Läufe kosteten 7,32 $ und 15,58 $, und der teure davon fiel auch noch durch die CI und schrieb das größte Diff des Tests. Und die 5,5-KB-Datei ohne Skills, F, war nicht günstiger als das volle Setup. Sie schrieb mehr Code, 1.601 Produktzeilen, und bezahlte dafür. Die Ersparnis in G kommt nicht allein von der kurzen Datei. Sie kommt von der kurzen Datei plus den zwei Skills, die ändern, wie die Arbeit gemacht wird.
Abonnieren Sie unseren Newsletter
Erhalten Sie die neuesten Tipps, Trends und Angebote kostenlos.
Qualität
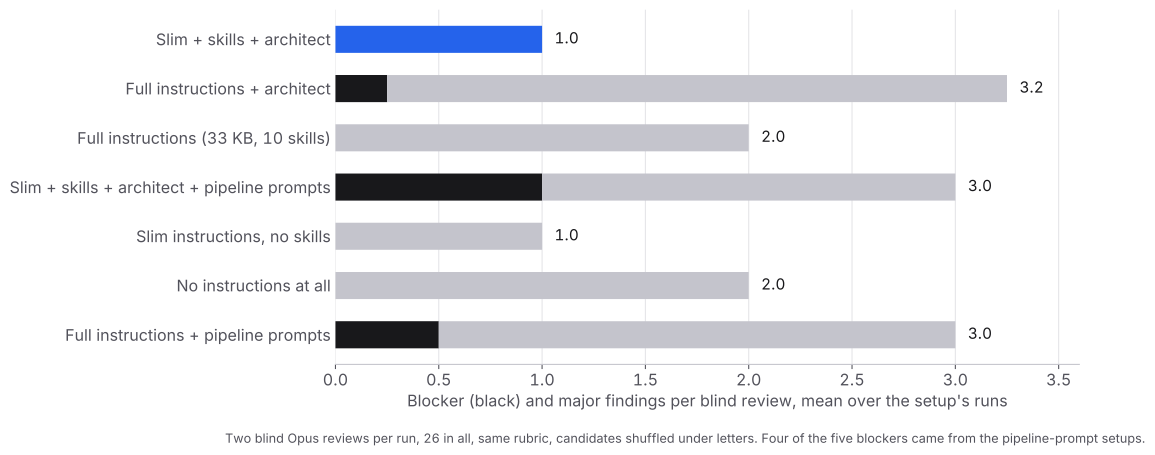
Das günstigste Setup hatte auch die wenigsten schwerwiegenden Findings: keine Blocker und 1,5 bzw. 0,5 Majors pro Review in seinen zwei Läufen. Die volle CLAUDE.md, B, lag in allen drei Läufen bei 2,0 Majors – genauso wie gar keine CLAUDE.md.
Das ist das Ergebnis, das mir am wichtigsten ist. Die Datei hat lange Abschnitte zu Sicherheit, Berechtigungen und Credits, geschrieben, weil ein Agent sie einmal übersprungen hatte. Mit und ohne die Datei fanden die Reviewer dieselbe Anzahl schwerwiegender Probleme, und dieselben Arten kamen über die Setups hinweg wieder: eine Anmeldung, die zahlt und dann kündigt; eine E-Mail, die verloren geht oder doppelt gesendet wird, wenn ein Worker mittendrin scheitert; ein Editor, der Inhalte überschreibt, die er nicht anzeigen kann. Das sind Denklücken beim Zustand über die Zeit. Keine Regelliste in der CLAUDE.md deckte sie ab, denn man kann keine Regel für einen Edge Case schreiben, an den man noch nicht gedacht hat.
Was sie abdeckte, war eine Änderung am architect-Skill zwischen den Runden. Bevor das Hauptmodell ein Briefing schreibt, schreibt es jetzt eine Tabelle: jedes Akzeptanzkriterium, was passiert, wenn sich der Zustand, von dem es abhängt, über die Zeit ändert, und das entschiedene Verhalten. Jede Zeile geht dann mit einem benannten Test in das Briefing ein. Die Läufe von G schrieben 774 und 818 Testzeilen, gegenüber 510 bis 670 bei B.
Die Planungsphase
A und E sind die zwei Setups, die die Prompts unserer CI-Pipeline ausführten: ein Planungs-Prompt, der einen Plan schreibt, dann ein Implementierungs-Prompt, der den Plan liest und ausführt. Vergleiche jedes mit seinem Zwilling, der stattdessen einen schlichten Prompt bekam. A kostete 11,49 $ pro Lauf gegenüber 9,61 $ bei B und hatte Blocker, wo B keine hatte. E kostete 10,13 $ gegenüber 6,68 $ bei G und hatte in jedem seiner Reviews einen Blocker, wo G keinen hatte.
Ich denke, der Grund ist, dass ein Plan ein Dokument ist, das das Modell für sich selbst schreibt und dann als fremde Anweisung zurücklesen muss. Die zweite Session behandelt den Plan als Spezifikation, folgt ihm dort, wo er falsch ist, und verbringt Turns damit, ihn mit dem abzugleichen, was sie im Code findet. Ein so fähiges Modell plant besser innerhalb der Session, die die Arbeit gleich erledigt, wo Plan und Code im selben Kontext liegen.
Der Teil der Planung, der überlebt hat, ist das Briefing. Wenn das Hauptmodell einen Abschnitt an einen Sonnet-Worker übergibt, startet der Worker mit leerem Kontext und baut genau das, was ihm gesagt wird. Diese Übergabe braucht eine geschriebene, entschiedene Beschreibung: das Ziel, die Dateien, das zu spiegelnde Muster, die Edge Cases, den zu schreibenden Test. Ein Plan für sich selbst ist Overhead. Ein Briefing für jemand anderen ist der einzige Weg, die Arbeit herüberzubringen.
Was grain-ponytail bewirkt hat
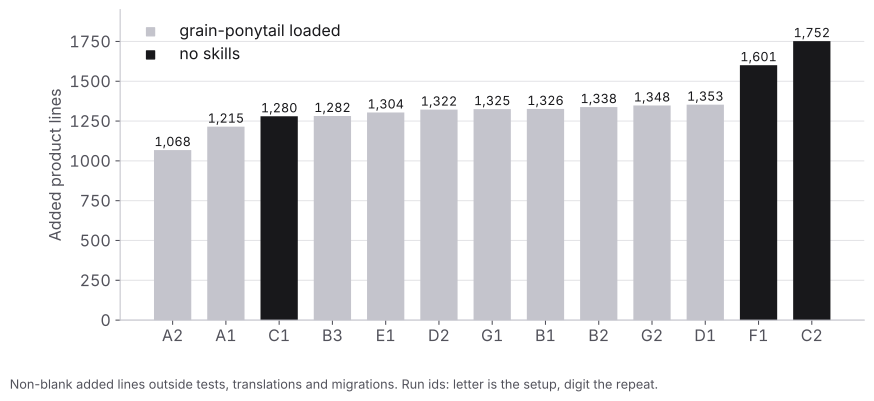
Der Skill aus code with the grain sagt dem Modell, das nächstgelegene vorhandene Beispiel zu spiegeln und den kleinsten Code zu liefern, der funktioniert. Jeder Lauf, der ihn geladen hatte, schrieb zwischen 1.068 und 1.353 Produktzeilen. Die zwei größten Diffs, 1.601 und 1.752, kamen aus Läufen ohne Skills. Ein Lauf ohne Skills blieb bei 1.280, der Skill entscheidet die Größe also nicht allein, aber er entfernte den Ausläufer.
Er ist auch das klarste Beispiel dafür, welche Art von Anweisung sich noch auszahlt. „Das nächstgelegene Beispiel spiegeln“ ändert, was das Modell in jeder Datei tut, die es schreibt. „Verwende snake_case für Funktionen“ wiederholt etwas, das es ohnehin schon tut.
Was die Reviews trotzdem fanden
Der Gewinnerlauf war nicht sauber. Nach dem Test habe ich G2s Arbeit auf main rebased und durch unseren vollen PR-Check geschickt, der das Diff reviewt, jedes Finding mit einem fehlschlagenden Test beweist und die Änderung in einem echten Browser durchspielt. Er fand, dass der Schritt-Editor jeden Block außer dem ersten HTML-Block verwarf, wenn ein Admin einen über MCP erstellten Schritt bearbeitete, und dass ein fehlgeschlagenes Freigeben eines Anspruchs manchen Nutzern die E-Mail doppelt schicken konnte. Beides wurde mit Tests behoben, bevor der PR zum menschlichen Review ging.
Die blinden Reviewer bemängelten außerdem mehr Over-Engineering in den architect-Läufen als in denen mit vollen Anweisungen: 2,5 Punkte pro Review bei G gegenüber 0 bis 1,0 bei den Läufen von A und B. Weniger schwerwiegende Findings, mehr Nits. Ich würde diesen Tausch eingehen, aber es ist ein Tausch.
Was ich geändert habe
- Die 33 KB große CLAUDE.md wurde zu einer 12 KB großen AGENTS.md, die auch Codex liest, und CLAUDE.md importiert sie jetzt nur noch. Sie behält die Befehle, den Test-Rhythmus, die Architektur und die Regeln, die ein Modell nicht aus dem Code ableiten kann, etwa welche Pfade kritisch sind und dass die zwei Agent-Oberflächen im Gleichschritt bleiben müssen.
- Die Planungsphase ist aus der Pipeline verschwunden. Die Triage übergibt das Issue direkt an eine Implementierungsphase, deren Prompt auf sechs Schritte geschrumpft ist: Issue lesen, branchen, die Skills architect und grain-ponytail laden, testen, committen, einen Draft-PR öffnen.
- Der architect-Skill bekam die Edge-Case-Tabelle, ein Feld Tests im Briefing und einen letzten Durchgang, der das gesamte Diff gegen das Issue prüft statt gegen die Briefings. Diese Version ist öffentlich unter github.com/LivinTribunal/architect-skill .
Die Änderung am Repository ist zum Zeitpunkt des Schreibens im Review.
Was man daraus mitnehmen sollte
Wenn deine CLAUDE.md Vorfall für Vorfall gewachsen ist, bezahlt sie wahrscheinlich für Regeln, die das Modell ohnehin befolgt. Kürze sie auf das, was das Modell nicht durch Lesen des Codes herausfinden kann, und miss vorher und nachher an einer echten Aufgabe, statt darauf zu vertrauen, dass mehr Anleitung sicherer ist.
Behalte die Anweisungen, die ändern, wie die Arbeit gemacht wird: wer den Code tippt, wie ein Abschnitt gebrieft wird, welches vorhandene Muster kopiert wird. Wirf die Planen-dann-Ausführen-Pipeline weg, wenn dein Hauptmodell ein aktuelles Frontier-Modell ist. Schreibe Briefings für Worker, keine Pläne für dich selbst.
Methode
13 headless Läufe von Claude Code 2.1.289 am 5. Oktober 2026, Hauptmodell Opus 5.5, Worker Sonnet 5.5, wo der architect-Skill delegierte. Alle Läufe starteten von einem Commit des FlowHunt-Monorepos, jeder in einem APFS-Clone mit eigener Postgres-Datenbank, abgeschottet von den anderen Läufen und von den Dateien des Experiments selbst. Ein Broker pushte den Commit jedes Laufs in einen Draft-PR gegen einen eingefrorenen Basis-Branch und setzte die Session mit dem CI-Ergebnis fort, bis zu drei Runden. Die Kosten sind der maximale total_cost_usd pro Session, summiert über die Hauptsession und ihre Subagenten. Produktzeilen sind nicht leere hinzugefügte Zeilen außerhalb von Tests, Übersetzungen und Migrationen.
Jedes Ergebnis bekam zwei blinde Reviews durch Opus mit einer Rubrik: Korrektheit, Akzeptanzkriterien, Grain, private Felder und verborgener Zustand, Over-Engineering, Sicherheit und Berechtigungen, Tests, Migrationen. Die Kandidaten wurden unter Buchstaben gemischt, und die Reviewer konnten das Repository lesen, aber nichts ausführen. Findings pro Review sind über die Läufe eines Setups gemittelt. Bei ein bis drei Läufen pro Setup ist der Mittelwert eines einzelnen Setups als verrauscht zu betrachten. Die obigen Schlussfolgerungen sind die, die über beide Runden hinweg Bestand hatten.
