

Wichtigste Erkenntnisse
- Das Schreiben von Code ist nicht mehr der langsame Teil. In 31 Tagen hat unser Hauptrepository 473 Pull Requests zusammengeführt. 130 davon benötigten jemanden, der zurückkommt und Main in den Branch zusammenführt – insgesamt 239 Merge-Commits, und 238 davon wurden von einer Person erstellt.
- Die PRs, die dies brauchten, dauerten vom Öffnen bis zum Zusammenführen im Durchschnitt 44 Stunden. Die, die es nicht brauchten, dauerten 2 Stunden. Von den 60 PRs, die länger als drei Tage offen blieben, brauchten 51 mindestens eine Zusammenführung von Main.
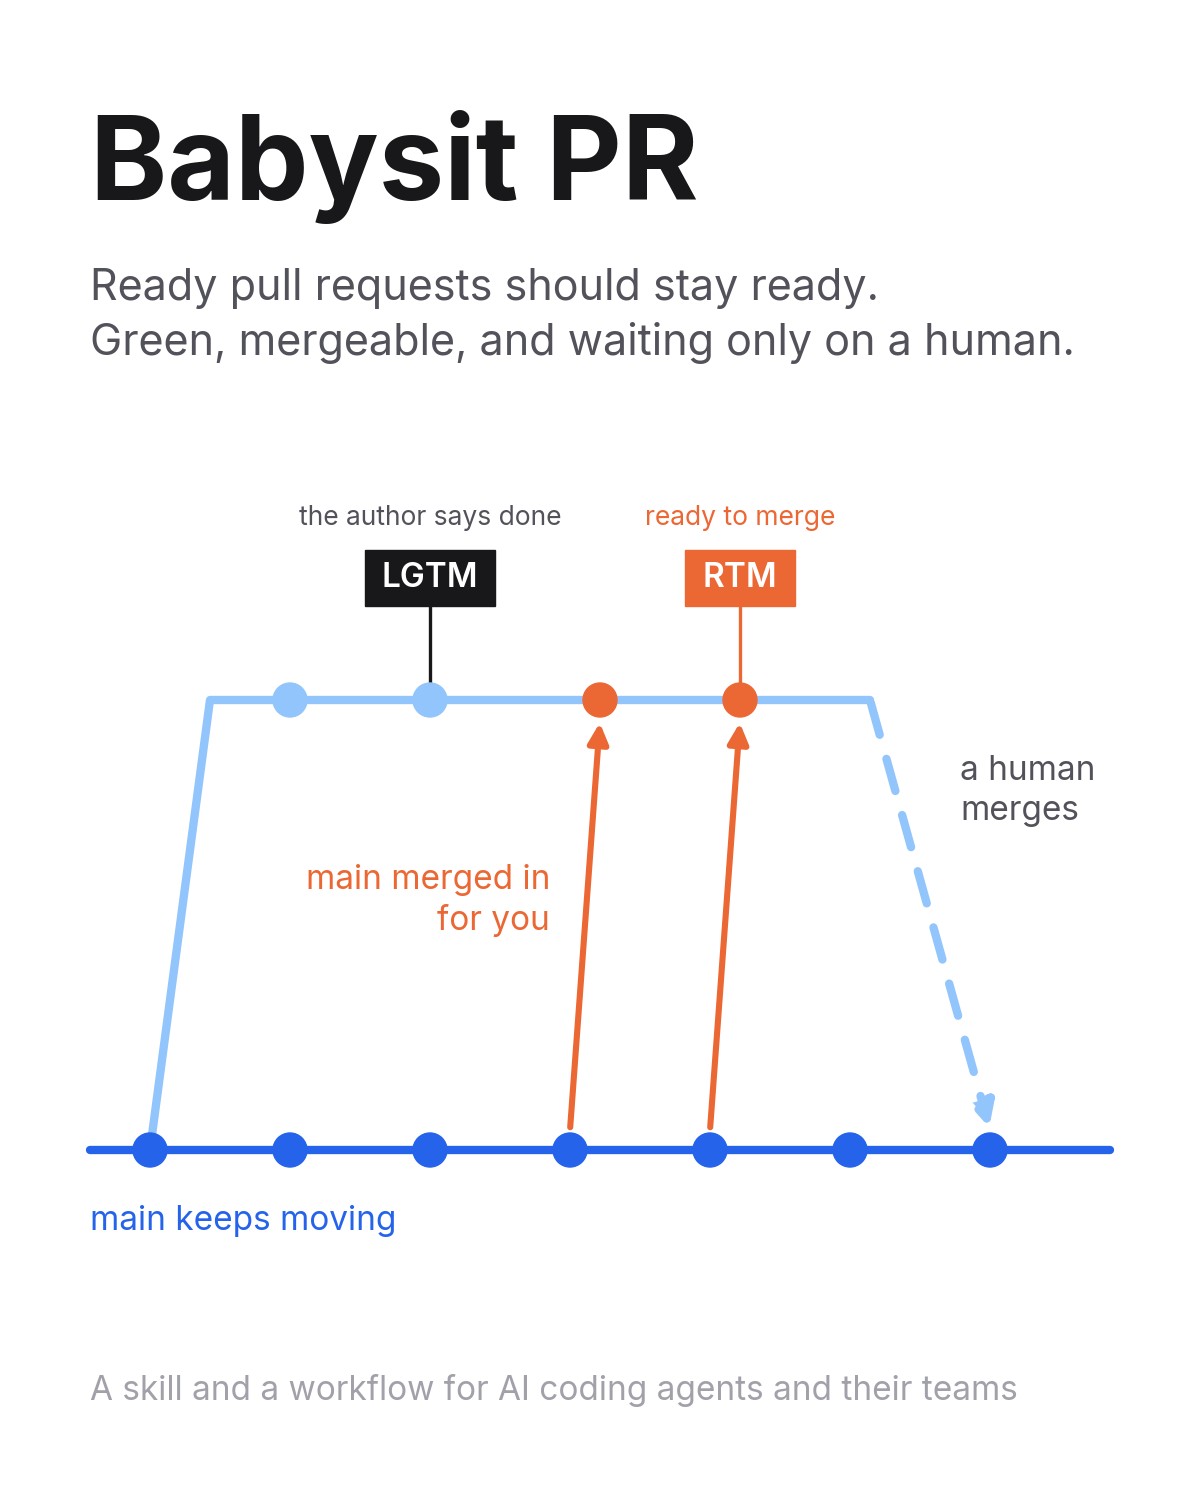
- babysit-pr teilt die Arbeit an einem Label auf:
LGTM, „looks good to me" (sieht gut aus), das der Autor hinzufügt, wenn die Arbeit erledigt ist. Davor hält eine Fähigkeit den Agenten auf dem PR, bis CI grün ist und jeder Review-Bot beantwortet ist. Danach hält ein GitHub Actions-Workflow den PR mergebar, bis eine Person ihn zusammenführt, und fügtRTM, „ready to merge" (bereit zum Zusammenführen), hinzu, sobald jemand anderes als der Autor genehmigt. - Der Workflow führt niemals zusammen, schließt niemals und ändert niemals eine Zeile, die der Autor geschrieben hat. Ein Konflikt, den er nicht um den Code des Autors herum auflösen kann, geht als
REWORKan den Autor zurück. - Die Fähigkeit ist öffentlich, unter der MIT-Lizenz: babysit-pr-skill auf GitHub , mit dem Watcher-Skript und dem Design des Workflows. Der Workflow selbst läuft noch im Testmodus auf unserem Repository, und ich erkläre unten, warum.
Warum werden fertige Pull Requests veraltet?
Das Schreiben von Code ist nicht mehr der langsame Teil. Mit dem Architect-Muster und Agenten, die das meiste der Eingaben machen, nimmt unser Repository etwa 13 Commits pro Tag in Main auf. Das ist gut zum Versand und schlecht für jeden offenen Pull Request, weil jeder dieser Commits einen PR in Konflikt bringen oder sein CI rot machen kann.
Ich habe die letzten 31 Tage der zusammengeführten PRs gezogen, um zu sehen, wo die Zeit verbracht wurde.
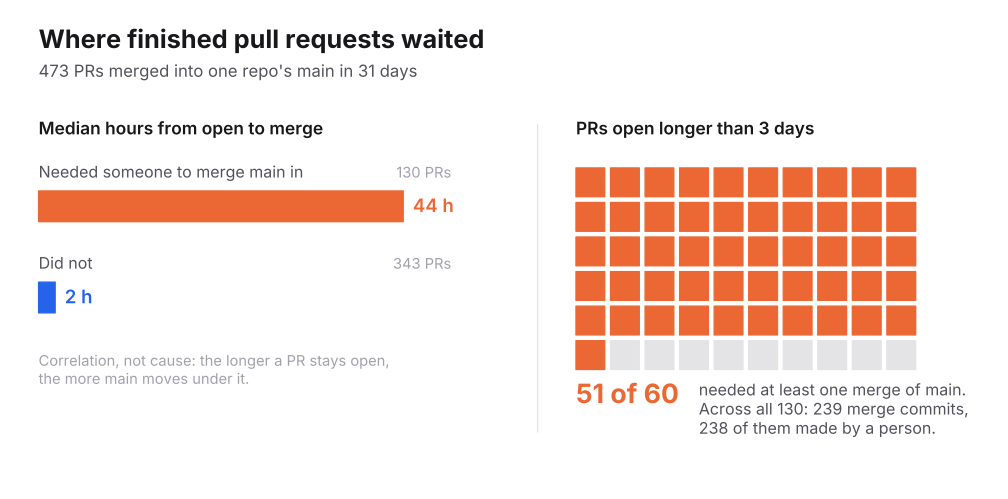
Die 44 gegen 2 ist eine Korrelation, keine Ursache. Ein PR, der länger offen bleibt, gibt Main mehr Zeit, sich darunter zu bewegen, daher ist es wahrscheinlicher, dass er eine Zusammenführung braucht. Aber die Zusammenführungen selbst sind echte Arbeit, die jemand 239 Mal im Monat gemacht hat. Fünf Personen machten 238 davon von Hand. Ein PR brauchte acht Zusammenführungen von Main über die sieben Tage, die er offen war.
Die Genehmigung selbst war schnell. Sobald ein PR seine erste Genehmigung erhielt, betrug die mittlere Zeit bis zur Zusammenführung null Stunden. Das Warten geschah davor: Der Autor war fertig, dann saß der PR, bis ein Reviewer ihn öffnete, und während er saß, bewegte sich Main. Wir begannen am 20. Oktober, fertige PRs mit LGTM zu beschriften. Die 20, die seitdem zusammengeführt wurden, warteten im Durchschnitt 38 Stunden zwischen LGTM und Zusammenführung, und einer von vier wartete mehr als 78 Stunden.
Das ist die Lücke, die dies füllt. Niemand ist hier leichtfertig. Der Autor denkt, sie sind fertig, der Reviewer hat ihn noch nicht geöffnet, und der Branch verwittert dazwischen.

Bereit, Ihr Geschäft zu erweitern?
Starten Sie heute Ihre kostenlose Testversion und sehen Sie innerhalb weniger Tage Ergebnisse.
Warum nicht veraltete Pull Requests mit actions/stale schließen?
Die übliche Antwort auf veraltete Pull Requests ist actions/stale : Eine GitHub Action, die nach einer festgelegten Anzahl von Tagen der Inaktivität ein Stale-Label zu Issues und Pull Requests hinzufügt und sie automatisch einige Tage später schließt, es sei denn, jemand kommentiert oder pusht.
Das passt zu einem Pull Request, an dem niemand arbeitet. Es tut nichts für die, die wir hatten. Die unseren waren fertige Arbeit, die veraltet waren, während sie auf einen Reviewer warteten, weil sich Main darunter bewegte. Sie zu schließen, wirft die Arbeit weg, und ein Stale-Label sagt dem Autor, was sie bereits wissen. Was der PR braucht, ist jemand, der Main zusammenführt, den roten CI-Job erneut ausführt und ihn grün hält, bis eine Person ihn genehmigt. Also statt veraltete Pull Requests zu schließen, halten wir sie mergebar.
Wie babysit-pr Pull Requests mergebar hält
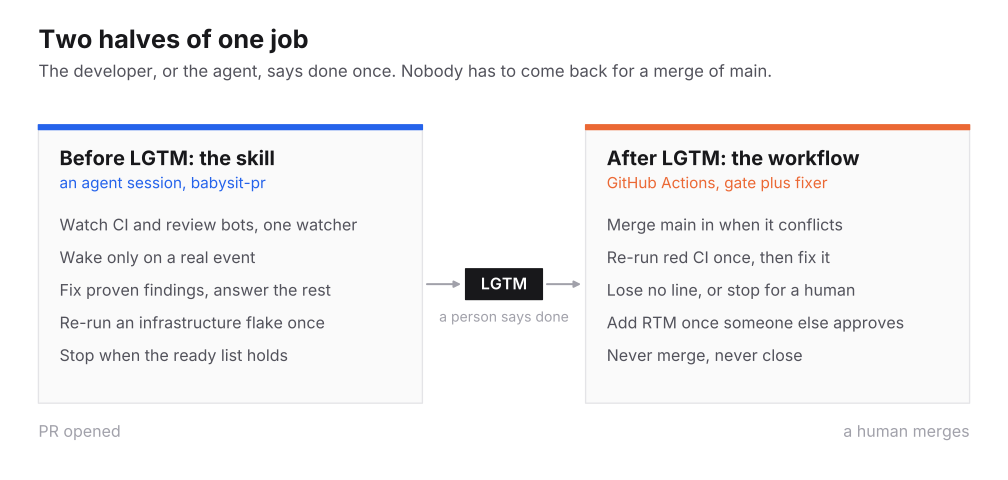
Die Aufteilung folgt, wer wartet. Vor LGTM ist der Autor noch auf dem PR, normalerweise eine Agent-Sitzung, und die Fähigkeit hält diese Sitzung mit nützlicher Arbeit, anstatt den Sieg zu erklären, wenn der Code kompiliert. Nach LGTM ist der Autor weitergegangen, daher geht die Arbeit zu etwas, das ihn nicht braucht: ein Workflow, der läuft, ob jemand hinschaut oder nicht.
LGTM steht für „looks good to me" (sieht gut aus). Bei den meisten Teams sagt ein Reviewer das über jemand anderen Code. Hier legt der Autor es als Label auf seinen eigenen PR, was bedeutet „Ich bin fertig, es gibt nichts mehr für mich zu tun". Es ist das Wort einer Person: Der Agent fügt es nur hinzu, wenn es angewiesen wurde, den PR zu übergeben. Dieses Label ist das Opt-in für alles danach, und es ist das, was einen Entwickler damit komfortabel macht, einen Bot seinen Branch pushen zu lassen.
Abonnieren Sie unseren Newsletter
Erhalten Sie die neuesten Tipps, Trends und Angebote kostenlos.
Vor LGTM: Eine Claude Code-Fähigkeit trägt den PR zur Bereitschaft
Die Fähigkeit begann als babysit-pr Fähigkeit in Theo Brownes tstack
. Ich behielt seinen Watcher und seine Kernregeln und änderte, wo er stoppt.
Ein Watcher pro Pull Request
pr-wait fragt einen Pull Request ab und druckt eine Zeile pro echtem Ereignis: ein Check ist fehlgeschlagen, alle Checks sind fertig, jemand hat kommentiert oder überprüft, Main hat sich unter Dateien bewegt, die dieser PR berührt, der Branch ist hinterhergehinkt oder in Konflikt, der PR ist zusammengeführt. In Claude Code läuft er unter dem Monitor-Tool, daher weckt jede Zeile den Agenten einmal auf. Ein Ereignis, das keine Aktion braucht, endet den Zug ohne Nachricht. „Immer noch warten" ist keine Neuigkeit, und ein Agent, der das 50 Mal sagt, füllt seinen eigenen Kontext mit nichts.
Den roten CI-Job sortieren, bevor der Code berührt wird
Es gibt vier Arten von Rot, und nur eine ist eine Code-Reparatur:
- Der PR hat es gebrochen. Repariere es mit der kleinsten Änderung.
- Der Runner ist abgestürzt. Führe die fehlgeschlagenen Jobs einmal erneut aus. Ein zweiter Fehler auf demselben Head ist kein Flake.
- Main ist rot. Repariere Main nicht auf einem Feature-Branch von jemand anderem. Berichte es und warte.
- Ein Prozess-Check ist rot, zum Beispiel, dass der PR keinen genehmigten Issue verlinkt. Das ist ein Schritt für eine Person.
Agenten, die allein gelassen werden, behandeln alle vier als die erste, und der PR wächst mit einer Problemlösung für einen Test, der auf Main kaputt ist.
Beweise eine Review-Erkenntnis, bevor du sie reparierst
Eine Review-Erkenntnis, die der Agent akzeptiert, bekommt zuerst einen fehlgeschlagenen Test, dann die Reparatur. Eine, die er ablehnt, bekommt einen schriftlichen Grund. Dies ist die gleiche Regel wie unsere bewiesene Review-Fähigkeit, und es ist das, was Review-Bots daran hindert, einen PR durch Volumen zu lenken.
Halte den PR auf der Größe seines Ziels
Review-Schleifen erweitern einen PR um eine billig aussehende Reparatur zur Zeit: eine Schutzvorrichtung für einen Edge-Fall, den niemand trifft, ein Test für Verhalten, das sich nicht geändert hat, einen Kompatibilitäts-Shim. Die Fähigkeit behebt echte Bugs im beabsichtigten Fall und lehnt den Rest schriftlich ab. Die wertvollen werden zu Issues.
Bereitschaft ist eine Checkliste
Jeder Gating-CI-Job grün auf dem aktuellen Head, jeder Review-Bot fertig auf diesem Head, nichts wartet auf einen Menschen, kein ungelöster Thread, kein Konflikt. Wenn das zutrifft, berichtet der Agent es und stoppt das Beobachten.
Nach LGTM: Ein GitHub Actions-Workflow löst Merge-Konflikte auf
Der Workflow hat zwei Jobs.
Das Gate entscheidet, was jeder PR braucht
Das Gate ist billig: Kein Agent, kein Checkout von PR-Code. Er läuft bei jedem Push zu Main, jeder CI-Vollendung, jedem Label und jeder Überprüfung und alle 30 Minuten, und eine GraphQL-Abfrage gibt ihm jeden offenen LGTM PR. Für jeden entscheidet eine reine Funktion, was zu tun ist. Füge RTM hinzu, wenn er von jemandem außer dem Autor genehmigt ist, grün und konfliktfrei. Lass ihn allein, wenn ein Review läuft. Führe rotes CI einmal erneut aus. Sende einen Konflikt oder CI, das nach seinem erneuten Durchlauf immer noch rot ist, an den Fixer.
Der Fixer-Agent führt Main zusammen
Der Fixer ist ein Agent-Job für einen PR auf einem Head. Er führt Main in den Branch zusammen, ohne zu committen, gibt dem Agenten die konfliktfreien Dateien und die fehlgeschlagenen Protokolle, und lässt ihn nur die konfliktfreien Dateien und Dateien bearbeiten, die der PR bereits ändert. Dann stellt er eine Frage.
Kann dieser PR landen, ohne eine Zeile zu ändern, die sein Autor geschrieben hat?
Wenn ja, ist das Urteil MODERNIZE. Der Agent löst den Konflikt um die Zeilen des Autors auf, ein Validator prüft das Ergebnis, und der Workflow pusht einen normalen Merge-Commit. Wenn nein, weil Main die Funktion gelöscht hat, die der PR bearbeitet, oder der PR’s eigener Code CI fehlschlägt, ist das Urteil REWORK. Nichts wird gepusht, LGTM kommt ab, und der Autor bekommt einen Kommentar mit dem kleinsten Umschreiben. Wenn Main bereits das tut, was der PR tut, ist das Urteil CLOSE, und eine Person schließt ihn.
Der Validator behält jede Zeile, die der Autor geschrieben hat
Der Validator ist das, was die Regel hält. Er lehnt jede Zusammenführung ab, die eine vom PR hinzugefügte Zeile löscht, oder eine Zeile, die Main einer konfliktfreien Datei hinzugefügt hat. Er lehnt Bearbeitungen außerhalb der erlaubten Dateien, restliche Konflikt-Marker und Änderungen an CI- oder Sicherheitsdateien ab. Ein Agent, der versucht, den Code des Autors zu „reparieren", endet mit einem Label, das einen Menschen fragt, niemals mit einem Push. Der Workflow pusht ohne Gewalt, und nur wenn sich der Branch seit dem Versuchsbeginn nicht bewegt hat. Ein Versuch pro Head und Base, zwei pro Head, drei Kommentare pro PR pro Tag.
Es führt niemals zusammen
RTM, „ready to merge" (bereit zum Zusammenführen), ist die Aussage des Gates, dass ein PR alles hat, was er braucht: die LGTM des Autors, eine Genehmigung von jemand anderem, grünes CI und keinen Konflikt. Eine Person führt die Zusammenführung durch. Das hielt das Design klein, und es hielt das Argument darüber, ob ein Bot zusammenführen sollte, aus der Überprüfung.
Was ändert sich für den Autor, den Reviewer und wer auch immer zusammenführt
Der Autor sagt einmal fertig. Sie kommen nicht drei Tage später zurück, um Main zusammenzuführen und auf CI zu warten, und ein PR eines Agenten wird nicht verfallen, weil die Sitzung, die ihn geöffnet hat, endete.
Der Reviewer öffnet einen PR, der heute auf Main grün und mergebar ist, also ist ihre Genehmigung der letzte Schritt und nicht der Start einer weiteren Runde.
Wer auch immer zusammenführt, arbeitet aus einer Liste. RTM bleibt, sobald das Gate es hinzufügt, und wenn Main den PR danach bricht, repariert der Workflow ihn und das Label bleibt.
Und der Autor behält die Kontrolle über seinen Code. Das Schlimmste, was der Bot einem Branch antun kann, ist einen Merge-Commit hinzufügen, den ein Validator Zeile für Zeile geprüft hat.
Warum unser alter Merge-Konflikt-Resolver nie lief
Wir hatten einen Konflikt-Resolver davor. Ein Detektor fand konfliktfreie PRs und kommentierte darauf, und der Resolver lief, wenn jemand ein Label hinzufügte, das ihn fragte. In demselben Zeitraum lief der Detektor ungefähr 2.500 Mal. Der Resolver lief null Mal.
Ich glaube nicht, dass jemand faul war. Ein Entwickler, der einen PR für fertig hält, kommt nicht zurück zu ihm, um einen Button zu drücken. Automatisierung, die darauf wartet, gefragt zu werden, wird nicht gefragt. Deshalb beginnt dieser mit LGTM, dem Moment, wenn der Autor sagt, dass sie fertig sind, und macht den Rest ohne sie.
Was funktioniert noch nicht?
Zwei Dinge, und ich würde es lieber hier sagen, als dass du sie findest.
Der Workflow ist im Testmodus
Sein Gate protokolliert nur, was es tun würde, bis eine Repository-Variable das Gegenteil sagt. Bevor es so weit kam, fand ein Review, das nur Erkenntnisse behält, die es mit einem fehlgeschlagenen Test beweisen kann, elf Bugs. Einige sind wissenswert, wenn du deinen eigenen baust. GitHubs Label-Suche verzögert sich, daher kann ein PR, das sie zurückgibt, das Label vor Sekunden verloren haben, und die Entscheidung muss Live-Labels prüfen. Ein „dieser Head hatte bereits seinen erneuten Durchlauf"-Marker, der vor dem erneuten Durchlauf-Aufruf geschrieben wird, ermöglicht es einem fehlgeschlagenen API-Aufruf, den einzigen Wiederholungsversuch des Head zu verbrauchen. Und eine „verliere keine Zeile"-Prüfung, die Umbenennungen nicht folgt, sieht jede Zeile einer umbenannten Datei als verloren an.
Die Agent-Runner waren unten
Seit dem 19. Oktober ist jeder Job, der auf unsere Agent-Runner abzielt, fehlgeschlagen, eine Maschine zu bekommen: 406 storniert, 24 immer noch in der Warteschlange, als ich nachschaute. Das Gate läuft anderswo und es ist in Ordnung, aber der Fixer braucht einen Agent-Runner, und ein toter sieht genau wie ein ruhiger Tag aus. Nichts ist laut fehlgeschlagen. Jobs warteten in der Warteschlange und wurden dann storniert. Wenn du das baust, benachrichtige dich über Fixer-Durchläufe, die in der Warteschlange stecken.
Also sind die obigen Zahlen das Vorher-Bild. Jetzt haben wir 27 offene LGTM PRs, 7 davon mit rotem CI und keine mit RTM. Das sind die Zahlen, die dies ändern sollte, und ich werde berichten, was es tat.
Wie man die babysit-pr Fähigkeit installiert
github.com/LivinTribunal/babysit-pr-skill hat:
SKILL.md, die Fähigkeit, mit einem kurzen Abschnitt „einmal konfigurieren" für deine CI-Workflows, Review-Bots und Prozess-Checks.scripts/pr-wait, der Watcher. Er braucht Python und einen authentifiziertengh.docs/after-lgtm.md, das Design des After-LGTM-Workflows: die Labels, das Gate, der Fixer, die Regel, dass er die Zeilen des Autors niemals ändert, und die elf Bugs.
Der Workflow ist ein Design statt eine Datei zum Kopieren, weil der unsere gegen die Labels, Runner und CI eines Unternehmens läuft. Baue deinen aus der Dokumentation, verschiebe ihn im Nur-Log-Modus, lese einen Tag seiner Entscheidungen, dann schalte ihn ein.
Es paart mit dem Architect-Muster , das entscheidet, wer den Code schreibt, und grain , das entscheidet, wie der Code aussieht. babysit-pr ist, was passiert, nachdem einer von ihnen den Pull Request öffnet. Wenn du den Agenten selbst stimmst, decken der CLAUDE.md A/B-Test und das Kontext-Limit, das die Token-Nutzung um 17 % senkte , die Anweisungen und die Kosten ab.