


Vor ein paar Tagen hat Anthropic Fable zu einem dauerhaften Bestandteil der Max-Pläne gemacht. Der Zeitpunkt erzählt die Geschichte: Es kam direkt nachdem OpenAI GPT-5.6 Sol ausgeliefert hatte, und — wichtiger noch — direkt nachdem Kimi K3 seine Gewichte veröffentlicht hatte. Es brauchte ein Open-Source-Modell, um das größte KI-Labor zu einem Realitätscheck zu zwingen und das Marketing-Tamtam um sein Flaggschiff zu beenden. Allein dafür verdient jeder einen Toast, der diese Rechnungen bezahlt.
Aber „im Abo enthalten“ ist nicht dasselbe wie „günstig“, und schon gar nicht dasselbe wie „dauerhaft günstig“. Deshalb haben wir unseren Workflow umgebaut, während Fable noch nach Verbrauch abgerechnet wurde, sodass das teure Modell mechanisch daran gehindert wird, Code zu schreiben. Es denkt, plant und prüft. Günstigere Modelle tippen. Dieser Beitrag zeigt, wie das funktioniert und was dabei tatsächlich herauskam — über alle Transkripte hinweg, die wir haben: 606 echte Sessions aus einem Produktions-SaaS-Monorepo, einer Drohnen-Operations-App, einer Marketing-Website und den CI-Agenten, die sie bedienen.
Teil 1 — Die Falle und das Prinzip
Unsere ehrliche Ausgangsposition: Wir können ohne Frontier-Modelle nicht mehr arbeiten. Niemand im Team könnte die aktuelle Leistung ohne sie halten — und genau diese Abhängigkeit ist der Hebel, den die großen Labore in der Hand halten. Nach unserer Lesart liefern heutige KI-Abos deutlich mehr Rechenleistung, als sie kosten; das sind Land-Grab-Preise, und Land-Grab-Preise enden. Wenn sie enden, zahlt jeder, der seine Engineering-Kultur um „unbegrenzte Frontier-Tokens“ herum aufgebaut hat, was auch immer verlangt wird.
Es gibt zwei Verteidigungen. Die erste ist ein glaubwürdiger Ausstieg: Offene Modelle wie DeepSeek und Kimi haben die Preiskorrektur dieser Woche erzwungen, und sie bleiben nur dann ein Hebel, wenn wir unsere Workflows tatsächlich portabel zu ihnen halten. Die zweite ist Workflow-Disziplin: Frontier-Tokens nur dort ausgeben, wo nichts Günstigeres funktioniert. Dieser Beitrag handelt von der zweiten — denn damit kannst du am Montag anfangen.
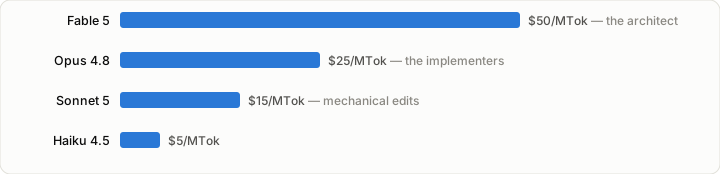
Das Prinzip ist alt genug, dass ein Gebäude danach benannt ist: der Architekt mauert nicht. Der Vorsprung eines Frontier-Modells gegenüber einem Mittelklasse-Modell ist enorm bei Design, Zerlegung und Review — und nahezu null beim Heruntertippen einer Umbenennung über vierzig Dateien. Also teilen wir die Rollen. Die Preis-Leiter sagt in Dollar dasselbe:
Wie das fable-architect-Muster funktioniert
Der fable-architect-Skill ist eine rund 100 Zeilen lange Markdown-Datei plus ein Shell-Hook, der geladen wird, sobald eine Claude-Code-Session auf dem Frontier-Modell läuft. Er erzwingt eine Arbeitsteilung:
- Der Architekt tut: die Anforderung hinterfragen, die Codebasis erkunden, jede Designentscheidung treffen — Ansatz, Datenfluss, Namen, Signaturen, Randfälle —, die Arbeit in unabhängige Slices zerlegen, die zurückgelieferten Diffs prüfen, Verifikation ausführen und alle Prosa schreiben (Pläne, Briefings, PR-Beschreibungen, Commit-Nachrichten).
- Der Architekt tut nie: eine Quelldatei schreiben oder bearbeiten. Kein Code im Chat außer kurzen Signaturen innerhalb eines Briefings.
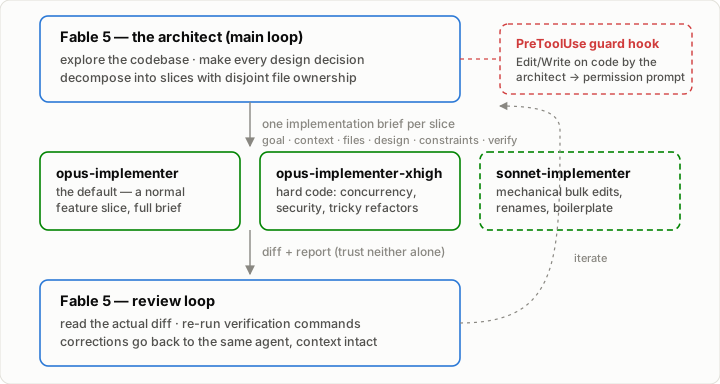
Drei Dinge sorgen dafür, dass das in der Praxis funktioniert und nicht nur auf einer Folie.
1. Das Briefing ist die Schnittstelle
Jeder Slice bekommt ein Implementierungs-Briefing. Der Implementierer startet mit einem frischen Kontextfenster — alles, was nicht im Briefing steht, muss er neu entdecken oder raten. Diese Einschränkung ist ein Feature: Sie zwingt den Architekten, seine Entscheidungen abzuschließen, bevor er delegiert. Ein Briefing enthält Entscheidungen, keine Optionen.
## Implementierungs-Briefing: <Slice>
Ziel:           ein Satz, beobachtbares Ergebnis
Kontext:        was die Exploration bereits gefunden hat — Auszüge, das
                nächstliegende Muster zum Nachbauen, Zeilenanker, Stolperfallen
Dateien:        Pfade zum Anlegen/Ändern — exklusives Eigentum dieses Slices
Design:         der entschiedene Ansatz — Datenfluss, Namen, Signaturen, Kanten
Vorgaben:       geltende Projektregeln: Stil, Schichten, Sicherheit
Nicht im Scope: was nicht angefasst werden darf, inklusive Dateien anderer Slices
Delegation:     darf dieser Slice Sub-Implementierer starten, und wie viele
Verifizieren:   exakte Befehle und erwartetes Ergebnis
Zwei dieser Zeilen sind neuer als der Rest, und sie existieren, weil sich der Implementierer-Tier unter uns verändert hat — siehe das Update weiter unten.
2. Durchsetzung statt Bauchgefühl
Ein PreToolUse-Guard-Hook überwacht die Session: Wenn der Architekt versucht, eine Nicht-Prosa-Datei zu bearbeiten, erscheint eine Berechtigungsabfrage. Die Abfrage zu bestätigen, ist die dokumentierte Ausnahme für triviale Änderungen (ein Tippfehler, ein Versions-Bump — Fälle, in denen der Delegationsaufwand mehr kostet als das Tippen). Reibung ist die Policy. Ohne den Hook hält „das teure Modell soll nicht coden“ exakt bis zum ersten Deadline.
3. Die Review-Schleife schließt die Qualitätslücke
Der Architekt liest den Bericht des Agenten und den tatsächlichen Diff — keinem von beiden allein traut er — und führt die entscheidenden Verifikationsbefehle erneut aus, wenn die Behauptung wichtig ist. Ein Problem gefunden? Die Korrektur geht zurück an denselben Agenten, der seinen vollständigen Arbeitskontext noch besitzt. Kein manuelles Nachbessern, kein frischer Neustart.
Beachte: Das ist die Verifikation des Architekten, und die bleibt. Was wir begonnen haben zu entfernen, ist die Verifikation, die wir früher in Briefings geschrieben haben — Anweisungen, mit denen der Implementierer sich selbst gegenprüfen sollte. Neuere Implementierer-Modelle tun das ungefragt, und ihnen zu sagen, sie sollen es noch einmal tun, kauft einen zweiten Durchlauf, den du bereits bezahlt hast.

Bereit, Ihr Geschäft zu erweitern?
Starten Sie heute Ihre kostenlose Testversion und sehen Sie innerhalb weniger Tage Ergebnisse.
Was wir gemessen haben
Um zu prüfen, ob das ein echter ökonomischer Mechanismus ist oder nur ein hübsches Ritual, haben wir jedes Claude-Code-Transkript über unsere Projekte hinweg ausgewertet, API-Requests dedupliziert und jeden Token zu aktuellen Listenpreisen bepreist. Drei Hypothesen, festgelegt, bevor wir die Zahlen pro Session angesehen haben:
- H1 — Die Implementierer tippen. Wenn wahr, sollten Implementierer-Subagenten in delegierten Sessions mehr Output-Tokens produzieren als die Hauptschleife des Architekten.
- H2 — Delegation ist günstiger. Wenn wahr, sollte die Umbepreisung der Arbeit der Implementierer zu den Sätzen des Architekturmodells deutlich teurer ausfallen als das, was wir tatsächlich bezahlt haben.
- H3 — Die Qualität hält. Die schwierige: Delegierter Code sollte nicht mehr Nacharbeit erfordern als vom Architekten getippter Code.
Grundregeln. Ein API-Request erstreckt sich über viele Transkriptzeilen, die dasselbe Usage-Objekt wiederholen — wir haben nach Request-ID gruppiert, Input- und Cache-Tokens einmal pro Request gezählt und den maximalen Output-Snapshot genommen (naive Summierung pro Zeile zählt 2–3× zu viel). Die Kosten verwenden aktuelle Anthropic-Listenpreise — Fable 10/50 $, Opus 5/25 $, Sonnet 3/15 $ pro Million Input-/Output-Tokens — mit Cache-Reads zu 10 % des Input-Preises und Cache-Writes zu ihren jeweiligen TTL-Sätzen. 31 von 354 Sessions im interaktiven Store qualifizieren sich unter einem konservativen Klassifizierer als fable-architect-Sessions; die Zahlen zeigen die acht teuersten. Wir berichten Verhältnisse und Prozentwerte statt unserer absoluten Ausgaben.
Teil 2 — Die Belege
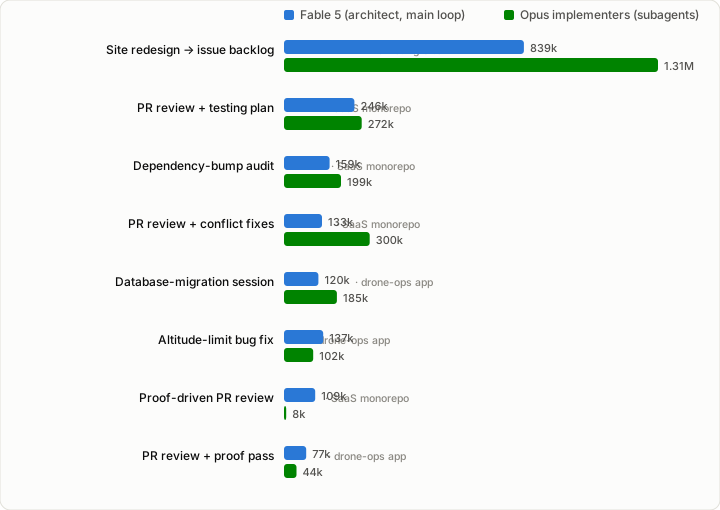
H1 — Gemischt … sagte die erste Abrechnung. In den größten Delegations-Sessions hält die Hypothese klar — bis zu 2,3× mehr Implementierer-Output als Architekten-Output. Über alle 31 fable-architect-Sessions hinweg produzierte der Architekt aber weiterhin mehr als die Implementierer: 3,59 Mio. gegenüber 3,15 Mio. Tokens. Teils ist das fair — der Output des Architekten enthält alle Pläne, Briefings und Review-Prosa, und genau das ist seine Aufgabe —, teils sah es nach Sessions aus, die einen Slice delegierten und den Rest behielten. Dann fiel uns ein, dass sich unser Website-Redesign überhaupt nicht architektenlastig angefühlt hatte, und wir machten uns auf die Suche nach den Tokens, die die Subagenten-Buchhaltung nicht sehen konnte.
Abonnieren Sie unseren Newsletter
Erhalten Sie die neuesten Tipps, Trends und Angebote kostenlos.
Der zweite Kanal: der Issue-Tracker als Delegationsbus
Die Subagenten-Buchhaltung hat einen blinden Fleck: Sie sieht nur Delegation, die innerhalb einer Session stattfindet. Die Session des Website-Redesigns — die größte Zeile im Diagramm oben — entpuppte sich als etwas völlig anderes: eine einzelne Architekten-Loop-Session, die 107 Stunden am Stück lief (292 geplante Aufwachpunkte), das Redesign in GitHub-Issues zerlegte, sie für unsere CI-Pipeline taggte und dann supervidierte: Runs pollen, die Pull Requests der Pipeline prüfen, Folge-Issues anlegen, wenn QA Bugs aufdeckte.
Das Tippen fand dort statt, wo unser Mining pro Session noch gar nicht hingeschaut hatte: in einer separaten Flotte selbst gehosteter Runner, in der die Pipeline-Stufen Plan → Implementierung → Lückenbewertung → Review als 252 unabhängige Opus-Sessions über 4,5 Tage liefen und dabei 48 verschiedene Issues und PRs berührten.
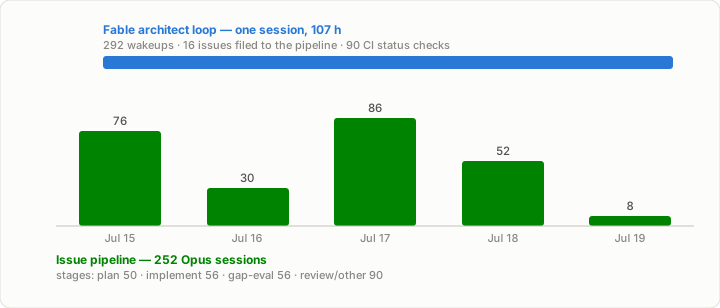
H1, neu betrachtet — Bestätigt auf Projektgröße. Zählt man beide Kanäle, kippt das Bild: Die Pipeline tippte 10× mehr Output-Tokens als die Architekten-Schleife, die sie gestartet hat (9,07 Mio. gegenüber 877 Tsd.), und zwar komplett zu Opus-Sätzen. Diese Implementierungswelle auf dem Modell des Architekten laufen zu lassen, hätte 2,1× so viel gekostet — bei einem einzigen Redesign, in einer Woche, noch ohne die Subagenten innerhalb der Session. Ein Issue ist nur ein gröber gekörntes Briefing: dieselbe Schnittstelle, dieselbe Ökonomie, eine Ebene höher.
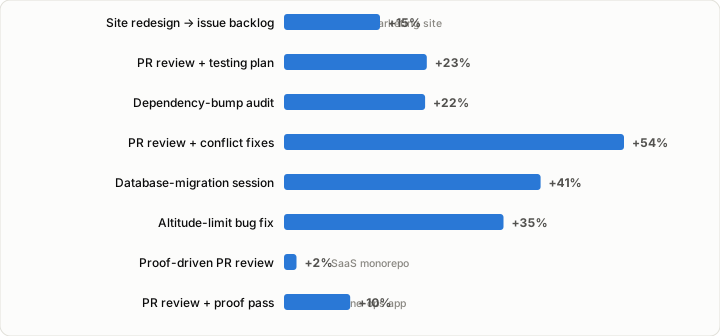
H2 — Bestätigt, mit einem Haken. Repreist man die exakten Token-Mengen der Implementierer zu den Sätzen des Architekturmodells, wird jede Session teurer — von +2 % bis +54 %, 17 % über die Top-Acht. Echtes Geld, aber weniger, als die 2×-Output-Preislücke vermuten lässt. Der Haken: Output ist nicht der Ort, an dem das Geld hingeht. In der größten Session kosteten die Cache-Reads des Architekten etwa 13× so viel wie alles, was er getippt hat — die dominierende Ausgabe ist das teure Modell, das einen großen Orchestrierungskontext hält und erneut liest, nicht das Tippen. Delegation deckelt die Output-Rechnung; der nächste Hebel ist, den Kontext des Architekten schlank zu halten.
H3 — Hier nicht gemessen. Token-Buchhaltung kann Codequalität nicht sehen. Was wir beobachtend sagen können: Die Review-Schleife ist tragend — Berichte und Diffs widersprechen sich oft genug, dass das Lesen beider nicht verhandelbar ist — und Korrekturen, die an einen kontextwarmen Agenten zurückgehen, konvergieren schnell. Wenn du das nachbaust und Nacharbeit sauber misst, wollen wir es sehen, besonders wenn es uns widerlegt.
Was uns die breitere Datenlage gelehrt hat
- Adoption ist ein Gradient, kein Schalter. In der Drohnen-Ops-App — kleiner, schneller bewegt — laufen 18 % der Sessions im fable-architect-Muster; im älteren SaaS-Monorepo sind es 9 %. Das Projekt, das am stärksten delegierte, tat es auf beiden Körnungen gleichzeitig: Implementierer-Briefings innerhalb der Session und 252 Pipeline-Sessions, die über den Issue-Tracker gestartet wurden.
- Die CI-Flotte führt den Skill nicht aus — weil sie der Implementierer ist. Unsere automatisierten Runner-Sessions starten nie einen Implementierer-Subagenten, und zunächst las sich das als Nicht-Adoption. Die Prompts sagen etwas anderes: Jede ist eine Pipeline-Stufe — Verifikation, Review, Lückenbewertung —, und etwa sechs von zehn arbeiten gegen ein konkretes Issue oder PR. Auf Projektgröße sind die Pipeline-Runner der Implementierer-Tier.
- Der günstigste Tier hatte noch keinen ersten Arbeitstag. Alle 78+ Implementierer-Läufe waren Opus-Klasse; der mechanische Sonnet-Edit-Tier wurde erst kürzlich hinzugefügt und noch nie aufgerufen. Was auch immer das hier an Einsparungen misst: Es ist eine Untergrenze.
Die Schnittstelle ist der Punkt: Briefing rein, Diff raus — Issue rein, PR raus. An dem Tag, an dem die Preiserhöhung kommt, tauschst du den Maurer, nicht den Prozess.
Volle Offenlegung. Die Modelle wurden aus Transkript-Strings verifiziert, nicht angenommen. Wir haben uns zweimal selbst korrigiert (eine Token-Überzählung pro Zeile, dann eine Platzhalter-Preistabelle). Das Kontrafaktische nimmt an, dass der Architekt dieselben Token-Mengen verbraucht hätte wie die Implementierer — die Fehlerbalken laufen in beide Richtungen. Die Pipeline-Sessions liegen in einem Transkript-Store, den unsere ersten beiden Mining-Durchläufe nicht erfasst hatten; eine Buchhaltungsgrenze verbarg einen Delegationskanal von 9 Mio. Tokens vor uns — und deiner hat wahrscheinlich auch einen. Die Projekte eines einzelnen Engineers, überwiegend Review-and-Fix- und Feature-Arbeit — kein kontrollierter Benchmark. Der Korpus schließt zudem, bevor Opus 5 erschien: Jede Zahl oben ist Fable als Architekt über Implementierer der Opus-4-Klasse. Die Preise der Sprossen haben sich mit Opus 5 nicht bewegt, die gemessenen Verhältnisse gelten also weiter — was sich bewegt hat, steht im nächsten Abschnitt.
Update — die Leiter hat sich unter uns bewegt
Opus 5 erschien, nachdem diese Messungen abgeschlossen waren, und an der Preis-Leiter hat sich nichts geändert: Opus kostet weiterhin 5/25 $ pro Million Input-/Output-Tokens, Fable weiterhin 10/50 $, und das Diagramm oben stimmt weiterhin. Was sich geändert hat, ist die Fähigkeit auf jeder Sprosse. Anthropic positioniert Opus 5 als Sprung bei tiefem Reasoning und langhorizontiger agentischer Arbeit — also genau bei der Arbeit, aus der die Architektenrolle besteht, zum halben Preis des Architekten-Tiers.
Das zielt direkt auf unseren eigenen H2-Haken. Wenn die dominierende Architekten-Kostenposition Cache-Reads sind und Cache-Reads mit 10 % des Input-Preises abgerechnet werden, dann liest ein Architekt auf Opus 5 seinen Orchestrierungskontext zu 0,50 $ pro Million Tokens statt zu Fables 1,00 $ erneut. Der Posten, der 13× alles gekostet hat, was der Architekt getippt hat, wird halbiert. Wir haben das nicht gemessen — es ist Arithmetik unter derselben Annahme gleicher Token-Mengen, die wir beim 2,1×-Kontrafaktischen markiert haben, und es ist das Nächste, was wir testen wollen. Wenn es hält, hört die interessante Frage auf, welche Modelle, und wird zu ob der Architekt überhaupt die oberste Sprosse braucht.
Drei Dinge am neuen Implementierer-Tier verändern das Muster selbst, nicht nur seinen Preis:
- Er greift bereitwillig zu Subagenten — das Gegenteil seines Vorgängers, dem man Delegation erst ausreden musste. Ein Implementierer, der still und leise seine eigenen Implementierer startet, multipliziert die Rechnung, ohne dass jemand hinsieht. Daher die Zeile
Delegation:im Briefing: Ein Slice sagt jetzt, ob er sich auffächern darf und wie weit. - Er verifiziert seine eigene Arbeit unaufgefordert. Verifikationsanweisungen, die für ältere Modelle geschrieben wurden, kaufen jetzt einen redundanten zweiten Durchlauf und fliegen aus den Briefings. Die Review-Schleife des Architekten bleibt unberührt.
- Er weitet den Scope aus.
Nicht im Scope:hört auf, Boilerplate zu sein, und wird die Zeile, die einen Slice ein Slice bleiben lässt.
Und die Sprosse, die wir nie genutzt haben, wurde schärfer, während wir wegschauten: Sonnet 5 erreicht nahezu Opus-Qualität bei Coding-Arbeit für 3/15 $, mit Einführungspreisen darunter bis Ende August. „Was auch immer das hier an Einsparungen misst, es ist eine Untergrenze“ war eine Absicherung, als wir es schrieben. Jetzt liest es sich wie eine Untertreibung.
Teil 3 — Wohin das bewusst führt
Wir steuern absichtlich auf eine Aufteilung zu, in die unserer Meinung nach jedes Engineering-Team irgendwann gezwungen sein wird: teure Frontier-Modelle nur für Brainstorming, Architektur und Review; zunehmend günstige Modelle für die Programmierung selbst. Heute sind unsere Implementierer Opus-Klasse. Am Workflow ändert sich nichts, wenn sie Sonnet-Klasse, DeepSeek-Klasse oder Kimi-Klasse werden — die Schnittstelle ist konstruktionsbedingt modellagnostisch. Das ist der gesamte strategische Wert: An dem Tag, an dem die Subvention endet und sich die Rechnung verdoppelt, ändern Teams mit dieser Disziplin eine Konfigurationszeile. Teams ohne sie verhandeln ihre gesamte Kostenstruktur unter Druck neu.
Fable-architect ist ein Babyschritt — die Adoption ist partiell und der günstigste Tier hatte noch keinen ersten Lauf. Aber es ist der Schritt, der den Muskel aufbaut: Briefings schreiben, die einen Slice vollständig spezifizieren, Diffs prüfen, die man nicht selbst getippt hat, die Aufmerksamkeit des teuren Modells als Budget behandeln. Und die Redesign-Welle zeigt, wohin der Muskel führt: Sobald Briefings funktionieren, funktionieren Issues, und das teure Modell ist bei der Implementierung gar nicht mehr dabei.
Was du am Montag tun kannst
- Teile die Rollen in deinem Agenten-Harness. Eine Regel auf Session-Ebene: Das Frontier-Modell plant und prüft; delegiere alle Dateiänderungen an einen günstigeren Implementierer-Agenten. In Claude Code ist das ein Skill plus Subagenten-Definitionen — ein Nachmittag Setup.
- Mach die Grenze mechanisch. Füge einen Pre-Edit-Hook hinzu, der die eigenen Dateischreibvorgänge des teuren Modells hinterfragt. Eine Regel, deren Bruch nichts kostet, ist bis Freitag gebrochen.
- Schreibe Briefings mit einer festen Vorlage. Ziel, Kontext, Dateien, Design, Vorgaben, Nicht-im-Scope, Delegationsbudget, Verifizieren. Die Vorlage ist die Disziplin — und das Delegationsbudget ist das, was einen Implementierer davon abhält, still und leise eigene einzustellen.
- Prüfe sowohl den Bericht als auch den Diff. Traue nie einem von beiden allein; führe die Verifikationsbefehle erneut aus, auf die es ankommt.
- Miss deine eigene Aufteilung. Deine Transkripte enthalten die Daten bereits — gruppiere nach Request, bepreise nach Modell und sieh nach, wer tatsächlich tippt. Unsere zeigten uns einen ungenutzten günstigen Tier und einen Delegationskanal von 9 Mio. Tokens, von dem wir nichts wussten.
- Erweitere die Schnittstelle von Briefings zu Issues. Ein Briefing delegiert eine Stunde Arbeit, ein Issue einen Tag davon. Sobald deine Issues Akzeptanzkriterien tragen, mit denen eine Pipeline arbeiten kann, kann das teure Modell Arbeit in den Tracker legen und supervidieren, statt für jeden Slice in der Schleife zu sitzen.
- Halte einen Ausstieg warm. Lass ein günstiges oder offenes Modell einmal pro Woche einen risikoarmen Slice als Implementierer übernehmen. Portabilität, die du nie ausübst, ist Portabilität, die du nicht hast.
- Repreise den Architekten, nicht nur den Maurer. Jede Modellveröffentlichung verschiebt die Sprossen, ohne die Leiter zu bewegen. Wenn der größte Teil deiner Architekten-Ausgaben Kontext statt Tippen ist, ist ein günstigerer Architekten-Tier mehr wert als ein günstigerer Implementierer-Tier — prüfe, welchen deine eigenen Transkripte sagen, dass du kaufst.
Die Labore werden uns weiter erzählen, ihre Top-Modelle seien jeden Preis wert, und — ärgerlicherweise — für Urteilsarbeit haben sie meistens recht. Der richtige Zug ist nicht, sich zu enthalten. Sondern damit aufzuhören, Frontier-Preise für For-Loops zu zahlen.
