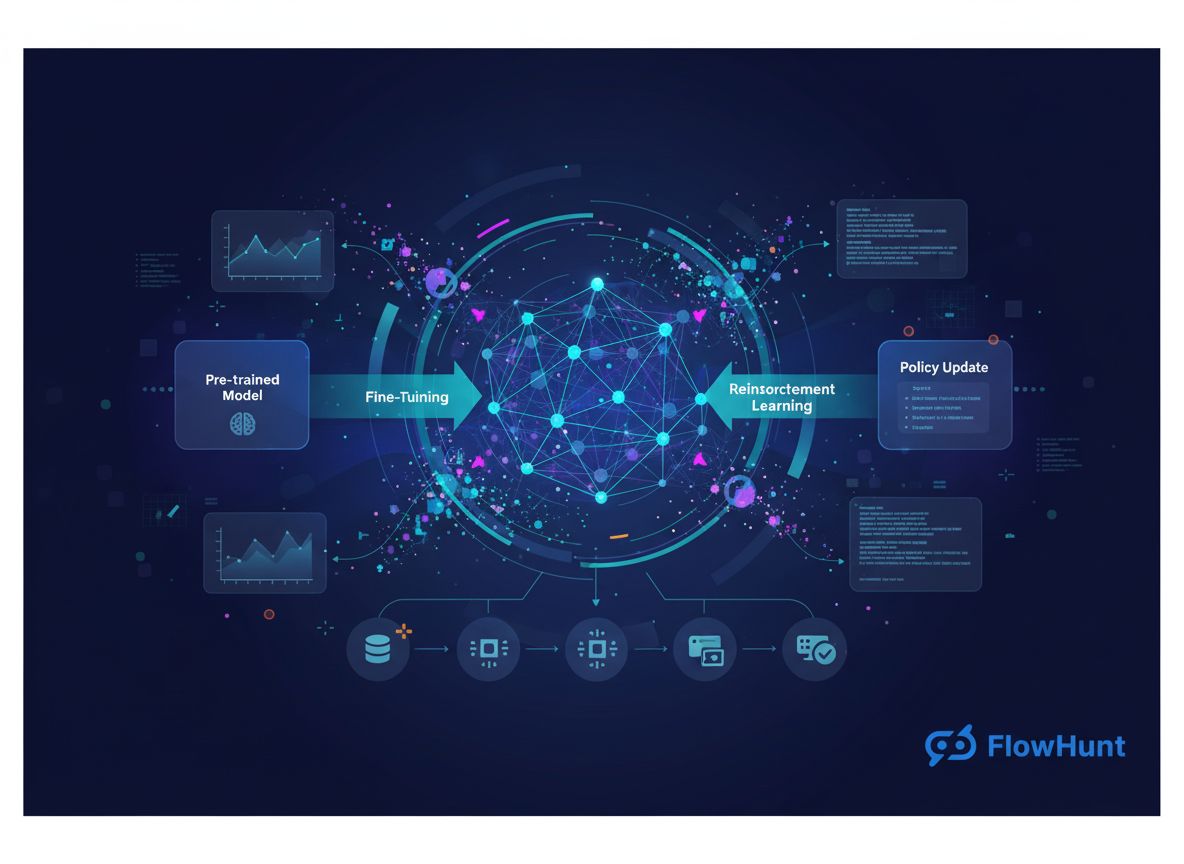
Por qué ganó el aprendizaje por refuerzo: La evolución del fine-tuning de modelos de IA y la historia de OpenPipe
Descubre cómo el aprendizaje por refuerzo y el fine-tuning se convirtieron en el enfoque dominante para optimizar modelos de IA, desde la destilación de GPT-4 h...
16 min de lectura
AI
Machine Learning
+3