


La versión corta
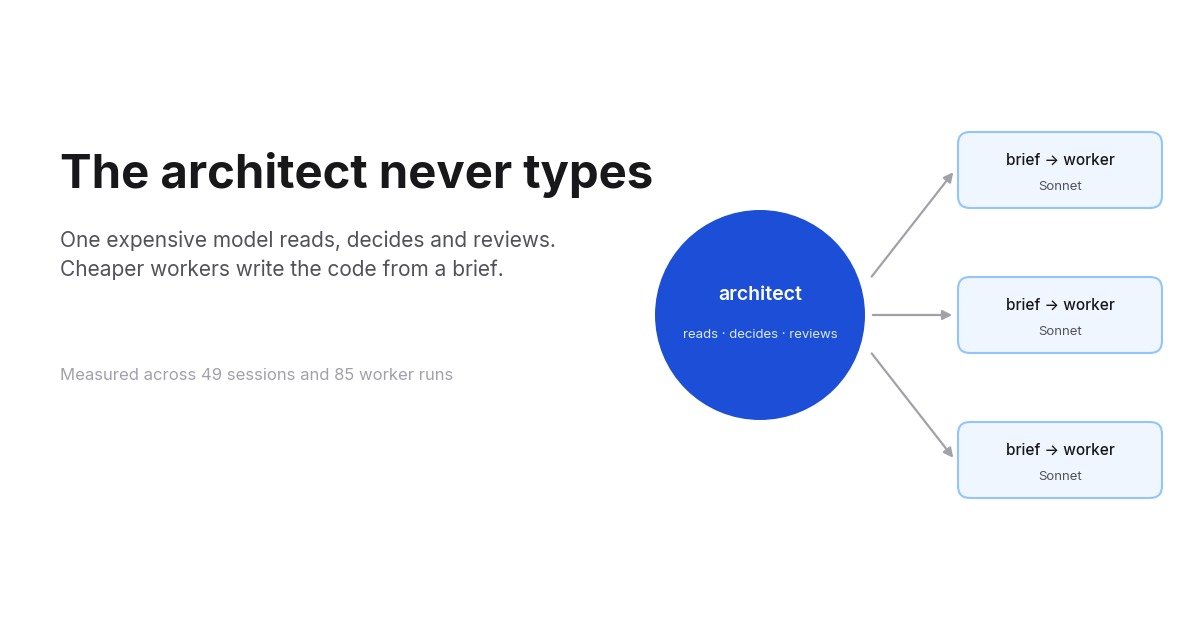
- Durante cinco semanas ejecuté mi agente de codificación en modo dividido: el modelo principal, Opus y luego Fable, lee, decide y revisa, y un agente trabajador escribe el código a partir de un brief escrito. Lo llamo el patrón arquitecto y ahora es una skill pública: architect-skill en GitHub , con licencia MIT.
- El modelo principal dejó de teclear. A lo largo de 49 sesiones de arquitecto editó un archivo fuente 6 veces en 1.467 prompts. En 275 sesiones simples durante las mismas semanas editó 244 archivos en 3.081 prompts. Eso es 0,4 frente a 7,9 por cada 100 prompts.
- El total de tokens por prompt no bajó. Subió, y mucho, durante dos semanas, y luego volvió a donde se sitúan las sesiones simples. Lo que cambió es quién los gastaba: la cuota de Opus en los tokens de los trabajadores pasó del 100% a cerca del 4%, y desde el 14 de septiembre un prompt en una sesión de arquitecto cuesta 364k tokens ponderados en el modelo principal, 205k en trabajadores Sonnet y 80k en trabajadores Opus.
- Ese reparto es lo que le importa a una suscripción. Claude Max mide su límite semanal de todos los modelos a la tarifa de cada modelo, así que un token de Sonnet lo consume al 40% de lo que lo hace un token de Opus, y Fable tiene un límite semanal propio, aparte y más estricto, que ningún trabajador toca.
- También probé a enrutar los trabajadores a DeepSeek a través de un Claude Code headless. Con precios de tarifa, el mismo tráfico costaba 10 $ en lugar de 202 $ en Sonnet o 505 $ en Opus. Con una suscripción ese ahorro no existe, porque la suscripción ya estaba pagada. Lo abandoné. Si pagas por token, lee esa sección de todos modos, porque los números son lo importante.
Esta es la tercera entrada de una serie. La primera midió qué le hizo un ajuste a una ventana de contexto, 17% menos tokens , y la segunda explica cuánto cuesta una ventana de contexto y por qué. Esta va de la otra palanca: no de cuán grande es el contexto, sino de qué modelo lo sostiene.
En qué consiste el patrón
Una sesión de agente de codificación hace dos tipos de trabajo. Piensa: lee la base de código, deduce qué cambiar, decide nombres, firmas y casos límite, comprueba el diff. Y teclea: escribe el código, ejecuta el archivo de test, arregla el lint. El pensamiento es donde un modelo de frontera justifica su precio. El tecleo, no. La mayor parte está determinada por la decisión que vino antes, y un modelo más pequeño ejecuta un plan ya decidido casi igual de bien que uno grande.
Así que la skill divide la sesión. El modelo principal es el arquitecto. Hace todo en el bucle principal excepto editar un archivo fuente:
- Interrogar el requisito y explorar la base de código.
- Tomar las decisiones de diseño: enfoque, flujo de datos, nombres, firmas, casos límite. El patrón existente más cercano que imitar. El cambio más pequeño que arregla la causa raíz.
- Descomponer en rebanadas que poseen conjuntos disjuntos de archivos.
- Escribir un brief de implementación por rebanada.
- Revisar el diff que vuelve, ejecutar las puertas de calidad, hacer commit.
El trabajador es un subagente con una ventana de contexto nueva. Recibe el brief y nada más, escribe el código, ejecuta los archivos de test que el brief nombra y devuelve un informe estructurado breve. Luego su contexto se tira a la basura. Nunca pasa a formar parte del historial de la sesión principal, lo cual importa más de lo que parece: todo lo que lee la sesión principal se reenvía en cada llamada posterior, así que un trabajador que lee doce archivos y un log de tests en su propio contexto mantiene todo eso fuera de la factura del arquitecto.
El brief es todo el contrato. El mío tiene siete campos y la skill consiste sobre todo en rellenarlos bien:
## Brief de implementación: <rebanada>
Objetivo: una frase, un resultado observable
Contexto: lo que encontró la exploración: extractos, el patrón a imitar, anclas de línea, trampas
Archivos: rutas a crear/modificar, propiedad exclusiva para esta rebanada
Diseño: el enfoque decidido: flujo de datos, nombres, firmas, casos límite
Restricciones: reglas del proyecto que aplican: estilo, capas, seguridad
Fuera de alcance: qué no tocar, incluidos los archivos que pertenecen a otras rebanadas
Verificar: comandos exactos y resultado esperado
Un brief contiene decisiones, no opciones. Si todavía estoy sopesando dos enfoques, no estoy listo para delegar.
Hay una excepción. Delegar tiene un coste fijo: escribir el brief, el arranque del trabajador, leer el informe, revisar el diff. Un arreglo de una errata, un valor de configuración, una subida de versión, borrar una clave muerta, un arreglo de una línea y su test de regresión: para eso el arquitecto edita directamente, porque el brief costaría más que la edición. El criterio es el coste, no el número de líneas. En el momento en que la edición necesita un juicio de diseño o toca una ruta que el repositorio marca como crítica, va a un trabajador.

¿Listo para hacer crecer tu negocio?
Comienza tu prueba gratuita hoy y ve resultados en días.
Por qué una suscripción cambia la aritmética
Si pagas por token, el caso es simple. Opus 5 está tarifado a 5 $ por millón de tokens de entrada y 25 $ por millón de salida; Sonnet 5 a 2 $ y 10 $. Cada token de implementación que pasa de Opus a Sonnet cuesta el 40% de lo que costaba.
Yo pago una suscripción, y ahí el caso es distinto y, creo, más fuerte. Claude Max tiene dos límites semanales, no uno: un límite que abarca todos los modelos, consumido por cada token a la tarifa de su modelo, y un límite aparte y más estricto que solo consume Fable. Opus no tiene límite propio. Eso le da al reparto dos efectos. El trabajo que hace un trabajador Sonnet consume el límite compartido al 40% de la tarifa que consumiría un trabajador Opus, así que mover dos tercios de los tokens de una sesión a Sonnet hace que la semana dure más aunque el total de tokens no cambie. Y cuando el arquitecto es Fable, cada token que no gasta tecleando es un token que queda en el límite que se agota primero. Así que aunque el patrón arquitecto gastara exactamente el mismo número de tokens que una sesión simple, quién los gasta seguiría decidiendo cuándo termina la semana.
Ese «aunque» resultó estar haciendo mucho trabajo.
Lo que dicen las transcripciones
Claude Code escribe cada sesión en una transcripción JSONL, y cada ejecución de trabajador en un archivo hermano dentro del directorio de la sesión. Tengo todas desde el 19 de agosto: 324 sesiones interactivas con tres o más prompts, de las cuales 49 usaron el patrón, es decir, lanzaron un agente implementador o le enviaron un brief. Los tokens se ponderan igual que la factura: entrada nueva a 1, escrituras de caché a 1,25 o 2, lecturas de caché a 0,1. Las ejecuciones de CI quedan excluidas.
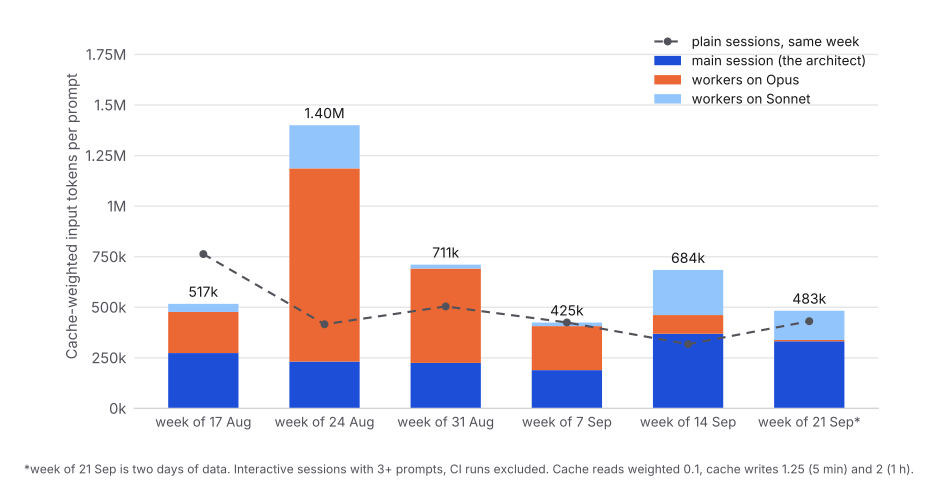
Léelo de izquierda a derecha y no es una historia de éxito en las dos primeras semanas.
En la semana del 24 de agosto una sesión de arquitecto costaba 1,40M de tokens ponderados por prompt. Las sesiones simples de esa misma semana costaban 0,42M. Tres veces y media más, y casi todo el exceso era naranja: trabajadores Opus. Había dado a los trabajadores un buen modelo y ninguna regla, y se comportaron como un buen modelo sin reglas. La mediana de ejecución de trabajador Opus esa semana fue de 176 turnos. Varios ejecutaron la suite completa de tests de backend, que mete unos 100 KB de salida en un contexto que se reenvía en cada turno posterior. Una sesión de seis trabajadores el 14 de septiembre, cuando ya había empezado a apretar las tuercas, aún quemó 245M tokens de entrada a lo largo de 1.585 turnos para producir unas seis mil líneas de diff. El almacenamiento en caché de prompts funcionaba con una tasa de acierto del 91,6% todo el tiempo. La factura era el volumen, no el precio.
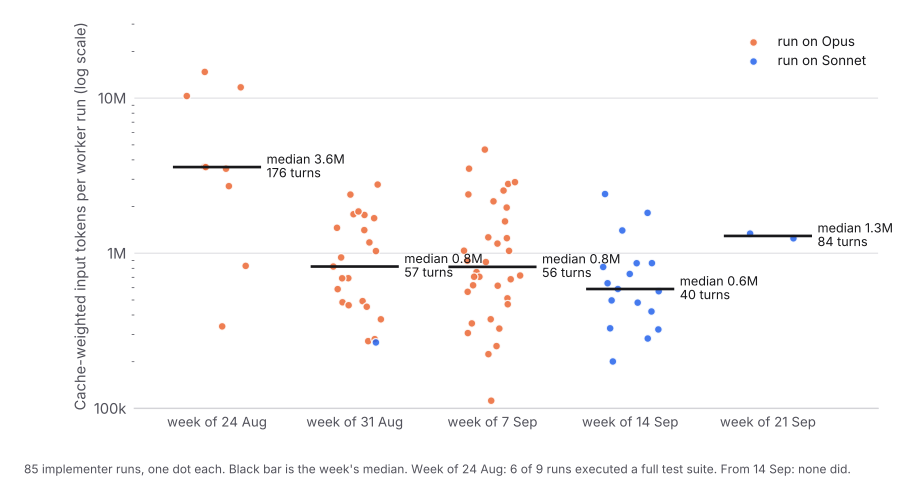
La franja de trabajadores muestra dónde aterrizaron las reglas. Tres de ellas hicieron la mayor parte del trabajo, y las escribí en las definiciones de los agentes en lugar de en el brief, para que se apliquen tanto si me acuerdo como si no:
- Un trabajador nunca ejecuta una suite de test completa. Ejecuta los archivos de test que nombra su brief. El arquitecto ejecuta las puertas de calidad.
maxTurnsestá limitado en la definición del agente: 140 para Sonnet y 160 para Opus. Una rebanada que necesita 250 turnos se briefó mal.- Una rebanada se mantiene por debajo de unos doce archivos, y el brief por debajo de unos 8 KB. El brief también se reenvía en cada turno.
Para la semana del 31 de agosto la mediana de ejecución de trabajador era de 57 turnos y 0,8M de tokens ponderados. Desde el 14 de septiembre, cuando moví la ruta por defecto a Sonnet, era de 40 turnos y 0,6M, y ningún trabajador ha ejecutado una suite completa desde entonces.
El total por prompt siguió esa estela: 711k, 425k, 684k, 483k en las últimas cuatro semanas, frente a las sesiones simples con 505k, 425k, 318k, 431k. Las sesiones de arquitecto ahora cuestan más o menos lo que cuestan las simples. Algo más en dos de las cuatro semanas, algo menos en una. Lo que compran a cambio son los dos gráficos siguientes.
Únete a nuestro boletín
Obtén los últimos consejos, tendencias y ofertas gratis.
El modelo principal dejó de teclear
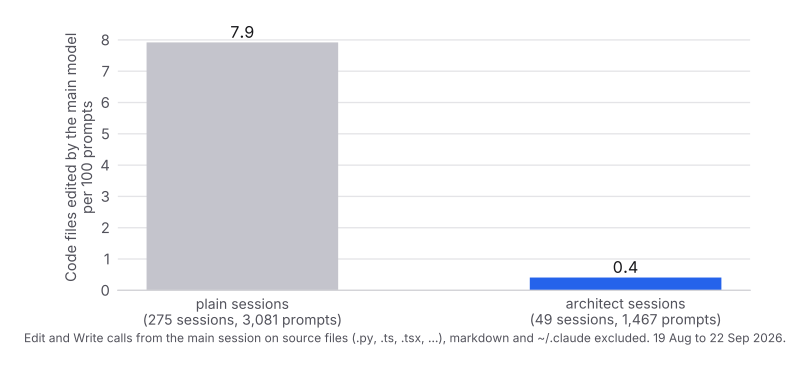
Este es el número que me propuse cambiar, y cambió. En las sesiones simples el modelo principal hizo 244 llamadas de Edit o Write sobre archivos fuente a lo largo de 3.081 prompts. En las sesiones de arquitecto hizo 6 a lo largo de 1.467. Las 6 son todas excepciones de ediciones pequeñas que puedo explicar.
Mientras tanto, los trabajadores fueron productivos. Las 85 ejecuciones de trabajador hicieron 2.510 ediciones de archivos fuente. Contando el bucle principal y los trabajadores juntos, una sesión de arquitecto produjo 2.516 ediciones de código a partir de 1.467 prompts; las sesiones simples produjeron 943 a partir de 3.081. Por edición de código, una sesión de arquitecto gastó 403k tokens ponderados en total y 330k en el modelo de la familia Opus. Una sesión simple gastó 1.410k y 1.324k. Quiero ser cuidadoso con esa comparación, porque las dos poblaciones no son el mismo trabajo: una sesión se clasifica como de arquitecto por delegar código, así que las sesiones de arquitecto son intensivas en código por construcción, y las sesiones simples incluyen investigación, revisiones y depuración que nunca editan nada. Léelo como «el patrón consigue que se escriba mucho código por token», no como una afirmación de eficiencia cuatro veces mayor.
La afirmación más limpia es el reparto entre modelos. Desde el 14 de septiembre, un prompt en una sesión de arquitecto cuesta 364k tokens ponderados en el bucle principal, 205k en trabajadores Sonnet y 80k en trabajadores Opus. La cuota de los trabajadores Opus sobre todos los tokens de trabajador era del 100% en agosto y de cerca del 4% en la semana del 21 de septiembre. En un plan Max eso significa que el límite semanal compartido se consume a la tarifa de Sonnet en lugar de la de Opus para casi todo el trabajo de implementación, y que nada de ello toca el límite de Fable.
Dos cosas no mejoraron, y prefiero decirlo antes que dejar que los gráficos insinúen lo contrario. El contexto de la propia sesión principal no se redujo: las sesiones de arquitecto se compactaron 8,7 veces por cada 100 prompts frente a 4,7 en las simples, porque el arquitecto lee mucho antes de preparar el brief. Y el patrón es más lento en tiempo real en tareas pequeñas, porque el arranque y el informe de un trabajador son minutos que no pagas cuando simplemente haces la edición. La excepción de las ediciones pequeñas existe porque la primera versión de la skill no la tenía, y me vi escribiendo un brief de 3 KB para un cambio de dos líneas.
El desvío por DeepSeek
Una vez que los trabajadores fueron Sonnet, la siguiente pregunta obvia era si tenían que ser un modelo de Claude siquiera. Del 13 al 18 de septiembre apunté el trabajador a DeepSeek V4.1 Flash a través de un Claude Code headless con ANTHROPIC_BASE_URL configurado a un endpoint compatible, primero mediante OpenRouter y luego de forma nativa. Mismo formato de brief, mismo formato de informe, mismo arquitecto. 2.732 llamadas, 431M tokens de entrada de los cuales el 88% eran lecturas de caché, 1,7M tokens de salida.
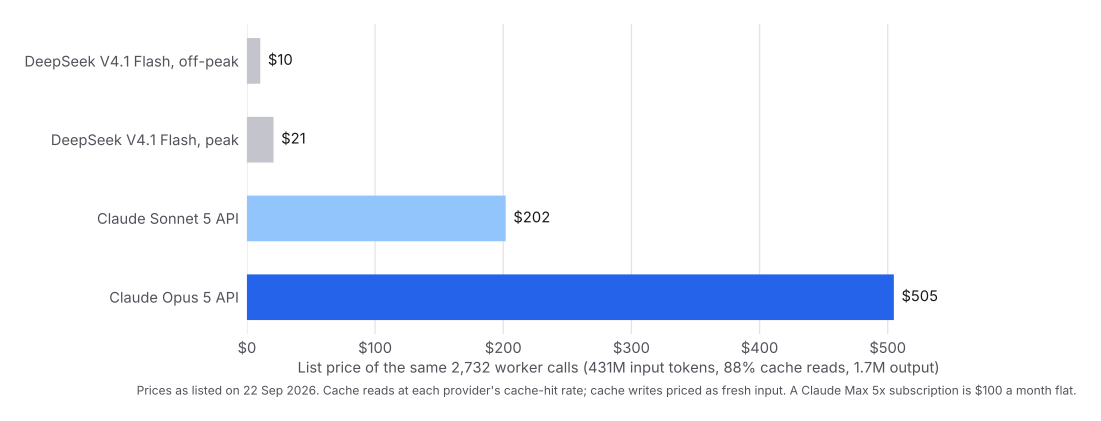
A precios de tarifa el 22 de septiembre, ese tráfico cuesta unos 10 $ en DeepSeek fuera de hora punta, 21 $ en hora punta, 202 $ en la API de Sonnet y 505 $ en la de Opus. Si pagara por token, este sería el titular de la entrada y lo habría mantenido.
No pago por token, y ese es todo el argumento. Una suscripción Max son 100 $ al mes tanto si uso el 30% del límite semanal como si lo uso al 100%. Mover el tráfico de los trabajadores a DeepSeek no bajó esa factura ni un céntimo. Añadió una segunda factura de 10 $ a 21 $ por semana encima de ella, para ahorrar capacidad en un plan cuya capacidad ya había pagado. Había confundido «más barato que la API» con «más barato que lo que yo pago», y no son lo mismo cuando lo que pagas es una tarifa plana. La comparación correcta para quien tiene suscripción es DeepSeek frente a una segunda suscripción, y ahí un segundo plan de Claude o un plan de ChatGPT con Codex cuesta más o menos lo mismo que un mes de uso moderado de DeepSeek y viene con su propio límite semanal, su propio modelo y ningún contador que vigilar.
La calidad era la otra mitad. Cinco rebanadas de backend volvieron limpias y se hicieron commit tal cual. Una rebanada de frontend eliminó un símbolo exportado y dejó intactos todos sus consumidores, así que el árbol no compilaba y una rebanada posterior tuvo que limpiarlo. Ese es exactamente el fallo que tiene un modelo que ejecuta una especificación y que no tiene un modelo que infiere la forma de un componente a partir de sus hermanos, y la skill ahora lo dice: los cambios en superficies de API compartidas van a Sonnet, y la regla del trabajador dice «nunca elimines ni renombres un símbolo exportado sin migrar a todos los consumidores en la misma ejecución». DeepSeek Flash es un buen ejecutor. El patrón arquitecto necesita un trabajador que se dé cuenta de cuándo el brief infravaloró los consumidores, y eso es justo lo único que un brief no puede aportar.
Así que la tabla de enrutamiento hoy tiene dos filas. El trabajo rutinario, el trabajo de backend contra un brief detallado con tests que satisfacer, el trabajo de frontend que sigue una gramática de diseño existente, y cualquier cambio en una superficie de API compartida van a sonnet-implementer. El trabajo cuya dificultad está en el razonamiento va a opus-implementer: una condición de carrera asíncrona, un refactor multi-sitio cuya corrección depende de sitios que el brief no puede enumerar, una migración de relleno que ningún test individual demuestra. Enruta por forma, nunca por riesgo. El riesgo cambia con qué dureza se revisa el diff y si un humano lo firma. Nunca cambia quién lo escribe.
El bucle de revisión, que es donde el patrón gana o pierde su razón de ser
El informe de un trabajador es una afirmación. El bucle de revisión de la skill es corto y cada línea salió de haberme quemado:
- Lee el informe y el
git diffreal. Contrasta el diffstat que cita el trabajador con el que ves tú. - Vuelve a ejecutar la verificación clave por tu cuenta cuando la afirmación importa.
- ¿Encontraste un problema? Envía la corrección al mismo trabajador. Todavía tiene su contexto y retoma donde lo dejó. No lo arregles a mano, no lances otro.
- Dos correcciones fallidas significan que el brief estaba infradetallado, no que el modelo sea demasiado pequeño. Descompón, pon el extracto que falta en Contexto, vuelve a ejecutar. No subas a un modelo más grande, porque implementará el mismo malentendido con más fluidez.
- Ejecuta las puertas de calidad acotadas antes de aceptar nada: los tests tocados, el linter sobre los archivos tocados, cualquier script de convenciones que lleve el repositorio.
En las transcripciones envié aproximadamente una corrección por ejecución de trabajador, 52 sobre 85 ejecuciones, y 7 ejecuciones de Opus alcanzaron su tope de 160 turnos, todas ellas en una rebanada que ahora dividiría. Esos son los dos números que vigilo. Si las correcciones por ejecución suben, mis briefs se están volviendo perezosos. Si los trabajadores alcanzan el tope, mis rebanadas son demasiado grandes.
Qué sacar de todo esto
Si pagas por token: pon el modelo caro en las decisiones y la revisión, pon uno barato en la implementación, y tarifa tu tráfico de trabajadores a precio de lista antes de elegir cuál barato. El gráfico de cuatro barras es el argumento.
Si pagas una suscripción: el patrón no reduce tu número de tokens. Mueve los tokens de implementación al modelo que consume el límite semanal compartido más despacio, conserva el límite de Fable para el trabajo que solo Fable debería hacer, y evita que tu modelo más caro gaste sus turnos en teclear. No añadas una API con contador por el lado para «ahorrar» capacidad que ya has comprado. Si te quedas sin capacidad de trabajadores, compra una segunda suscripción.
En cualquier caso, las reglas que lo hicieron funcionar eran las aburridas. Nada de suites de test completas en un trabajador. Limita los turnos. Rebanadas pequeñas, briefs cortos. Corrige al mismo trabajador una vez y luego arregla el brief.
La skill, las tres definiciones de agente y el hook de guardia están en github.com/LivinTribunal/architect-skill bajo MIT. La skill complementaria que le dice al trabajador cómo escribir código que encaje con el repositorio donde aterriza es grain-skill , y la entrada sobre ella es código con la veta .
Método
Todo lo que describe la entrada está en github.com/LivinTribunal/architect-skill : la propia skill, la plantilla de brief, la tabla de enrutamiento, las tres definiciones de agente implementador con sus topes de turnos y reglas de contexto, y el hook de guardia. Instálalo y tendrás la configuración de la que salieron los números de abajo.
Las sesiones son transcripciones JSONL de Claude Code del 19 de agosto al 22 de septiembre de 2026, entrypoint cli, tres o más prompts de usuario. Una sesión se clasifica como de arquitecto si lanzó opus-implementer, opus-implementer-xhigh o sonnet-implementer, ejecutó un trabajador ds-slice, invocó la skill de arquitecto, o envió un mensaje con un brief de implementación a un agente de propósito general, que es como funcionaron las primeras semanas antes de que existieran los agentes con nombre. Las ejecuciones de trabajador son las transcripciones de subagente bajo el directorio de cada sesión. El uso se deduplica por id de petición y se pondera: entrada nueva 1, escritura de caché de cinco minutos 1,25, escritura de caché de una hora 2, lectura de caché 0,1. Una «edición de código» es una llamada de Edit o Write sobre un archivo fuente .py, .ts, .tsx, .js, .sql o similar, excluyendo markdown y cualquier cosa bajo ~/.claude. Los precios de DeepSeek son el precio de tarifa nativo el 22 de septiembre de 2026, fuera de punta y en punta, con las lecturas de caché a la tarifa de acierto de caché y las escrituras de caché tarifadas como entrada nueva; los precios de la API de Claude son los precios de lista publicados de Opus 5 y Sonnet 5, con las lecturas de caché a una décima parte de la entrada. La semana del 21 de septiembre son dos días de datos.
