


La versión corta
- Tomé una incidencia real del backlog de FlowHunt e hice que Claude Code la implementara 13 veces en Opus 5.5, bajo siete configuraciones de instrucciones distintas. Cada ejecución partió del mismo commit, en su propio clon con su propia base de datos, y pasó por nuestro CI real de GitHub. Dos revisiones ciegas de Opus calificaron cada resultado.
- El CLAUDE.md de 33 KB del repositorio no compró calidad medible. Las ejecuciones con él obtuvieron 2,0 hallazgos bloqueantes y mayores por revisión. Una ejecución sin ningún archivo de instrucciones obtuvo lo mismo. Un archivo de 5,5 KB obtuvo 1,0.
- Una etapa de planificación separada empeoró las cosas. Las dos configuraciones que ejecutaron un prompt de planificación y luego uno de implementación costaron más que sus gemelas con prompt simple, y produjeron cuatro de los cinco bloqueantes en las 26 revisiones.
- La ganadora fue un CLAUDE.md de 8 KB, tres habilidades, trabajadores Sonnet y un prompt simple. Sus dos ejecuciones promediaron 6,68 $ a precio de lista de la API. La configuración completa con los prompts del pipeline promedió 11,49 $, unas 1,7 veces más, y tuvo más hallazgos.
- Lo que sobrevivió de toda la estructura que había construido es el brief: una descripción corta y ya decidida de una porción de trabajo que el modelo principal escribe para un trabajador más barato. Los planes para el propio modelo principal no dieron resultado. El modelo planifica bien por sí solo.
Esto continúa el artículo sobre el patrón architect , que midió quién debería escribir el código. Este pregunta cuánto hay que decirle al modelo principal antes de que empiece.
Por qué lo hice
Nuestro monorepo había acumulado muchas instrucciones para agentes. El CLAUDE.md raíz tenía 33 KB: comandos de compilación, cadencia de pruebas, estilo de código, arquitectura, rutas críticas, reglas de seguridad, reglas de permisos y créditos, las dos superficies de agente, creación de incidencias, convenciones de PR. Diez habilidades estaban bajo .claude/skills/. Además, nuestro pipeline de CI (lo llamamos harnext) hacía pasar una incidencia por un etiquetador, un paso de triaje, un paso de planificación que escribía un plan como comentario de incidencia y un paso de implementación que releía el plan y escribía el código, cada uno con su propio system prompt largo.
Cada línea de eso se añadió por una razón, normalmente después de que un agente hiciera algo mal. La pregunta que nadie había hecho era si seguía ayudando. Un CLAUDE.md se carga en cada sesión y se reenvía en cada turno. Si el modelo habría hecho lo correcto de todos modos, esos tokens son un impuesto, y como explica cuánto cuesta una ventana de contexto , un impuesto sobre cada turno se acumula más rápido de lo que parece.

¿Listo para hacer crecer tu negocio?
Comienza tu prueba gratuita hoy y ve resultados en días.
La prueba
La incidencia era una secuencia de correos programados para nuevos registros: un administrador define pasos como “día 0: bienvenida” y “día 5: tu prueba termina pronto”, y una tarea en segundo plano envía un correo a cada cuenta el día correcto, se detiene cuando la persona compra un plan de pago y omite las cuentas creadas antes del lanzamiento. Necesita una migración, un repositorio, un servicio, una tarea de Celery beat, endpoints REST, herramientas MCP para agentes y una UI de consola en 11 idiomas. Es una función realista de la primera semana, y tiene varios casos límite fáciles de pasar por alto.
Cada ejecución fue una sesión headless de Claude Code en Opus 5.5, aislada en su propio clon y base de datos, con un script que subía su commit a un PR en borrador y devolvía el resultado del CI a la sesión, hasta tres rondas. El coste es el total_cost_usd propio de Claude Code para la sesión principal más todos los subagentes, a precio de lista de la API. Yo pago una suscripción, así que esto es una medida del trabajo, no de mi factura.
Las siete configuraciones:
| Configuración | Ejecuciones | |
|---|---|---|
| A | CLAUDE.md completo de 33 KB y diez habilidades, prompts del pipeline (planificar y luego implementar) | 2 |
| B | CLAUDE.md completo y habilidades, prompt simple | 3 |
| C | Sin CLAUDE.md, sin habilidades, prompt simple | 2 |
| D | CLAUDE.md completo más la habilidad architect, prompt simple | 2 |
| E | CLAUDE.md de 8 KB, architect, grain-ponytail y unslop, prompts del pipeline | 1 |
| F | CLAUDE.md de 5,5 KB, sin habilidades, prompt simple | 1 |
| G | CLAUDE.md de 8 KB, architect, grain-ponytail y unslop, prompt simple | 2 |
De la A a la D fueron las primeras. Las E a G se construyeron a partir de lo que mostraron aquellas, y la tercera ejecución de B fue junto a ellas como control. El archivo de 8 KB es el de 5,5 KB más una lista corta de las habilidades y cuándo cargarlas, y las reglas de enrutamiento de modelos que hacen que la habilidad architect delegue en Sonnet.
Cada resultado pasó después a dos revisores Opus que solo veían una letra, el diff, el repositorio y la incidencia. Enumeraron todos los cambios que pedirían antes de aprobar, los calificaron como bloqueante, mayor, menor o nimio, y comprobaron cada criterio de aceptación contra un archivo y una línea.
Coste
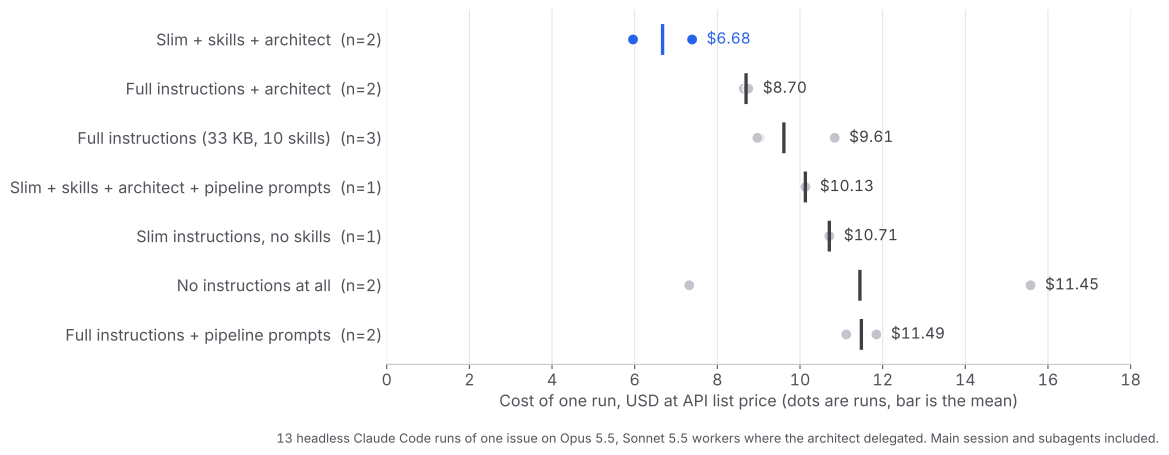
La configuración ganadora, G, costó 5,96 $ y 7,39 $. La configuración completa con prompts del pipeline, A, costó 11,12 $ y 11,85 $. La diferencia está sobre todo en los turnos y en lo que carga cada turno. Las sesiones principales de A corrieron 172 y 144 turnos en Opus con 24 a 28 millones de tokens de entrada. Las de G corrieron 79 y 95 turnos con 13 a 16 millones, y pasaron unos 60 turnos más a trabajadores Sonnet, que se facturan a una fracción de la tarifa. G además terminó su trabajo en unos 21 minutos frente a los 45 de A.
Dos cosas de este gráfico me sorprendieron. Ninguna instrucción no es la opción barata: sus dos ejecuciones costaron 7,32 $ y 15,58 $, y la cara además falló el CI y escribió el diff más grande de la prueba. Y el archivo de 5,5 KB sin habilidades, F, no fue más barato que la configuración completa. Escribió más código, 1.601 líneas de producto, y lo pagó. El ahorro de G no viene solo del archivo corto. Viene del archivo corto más las dos habilidades que cambian cómo se hace el trabajo.
Únete a nuestro boletín
Obtén los últimos consejos, tendencias y ofertas gratis.
Calidad
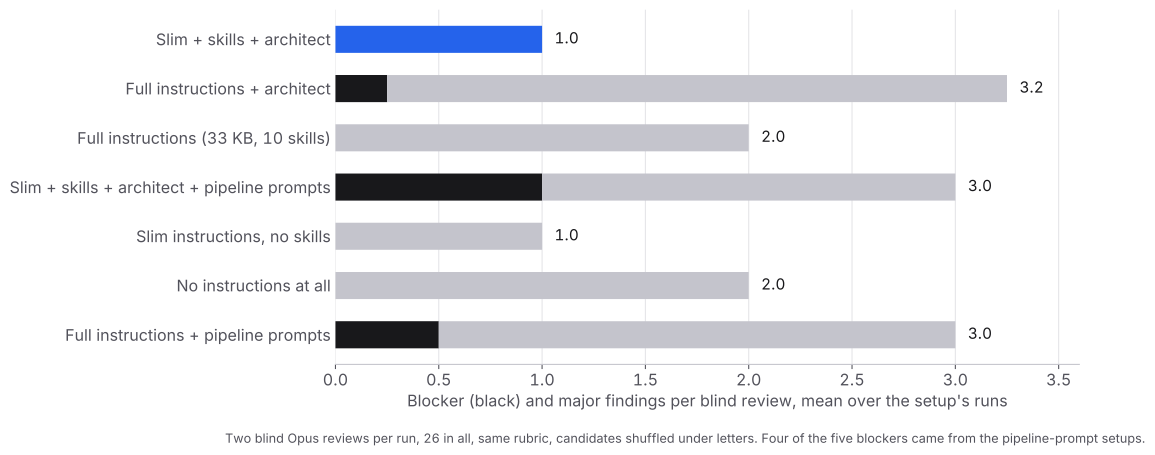
La configuración más barata también tuvo los menos hallazgos graves: ningún bloqueante, y 1,5 y 0,5 mayores por revisión en sus dos ejecuciones. El CLAUDE.md completo, B, se quedó en 2,0 mayores en sus tres ejecuciones, lo mismo que sin CLAUDE.md alguno.
Este es el resultado que más me importa. El archivo tiene secciones largas sobre seguridad, permisos y créditos, escritas porque un agente se las saltó una vez. Con o sin el archivo, los revisores encontraron el mismo número de problemas graves, y volvieron los mismos tipos en todas las configuraciones: un registro que paga y luego cancela, un correo perdido o enviado dos veces cuando un trabajador falla a mitad de camino, un editor que sobrescribe contenido que no puede mostrar. Son lagunas de razonamiento sobre el estado a lo largo del tiempo. Ninguna lista de reglas en CLAUDE.md los cubría, porque no puedes escribir una regla para un caso límite que aún no se te ha ocurrido.
Lo que sí los cubrió fue un cambio en la habilidad architect entre rondas. Antes de que el modelo principal escriba cualquier brief, ahora escribe una tabla: cada criterio de aceptación, qué ocurre cuando el estado del que depende cambia con el tiempo, y el comportamiento decidido. Cada fila pasa luego al brief con una prueba con nombre. Las ejecuciones de G escribieron 774 y 818 líneas de pruebas, frente a 510 a 670 en B.
La etapa de planificación
A y E son las dos configuraciones que ejecutaron los prompts de nuestro pipeline de CI: un prompt de planificación que escribe un plan, y luego un prompt de implementación que lee el plan y lo ejecuta. Compara cada una con su gemela, que recibió un prompt simple en su lugar. A costó 11,49 $ por ejecución frente a los 9,61 $ de B y tuvo bloqueantes donde B no tuvo ninguno. E costó 10,13 $ frente a los 6,68 $ de G y tuvo un bloqueante en cada una de sus revisiones donde G no tuvo ninguno.
Creo que la razón es que un plan es un documento que el modelo escribe para sí mismo y luego tiene que releer como una instrucción externa. La segunda sesión trata el plan como una especificación, lo sigue donde está equivocado y gasta turnos reconciliándolo con lo que encuentra en el código. Un modelo tan capaz planifica mejor dentro de la sesión que está a punto de hacer el trabajo, donde el plan y el código están en el mismo contexto.
La parte de la planificación que sí sobrevivió es el brief. Cuando el modelo principal entrega una porción a un trabajador Sonnet, el trabajador empieza con un contexto vacío y construye exactamente lo que se le dice. Esa entrega necesita una descripción escrita y ya decidida: el objetivo, los archivos, el patrón a imitar, los casos límite, la prueba a escribir. Un plan para ti mismo es sobrecarga. Un brief para otro es la única forma de que el trabajo cruce.
Qué hizo grain-ponytail
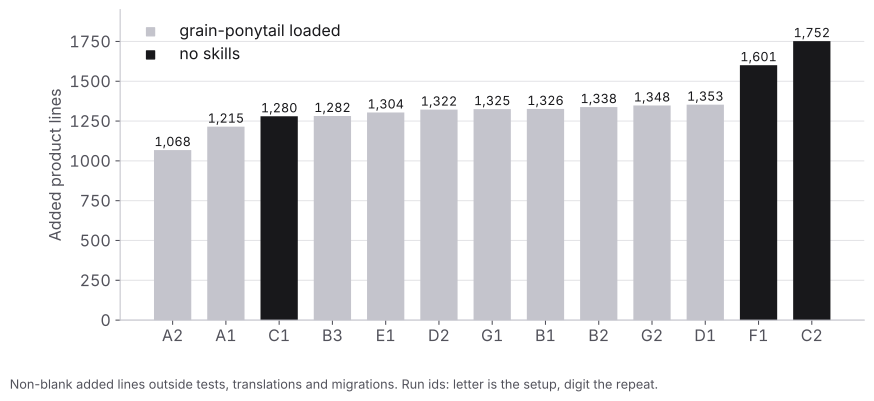
La habilidad de código a favor de la veta le dice al modelo que imite el ejemplo existente más cercano y entregue el mínimo código que funciona. Todas las ejecuciones que la tenían cargada escribieron entre 1.068 y 1.353 líneas de producto. Los dos diffs más grandes, 1.601 y 1.752, vinieron de ejecuciones sin habilidades. Una ejecución sin habilidades se quedó en 1.280, así que la habilidad no decide el tamaño por sí sola, pero eliminó la cola.
También es el caso más claro de qué tipo de instrucción sigue pagando. “Imita el ejemplo más cercano” cambia lo que el modelo hace en cada archivo que escribe. “Usa snake_case para las funciones” repite algo que ya hace.
Qué siguieron detectando las revisiones
La ejecución ganadora no estaba limpia. Después de la prueba hice rebase del trabajo de G2 sobre main y lo pasé por nuestra comprobación completa de PR, que revisa el diff, demuestra cada hallazgo con una prueba que falla y lleva el cambio a un navegador real. Encontró que el editor de pasos descartaba todos los bloques excepto el primero de HTML cuando un administrador editaba un paso creado por MCP, y que una liberación de reserva fallida podía enviar correo dos veces a algunos usuarios. Ambos se corrigieron, con pruebas, antes de que el PR pasara a revisión humana.
Los revisores ciegos también señalaron más sobreingeniería en las ejecuciones con architect que en las de instrucciones completas: 2,5 elementos por revisión en G frente a 0 a 1,0 en las ejecuciones de A y B. Menos hallazgos graves, más nimiedades. Yo aceptaría ese intercambio, pero es un intercambio.
Qué cambié
- El CLAUDE.md de 33 KB se convirtió en un AGENTS.md de 12 KB que Codex también lee, y CLAUDE.md ahora solo lo importa. Conserva los comandos, la cadencia de pruebas, la arquitectura y las reglas que un modelo no puede inferir del código, como qué rutas son críticas y que las dos superficies de agente deben mantenerse sincronizadas.
- La etapa de planificación desapareció del pipeline. El triaje entrega la incidencia directamente a una etapa de implementación cuyo prompt se redujo a seis pasos: lee la incidencia, crea la rama, carga las habilidades architect y grain-ponytail, prueba, haz commit, abre un PR en borrador.
- La habilidad architect ganó la tabla de casos límite, un campo Tests en el brief y una pasada final que comprueba todo el diff contra la incidencia en lugar de contra los briefs. Esa versión es pública en github.com/LivinTribunal/architect-skill .
El cambio del repositorio está en revisión en el momento de escribir esto.
Qué sacar de esto
Si tu CLAUDE.md creció una incidencia a la vez, probablemente esté pagando por reglas que el modelo ya sigue. Recórtalo a lo que el modelo no puede averiguar leyendo el código, y mide antes y después en una tarea real en lugar de confiar en que más guía es más seguro.
Conserva las instrucciones que cambian cómo se hace el trabajo: quién escribe el código, cómo se briefa una porción, qué patrón existente copiar. Elimina el pipeline de planificar y luego ejecutar si tu modelo principal es uno frontera actual. Escribe briefs para los trabajadores, no planes para ti mismo.
Método
13 ejecuciones headless de Claude Code 2.1.289 el 5 de octubre de 2026, modelo principal Opus 5.5, trabajadores Sonnet 5.5 donde la habilidad architect delegaba. Todas las ejecuciones partieron de un commit del monorepo de FlowHunt, cada una en un clon APFS con su propia base de datos Postgres, aislada de las otras ejecuciones y de los propios archivos del experimento. Un broker subía el commit de cada ejecución a un PR en borrador contra una rama base congelada y reanudaba la sesión con el resultado del CI, hasta tres rondas. El coste es el total_cost_usd máximo por sesión, sumado sobre la sesión principal y sus subagentes. Las líneas de producto son líneas añadidas no vacías fuera de pruebas, traducciones y migraciones.
Cada resultado recibió dos revisiones ciegas de Opus con una sola rúbrica: corrección, criterios de aceptación, veta, campos privados y estado oculto, sobreingeniería, seguridad y permisos, pruebas, migraciones. Los candidatos se barajaron bajo letras, y los revisores podían leer el repositorio pero no ejecutar nada. Los hallazgos por revisión se promedian sobre las ejecuciones de una configuración. Con una a tres ejecuciones por configuración, toma la media de una sola configuración como ruidosa. Las conclusiones anteriores son las que se mantuvieron en las dos rondas.
