


La versión corta
- Los agentes de IA de programación son buenos añadiendo código y malos notando que el código ya existe. Si se les deja solos, le dan a un repositorio un segundo helper por cada primero, y cada lector tiene que revisar ambos para confiar en cualquiera de los dos.
- La solución son dos hábitos escritos para que un agente los siga. Grain: encuentra el ejemplo existente más cercano del mismo tipo de cosa y replica su forma, su lugar y sus nombres. Ponytail: sube una escalera desde “¿esto necesita existir?” hasta “lo mínimo que funciona” y detente en el primer peldaño que aguante.
- Ambos son ahora una skill pública, con licencia MIT: grain-skill en GitHub . Contiene las reglas de autoría, una pasada de revisión con etiquetas fijas y la forma de la línea de cierre que hace que el agente nombre lo que replicó.
- En nuestro repositorio principal desde agosto: 386 issues y pull requests llevan un comentario de plan que nombra el ejemplar a replicar, a lo largo de 1.333 commits en un árbol de unas 18.000 archivos. 35 lugares del código llevan un comentario
ponytail:que nombra una simplificación deliberada y su ruta de mejora. - El hallazgo incómodo: el agente invocó la skill como skill cero veces. Las reglas funcionaron porque también las puse en el CLAUDE.md del proyecto, en las definiciones de los agentes trabajadores y en la checklist de revisión. Pon la regla donde el agente ya lee.
Ya escribí sobre esto una vez y no me gustó el resultado, porque describía el principio y no el mecanismo. Esta es la versión con el mecanismo.
El fallo para el que sirve esto
Tres ejemplos de nuestro backend, todos reales, todos de pull requests escritos por agentes que pasaron sus tests.
Una nueva ruta REST que sacaba el servicio de aplicación directamente de una factory. Todas las rutas hermanas del repositorio van de ruta a controlador a servicio a repositorio, con cada salto inyectado. Esta colapsaba la cadena a ruta → servicio. Funcionaba. También significaba que no existía el único lugar donde viven la validación de la petición y el modelado de la respuesta para esa funcionalidad, y el siguiente agente que tocara la funcionalidad tendría dos formas entre las que elegir.
Un servicio sobredimensionado dividido en _payloads.py, _protocol.py y _tokens.py, cada uno un módulo de async def desnudos, con el servicio llamando a protocol.discover(...) por import. La comprobación de longitud de archivo se puso en verde. Volvió justo lo que la inyección de dependencias existe para evitar: un colaborador elegido en tiempo de import, no sustituible sin parchear el módulo, ausente del constructor que documenta de qué depende el servicio.
Un segundo normalizador. Ya había uno. El agente no lo encontró, escribió otras ocho líneas que hacían casi lo mismo, y ahora dos funciones con distinto comportamiento en los casos límite afirman canonicalizar el mismo campo.
Ninguno de estos es un bug en el sentido que un test detecta. Cada uno es un agente eligiendo el código que podía generar en lugar del código que existía. Haz eso a lo largo de unos cientos de pull requests y el repositorio deja de tener una forma.

¿Listo para hacer crecer tu negocio?
Comienza tu prueba gratuita hoy y ve resultados en días.
Grain
El código nuevo debería ser indistinguible del código que lo rodea. La skill convierte esa frase en cinco pasos que un agente da antes de escribir.
Encuentra primero el ejemplar. Para un endpoint, un servicio, un repositorio, un query hook, una slice de store o un componente, localiza el más cercano que ya exista y copia su forma, su ubicación de archivo y su nomenclatura. No inventes estructura cuando ya existe un patrón. En nuestro repositorio la slice branding es el ejemplar nombrado para el backend porque es pequeña, limpia y abarca todas las capas, y la tabla de la skill dice, para cada tipo de artefacto, qué archivo abrir y qué replicar.
Respeta las capas. Presentación llama a aplicación, aplicación llama a dominio, e infraestructura implementa dominio. Un import nuevo que cruce esas líneas falla la comprobación de arquitectura. Lee el documento de capas, no lo rederives.
Veta local contra veta del repositorio. Ajústate a tus hermanos. Pero si los propios hermanos divergen de la cadena canónica, sigue la cadena canónica y anota la divergencia en lugar de copiar la deriva. “Coincide con las otras cinco rutas de este archivo” no basta si las seis se saltan una capa que usa la slice canónica. Comparaste demasiado localmente.
Reutiliza el helper canónico. Si un helper, un tipo o un patrón ya viven en el repositorio, úsalos. Dos normalizadores obligan a cada lector a comparar ambos.
Los nombres llevan significado. Reutiliza el vocabulario que ya está en el código. Un nombre nuevo para un concepto existente es un bug esperando a un lector.
El test al final es el que doy a los revisores: si puedes saber qué líneas escribió el agente solo por su forma, luchó contra la veta.
Ponytail
Vago significa eficiente, no descuidado. El mejor código es el código que nunca se escribe. Entiende primero el problema por completo, cada archivo que toca el cambio, el flujo real de extremo a extremo, y luego sube esta escalera y detente en el primer peldaño que aguante.
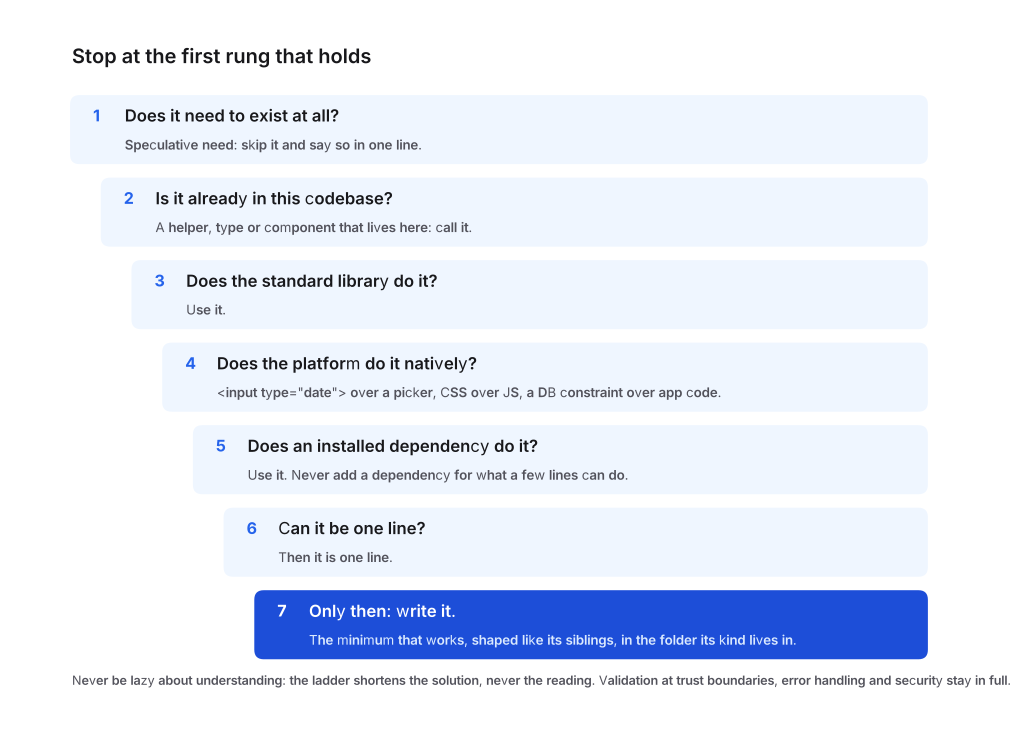
Dos reglas acompañan a la escalera.
Un bugfix es una causa raíz, no un síntoma. Un ticket nombra un síntoma. Haz grep de todos los llamadores de la función que estás a punto de tocar. Un guard en la función compartida es un diff más pequeño que un guard en cada llamador, y parchear solo el camino que nombra el ticket deja rotos a los llamadores hermanos.
Mantén el diff mínimo. El diff es lo que lee la revisión. Sin refactors de paso, sin renombrados, sin reformateos, sin mejoras del tipo “ya que estoy aquí”, sin tocar archivos que la tarea no requería. Cada una de esas cosas entierra el cambio real. Si el diff es más grande que el problema, recórtalo. Las mejoras que detectaste son una issue de seguimiento, no commits extra en esta rama.
Y los límites, porque “vago” es la palabra con más probabilidad de malinterpretarse. Nunca simplifiques eliminando la validación de entrada en una frontera de confianza, el manejo de errores que evita la pérdida de datos, la seguridad, los básicos de accesibilidad ni nada que el usuario haya pedido. Nunca seas vago al entender: la escalera acorta la solución, nunca la lectura. Un diff pequeño en el lugar equivocado es un segundo bug. La lógica no trivial deja detrás una comprobación ejecutable, lo más pequeño que falla si la lógica se rompe.
Cuando el agente sube un peldaño a propósito y conoce el techo, lo dice en el código:
# ponytail: global lock, per-account locks if throughput matters
Hay 35 de esos en nuestro repositorio ahora. Cada uno es una decisión que un lector futuro tendría que reconstruir de otro modo, y un marcador de dónde mirar cuando se alcance el techo.
Únete a nuestro boletín
Obtén los últimos consejos, tendencias y ofertas gratis.
Conseguir que un agente realmente lo haga
Un principio en un documento no es un comportamiento. Tres mecanismos convirtieron estos dos en comportamientos, y los ordenaría así.
El brief lleva el ejemplar. En el patrón arquitecto el modelo principal escribe un brief para un trabajador, y el campo Design del brief nombra el patrón existente más cercano a replicar y el cambio mínimo de causa raíz. El trabajador no tiene que encontrar la veta. Se la entregan. En todo nuestro repositorio eso es lo que son los 491 comentarios de plan en 386 issues y pull requests: un paso de planificación que nombra qué replicar antes de que nadie escriba.
El agente cierra con lo que replicó. El informe de cada implementador termina con una línea, mirrored: <path>, o nombra el patrón nuevo y por qué no encajaba ningún hermano. Esto es barato y es la mejor ayuda de revisión que he añadido. Una línea mirrored: que apunta al tipo de archivo equivocado te dice que el diff está mal antes de abrirlo. Una que falta te dice que el agente no miró.
La revisión aplica el mismo listón, en un orden fijo. Nuestra skill de revisión tiene dos pasadas con etiquetas fijas, y las etiquetas son lo que hace comparables los hallazgos entre revisores y entre agentes.
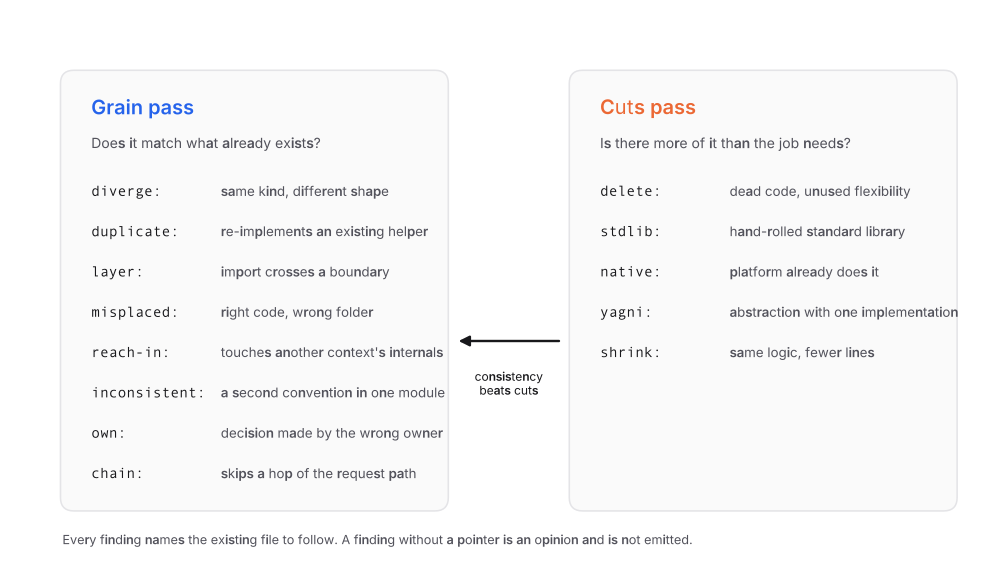
Estructura primero. ¿Esto diverge del ejemplar más cercano, duplica un helper existente, cruza una capa, está en el lugar equivocado, se mete en las interioridades de otro módulo, usa nombres inconsistentes, se apropia de algo que debería inyectar o rompe la cadena de llamadas canónica? Luego los recortes. ¿Qué podría borrarse, sustituirse por la biblioteca estándar, sustituirse por una funcionalidad nativa, descartarse por especulativo o reducirse?
El orden es una regla, no una preferencia. La consistencia gana a los recortes. Un recorte que deja el código divergiendo de sus hermanos no es una victoria, porque ahora el lector tiene que aprender dos formas para ahorrar ocho líneas. Corre la estructura primero y la pasada de recortes solo toca código que ya encaja.
Qué pasó en el repositorio, incluida la parte que no funcionó
Desde el 1 de agosto nuestro repositorio principal ha recibido 1.333 commits, la mayoría escritos por agentes y bajo revisión. 386 de las issues y pull requests de ese periodo llevan un comentario de plan que nombra el ejemplar a replicar, 491 de esos comentarios en total. La cadena canónica es la forma por defecto de un endpoint nuevo, y las dos rutas heredadas que se saltan el controlador están listadas en el documento como una divergencia en proceso de retirada, no como un segundo estilo.
Los 35 comentarios ponytail: son una cifra más pequeña de lo que esperaba y creo que es correcto. La mayoría de las simplificaciones no merecen un comentario. Las que lo merecen son las que tienen un techo.
Ahora la parte que preferiría no contar. Publiqué grain y ponytail como skill de Claude Code: una descripción en el índice de skills, un cuerpo que se carga bajo demanda y una línea en CLAUDE.md diciendo que se invocara antes de escribir código. A lo largo de cinco semanas de transcripciones, el agente la invocó por su nombre cero veces. La línea de cierre mirrored: apareció en siete respuestas.
Las reglas aun así calaron. Calaron porque el mismo texto también estaba en tres lugares que el agente lee sin elegir: el CLAUDE.md del proyecto, que está en contexto desde el primer turno; las definiciones de los agentes trabajadores, que dicen “replica la forma, la ubicación y la nomenclatura del ejemplo existente más cercano” y “busca la solución más vaga que realmente funcione” como reglas, no como una skill a considerar; y la checklist de revisión, cuyas etiquetas hacen fallar un pull request que las ignora. El cuerpo de la skill se convirtió en la referencia canónica a la que apuntan esos tres. Como disparador, no hizo nada.
Así que la lección que le pasaría a cualquiera que empaquete convenciones para un agente es esta. Una skill es un buen lugar para la versión larga de una regla. Es un mal lugar para la regla en sí, porque el agente tiene que decidir cargarla y en general no lo hará. Pon la versión de un párrafo en el archivo que siempre está en contexto, pon la versión imperativa en la definición del agente que escribe el código, y pon la comprobación en la revisión que controla el merge. Luego apunta las tres a la skill para el detalle.
La versión pública en github.com/LivinTribunal/grain-skill está organizada así: un SKILL.md corto con las reglas que un agente puede sostener en la cabeza, el documento completo con la escalera y los antipatrones, las etiquetas de revisión y un README que dice qué párrafo va en tu CLAUDE.md y cuál va en la definición de tu implementador. Sustituye el ejemplo desarrollado por tu propio ejemplar canónico y ya está.
