


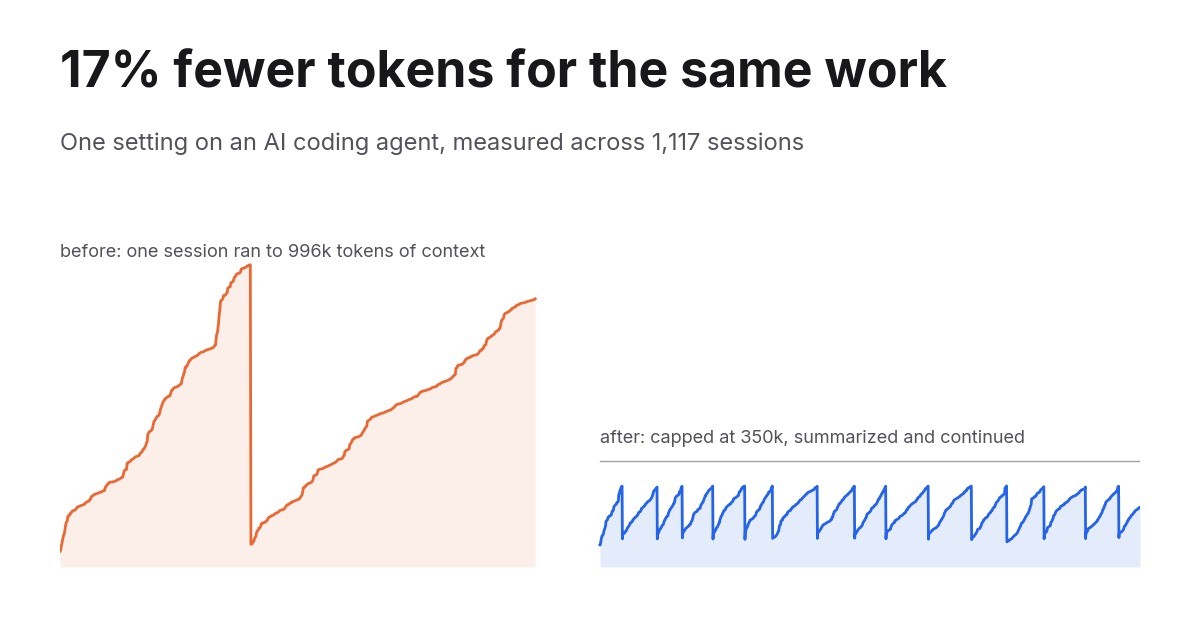
La versión corta
- Ejecuto un agente de programación con IA todo el día sobre un modelo con una ventana de contexto de 1M de tokens. Las sesiones solían crecer hasta casi llenarla.
- Añadí una línea a su configuración, limitando una sesión a 350.000 tokens de contexto antes de que se resuma a sí misma y continúe.
- Medido en 1.117 transcripciones de sesiones: un 17% menos de tokens para el mismo número de prompts, y en las sesiones largas donde el límite realmente actúa, un 55% menos.
A continuación está el método, todos los gráficos y lo que te cuesta a cambio, para que puedas decidir si se aplica a tu configuración.
Por qué una ventana de 1M cuesta más de lo que parece
Una conversación con un modelo no tiene estado. Cada solicitud lleva todo el historial: el prompt del sistema, cada definición de herramienta, cada archivo que el agente ha leído, cada resultado de herramienta, cada mensaje. No un delta. Todo, cada vez.
Así que una sesión que ha crecido hasta 900.000 tokens paga por 900.000 tokens de entrada en la siguiente llamada, y en la posterior. El turno 400 no hace más trabajo que el turno 4. Simplemente cuesta muchas veces más.
El almacenamiento en caché de prompts suaviza esto. Los tokens que el modelo ya ha visto se facturan a aproximadamente una décima parte del precio de entrada normal. Ese descuento es real, es lo que hace viables las sesiones largas y es también la razón por la que nadie mira el problema. En mis datos, el 98% de todos los tokens de entrada eran lecturas de caché. Una décima parte de un número muy grande seguía siendo la línea más grande de la factura.
La cuestión no es si tu historial está en caché. Es cuánto se le permite crecer antes de que algo lo reinicie.

¿Listo para hacer crecer tu negocio?
Comienza tu prueba gratuita hoy y ve resultados en días.
Lo que cambié
El agente es Claude Code ejecutando Opus en la ventana de contexto de 1M. El ajuste es autoCompactWindow en ~/.claude/settings.json. Cuando una sesión alcanza esa cantidad de tokens, el agente resume la conversación y continúa desde el resumen.
{
  "autoCompactWindow": 350000
}
Nunca lo había configurado, así que las sesiones corrían hasta acercarse a la ventana completa. Durante cuatro días probé tres valores:
| Fecha | Ajuste |
|---|---|
| 14 de septiembre | 250.000 |
| 15 de septiembre | 300.000 |
| 18 de septiembre | 350.000 |
Cómo lo medí
Claude Code escribe cada sesión en una transcripción JSONL dentro de ~/.claude/projects/, incluido el uso de tokens de cada llamada a la API. Analicé las 1.117, que cubren cinco semanas desde el 19 de agosto hasta el 22 de septiembre, deduplicadas por ID de solicitud, y conservé solo las sesiones interactivas. Las ejecuciones en GitHub Actions usan la misma cuenta, pero no pueden verse afectadas por un ajuste de mi portátil, así que quedan excluidas.
Los totales brutos de tokens engañan por sí solos. Una semana ajetreada supera a una tranquila hagas lo que hagas. Por eso cada número de abajo está ponderado por caché, que es lo que el contador lee realmente: entrada nueva a 1x, escrituras de caché a 1,25x (caché de 5 minutos) o 2x (caché de 1 hora), lecturas de caché a 0,1x. Y cada comparación está normalizada por el trabajo realizado, ya sean los prompts que escribí o las llamadas a la API que hizo el agente.
Únete a nuestro boletín
Obtén los últimos consejos, tendencias y ofertas gratis.
Dos sesiones, el mismo agente
Este es el mecanismo en una imagen. A la izquierda, una sesión real del 3 de septiembre, antes del límite. A la derecha, una sesión real del 15 de septiembre, después.
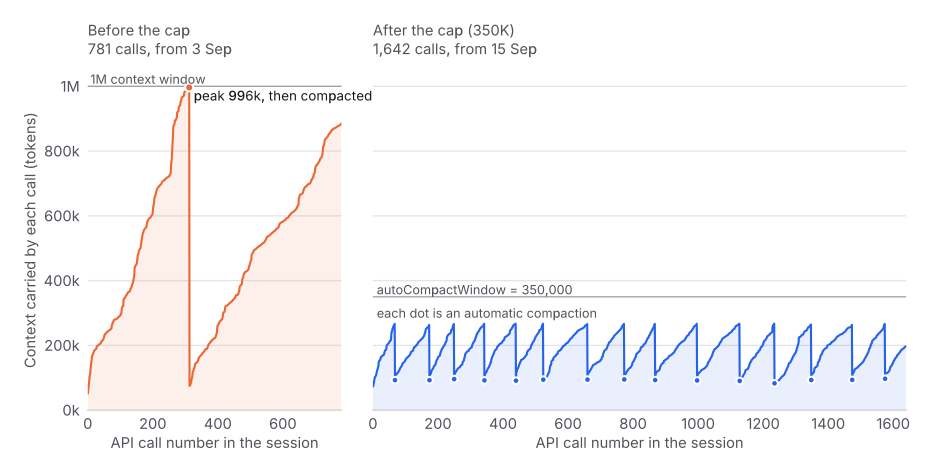
La sesión de la izquierda duró 781 llamadas. Subió hasta 996.000 tokens de contexto, chocó con el muro de la ventana de 1M, se compactó una vez y luego volvió a subir directamente hasta 880.000. Durante la segunda mitad de esa sesión, cada una de las llamadas releía más de medio millón de tokens.
La sesión de la derecha duró 1.642 llamadas, más del doble, y nunca llevó más de 270.000. Se compactó quince veces. Cada compactación es un punto.
Los números semanales
Solo sesiones interactivas. Las barras son tokens de entrada ponderados por caché por llamada a la API, que es el número único más justo porque no le importa cuánto trabajé en una semana concreta.
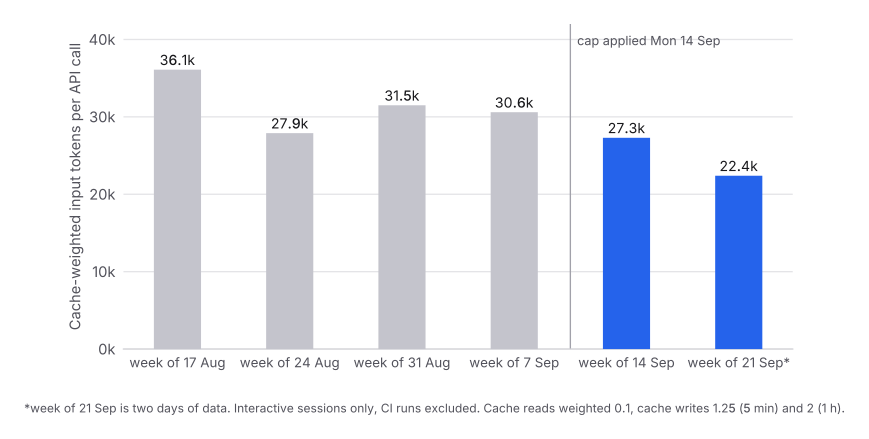
La comparación más limpia del conjunto de datos es la semana del 7 de septiembre frente a la semana del 14 de septiembre, porque no las elegí yo. Simplemente cayeron a uno y otro lado del cambio, y escribí casi exactamente el mismo número de prompts en cada una.
| Semana del | Prompts | Llamadas a la API | Entrada ponderada por caché | Por llamada |
|---|---|---|---|---|
| 7 sep | 971 | 11.364 | 348,1M | 30,6k |
| 14 sep | 968 | 10.555 | 288,5M | 27,3k |
971 prompts frente a 968. La entrada efectiva bajó de 348,1M a 288,5M. Eso es un 17% menos para la misma cantidad de prompts. Los dos días de la semana siguiente llegaron a 22,4k por llamada, aún más bajo.
A dónde iba el dinero
Divide cada llamada a la API según cuánto contexto llevaba, y el mecanismo se ve directamente.
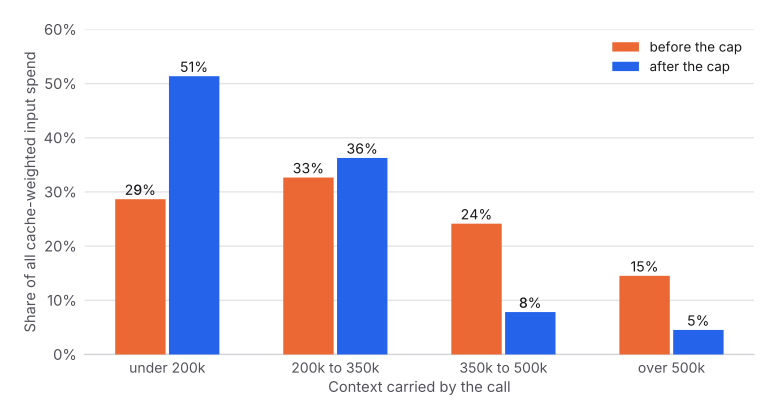
Antes del límite, el 39% de todo lo que gasté fue a llamadas que arrastraban más de 350.000 tokens de historial. Esas llamadas no hacían más trabajo que las demás. Era el mismo trabajo, con más equipaje. Después del límite esa cuota es del 12%.
¿Aguantó el techo?
Un punto por sesión, situado en el mayor contexto que esa sesión llegó a llevar.
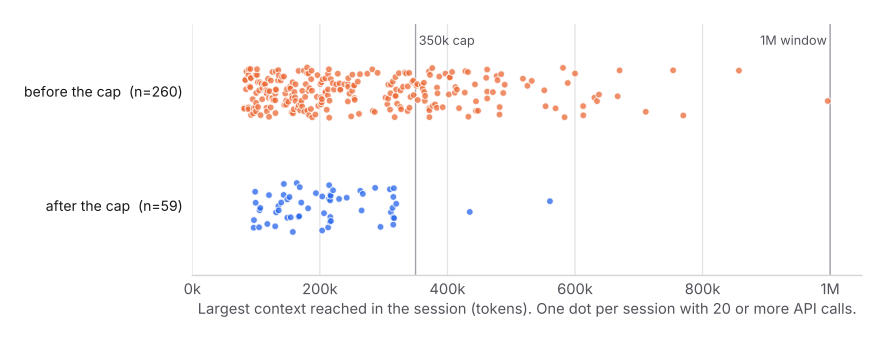
Dos sesiones de los dos primeros días siguieron pasándose del límite, hasta 434.000 y 561.000, y no descubrí por qué. Desde que se aplicó el ajuste de 350.000 el 18 de septiembre, ninguna sesión lo ha superado. La cola de sesiones que vivían entre 500k y 1M, que es donde estaba la mayor parte del desperdicio, ha desaparecido.
Lo que habría costado sin el límite
Para ponerle un total, reproduje cada sesión que empezó después del cambio como si el contexto descartado nunca se hubiera resumido y se siguiera releyendo en cada llamada posterior, acotado a la ventana de 1M.
| Entrada ponderada por caché | |
|---|---|
| Real, 73 sesiones, 9.675 llamadas, 55 compactaciones | 216,8M |
| Las mismas sesiones sin el límite | 479,2M |
| Evitado | 262,5M, o un 55% |
La sesión de la derecha del primer gráfico representa por sí sola 118,5M de eso. Una refactorización larga que, de otro modo, habría pasado sus últimas cientos de llamadas releyendo cerca de un millón de tokens cada una.
Toma el 55% como el extremo optimista. Sin el límite, en realidad no habría dejado que una sesión se arrastrara a 900k durante horas; al final la habría vaciado a mano, lo que también reinicia el coste. El extremo conservador es la cifra observada por llamada, de 30,6k a 22,4k, así que aproximadamente entre el 20% y el 27%. La verdad está en algún punto intermedio.
Lo que te cuesta
Esto no es gratis, y quien lo recomiende debería decirlo.
Espera. 67 compactaciones desde el cambio, con una mediana de unos tres minutos cada una. Aproximadamente 3,4 horas viendo cómo se escribe un resumen, repartidas en ocho días.
Algo de retrabajo. La compactación descarta mucho. Con el ajuste de 350K, la compactación mediana llevaba una sesión de 318.000 tokens hasta 24.000. El agente pierde detalle y a veces lo reconstruye: los archivos releídos dentro de la misma sesión pasaron del 11,5% de las lecturas antes de la primera compactación al 20,5% después. La muestra que respalda ese segundo número es pequeña, así que léelo como una dirección más que como una medición.
La elección del umbral importa. Con 250K, el 36% de mis sesiones largas llegaba a una compactación. Con 350K, lo hacía el 12%, y el techo seguía aguantando. Configúralo demasiado bajo y pagas los tres minutos y el retrabajo una y otra vez por un ahorro que ya habías consolidado.
Cómo configurarlo
Claude Code. Añade autoCompactWindow a ~/.claude/settings.json. En un modelo con contexto de 1M, 350.000 fue el mejor de los tres valores que probé. En un modelo de 200K, reduce la escala y empieza en torno a 120.000–140.000. Las sesiones nuevas lo adoptan; una sesión que ya está en marcha mantiene el valor antiguo.
Otros agentes. Busca la misma idea con otro nombre: un disparador de compactación, un límite de contexto, un umbral de resumir y continuar. Si no hay ninguno, la versión manual es vaciar la sesión más a menudo de lo que parece natural. El instinto de mantener viva una sesión larga todo el día porque “conoce el proyecto” es el caro.
Sea lo que sea lo que uses, dos hábitos hacen más que cualquier ajuste. Mantén el estado duradero en archivos en lugar de en la conversación, para que el agente pueda releer un archivo a bajo coste en vez de arrastrar para siempre cada respuesta anterior. Y deriva el trabajo con mucha lectura a subagentes con su propio contexto de vida corta, para que los veinte archivos que leen no entren nunca en la sesión principal.
Si tienes un límite semanal
Si pagas una suscripción con un límite de uso semanal en lugar de una factura por token, esta es la palanca con la mejor relación entre esfuerzo y efecto que he encontrado. Una línea de JSON, sin cambios en cómo trabajas, y el mismo límite se estira de forma medible. En mi caso, el mismo volumen semanal de prompts costó un 17% menos, y las sesiones largas costaron aproximadamente la mitad.
Lee a continuación
Las ventanas de contexto se venden como capacidad. Se comportan como un contador en marcha, que cobra en cada turno por todo lo que has puesto alguna vez. Si quieres la mecánica que hay detrás de esto en lugar de solo el ajuste, el artículo complementario recorre qué llena realmente una ventana de contexto, por qué una sesión larga cuesta mucho más que el trabajo que realiza y cómo el almacenamiento en caché, el vaciado y la compactación cambian cada uno la aritmética.
