


Hace unos días, Anthropic convirtió Fable en parte permanente de los planes Max. El momento lo dice todo: llegó justo después de que OpenAI lanzara GPT-5.6 Sol y —más importante aún— justo después de que Kimi K3 liberara sus pesos. Hizo falta un modelo open source para obligar al mayor laboratorio de IA a bajar a la realidad y poner fin al revuelo de marketing en torno a su buque insignia. Solo por eso merece un brindis cualquiera que pague estas facturas.
Pero “incluido en tu suscripción” no es lo mismo que “barato”, y desde luego no es lo mismo que “barato para siempre”. Por eso, mientras Fable aún se facturaba por uso, reconstruimos nuestro flujo de trabajo para que el modelo caro quedara bloqueado mecánicamente para escribir código. Piensa, planifica y revisa. Los modelos más baratos teclean. Este artículo muestra cómo funciona y qué midió de verdad en todos los transcripts que tenemos: 606 sesiones reales que abarcan un monorepo SaaS en producción, una app de operaciones con drones, un sitio de marketing y los agentes de CI que les dan servicio.
Parte 1 — La trampa y el principio
Nuestro punto de partida honesto es este: ya no podemos operar sin modelos frontera. Nadie en el equipo podría sostener el ritmo de producción actual sin ellos, y esa dependencia es exactamente la palanca que tienen los grandes laboratorios. En nuestra lectura, las suscripciones de IA de hoy entregan bastante más cómputo de lo que cuestan; son precios de conquista de mercado, y los precios de conquista se acaban. Cuando eso ocurra, quien haya construido su cultura de ingeniería alrededor de “tokens frontera ilimitados” pagará lo que le pidan.
Hay dos defensas. La primera es mantener una salida creíble: los modelos abiertos como DeepSeek y Kimi son los que forzaron la corrección de precios de esta semana, y solo seguirán siendo una palanca si de verdad mantenemos nuestros flujos de trabajo portables a ellos. La segunda es disciplina de flujo de trabajo: gastar tokens frontera solo donde nada más barato funciona. Este artículo trata de la segunda, porque es la que puedes empezar el lunes.
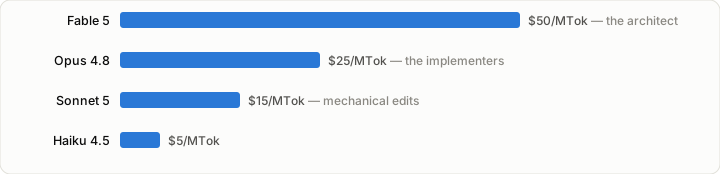
El principio es tan antiguo que hay un edificio con su nombre: el arquitecto no coloca ladrillos. La ventaja de un modelo frontera sobre uno de gama media es enorme en diseño, descomposición y revisión, y casi nula a la hora de escribir un renombrado en cuarenta archivos. Así que divide los roles. La escalera de precios dice lo mismo en dólares:
Cómo funciona el patrón fable-architect
La skill fable-architect es un archivo markdown de ~100 líneas más un hook de shell, que se carga siempre que una sesión de Claude Code corre sobre el modelo frontera. Impone una división del trabajo:
- El arquitecto hace: interrogar el requisito, explorar el código, tomar todas las decisiones de diseño —enfoque, flujo de datos, nombres, firmas, casos límite—, descomponer el trabajo en porciones independientes, revisar los diffs devueltos, ejecutar la verificación y escribir toda la prosa (planes, briefs, cuerpos de PR, mensajes de commit).
- El arquitecto nunca hace: escribir o editar un archivo de código fuente. Nada de código en el chat más allá de firmas cortas dentro de un brief.
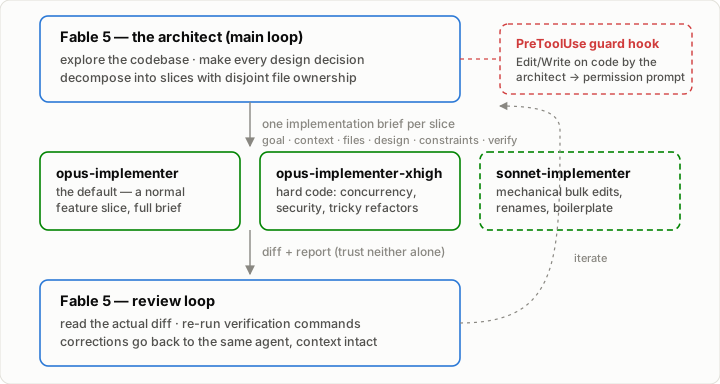
Tres cosas hacen que esto funcione en la práctica y no solo sobre una diapositiva.
1. El brief es la interfaz
Cada porción recibe un brief de implementación. El implementador arranca con una ventana de contexto nueva: todo lo que no esté en el brief tendrá que redescubrirlo o adivinarlo. Esa restricción es una ventaja: obliga al arquitecto a terminar de decidir antes de delegar. Un brief contiene decisiones, no opciones.
## Implementation brief: <slice>
Goal:         una frase, resultado observable
Context:      lo que ya encontró la exploración — extractos, el patrón
              más cercano a imitar, anclas de línea, trampas
Files:        rutas a crear/modificar — propiedad exclusiva de esta porción
Design:       el enfoque decidido — flujo de datos, nombres, firmas, bordes
Constraints:  reglas del proyecto que aplican: estilo, capas, seguridad
Out of scope: qué no tocar, incluidos archivos de otras porciones
Delegation:   si esta porción puede generar sub-implementadores, y cuántos
Verify:       comandos exactos y resultado esperado
Dos de esas líneas son más nuevas que el resto, y existen porque el nivel del implementador cambió bajo nuestros pies: mira la actualización más abajo.
2. Cumplimiento forzoso, no buenas vibras
Un hook de guardia PreToolUse vigila la sesión: si el arquitecto intenta editar un archivo que no es prosa, se dispara un aviso de permiso. Aprobar ese aviso es la excepción documentada para ediciones triviales (una errata, un bump de versión: casos en los que el coste de delegar supera al de teclear). La fricción es la política. Sin el hook, “el modelo caro no debería programar” dura exactamente hasta la primera fecha límite.
3. El bucle de revisión cierra la brecha de calidad
El arquitecto lee el informe del agente y el diff real —sin fiarse de ninguno por separado— y vuelve a ejecutar los comandos de verificación clave cuando la afirmación importa. ¿Encontró un problema? La corrección vuelve al mismo agente, que todavía conserva todo su contexto de trabajo. Sin arreglos a mano, sin reiniciar desde cero.
Fíjate en que esta es la verificación del arquitecto, y se queda. Lo que hemos empezado a eliminar es la verificación que solíamos escribir en los briefs: instrucciones que le decían al implementador que se revisara a sí mismo. Los modelos implementadores más nuevos lo hacen sin que se lo pidan, y decirles que lo hagan otra vez compra una segunda pasada que ya pagaste.

¿Listo para hacer crecer tu negocio?
Comienza tu prueba gratuita hoy y ve resultados en días.
Lo que medimos
Para comprobar si esto es un mecanismo económico real o solo un ritual agradable, minamos todos los transcripts de Claude Code de nuestros proyectos, deduplicando las peticiones a la API y valorando cada token a los precios de lista actuales. Tres hipótesis, registradas antes de mirar los números por sesión:
- H1 — Los implementadores teclean. Si es cierto, los subagentes implementadores deberían producir más tokens de salida que el bucle principal del arquitecto en las sesiones delegadas.
- H2 — Delegar es más barato. Si es cierto, recalcular el trabajo de los implementadores a las tarifas del modelo arquitecto debería salir notablemente más caro que lo que pagamos de verdad.
- H3 — La calidad se mantiene. La difícil: el código delegado no debería necesitar más retrabajo que el código tecleado por el arquitecto.
Reglas del juego. Una petición a la API abarca muchas líneas del transcript que repiten el mismo objeto de uso: agrupamos por ID de petición, contamos los tokens de entrada y de caché una vez por petición y tomamos la instantánea máxima de salida (la suma ingenua línea por línea sobrecuenta 2–3×). Los costes usan los precios de lista actuales de Anthropic —Fable $10/$50, Opus $5/$25, Sonnet $3/$15 por millón de tokens de entrada/salida— con lecturas de caché al 10% del precio de entrada y escrituras de caché a sus tarifas por TTL. 31 de 354 sesiones del almacén interactivo califican como sesiones fable-architect bajo un clasificador conservador; las cifras muestran las ocho más caras. Reportamos ratios y porcentajes en lugar de nuestro gasto absoluto.
Parte 2 — Los recibos
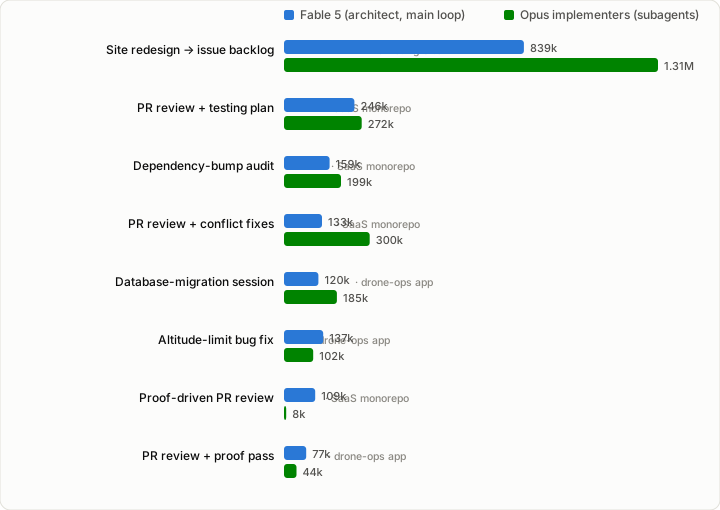
H1 — Mixto… dijo la primera contabilidad. En las mayores sesiones de delegación la hipótesis se cumple de forma contundente: hasta 2,3× más salida del implementador que del arquitecto. Pero en las 31 sesiones fable-architect el arquitecto seguía produciendo más que los implementadores, 3,59M frente a 3,15M tokens. En parte es justo —la salida del arquitecto incluye todos los planes, briefs y prosa de revisión, que es exactamente su trabajo— y en parte parecía que las sesiones delegaban una porción y se quedaban con el resto. Luego recordamos que el rediseño de nuestro sitio no se había sentido para nada cargado de arquitecto, y fuimos a buscar los tokens que la contabilidad de subagentes no podía ver.
Únete a nuestro boletín
Obtén los últimos consejos, tendencias y ofertas gratis.
El segundo canal: el gestor de incidencias como bus de delegación
La contabilidad de subagentes tiene un punto ciego: solo ve la delegación que ocurre dentro de una sesión. La sesión del rediseño del sitio —la línea más grande del gráfico anterior— resultó ser otra cosa por completo: una única sesión de bucle de arquitecto que corrió 107 horas seguidas (292 despertares programados), dividió el rediseño en issues de GitHub, los etiquetó para nuestro pipeline de CI y luego supervisó: consultando ejecuciones, revisando los pull requests del pipeline y abriendo issues de seguimiento a medida que QA sacaba bugs a la luz.
El tecleo ocurrió en un lugar que nuestro minado por sesión ni siquiera había mirado: una flota aparte de runners autoalojados, donde las etapas plan → implement → gap-evaluation → review del pipeline se ejecutaron como 252 sesiones independientes de Opus a lo largo de 4,5 días, tocando 48 issues y PRs distintos.
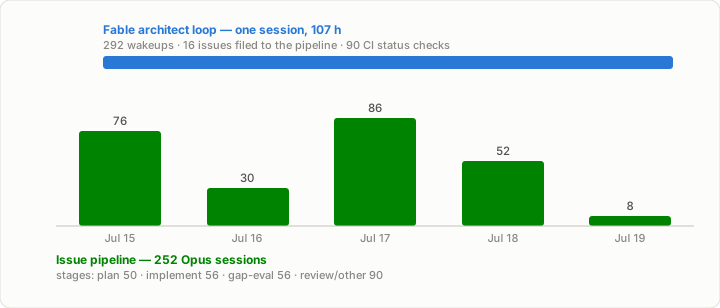
H1, revisitada — Confirmada a escala de proyecto. Cuenta ambos canales y la imagen se invierte: el pipeline tecleó 10× más tokens de salida que el bucle de arquitecto que lo despachó (9,07M frente a 877k), todo a tarifas de Opus. Ejecutar esa ola de implementación en el modelo del arquitecto habría costado 2,1× más: en un solo rediseño, en una sola semana, y antes de contar los subagentes dentro de sesión. Un issue no es más que un brief de grano más grueso: la misma interfaz, la misma economía, un nivel más arriba.
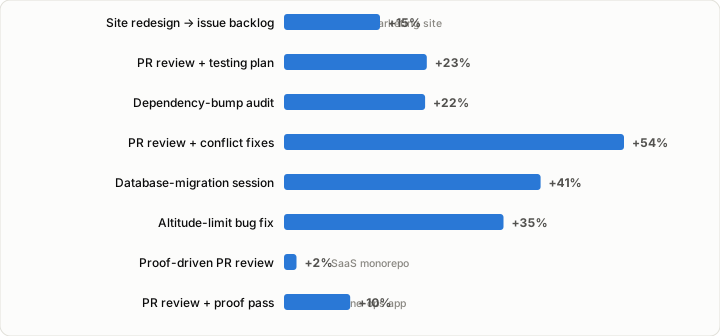
H2 — Confirmada, con un giro. Recalcular los volúmenes exactos de tokens de los implementadores a las tarifas del modelo arquitecto hace más cara cada sesión: de un +2% a un +54%, un 17% en las ocho principales. Dinero real, pero menos de lo que sugiere la brecha del 2× en el precio de salida. El giro: la salida no es adonde va el dinero. En la sesión más grande, las lecturas de caché del arquitecto costaron unas 13× más que todo lo que tecleó: el gasto dominante es el modelo caro manteniendo y releyendo un contexto de orquestación grande, no tecleando. Delegar pone techo a la factura de salida; la siguiente palanca es mantener ligero el contexto del arquitecto.
H3 — No medida aquí. La contabilidad de tokens no puede ver la calidad del código. Lo que sí podemos decir por observación: el bucle de revisión es portante —los informes y los diffs discrepan con la frecuencia suficiente para que leer ambos no sea negociable— y las correcciones devueltas a un agente con el contexto caliente convergen rápido. Si replicas esto y mides el retrabajo correctamente, queremos verlo, sobre todo si nos refuta.
Lo que nos enseñaron los datos más amplios
- La adopción es un gradiente, no un interruptor. En la app de operaciones con drones —más pequeña y de ritmo más rápido— el 18% de las sesiones usan el patrón fable-architect; en el monorepo SaaS más antiguo es el 9%. El proyecto que delegó con más fuerza lo hizo en los dos granos a la vez: briefs de implementador dentro de la sesión y 252 sesiones de pipeline despachadas por el gestor de incidencias.
- La flota de CI no ejecuta la skill porque es el implementador. Nuestras sesiones automatizadas de runner nunca generan un subagente implementador, y al principio eso se leía como falta de adopción. Los prompts dicen otra cosa: cada una es una etapa del pipeline —verify, review, gap-evaluation— y aproximadamente seis de cada diez trabajan contra un issue o PR concreto. A escala de proyecto, los runners del pipeline son el nivel implementador.
- El nivel más barato todavía no ha tenido su primer día de trabajo. Las 78+ ejecuciones de implementador fueron todas de clase Opus; el nivel de edición mecánica con Sonnet se añadió hace poco y aún no se ha invocado. Los ahorros que esto mida son un suelo.
La interfaz es lo importante: brief entra, diff sale; issue entra, PR sale. El día que llegue la subida de precios, cambias al albañil, no el proceso.
Divulgación completa. Modelos verificados a partir de las cadenas de los transcripts, no supuestos. Nos corregimos dos veces (un sobreconteo de tokens línea por línea y luego una tabla de precios provisional). El contrafactual asume que el arquitecto habría gastado los mismos volúmenes de tokens que los implementadores: las barras de error van en ambas direcciones. Las sesiones del pipeline viven en un almacén de transcripts que nuestras dos primeras pasadas de minado no incluyeron en el alcance; una frontera contable nos ocultó un canal de delegación de 9M tokens, y el tuyo probablemente tenga uno también. Son los proyectos de un solo ingeniero, en su mayoría trabajo de revisión y corrección y de funcionalidades: no es un benchmark controlado. El corpus además se cierra antes de que se lanzara Opus 5: todas las cifras de arriba son Fable como arquitecto sobre implementadores de clase Opus-4. Los precios de los peldaños no se movieron cuando llegó Opus 5, así que los ratios medidos se mantienen, pero mira la siguiente sección para ver qué sí se movió.
Actualización — la escalera se movió bajo nuestros pies
Opus 5 llegó después de que se cerraran estas mediciones, y nada en la escalera de precios cambió: Opus sigue a $5/$25 por millón de tokens de entrada/salida, Fable sigue a $10/$50, y el gráfico de arriba sigue siendo correcto. Lo que cambió es la capacidad en cada peldaño. Anthropic posiciona Opus 5 como un salto cualitativo en razonamiento profundo y trabajo agéntico de horizonte largo, es decir, exactamente en el trabajo del que está hecho el rol de arquitecto, a la mitad del precio del nivel de arquitecto.
Eso apunta directo a nuestro propio giro de H2. Si el coste dominante del arquitecto son las lecturas de caché, y las lecturas de caché se facturan al 10% del precio de entrada, entonces un arquitecto corriendo sobre Opus 5 relee su contexto de orquestación a $0,50 por millón de tokens en lugar de los $1,00 de Fable. La partida que costaba 13× todo lo que el arquitecto tecleó se reduce a la mitad. No hemos medido esto: es aritmética bajo el mismo supuesto de volúmenes de tokens iguales que señalamos para el contrafactual del 2,1×, y es lo siguiente que pensamos probar. Si se sostiene, la pregunta interesante deja de ser qué modelos y pasa a ser si el arquitecto necesita el peldaño superior.
Tres cosas del nuevo nivel de implementador cambian el patrón en sí, no solo su precio:
- Recurre a los subagentes con facilidad, al revés que su predecesor, al que había que convencer para que delegara algo. Un implementador que genera en silencio sus propios implementadores multiplica la factura sin que nadie mire. De ahí la línea
Delegation:en el brief: una porción ahora declara si puede ramificarse y con qué amplitud. - Verifica su propio trabajo sin que se lo pidan. Las instrucciones de verificación escritas para modelos más antiguos ahora compran una segunda pasada redundante, así que salen de los briefs. El bucle de revisión del arquitecto no se toca.
- Amplía el alcance.
Out of scope:deja de ser relleno y se convierte en la línea que mantiene una porción como porción.
Y el peldaño que nunca usamos se volvió más afilado mientras no mirábamos: Sonnet 5 llega cerca de la calidad de Opus en trabajo de programación a $3/$15, con precios introductorios por debajo de eso hasta finales de agosto. “Los ahorros que esto mida son un suelo” era una cautela cuando lo escribimos. Ahora suena a quedarse corto.
Parte 3 — Hacia dónde vamos a propósito
Nos estamos dirigiendo, a propósito, hacia una división en la que creemos que todo equipo de ingeniería acabará viéndose forzado: modelos frontera caros solo para lluvia de ideas, arquitectura y revisión; modelos cada vez más baratos para la programación en sí. Hoy nuestros implementadores son de clase Opus. Nada en el flujo de trabajo cambia cuando pasen a ser de clase Sonnet, de clase DeepSeek o de clase Kimi: la interfaz es agnóstica respecto al modelo por construcción. Ese es todo el valor estratégico: el día que acabe la subvención y la factura se duplique, los equipos con esta disciplina cambian una línea de configuración. Los equipos sin ella renegocian toda su estructura de costes bajo presión.
Fable-architect es un primer paso minúsculo: la adopción es parcial y el nivel más barato no ha tenido su primera ejecución. Pero es el paso que construye el músculo: escribir briefs que especifican por completo una porción, revisar diffs que no tecleaste, tratar la atención del modelo caro como un presupuesto. Y la ola del rediseño muestra adónde lleva ese músculo: cuando los briefs funcionan, los issues funcionan, y el modelo caro deja de asistir a la implementación por completo.
Qué puedes hacer el lunes
- Divide los roles en tu arnés de agentes. Una regla a nivel de sesión: el modelo frontera planifica y revisa; delega todas las ediciones de archivos a un agente implementador más barato. En Claude Code esto es una skill más definiciones de subagentes: una tarde de configuración.
- Haz que la frontera sea mecánica. Añade un hook previo a la edición que cuestione las escrituras de archivos del propio modelo caro. Una regla que no cuesta nada romper se romperá el viernes.
- Escribe briefs con una plantilla fija. Objetivo, contexto, archivos, diseño, restricciones, fuera de alcance, presupuesto de delegación, verificación. La plantilla es la disciplina, y el presupuesto de delegación es lo que impide que un implementador contrate en silencio a los suyos.
- Revisa tanto el informe como el diff. No te fíes nunca de uno solo; vuelve a ejecutar los comandos de verificación que importen.
- Mide tu propia división. Tus transcripts ya contienen los datos: agrupa por petición, valora por modelo y mira quién teclea de verdad. Los nuestros nos mostraron un nivel barato sin usar y un canal de delegación de 9M tokens que no conocíamos.
- Amplía la interfaz de briefs a issues. Un brief delega una hora de trabajo; un issue delega un día. Cuando tus issues lleven criterios de aceptación sobre los que un pipeline pueda actuar, el modelo caro podrá registrar trabajo en el gestor y supervisar en lugar de estar en el bucle de cada porción.
- Mantén una salida caliente. Ejecuta un modelo barato o abierto como implementador en una porción de bajo riesgo cada semana. La portabilidad que nunca ejercitas es portabilidad que no tienes.
- Recalcula el precio del arquitecto, no solo el del albañil. Cada lanzamiento de modelo mueve los peldaños sin mover la escalera. Si la mayor parte de tu gasto de arquitecto es contexto y no tecleo, un nivel de arquitecto más barato vale más que un nivel de implementador más barato: comprueba cuál de los dos dicen tus propios transcripts que estás comprando.
Los laboratorios seguirán diciéndonos que sus mejores modelos valen cualquier precio y, de forma exasperante, para el trabajo de criterio tienen razón en su mayoría. La jugada no es abstenernos. Es dejar de pagar precios frontera por bucles for.
