


Teknisen dokumentaation tekeminen vie kehittäjät pois itse rakentamistyöstä. Jokainen asennusoppaan kirjoittamiseen tai jokaisen rivin selittämiseen kirjoittajalle käytetty tunti on tunti, jota ei käytetä koodin toimitukseen – ja heti kun dokumentaatio julkaistaan, taustalla oleva järjestelmä jatkaa muuttumistaan ilman sitä.
Ratkaisu on tekoälypohjainen tekninen dokumentaatiokirjoittaja . Työkalu, joka lukee todellista lähdekoodiasi ja tuottaa siitä jäsennellyn ja tarkan asiakirjan minuuteissa päivien sijaan. Koska syötteenä on oikea koodisi eikä muistinvarainen sitä kuvaava kehote, tulos pysyy sidoksissa siihen, mitä järjestelmä todella tekee.
Tässä syyt siihen, miksi dokumentaatio vanhenee niin helposti , mitä nämä työkalut voivat todella tuottaa, miten sellaisen käyttöönotto tehdään vaihe vaiheelta ja miten tulosta käytetään API-viitteisiin, käyttöoppaisiin ja sisäisiin wikeihin ilman että julkaiset jotain virheellistä.
Miksi tekninen dokumentaatio on aina vanhentunutta
Dokumentaatio häviää prioriteettikilpailun lähes rakenteellisesti. Määräajat palkitsevat toimivan koodin, eivät sitä selittävän kappaleen, ja yhä elää uskomus, että siistin koodin pitäisi olla itsestään selittävää. Stack Overflown oma tutkimus osoitti, että dokumentaatio vie jo noin 11 % kehittäjien työtunneista, mutta silti tiimit laskevat sen prioriteettia ensimmäisenä, kun määräaika kiristyy.
Ohittamisen hinta ei katoa, se vain siirtyy eteenpäin. GetDX arvioi , että insinöörit käyttävät 3–10 tuntia viikossa etsiessään tietoa, joka pitäisi jo olla dokumentoitu, selaillen vanhoja pull requesteja ja kysellen siltä, joka sattuu muistamaan. Minkä tahansa kokoisessa tiimissä se on valtava määrä tunteja käytettynä tiedon jäljittämiseen – tietoa, jonka dokumentti olisi voinut säilyttää jo ensimmäisellä kerralla.
Tekniseen kirjoittamiseen tarkoitettu tekoäly muuttaa ongelman taloutta sen sijaan, että se yrittäisi korjata kehittäjien tapoja. Jos asiakirjan uudelleentuottaminen kestää minuutteja ja maksaa hyvin vähän, dokumentaation pitäminen tahdissa nopeasti muuttuvan koodikannan kanssa muuttuu realistiseksi toiveiden sijaan. Jäljelle jää vain se, että kehittäjä tai kirjoittaja oikolukee sen nopeasti ja varmistaa, että kaikki on mainittu ja kuvattu oikein.
Mitä tekoälypohjaiset dokumentaatiokirjoittajat voivat tuottaa
Tekoälypohjainen dokumentaatiogeneraattori ei rajoitu yhteen tulostusmuotoon. Riippuen siitä, mitä sille syötät ja kenelle kerrot sen olevan tarkoitettu, sama taustaprosessi voi tuottaa API-viitteitä, arkkitehtuurikatsauksia, perehdytysoppaita tai käyttöohjeita sisäiseen työkaluun.
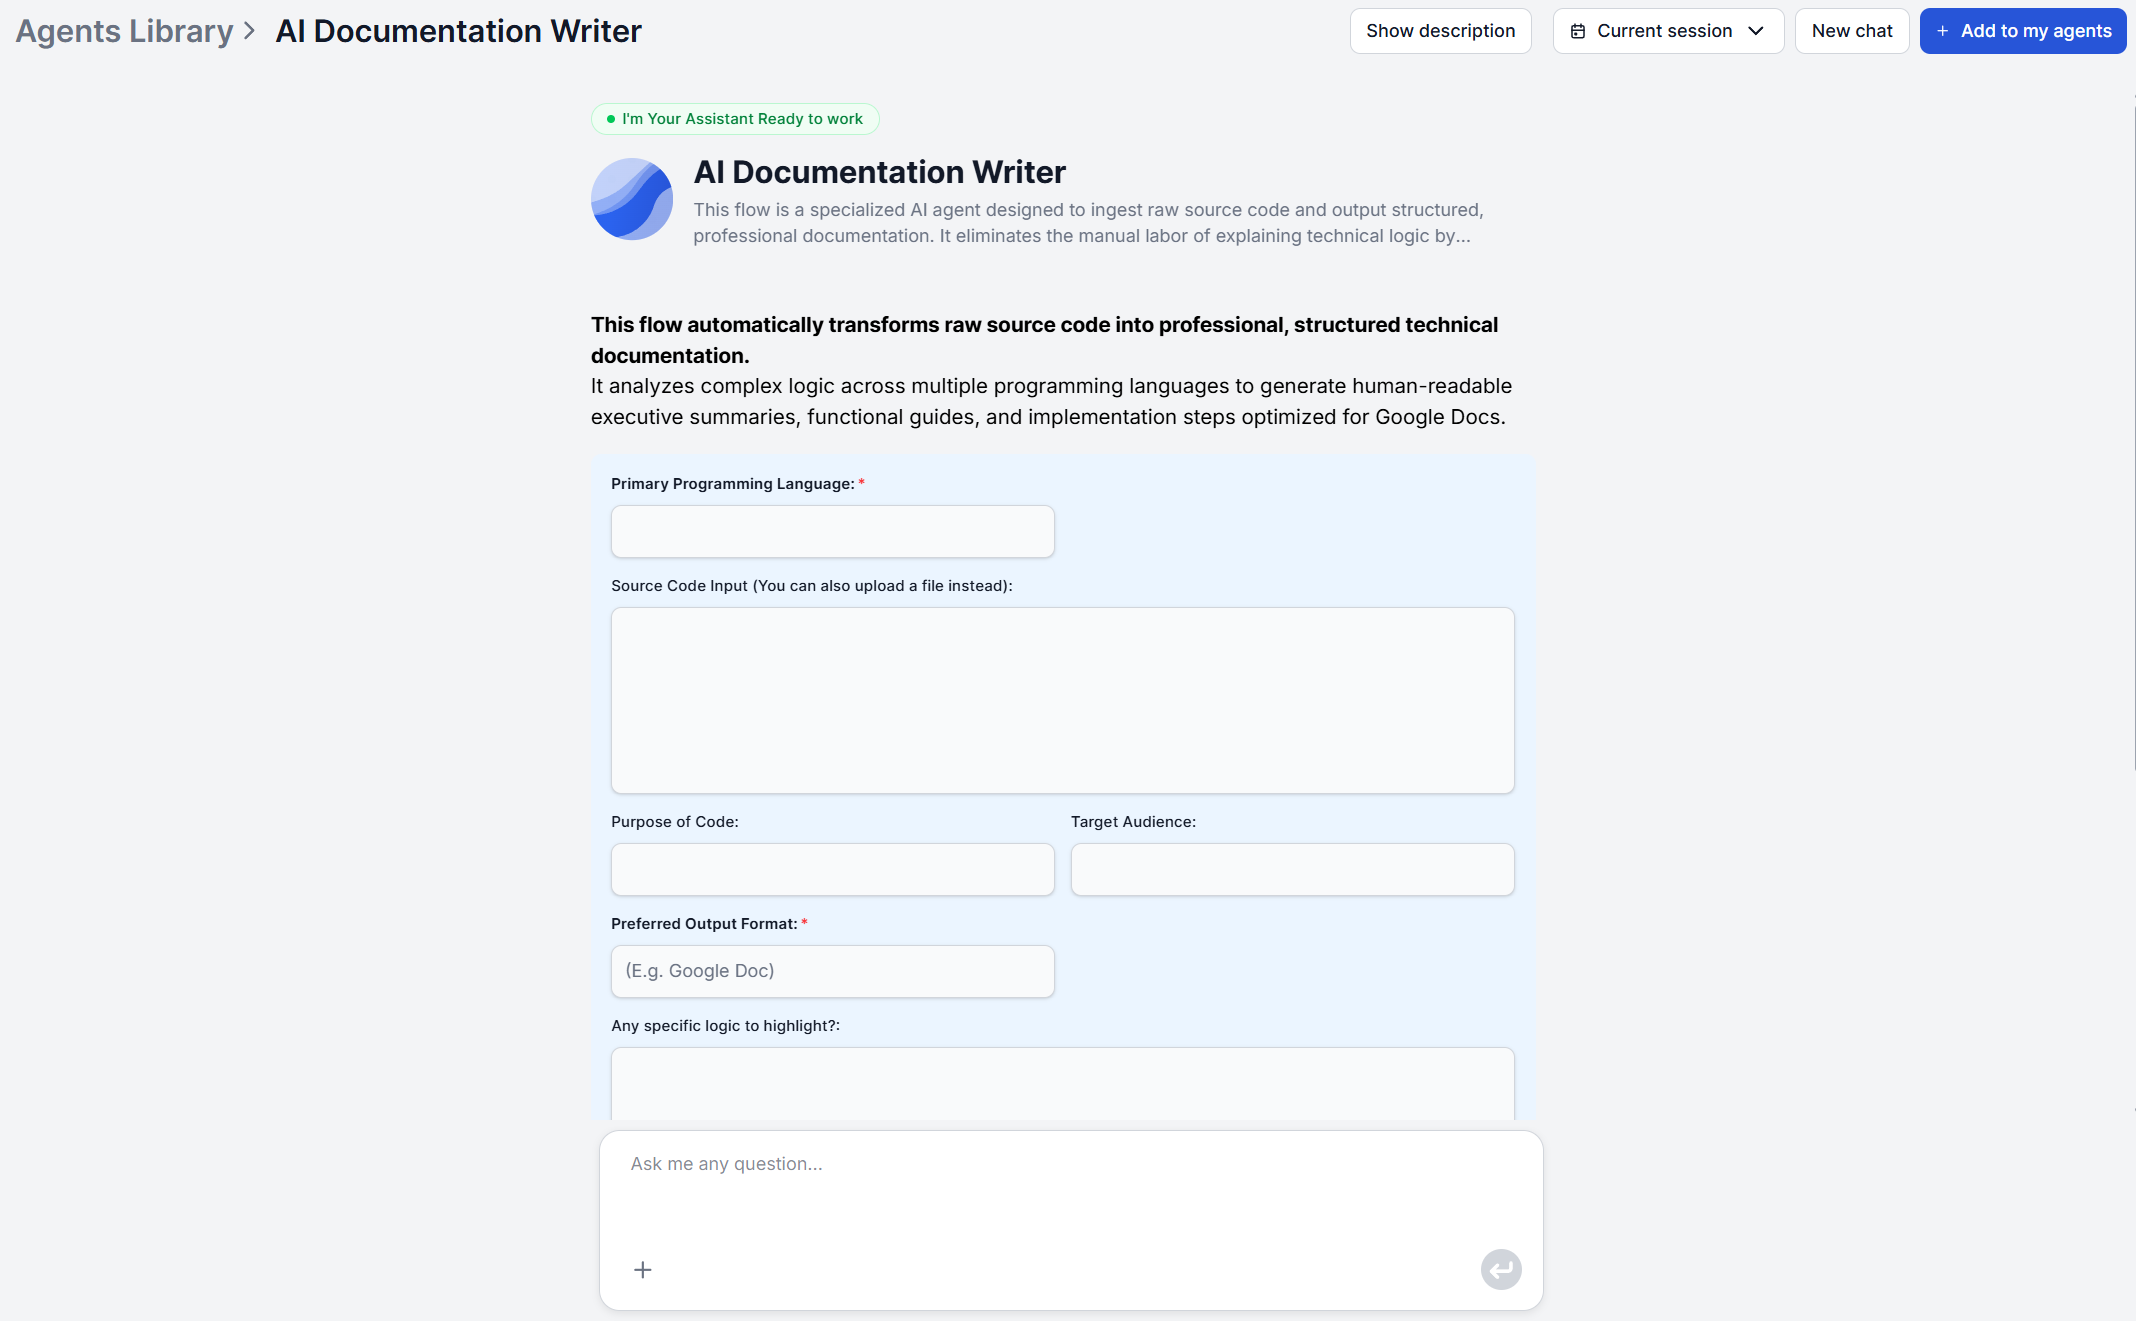
FlowHuntin tekoälypohjainen dokumentaatiokirjoittaja ottaa vastaan lähdekoodia ja kontekstia ja palauttaa jäsennellyn JSON-asiakirjan, joka kattaa:
- Tiivistelmä johdolle — lyhyt katsaus siihen, mitä ohjelmisto tekee ja mitä ongelmaa se ratkaisee.
- Toiminnalliset ominaisuudet — koodin mahdollistamat keskeiset ominaisuudet ja loppukäyttäjän kyvykkyydet.
- Tekninen arkkitehtuuri — käytetty teknologiapino, komponentit, kehykset, tietokannat ja API:t.
- Logiikan kulku ja prosessi — miten tieto liikkuu järjestelmässä ja miten keskeiset toiminnot tapahtuvat.
- Keskeiset funktiot ja komponentit — mitä kukin merkittävä funktio tai moduuli tekee ja mitä se palauttaa.
- Toteutus- ja käyttöohjeet — asennusta, määritystä tai käyttöä koskevat ohjeet kirjoitettuna mille tahansa määrittämällesi kohdeyleisölle.
Raa’an lähdekoodin jättäminen pois tulosteesta on oletusasetus, joten tuloksena on dokumentaatiota, jonka ihminen on kirjoittanut – ei koodilista, johon on liimattu kommentit. Samat kuusi osiota toimivat riippumatta siitä, tuotatko sisäistä wikisivua palvelulle, jota koskee vain kolme ihmistä, vai asiakkaalle toimitettavan projektin käsikirjaa, sillä näiden välinen ero on kohdeyleisösyötteessä, ei taustaprosessissa.

Valmis kasvattamaan liiketoimintaasi?
Aloita ilmainen kokeilujakso tänään ja näe tulokset muutamassa päivässä.
Vaihe vaiheelta: luo ensimmäinen tekninen asiakirjasi
Tekoälypohjaisen dokumentaatiokirjoittajan prosessi etenee neljän vaiheen kautta, ja niiden ymmärtäminen auttaa saamaan paremman tuloksen heti ensimmäisellä yrityksellä.
Vaihe 1: Anna koodisi ja konteksti. Liitä tai lataa lähdekoodisi ja määritä sitten muut lomakkeen kysymät syötetiedot, kuten kohdeyleisö (kehittäjät, asiakkaat tai ei-tekniset sidosryhmät) tai haluamasi tulostusmuoto.
Vaihe 2: Koodianalyysi. Työkalu tulkitsee antamasi koodin keskeisen toiminnallisuuden, tietovirran ja rakenteellisen logiikan, olipa kyseessä koko koodikanta tai osittainen katkelma.
Vaihe 3: Logiikan kääntäminen. Tekniset toiminnot muunnetaan selkokielisiksi selityksiksi, jotka on kalibroitu määrittämällesi yleisölle, joten sama koodi voi näyttää hyvin erilaiselta riippuen siitä, kenelle kerroit asiakirjan olevan tarkoitettu.
Vaihe 4: Asiakirjan jäsentely Selitykset järjestetään loogiseen hierarkiaan, joka kattaa miksi ja miten koodi toimii, ei vain mitä se tekee, ja ne toimitetaan valitsemassasi muodossa.
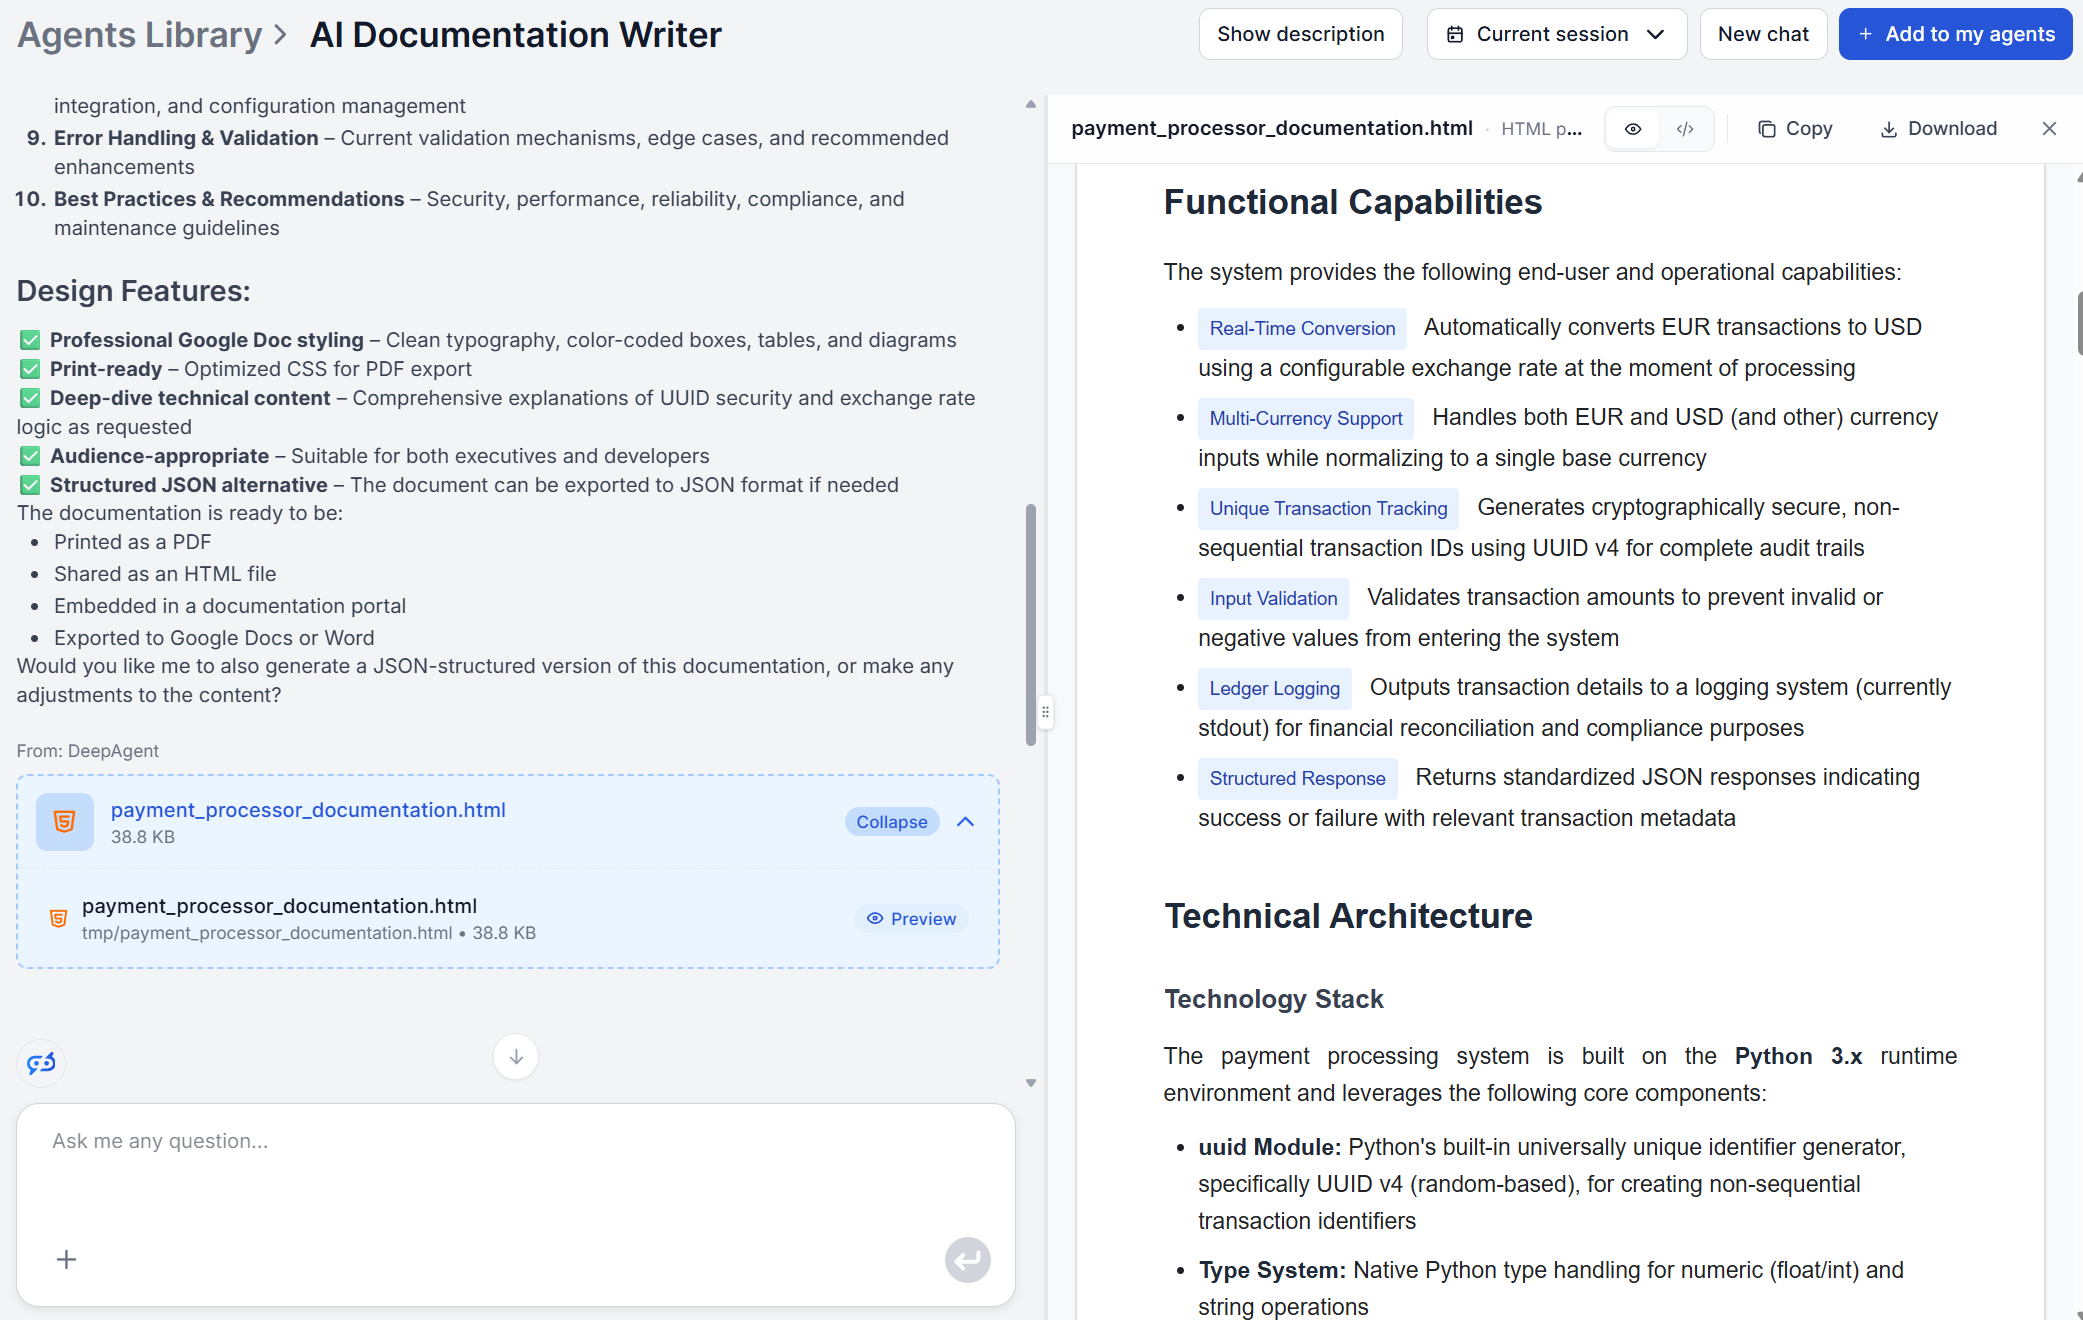
Jos koodisi tai kontekstisi on puutteellinen, työkalu päättelee todennäköisimmän tarkoituksen olemassa olevista tiedoista sen sijaan, että se pysähtyisi, joten myös sekava tai osittainen katkelma tuottaa jotain käyttökelpoista. Kokeile tekoälypohjaista dokumentaatiokirjoittajaa nähdäksesi tulostusmuodon omalla koodillasi.
Käyttötapaus: API-dokumentaatio koodista
API-viitteet sopivat luontevimmin tekoälypohjaiselle dokumentaatiokirjoittajalle, sillä työkalun koko prosessi lähtee lähdekoodista eikä kuvauksesta siitä, mitä koodin pitäisi tehdä. Kohdista se päätepisteiden käsittelijöihin tai SDK-metodeihin, aseta kohdeyleisöksi “kehittäjät” tai “API-kuluttajat”, niin tulosteen keskeisten funktioiden ja komponenttien osiosta tulee toimiva viite: mitä kukin funktio tekee, miten sen odotetaan käyttäytyvän ja miten se sopii laajempaan arkkitehtuuriin.
Tässä työkalu myös säästää eniten aikaa verrattuna manuaaliseen kirjoittamiseen, sillä API-dokumentaatio on tyypillisesti päivitettävä aina, kun parametri muuttuu tai päätepiste lisätään tai poistetaan käytöstä – juuri sellainen pieni ja toistuva muutos, jossa manuaalinen dokumentaatio jää helposti jälkeen.
Liity uutiskirjeellemme
Saa uusimmat vinkit, trendit ja tarjoukset ilmaiseksi.
Käyttötapaus: käyttäjille suunnatut tuoteoppaat
API-viitteen ja käyttöoppaan ero liittyy lähes kokonaan yleisöön, ei syötteeseen. Aja sama lähdekoodi dokumentaatiokirjoittajan läpi, mutta aseta kohdeyleisöksi “loppukäyttäjät” tai “ei-tekniset sidosryhmät”, niin logiikan kääntämisen vaihe tuottaa selkokielisiä selityksiä kehittäjille suunnatun terminologian sijaan.
Tämä toimii parhaiten ohjelmistodokumentaatiotehtävissä, joissa opas kuvaa CLI-työkalua, SDK:ta tai sisäistä sovellusta, jonka käyttöohjeet todella tulevat koodista itsestään, kuten käytettävissä olevat komennot, määritysvaihtoehdot tai asennusvaiheet.
Toteutus- ja käyttöohjeiden osio kirjoitetaan mille tahansa määrittämällesi yleisölle, joten sama koodikanta voi tukea sekä teknistä käsikirjaa että yksinkertaistettua opasta ilman, että kumpaakaan kirjoitetaan tyhjästä kahteen kertaan.
Tämä lähestymistapa ei sovellu dokumentaatioon, joka on puhtaasti käsitteellistä tai käytäntöihin perustuvaa, kuten tyyliopas tai tuen eskalaatiomatriisi, sillä työkalulla ei ole analysoitavaa koodia. Niissä tekoälypohjaista dokumentaatiokirjoittajaa kannattaa pitää yhtenä osana laajempaa dokumentaatiotyönkulkua eikä ainoana tarvitsemanasi työkaluna.
Käyttötapaus: sisäisten prosessien dokumentointi
Sisäisten prosessien dokumentaatio rapistuu yleensä nopeimmin, koska se on usein olemassa vain organisaation muistissa – vanhempi insinööri selittää ääneen käyttöönottoskriptiä tai perehdytysautomaatiota, eikä kukaan kirjoita sitä muistiin.
Jos selitys tapahtui nauhoitetussa kokouksessa, muunna se ensin jäsennellyiksi muistiinpanoiksi tekoälypohjaisella kokousraporttigeneraattorilla , jotta konteksti saadaan talteen ennen kuin se katoaa. Ota sen jälkeen skripti yhdessä koodin kanssa ja aja se dokumentaatiokirjoittajan läpi tuottaaksesi viitteen, joka säilyy, vaikka henkilö lähtisi yrityksestä.
Tämä käyttötapaus on tärkein insinööritiimeille, jotka perehdyttävät uusia jäseniä, joissa kysymys “miten käyttöönottoputkemme oikeasti toimii” ei saisi riippua siitä, että löydetään se yksi ihminen, joka muistaa.
Mitä tarkistaa ennen tekoälyn tuottaman dokumentaation julkaisemista
Tuotettu dokumentaatio on vahva ensimmäinen luonnos, ei valmis toimitettava. Muutama tarkistus kannattaa tehdä ennen kuin mitään julkaistaan:
- Varmista asennus- ja määritysvaiheet oikeassa ympäristössä. Käyttöohjeet on päätelty koodin logiikasta, joten varmista, että ne todella toimivat päästä päähän – erityisesti kaikki, mikä liittyy ympäristömuuttujiin, tunnistetietoihin tai ulkoisiin palveluihin.
- Vertaa tekninen arkkitehtuuri -osio todellisuuteen. Jos koodikannassa on perintökomponentteja, joita tekoäly ei voinut päätellä pelkän koodin perusteella, lisää se konteksti takaisin manuaalisesti.
- Vertaa olemassa olevaan dokumentaatioon. Jos aiempaa dokumentaatiota on jo olemassa PDF-muodossa, kuten vanha runbook, keskustelutyökalu PDF:n kanssa auttaa tarkistamaan nopeasti, jäikö tekoälyn tuottamasta versiosta jokin vaihe puuttumaan, ilman että koko asiakirjaa tarvitsee lukea uudelleen.
- Varmista, että yleisön kalibrointi onnistui. Aja uudelleen korjatulla kohdeyleisösyötteellä, jos “ei-tekninen” opas kuulostaa yhä API-viitteeltä.
- Tarkista asiakirjassa mainitut termit ja alan käytännöt. Jos haluat toisen lähteen tulosteessa mainitulle standardille tai käytännölle, tekoälypohjainen tutkimusavustaja voi hakea tukevia lähteitä saman istunnon aikana.
Yhteenveto
Mikään tästä ei vie niin kauan kuin asiakirjan kirjoittaminen tyhjästä, ja juuri se on koko pointti. Jäsennellyn luonnoksen tarkistaminen on pohjimmiltaan nopeampi tehtävä kuin tyhjään sivuun tuijottaminen, ja siinä on ero työkalun, joka säästää aikaa, ja sellaisen välillä, joka vain siirtää virheen riskin tilasta “kirjoittamaton” tilaan “itsevarmasti väärä”.