


La version courte
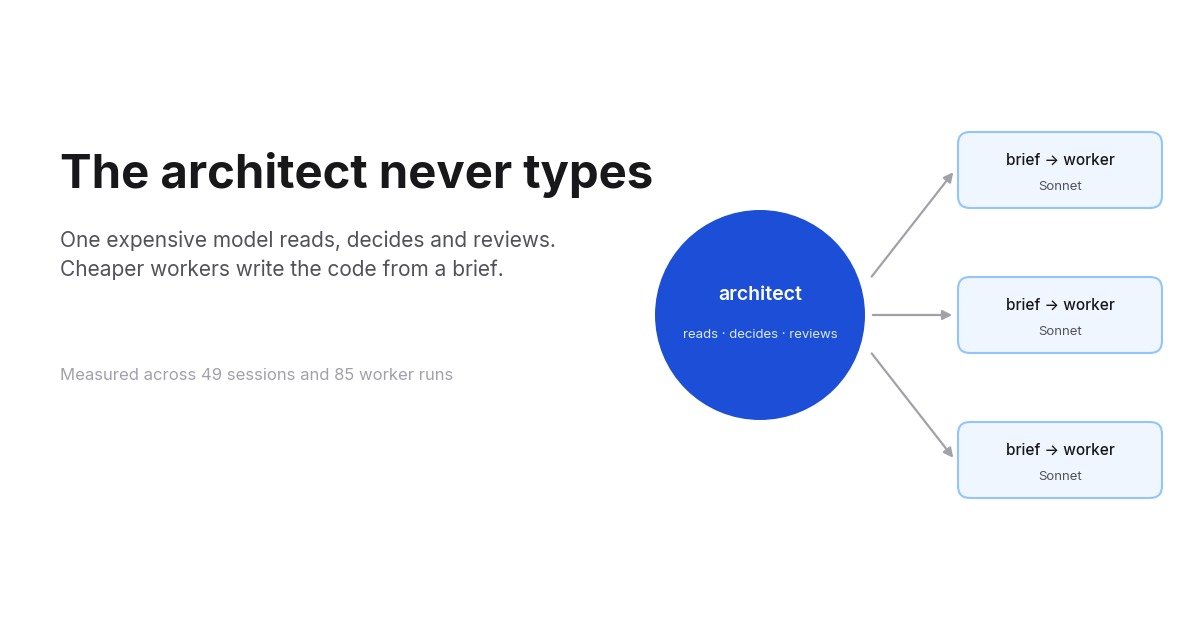
- Pendant cinq semaines, j’ai fait tourner mon agent de codage en mode scindé : le modèle principal, Opus puis Fable, lit, décide et relit, et un agent exécutant écrit le code à partir d’un brief rédigé. Je l’appelle le pattern architecte et c’est désormais une skill publique : architect-skill sur GitHub , sous licence MIT.
- Le modèle principal a arrêté de taper. Sur 49 sessions d’architecte, il a modifié un fichier source 6 fois en 1 467 prompts. Sur 275 sessions ordinaires durant les mêmes semaines, il a modifié 244 fichiers en 3 081 prompts. Soit 0,4 contre 7,9 pour 100 prompts.
- Le total de tokens par prompt n’a pas baissé. Il a augmenté, fortement, pendant deux semaines, puis est revenu au niveau des sessions ordinaires. Ce qui a changé, c’est qui les dépense : la part d’Opus dans les tokens des exécutants est passée de 100 % à environ 4 %, et depuis le 14 septembre, un prompt d’une session d’architecte coûte 364 k tokens pondérés sur le modèle principal, 205 k sur les exécutants Sonnet et 80 k sur les exécutants Opus.
- C’est cette répartition qui intéresse un abonnement. Claude Max facture sa limite hebdomadaire tous modèles au tarif de chaque modèle, donc un token Sonnet la consomme à 40 % d’un token Opus, et Fable dispose de sa propre limite hebdomadaire, distincte et plus serrée, que nul exécutant ne touche.
- J’ai aussi essayé de router les exécutants vers DeepSeek via un Claude Code sans interface. Au tarif catalogue, le même trafic coûtait 10 $ au lieu de 202 $ sur Sonnet ou 505 $ sur Opus. Avec un abonnement, cette économie n’existe pas, puisque l’abonnement est déjà payé. J’ai abandonné. Si vous payez au token, lisez quand même cette section, parce que les chiffres sont tout l’intérêt.
C’est le troisième article d’une série. Le premier mesurait l’effet d’un réglage sur une fenêtre de contexte, 17 % de tokens en moins , et le deuxième explique ce que coûte une fenêtre de contexte et pourquoi. Celui-ci porte sur l’autre levier : non pas la taille du contexte, mais le modèle qui le tient.
En quoi consiste le pattern
Une session d’agent de codage fait deux types de travail. Elle réfléchit : elle lit le dépôt, détermine quoi changer, décide des noms, des signatures et des cas limites, vérifie le diff. Et elle tape : elle écrit le code, lance le fichier de test, corrige le lint. La réflexion est ce qui justifie le prix d’un modèle de pointe. Le fait de taper, non. L’essentiel en est déterminé par la décision qui précède, et un modèle plus petit exécute un plan décidé à peu près aussi bien qu’un grand.
La skill scinde donc la session. Le modèle principal est l’architecte. Il fait tout dans la boucle principale, sauf modifier un fichier source :
- Interroger le besoin et explorer le dépôt.
- Prendre les décisions de conception : approche, flux de données, noms, signatures, cas limites. Le pattern existant le plus proche à imiter. Le plus petit changement qui corrige la cause racine.
- Décomposer en tranches propriétaires d’ensembles de fichiers disjoints.
- Rédiger un brief d’implémentation par tranche.
- Relire le diff qui revient, lancer les vérifications finales, committer.
L’exécutant est un sous-agent doté d’une fenêtre de contexte neuve. Il reçoit le brief et rien d’autre, écrit le code, lance les fichiers de test nommés dans le brief et renvoie un court rapport structuré. Puis son contexte est jeté. Il ne fait jamais partie de l’historique de la session principale, ce qui compte plus qu’on ne le croit : tout ce que lit la session principale est renvoyé à chaque appel suivant, donc un exécutant qui lit douze fichiers et un journal de test dans son propre contexte garde tout cela hors de la facture de l’architecte.
Le brief est tout le contrat. Le mien a sept champs, et la skill consiste surtout à bien les remplir :
## Brief d'implémentation : <tranche>
Objectif : une phrase, un résultat observable
Contexte : ce que l'exploration a trouvé : extraits, le pattern à imiter, ancrages de lignes, pièges
Fichiers : chemins à créer/modifier, propriété exclusive pour cette tranche
Conception : l'approche décidée : flux de données, noms, signatures, cas limites
Contraintes : règles du projet applicables : style, couches, sécurité
Hors périmètre : ce qu'il ne faut pas toucher, y compris les fichiers possédés par d'autres tranches
Vérification : commandes exactes et résultat attendu
Un brief contient des décisions, pas des options. Si je pèse encore deux approches, je ne suis pas prêt à déléguer.
Il y a une exception. La délégation a un coût fixe : rédiger le brief, démarrer l’exécutant, lire le rapport, relire le diff. Une faute de frappe, une valeur de configuration, une montée de version, la suppression d’une clé morte, une correction d’une ligne et son test de non-régression : pour cela, l’architecte édite directement, parce que le brief coûterait plus cher que l’édition. Le critère est le coût, pas le nombre de lignes. Dès que l’édition exige un jugement de conception ou touche un chemin que le dépôt signale comme critique, elle part chez un exécutant.

Prêt à développer votre entreprise?
Commencez votre essai gratuit aujourd'hui et voyez les résultats en quelques jours.
Pourquoi un abonnement change l’arithmétique
Si vous payez au token, le raisonnement est simple. Opus 5 est listé à 5 $ par million de tokens d’entrée et 25 $ par million en sortie ; Sonnet 5 à 2 $ et 10 $. Chaque token d’implémentation qui passe d’Opus à Sonnet coûte 40 % de ce qu’il coûtait.
Je paie un abonnement, et là le raisonnement est différent et, je pense, plus fort. Claude Max a deux limites hebdomadaires, pas une : une limite tous modèles confondus, consommée par chaque token au tarif de son modèle, et une limite distincte et plus serrée que seul Fable consomme. Opus n’a pas de limite propre. La scission produit donc deux effets. Le travail d’un exécutant Sonnet consomme la limite partagée à 40 % du tarif qu’aurait un exécutant Opus, donc déplacer deux tiers des tokens d’une session vers Sonnet fait durer la semaine plus longtemps, même si le nombre total de tokens ne change pas. Et quand l’architecte est Fable, chaque token qu’il ne dépense pas à taper est un token laissé sur la limite qui s’épuise en premier. Ainsi, même si le pattern architecte dépensait exactement le même nombre de tokens qu’une session ordinaire, l’identité de celui qui les dépense déciderait encore de la fin de la semaine.
Ce « même si » s’est avéré porter beaucoup de poids.
Ce que disent les transcriptions
Claude Code écrit chaque session dans une transcription JSONL, et chaque exécution d’exécutant dans un fichier frère sous le répertoire de la session. Je les ai toutes depuis le 19 août : 324 sessions interactives avec trois prompts ou plus, dont 49 utilisaient le pattern, c’est-à-dire ont lancé un agent implémenteur ou lui ont envoyé un brief. Les tokens sont pondérés comme la facture : entrée fraîche à 1, écritures de cache à 1,25 ou 2, lectures de cache à 0,1. Les exécutions CI sont exclues.
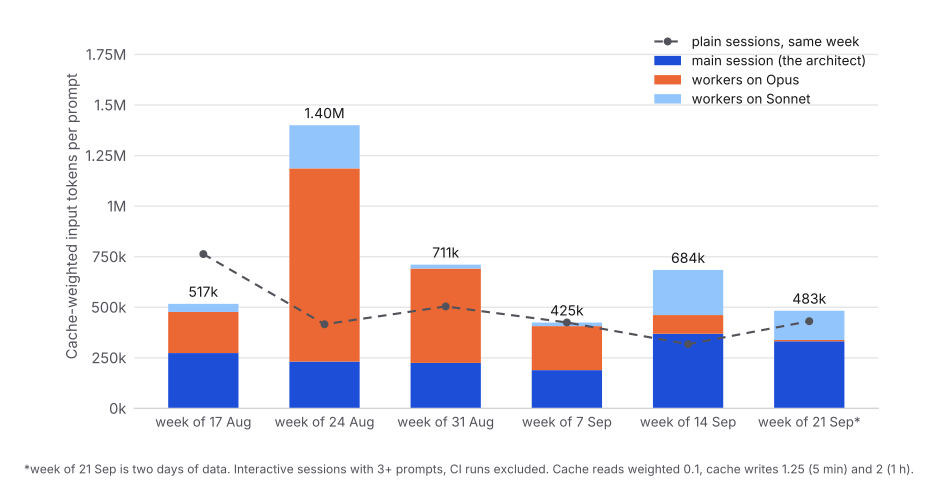
Lisez de gauche à droite : ce n’est pas une réussite pour les deux premières semaines.
Dans la semaine du 24 août, une session d’architecte coûtait 1,40 M de tokens pondérés par prompt. Les sessions ordinaires de la même semaine coûtaient 0,42 M. Trois fois et demie plus, et presque tout l’excédent était orange : les exécutants Opus. J’avais donné aux exécutants un bon modèle et aucune règle, et ils se sont comportés comme un bon modèle sans règles. La médiane des exécutions d’exécutants Opus cette semaine-là était de 176 tours. Plusieurs ont lancé la suite de tests backend complète, ce qui met environ 100 Ko de sortie dans un contexte renvoyé à chaque tour suivant. Une session à six exécutants le 14 septembre, après que j’avais déjà commencé à resserrer les choses, a encore brûlé 245 M de tokens d’entrée sur 1 585 tours pour produire environ six mille lignes de diff. Le cache de prompt fonctionnait à un taux de succès de 91,6 % tout du long. La facture venait du volume, pas du prix.
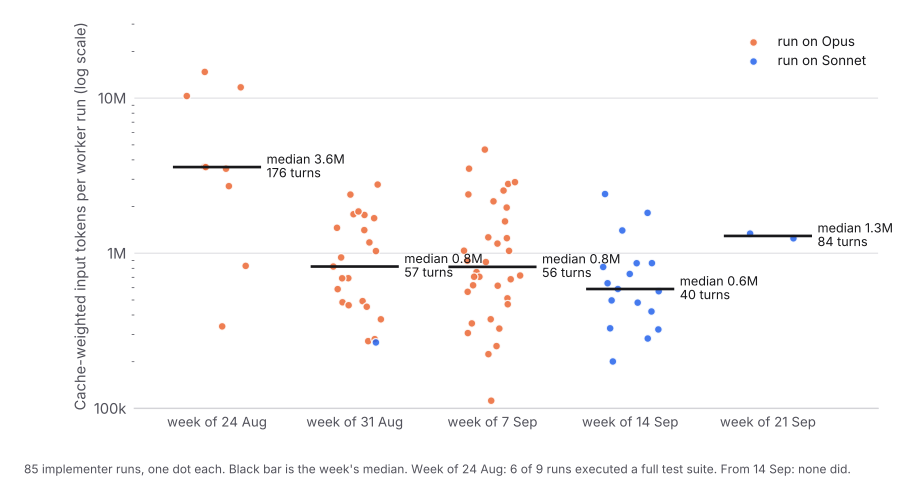
La bande des exécutants montre où les règles ont atterri. Trois d’entre elles ont fait l’essentiel du travail, et je les ai écrites dans les définitions d’agents plutôt que dans le brief, pour qu’elles s’appliquent que je m’en souvienne ou non :
- Un exécutant ne lance jamais une suite de tests complète. Il lance les fichiers de test nommés dans son brief. L’architecte lance les vérifications finales.
maxTurnsest plafonné dans la définition de l’agent, 140 pour Sonnet et 160 pour Opus. Une tranche qui a besoin de 250 tours a été mal briefée.- Une tranche reste sous une douzaine de fichiers environ, et le brief sous environ 8 Ko. Le brief est lui aussi renvoyé à chaque tour.
Dans la semaine du 31 août, la médiane des exécutions d’exécutants était de 57 tours et 0,8 M de tokens pondérés. À partir du 14 septembre, quand j’ai basculé la route par défaut vers Sonnet, elle était de 40 tours et 0,6 M, et aucun exécutant n’a relancé de suite complète depuis.
Le total par prompt a suivi : 711 k, 425 k, 684 k, 483 k sur les quatre dernières semaines, contre 505 k, 425 k, 318 k, 431 k pour les sessions ordinaires. Les sessions d’architecte coûtent désormais à peu près ce que coûtent les sessions ordinaires. Un peu plus lors de deux des quatre semaines, un peu moins lors d’une seule. Ce qu’elles achètent en échange, ce sont les deux graphiques suivants.
Rejoignez notre newsletter
Recevez gratuitement les derniers conseils, tendances et offres.
Le modèle principal a arrêté de taper
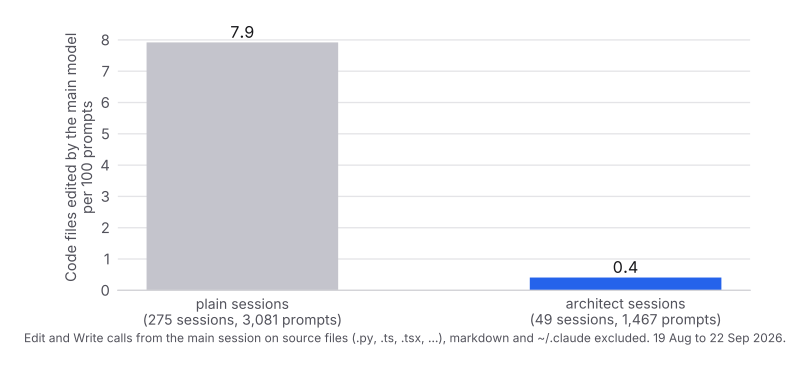
C’est le chiffre que je voulais changer, et il a changé. Dans les sessions ordinaires, le modèle principal a effectué 244 appels Edit ou Write sur des fichiers source sur 3 081 prompts. Dans les sessions d’architecte, il en a effectué 6 sur 1 467. Ces 6 sont toutes des exceptions de petites éditions que je peux justifier.
Pendant ce temps, les exécutants étaient productifs. Les 85 exécutions d’exécutants ont produit 2 510 éditions de fichiers source. En comptant la boucle principale et les exécutants ensemble, une session d’architecte a produit 2 516 éditions de code à partir de 1 467 prompts ; les sessions ordinaires en ont produit 943 à partir de 3 081. Par édition de code, une session d’architecte a dépensé 403 k tokens pondérés au total et 330 k sur le modèle de la famille Opus. Une session ordinaire a dépensé 1 410 k et 1 324 k. Je veux rester prudent avec cette comparaison, car les deux populations ne font pas le même travail : une session est classée comme architecte parce qu’elle délègue du code, donc les sessions d’architecte sont lourdes en codage par construction, tandis que les sessions ordinaires incluent de la recherche, des revues et du débogage qui ne modifient jamais rien. Lisez cela comme « le pattern fait écrire beaucoup de code par token », pas comme une prétention à quatre fois plus d’efficacité.
L’affirmation la plus propre est celle de la répartition entre modèles. Depuis le 14 septembre, un prompt d’une session d’architecte coûte 364 k tokens pondérés dans la boucle principale, 205 k dans les exécutants Sonnet et 80 k dans les exécutants Opus. La part des exécutants Opus dans l’ensemble des tokens des exécutants était de 100 % en août et d’environ 4 % dans la semaine du 21 septembre. Sur un forfait Max, cela signifie que la limite hebdomadaire partagée est consommée au tarif de Sonnet plutôt qu’à celui d’Opus pour presque tout le travail d’implémentation, et que rien n’y touche la limite Fable.
Deux choses ne se sont pas améliorées, et je préfère le dire plutôt que de laisser les graphiques suggérer le contraire. Le contexte de la session principale n’a pas rétréci : les sessions d’architecte ont compacté 8,7 fois pour 100 prompts, contre 4,7 pour les sessions ordinaires, parce que l’architecte lit beaucoup avant de briefer. Et le pattern est plus lent en temps réel sur les petites tâches, car le démarrage et le rapport d’un exécutant représentent des minutes que vous ne payez pas quand vous faites simplement l’édition. L’exception des petites éditions existe parce que la première version de la skill n’en avait pas, et je me suis vu rédiger un brief de 3 Ko pour un changement de deux lignes.
Le détour par DeepSeek
Une fois les exécutants passés à Sonnet, la question suivante était évidente : devaient-ils être un modèle Claude ? Du 13 au 18 septembre, j’ai pointé l’exécutant vers DeepSeek V4.1 Flash via un Claude Code sans interface avec ANTHROPIC_BASE_URL réglé sur un endpoint compatible, d’abord via OpenRouter puis en natif. Même format de brief, même format de rapport, même architecte. 2 732 appels, 431 M de tokens d’entrée dont 88 % de lectures de cache, 1,7 M de tokens de sortie.
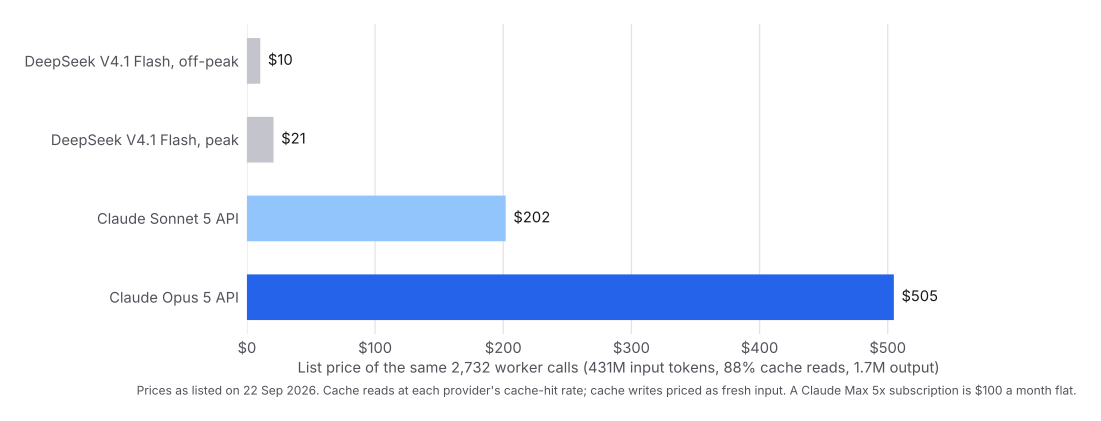
Aux prix catalogue du 22 septembre, ce trafic coûte environ 10 $ sur DeepSeek hors pointe, 21 $ en pointe, 202 $ sur l’API Sonnet et 505 $ sur l’API Opus. Si je payais au token, ce serait le titre de l’article et j’aurais gardé DeepSeek.
Je ne paie pas au token, et c’est tout l’argument. Un abonnement Max coûte 100 $ par mois, que j’utilise 30 % de la limite hebdomadaire ou 100 %. Déplacer le trafic des exécutants vers DeepSeek n’a pas réduit cette facture d’un centime. Cela y a ajouté une seconde facture de 10 $ à 21 $ par semaine, pour économiser de la capacité sur un forfait dont j’avais déjà payé la capacité. J’avais confondu « moins cher que l’API » et « moins cher que ce que je paie », et ce n’est pas la même chose quand ce que vous payez est forfaitaire. La bonne comparaison pour un abonné, c’est DeepSeek face à un second abonnement, et là, un second forfait Claude ou un forfait ChatGPT avec Codex coûte à peu près ce qu’un mois d’usage modéré de DeepSeek coûte, et vient avec sa propre limite hebdomadaire, son propre modèle et aucune consommation à surveiller.
La qualité était l’autre moitié. Cinq tranches backend sont revenues propres et ont été committées telles quelles. Une tranche frontend a supprimé un symbole exporté et laissé tous ses consommateurs intacts, si bien que l’arbre ne compilait plus et qu’une tranche ultérieure a dû nettoyer. C’est exactement l’échec que connaît un modèle qui exécute une spécification et que ne connaît pas un modèle qui déduit la forme d’un composant à partir de ses voisins, et la skill le dit désormais : les changements de surface d’API partagée vont à Sonnet, et la règle pour les exécutants se lit « ne jamais supprimer ni renommer un symbole exporté sans migrer tous ses consommateurs dans la même exécution ». DeepSeek Flash est un bon exécutant. Le pattern architecte a besoin d’un exécutant qui remarque quand le brief a sous-estimé les consommateurs, et c’est la seule chose qu’un brief ne peut pas fournir.
La table de routage actuelle comporte donc deux lignes. Le travail mécanique, le travail backend à partir d’un brief détaillé avec des tests à satisfaire, le travail frontend qui suit une grammaire de design existante, et tout changement de surface d’API partagée vont à sonnet-implementer. Le travail dont la difficulté réside dans le raisonnement va à opus-implementer : une course asynchrone, une refactorisation multi-sites dont la justesse dépend de sites que le brief ne peut pas énumérer, une migration de rattrapage qu’aucun test unique ne prouve. Routez selon la forme, jamais selon le risque. Le risque change la rigueur avec laquelle le diff est relu et si un humain le signe. Il ne change jamais qui l’écrit.
La boucle de revue, où le pattern gagne ou perd sa place
Le rapport d’un exécutant est une affirmation. La boucle de revue de la skill est courte et chaque ligne vient d’une mauvaise expérience :
- Lisez le rapport et le vrai
git diff. Recoupez le résumé de diff cité par l’exécutant avec celui que vous voyez. - Relancez vous-même la vérification clé quand l’affirmation compte.
- Un problème trouvé ? Envoyez la correction au même exécutant. Il a encore son contexte et reprend là où il s’est arrêté. Ne corrigez pas à la main, ne relancez pas un nouvel exécutant.
- Deux corrections échouées signifient que le brief était sous-spécifié, pas que le modèle est trop petit. Décomposez, mettez l’extrait manquant dans Contexte, relancez. Ne montez pas vers un modèle plus gros, car il implémentera le même malentendu avec plus d’aisance.
- Lancez les vérifications ciblées avant d’accepter quoi que ce soit : les tests touchés, le linter sur les fichiers touchés, tout script de convention que porte le dépôt.
Dans les transcriptions, j’ai envoyé environ une correction par exécution d’exécutant, 52 sur 85, et 7 exécutions Opus ont atteint leur plafond de 160 tours, toutes sur une tranche que je découperais aujourd’hui. Ce sont les deux chiffres que je surveille. Si les corrections par exécution augmentent, mes briefs deviennent paresseux. Si les exécutants atteignent le plafond, mes tranches sont trop grosses.
Ce qu’il faut en retenir
Si vous payez au token : mettez le modèle coûteux sur les décisions et la revue, un modèle bon marché sur l’implémentation, et chiffrez votre trafic d’exécutants au tarif catalogue avant de choisir lequel est bon marché. Le graphique à quatre barres est l’argument.
Si vous payez un abonnement : le pattern ne réduit pas votre nombre de tokens. Il déplace les tokens d’implémentation vers le modèle qui consomme la limite hebdomadaire partagée le plus lentement, réserve la limite Fable au travail que seul Fable devrait faire, et empêche votre modèle le plus coûteux de dépenser ses tours à taper. N’ajoutez pas une API facturée au token à côté pour « économiser » une capacité que vous avez déjà achetée. Si vous manquez de capacité pour les exécutants, achetez un second abonnement.
Dans les deux cas, les règles qui ont fait fonctionner le tout étaient les plus ennuyeuses. Pas de suite de tests complète chez un exécutant. Plafonner les tours. Petites tranches, briefs courts. Corriger une fois le même exécutant, puis corriger le brief.
La skill, les trois définitions d’agents et le hook de garde sont sur github.com/LivinTribunal/architect-skill sous licence MIT. La skill complémentaire qui indique à l’exécutant comment écrire du code qui correspond au dépôt où il atterrit est grain-skill , et l’article qui lui est consacré est du code dans le fil du dépôt .
Méthode
Tout ce que décrit l’article est dans github.com/LivinTribunal/architect-skill : la skill elle-même, le modèle de brief, la table de routage, les trois définitions d’agents implémenteurs avec leurs plafonds de tours et leurs règles de contexte, et le hook de garde. Installez-le et vous avez la configuration dont proviennent les chiffres ci-dessous.
Les sessions sont des transcriptions JSONL de Claude Code du 19 août au 22 septembre 2026, entrypoint cli, trois prompts utilisateur ou plus. Une session est classée comme architecte si elle a lancé opus-implementer, opus-implementer-xhigh ou sonnet-implementer, exécuté un exécutant ds-slice, invoqué la skill architecte, ou envoyé un message contenant un brief d’implémentation à un agent polyvalent, ce qui correspond au fonctionnement des premières semaines avant que les agents nommés n’existent. Les exécutions d’exécutants sont les transcriptions de sous-agents sous le répertoire de chaque session. L’usage est dédupliqué par identifiant de requête et pondéré ainsi : entrée fraîche 1, écriture de cache de cinq minutes 1,25, écriture de cache d’une heure 2, lecture de cache 0,1. Une « édition de code » est un appel Edit ou Write sur un fichier source .py, .ts, .tsx, .js, .sql ou similaire, à l’exclusion du markdown et de tout ce qui se trouve sous ~/.claude. Les prix DeepSeek sont les prix catalogue natifs du 22 septembre 2026, hors pointe et en pointe, avec les lectures de cache au taux de succès du cache et les écritures de cache facturées comme de l’entrée fraîche ; les prix de l’API Claude sont les prix catalogue publiés d’Opus 5 et de Sonnet 5, avec les lectures de cache à un dixième de l’entrée. La semaine du 21 septembre représente deux jours de données.
