


La version courte
- J’ai pris un vrai ticket du backlog de FlowHunt et j’ai fait implémenter par Claude Code 13 fois sous Opus 5.5, avec sept configurations d’instructions différentes. Chaque exécution partait du même commit, dans son propre clone avec sa propre base de données, et passait par notre vraie CI GitHub. Deux revues à l’aveugle par Opus ont noté chaque résultat.
- Le CLAUDE.md de 33 Ko du dépôt n’a apporté aucune qualité mesurable. Les exécutions avec lui ont obtenu 2,0 remarques bloquantes et majeures par revue. Une exécution sans aucun fichier d’instructions a obtenu le même résultat. Un fichier de 5,5 Ko a obtenu 1,0.
- Une étape de planification séparée a aggravé les choses. Les deux configurations qui exécutaient un prompt de planification puis un prompt d’implémentation ont coûté plus cher que leurs jumelles à prompt simple, et elles ont produit quatre des cinq blocages de l’ensemble des 26 revues.
- Le gagnant était un CLAUDE.md de 8 Ko, trois compétences, des exécutants Sonnet et un prompt simple. Ses deux exécutions ont coûté en moyenne 6,68 $ au prix catalogue de l’API. La configuration complète avec les prompts de pipeline coûtait en moyenne 11,49 $, soit environ 1,7 fois plus, et elle avait plus de remarques.
- Ce qui a survécu de toute la structure que j’avais construite, c’est le brief : une description courte et décidée d’une tranche de travail que le modèle principal écrit pour un exécutant moins cher. Les plans destinés au modèle principal lui-même n’ont pas été rentables. Le modèle planifie très bien tout seul.
Cet article fait suite au billet sur le motif architecte , qui mesurait qui devait taper le code. Celui-ci demande combien il faut dire au modèle principal avant qu’il commence.
Pourquoi je l’ai fait
Notre monorepo avait accumulé beaucoup d’instructions pour agents. Le CLAUDE.md racine faisait 33 Ko : commandes de build, cadence des tests, style de code, architecture, chemins critiques, règles de sécurité, règles de permissions et de crédits, les deux surfaces d’agents, la création de tickets, les conventions de PR. Dix compétences se trouvaient sous .claude/skills/. En plus de cela, notre pipeline de CI (nous l’appelons harnext) faisait passer un ticket par un tagger, une étape de triage, une étape de planification qui écrivait un plan sous forme de commentaire de ticket, et une étape d’implémentation qui relisait le plan et écrivait le code, chacune avec son propre long prompt système.
Chaque ligne avait été ajoutée pour une raison, généralement après qu’un agent s’était trompé. La question que personne n’avait posée était de savoir si cela aidait encore. Un CLAUDE.md est chargé dans chaque session et renvoyé à chaque tour. Si le modèle aurait de toute façon fait la bonne chose, ces tokens sont une taxe, et comme l’explique ce que coûte une fenêtre de contexte , une taxe à chaque tour s’accumule plus vite qu’il n’y paraît.

Prêt à développer votre entreprise?
Commencez votre essai gratuit aujourd'hui et voyez les résultats en quelques jours.
Le test
Le ticket était une séquence d’e-mails programmée pour les nouvelles inscriptions : un administrateur définit des étapes comme « jour 0 : bienvenue » et « jour 5 : votre essai se termine bientôt », et une tâche de fond envoie un e-mail à chaque compte le bon jour, s’arrête dès que la personne achète un forfait payant et ignore les comptes créés avant le lancement. Cela nécessite une migration, un dépôt, un service, une tâche Celery beat, des endpoints REST, des outils MCP pour les agents et une interface console en 11 langues. C’est une fonctionnalité réaliste de première semaine, et elle comporte plusieurs cas limites faciles à manquer.
Chaque exécution était une session Claude Code sans interface graphique sous Opus 5.5, isolée dans son propre clone et sa propre base de données, avec un script qui poussait son commit vers une PR en brouillon et renvoyait le résultat de la CI dans la session, jusqu’à trois tours. Le coût correspond au total_cost_usd de Claude Code pour la session principale plus chaque sous-agent, au prix catalogue de l’API. Je paie un abonnement, donc c’est une mesure du travail, pas de ma facture.
Les sept configurations :
| Configuration | Exécutions | |
|---|---|---|
| A | CLAUDE.md complet de 33 Ko et dix compétences, prompts de pipeline (planifier, puis implémenter) | 2 |
| B | CLAUDE.md complet et compétences, prompt simple | 3 |
| C | Aucun CLAUDE.md, aucune compétence, prompt simple | 2 |
| D | CLAUDE.md complet plus la compétence architect, prompt simple | 2 |
| E | CLAUDE.md de 8 Ko, architect, grain-ponytail et unslop, prompts de pipeline | 1 |
| F | CLAUDE.md de 5,5 Ko, aucune compétence, prompt simple | 1 |
| G | CLAUDE.md de 8 Ko, architect, grain-ponytail et unslop, prompt simple | 2 |
A à D sont venues en premier. E à G ont été construites à partir de ce que celles-ci ont montré, et la troisième exécution de B les a accompagnées comme témoin. Le fichier de 8 Ko est celui de 5,5 Ko plus une courte liste des compétences et du moment où les charger, ainsi que les règles de routage de modèle qui font que la compétence architect délègue à Sonnet.
Chaque résultat est ensuite allé à deux relecteurs Opus qui ne voyaient qu’une lettre, le diff, le dépôt et le ticket. Ils listaient chaque changement qu’ils demanderaient avant d’approuver, le classaient en bloquant, majeur, mineur ou détail, et vérifiaient chaque critère d’acceptation par rapport à un fichier et une ligne.
Coût
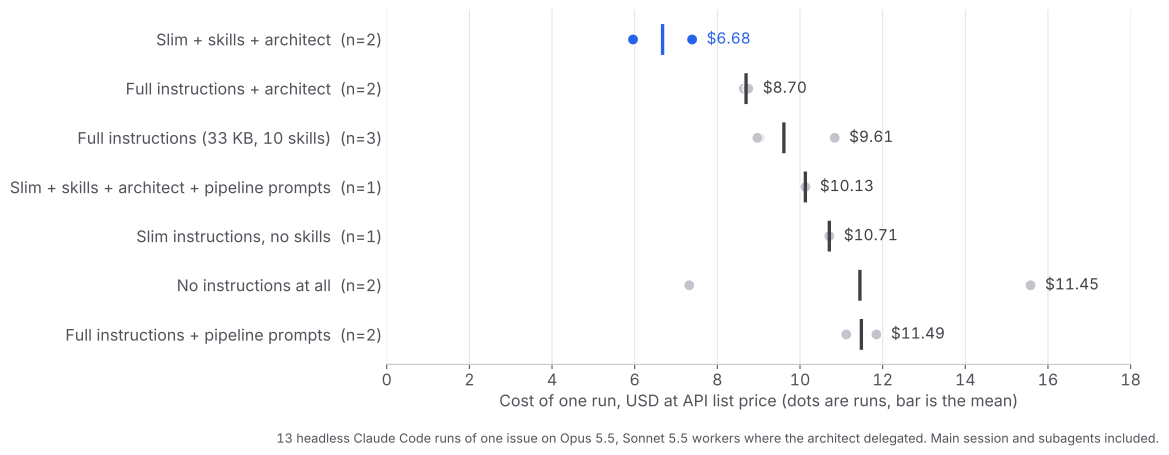
La configuration gagnante, G, a coûté 5,96 $ et 7,39 $. La configuration complète avec prompts de pipeline, A, a coûté 11,12 $ et 11,85 $. L’écart tient surtout au nombre de tours et à ce que chaque tour transporte. Les sessions principales de A ont tourné 172 et 144 tours sur Opus avec 24 à 28 millions de tokens d’entrée. Celles de G ont tourné 79 et 95 tours avec 13 à 16 millions, et ont confié environ 60 tours de plus à des exécutants Sonnet, facturés à une fraction du tarif. G a aussi terminé son travail en environ 21 minutes, contre 45 pour A.
Deux choses sur ce graphique m’ont surpris. Aucune instruction du tout n’est pas l’option bon marché : ses deux exécutions ont coûté 7,32 $ et 15,58 $, et la plus chère a aussi échoué à la CI et écrit le plus gros diff du test. Et le fichier de 5,5 Ko sans compétences, F, n’était pas moins cher que la configuration complète. Il a écrit plus de code, 1 601 lignes de produit, et l’a payé. L’économie de G ne vient pas du fichier court seul. Elle vient du fichier court plus les deux compétences qui changent la façon dont le travail est fait.
Rejoignez notre newsletter
Recevez gratuitement les derniers conseils, tendances et offres.
Qualité
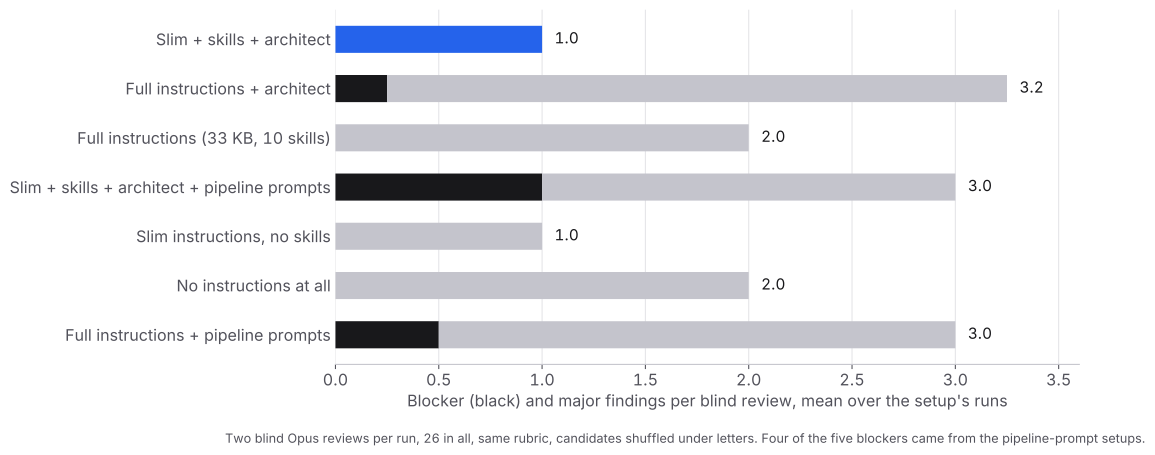
La configuration la moins chère avait aussi le moins de remarques sérieuses : aucun blocage, et 1,5 puis 0,5 remarque majeure par revue sur ses deux exécutions. Le CLAUDE.md complet, B, était à 2,0 majeures sur ses trois exécutions, autant qu’avec aucun CLAUDE.md du tout.
C’est le résultat qui m’importe le plus. Le fichier contient de longues sections sur la sécurité, les permissions et les crédits, écrites parce qu’un agent les avait un jour ignorées. Avec ou sans le fichier, les relecteurs ont trouvé le même nombre de problèmes sérieux, et les mêmes types revenaient d’une configuration à l’autre : un inscrit qui paie puis annule, un e-mail perdu ou envoyé deux fois quand un worker échoue à mi-parcours, un éditeur qui écrase du contenu qu’il ne peut pas afficher. Ce sont des lacunes de raisonnement sur l’état dans le temps. Aucune liste de règles dans CLAUDE.md ne les couvrait, parce qu’on ne peut pas écrire de règle pour un cas limite auquel on n’a pas encore pensé.
Ce qui les a couverts, c’est une modification de la compétence architect entre les deux tours. Avant que le modèle principal n’écrive le moindre brief, il rédige désormais un tableau : chaque critère d’acceptation, ce qui se passe quand l’état dont il dépend change dans le temps, et le comportement décidé. Chaque ligne entre ensuite dans le brief avec un test nommé. Les exécutions de G ont écrit 774 et 818 lignes de test, contre 510 à 670 pour B.
L’étape de planification
A et E sont les deux configurations qui ont exécuté les prompts de notre pipeline de CI : un prompt de planification qui écrit un plan, puis un prompt d’implémentation qui lit le plan et l’exécute. Comparez chacune avec sa jumelle qui a plutôt reçu un prompt simple. A a coûté 11,49 $ par exécution contre 9,61 $ pour B et a eu des blocages là où B n’en avait aucun. E a coûté 10,13 $ contre 6,68 $ pour G et a eu un blocage dans chacune de ses revues là où G n’en avait aucun.
Je pense que la raison est qu’un plan est un document que le modèle écrit pour lui-même puis qu’il doit relire comme une instruction externe. La seconde session traite le plan comme une spécification, le suit là où il est faux, et passe des tours à le réconcilier avec ce qu’elle trouve dans le code. Un modèle aussi capable planifie mieux à l’intérieur de la session qui est sur le point de faire le travail, là où le plan et le code sont dans le même contexte.
La partie de la planification qui a survécu, c’est le brief. Quand le modèle principal confie une tranche à un exécutant Sonnet, celui-ci part d’un contexte vide et construit exactement ce qu’on lui dit. Ce passage de relais exige une description écrite et décidée : l’objectif, les fichiers, le motif à imiter, les cas limites, le test à écrire. Un plan pour soi-même est une surcharge. Un brief pour quelqu’un d’autre est le seul moyen de transmettre le travail.
Ce que grain-ponytail a fait
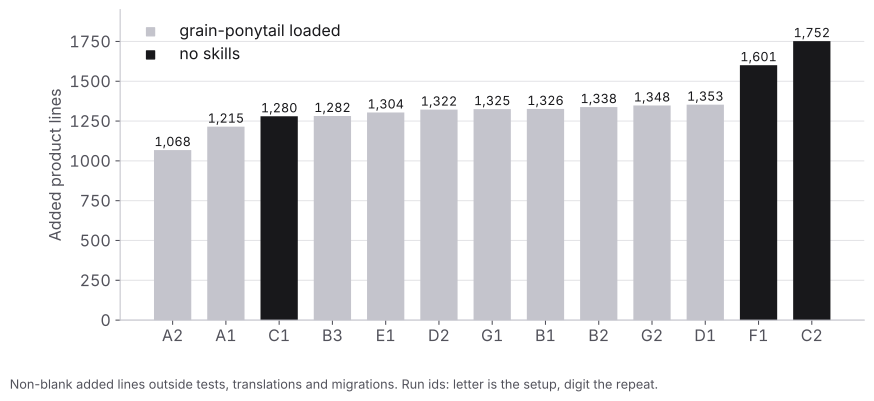
La compétence de code with the grain dit au modèle d’imiter l’exemple existant le plus proche et de livrer le minimum de code qui fonctionne. Chaque exécution qui l’avait chargée a écrit entre 1 068 et 1 353 lignes de produit. Les deux plus gros diffs, 1 601 et 1 752, venaient d’exécutions sans compétences. Une exécution sans compétence est restée à 1 280, donc la compétence ne décide pas seule de la taille, mais elle a supprimé la traîne.
C’est aussi le cas le plus clair de ce type d’instruction qui paie encore. « Imite l’exemple le plus proche » change ce que le modèle fait sur chaque fichier qu’il écrit. « Utilise snake_case pour les fonctions » répète quelque chose qu’il fait déjà.
Ce que les revues ont encore attrapé
L’exécution gagnante n’était pas propre. Après le test, j’ai rebasé le travail de G2 sur main et je l’ai passé dans notre vérification complète de PR, qui relit le diff, prouve chaque remarque par un test qui échoue et pilote le changement dans un vrai navigateur. Elle a trouvé que l’éditeur d’étapes supprimait tous les blocs sauf le premier bloc HTML quand un administrateur modifiait une étape créée via MCP, et qu’une libération de claim échouée pouvait envoyer deux fois un e-mail à certains utilisateurs. Les deux ont été corrigés, avec des tests, avant que la PR ne parte en revue humaine.
Les relecteurs à l’aveugle ont aussi signalé plus de sur-ingénierie dans les exécutions avec architect que dans celles avec les instructions complètes : 2,5 éléments par revue pour G contre 0 à 1,0 pour les exécutions de A et B. Moins de remarques sérieuses, plus de détails. J’accepterais ce compromis, mais c’est un compromis.
Ce que j’ai changé
- Le CLAUDE.md de 33 Ko est devenu un AGENTS.md de 12 Ko que Codex lit aussi, et CLAUDE.md ne fait plus que l’importer. Il conserve les commandes, la cadence des tests, l’architecture et les règles qu’un modèle ne peut pas déduire du code, comme les chemins critiques et le fait que les deux surfaces d’agents doivent rester synchronisées.
- L’étape de planification a disparu du pipeline. Le triage remet le ticket directement à une étape d’implémentation dont le prompt s’est réduit à six étapes : lire le ticket, créer une branche, charger les compétences architect et grain-ponytail, tester, committer, ouvrir une PR en brouillon.
- La compétence architect a gagné le tableau des cas limites, un champ Tests dans le brief et une passe finale qui vérifie tout le diff par rapport au ticket plutôt que par rapport aux briefs. Cette version est publique sur github.com/LivinTribunal/architect-skill .
Le changement du dépôt est en revue au moment de la rédaction.
Ce qu’il faut en retenir
Si votre CLAUDE.md a grandi un incident à la fois, il paie probablement pour des règles que le modèle suit déjà. Réduisez-le à ce que le modèle ne peut pas découvrir en lisant le code, et mesurez avant et après sur une vraie tâche plutôt que de croire que plus de consignes est plus sûr.
Gardez les instructions qui changent la façon dont le travail est fait : qui tape le code, comment une tranche est briefée, quel motif existant copier. Abandonnez le pipeline planifier-puis-exécuter si votre modèle principal est un modèle de pointe actuel. Écrivez des briefs pour les exécutants, pas des plans pour vous-même.
Méthode
13 exécutions sans interface de Claude Code 2.1.289 le 5 octobre 2026, modèle principal Opus 5.5, exécutants Sonnet 5.5 là où la compétence architect déléguait. Toutes les exécutions partaient d’un seul commit du monorepo FlowHunt, chacune dans un clone APFS avec sa propre base Postgres, isolée des autres exécutions et des propres fichiers de l’expérience. Un broker poussait le commit de chaque exécution vers une PR en brouillon contre une branche de base figée et relançait la session avec le résultat de la CI, jusqu’à trois tours. Le coût est le total_cost_usd maximal par session, additionné sur la session principale et ses sous-agents. Les lignes de produit sont les lignes ajoutées non vides hors tests, traductions et migrations.
Chaque résultat a reçu deux revues à l’aveugle par Opus avec une seule grille : correction, critères d’acceptation, grain, champs privés et état caché, sur-ingénierie, sécurité et permissions, tests, migrations. Les candidats étaient mélangés sous des lettres, et les relecteurs pouvaient lire le dépôt mais rien exécuter. Les remarques par revue sont moyennées sur les exécutions d’une configuration. Avec une à trois exécutions par configuration, considérez la moyenne d’une configuration comme bruitée. Les conclusions ci-dessus sont celles qui ont tenu sur les deux tours.
