


La version courte
- Les agents de codage IA sont doués pour ajouter du code et mauvais pour remarquer que le code existe déjà. Livrés à eux-mêmes, ils donnent à un dépôt un second helper pour chaque premier, et chaque lecteur doit vérifier les deux pour faire confiance à l’un ou à l’autre.
- Le remède, ce sont deux habitudes écrites noir sur blanc pour qu’un agent les suive. Le grain : trouver l’exemple existant le plus proche du même type d’objet et reproduire sa forme, son emplacement et ses noms. Le ponytail : gravir une échelle depuis « est-ce que cela doit exister » jusqu’à « le minimum qui fonctionne » et s’arrêter au premier barreau qui tient.
- Les deux forment désormais une compétence publique, sous licence MIT : grain-skill sur GitHub . Elle contient les règles d’écriture, une passe de revue avec des tags fixes, et la forme de la ligne de clôture qui oblige l’agent à nommer ce qu’il a reproduit.
- Dans notre dépôt principal depuis août : 386 issues et pull requests portent un commentaire de plan nommant l’exemplaire à reproduire, sur 1 333 commits dans une arborescence d’environ 18 000 fichiers. 35 endroits du code portent un commentaire
ponytail:nommant une simplification délibérée et sa voie de mise à niveau. - La découverte inconfortable : l’agent a invoqué la compétence en tant que compétence zéro fois. Les règles ont fonctionné parce que je les ai aussi placées dans le CLAUDE.md du projet, dans les définitions des agents travailleurs et dans la checklist de revue. Placez la règle là où l’agent lit déjà.
J’ai déjà écrit sur ce sujet une fois et le résultat ne m’a pas plu, parce que cela décrivait le principe et non le mécanisme. Voici la version avec le mécanisme.
L’échec auquel cela répond
Trois exemples venus de notre backend, tous réels, tous issus de pull requests écrites par l’agent qui passaient leurs tests.
Une nouvelle route REST qui tirait le service applicatif directement depuis une factory. Toutes les routes voisines du dépôt suivent route vers contrôleur vers service vers repository, chaque saut étant injecté. Celle-ci réduisait la chaîne à route vers service. Elle fonctionnait. Cela signifiait aussi que l’unique endroit où vivent la validation de requête et la mise en forme de réponse pour cette fonctionnalité n’existait pas, et que le prochain agent à toucher la fonctionnalité aurait deux formes entre lesquelles choisir.
Un service surdimensionné découpé en _payloads.py, _protocol.py et _tokens.py, chacun étant un module de async def nus, le service appelant protocol.discover(...) par import. Le contrôle de longueur de fichier est passé au vert. Ce que l’injection de dépendances existe pour empêcher est revenu aussitôt : un collaborateur choisi au moment de l’import, non substituable sans patcher le module, absent du constructeur qui documente ce dont le service dépend.
Un second normaliseur. Il y en avait déjà un. L’agent ne l’a pas trouvé, en a écrit un autre de huit lignes qui faisait presque la même chose, et maintenant deux fonctions au comportement différent sur les cas limites prétendent toutes deux canoniser le même champ.
Aucun de ces cas n’est un bug au sens où un test l’attrape. Chacun est un agent qui choisit le code qu’il pouvait générer plutôt que le code qui existait. Faites cela sur quelques centaines de pull requests et le dépôt cesse d’avoir une forme.

Prêt à développer votre entreprise?
Commencez votre essai gratuit aujourd'hui et voyez les résultats en quelques jours.
Le grain
Le nouveau code doit être indiscernable du code qui l’entoure. La compétence transforme cette phrase en cinq étapes que l’agent suit avant d’écrire.
Trouvez d’abord l’exemplaire. Pour un endpoint, un service, un repository, un hook de requête, une tranche de store ou un composant, localisez le plus proche existant et copiez sa forme, son emplacement de fichier et son nommage. N’inventez pas de structure quand un patron existe. Dans notre dépôt, la tranche branding est l’exemplaire nommé pour le backend parce qu’elle est petite, propre et couvre chaque couche, et le tableau de la compétence indique, pour chaque type d’artefact, quel fichier ouvrir et quoi reproduire.
Respectez les couches. La présentation appelle l’application qui appelle le domaine, et l’infrastructure implémente le domaine. Un nouvel import à travers ces lignes échoue au contrôle d’architecture. Lisez le document sur les couches, ne le redérivez pas.
Grain local contre grain du dépôt. Alignez-vous sur vos voisins. Mais si les voisins eux-mêmes s’écartent de la chaîne canonique, suivez la chaîne canonique et signalez l’écart plutôt que de copier la dérive. « Ça correspond aux cinq autres routes de ce fichier » ne suffit pas si les six sautent une couche qu’utilise la tranche canonique. Vous avez comparé trop localement.
Réutilisez le helper canonique. Si un helper, un type ou un patron vit déjà dans le dépôt, utilisez-le. Deux normaliseurs obligent chaque lecteur à comparer les deux.
Les noms portent du sens. Réutilisez le vocabulaire déjà présent dans le code. Un nouveau nom pour un concept existant est un bug qui attend un lecteur.
Le test final est celui que je donne aux relecteurs : si vous pouvez dire quelles lignes l’agent a écrites rien qu’à leur forme, c’est qu’il a lutté contre le grain.
Ponytail
Paresseux veut dire efficace, pas négligent. Le meilleur code est le code jamais écrit. Comprenez d’abord pleinement le problème, chaque fichier que le changement touche, le vrai flux de bout en bout, puis gravissez cette échelle et arrêtez-vous au premier barreau qui tient.
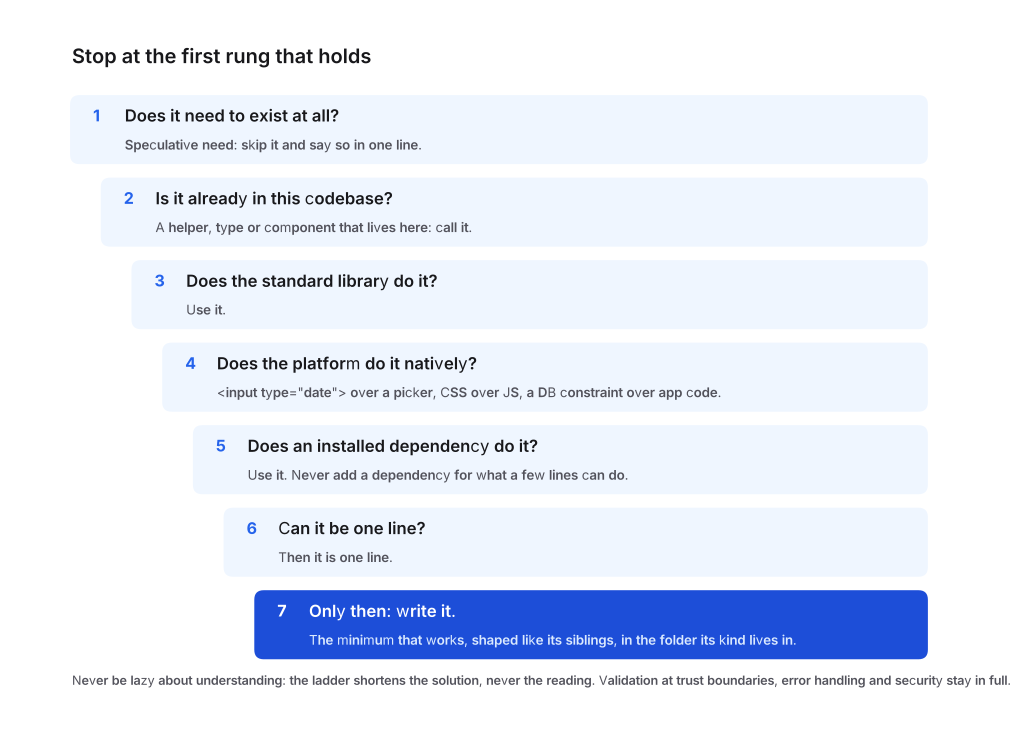
Deux règles accompagnent l’échelle.
Une correction de bug, c’est une cause racine, pas un symptôme. Un ticket nomme un symptôme. Faites un grep de tous les appelants de la fonction que vous êtes sur le point de toucher. Un garde-fou dans la fonction partagée est un diff plus petit qu’un garde-fou chez chaque appelant, et ne corriger que le chemin nommé par le ticket laisse les appelants voisins cassés.
Gardez le diff minimal. Le diff est ce que la revue lit. Pas de refactorisations opportunistes, pas de renommages, pas de reformatage, pas d’améliorations « tant que j’y suis », pas de fichiers touchés que la tâche n’exigeait pas. Chacune enterre le vrai changement. Si le diff est plus gros que le problème, réduisez-le. Les améliorations que vous avez repérées sont une issue de suivi, pas des commits supplémentaires sur cette branche.
Et les limites, parce que « paresseux » est le mot le plus susceptible d’être mal lu. Ne simplifiez jamais en supprimant la validation des entrées à une frontière de confiance, la gestion d’erreurs qui empêche une perte de données, la sécurité, les bases de l’accessibilité, ou quoi que ce soit que l’utilisateur a demandé. Ne soyez jamais paresseux sur la compréhension : l’échelle raccourcit la solution, jamais la lecture. Un petit diff au mauvais endroit est un second bug. Une logique non triviale laisse derrière elle une vérification exécutable, la plus petite chose qui échoue si la logique casse.
Quand l’agent choisit un barreau exprès et connaît le plafond, il le dit dans le code :
# ponytail: verrou global, verrous par compte si le débit compte
Il y en a 35 comme celui-ci dans notre dépôt maintenant. Chacun est une décision qu’un futur lecteur devrait sinon reconstituer, et un marqueur indiquant où regarder quand le plafond est atteint.
Rejoignez notre newsletter
Recevez gratuitement les derniers conseils, tendances et offres.
Faire en sorte qu’un agent le fasse vraiment
Un principe dans un document n’est pas un comportement. Trois mécanismes ont transformé ces deux principes en comportements, et je les classerais dans cet ordre.
Le brief porte l’exemplaire. Dans le patron architecte , le modèle principal écrit un brief pour un travailleur, et le champ Design du brief nomme le patron existant le plus proche à reproduire et le changement minimal sur la cause racine. Le travailleur n’a pas à trouver le grain. On le lui remet. Dans notre dépôt, c’est ce que sont les 491 commentaires de plan sur 386 issues et pull requests : une étape de planification qui nomme quoi reproduire avant que quiconque écrive.
L’agent termine en disant ce qu’il a reproduit. Le rapport de chaque implémenteur se termine par une ligne, mirrored: <path>, ou nomme le nouveau patron et pourquoi aucun voisin ne convenait. C’est peu coûteux et c’est la meilleure aide à la revue que j’aie ajoutée. Une ligne mirrored: pointant vers le mauvais type de fichier vous dit que le diff est faux avant même que vous l’ouvriez. Une ligne manquante vous dit que l’agent n’a pas regardé.
La revue impose la même barre, dans un ordre fixe. Notre compétence de revue a deux passes avec des tags fixes, et ce sont les tags qui rendent les constats comparables entre relecteurs et entre agents.
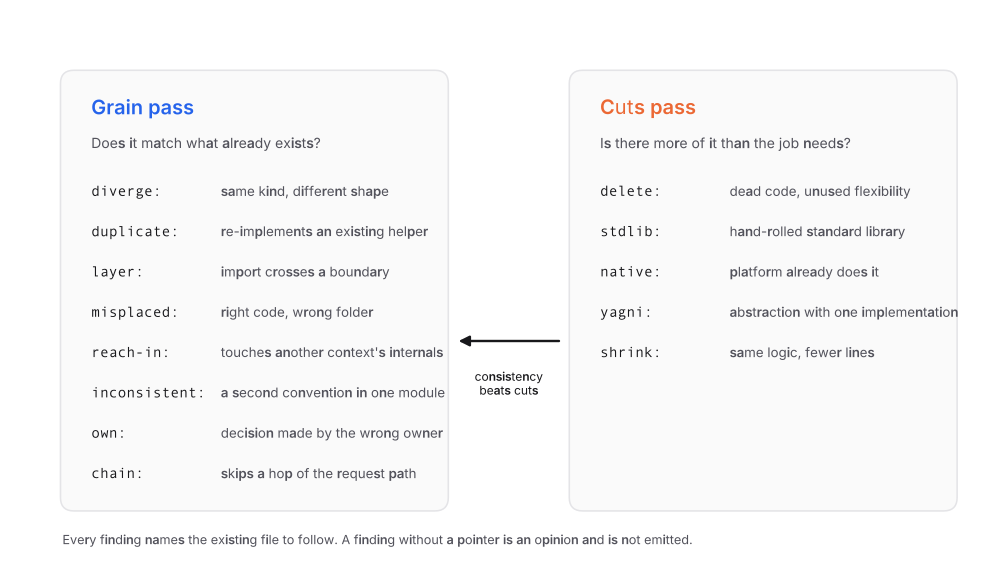
La structure d’abord. Est-ce que cela s’écarte de l’exemplaire le plus proche, duplique un helper existant, franchit une couche, se trouve au mauvais endroit, va chercher dans les entrailles d’un autre module, utilise des noms incohérents, s’approprie quelque chose qu’il devrait injecter, ou casse la chaîne d’appel canonique ? Ensuite les coupes. Que pourrait-on supprimer, remplacer par la bibliothèque standard, remplacer par une fonctionnalité native, écarter comme spéculatif, ou réduire ?
L’ordre est une règle, pas une préférence. La cohérence l’emporte sur les coupes. Une coupe qui laisse le code s’écarter de ses voisins n’est pas une victoire, parce que le lecteur doit maintenant apprendre deux formes pour économiser huit lignes. Lancez la structure d’abord et la passe de coupes ne touche que du code qui correspond déjà.
Ce qui s’est passé dans le dépôt, y compris la partie qui n’a pas fonctionné
Depuis le 1er août, notre dépôt principal a reçu 1 333 commits, la plupart écrits par l’agent puis passés en revue. 386 des issues et pull requests de cette période portent un commentaire de plan qui nomme l’exemplaire à reproduire, 491 commentaires de ce type au total. La chaîne canonique est la forme par défaut d’un nouvel endpoint, et les deux routes héritées qui sautent le contrôleur sont listées dans le document comme un écart en cours de retrait, pas comme un second style.
Les 35 commentaires ponytail: sont un nombre plus petit que ce que j’attendais et je pense que c’est juste. La plupart des simplifications ne valent pas un commentaire. Celles qui en valent un sont celles qui ont un plafond.
Maintenant la partie que je préférerais ne pas rapporter. J’ai livré grain et ponytail comme compétence Claude Code : une description dans l’index des compétences, un corps qui se charge à la demande, et une ligne dans CLAUDE.md disant de l’invoquer avant d’écrire du code. Sur cinq semaines de transcriptions, l’agent l’a invoquée par son nom zéro fois. La ligne de clôture mirrored: est apparue dans sept réponses.
Les règles ont quand même pris. Elles ont pris parce que le même texte était aussi à trois endroits que l’agent lit sans choisir de le faire : le CLAUDE.md du projet, présent dans le contexte dès le premier tour ; les définitions des agents travailleurs, qui disent « reproduis la forme, l’emplacement et le nommage de l’exemple existant le plus proche » et « va chercher la solution la plus paresseuse qui fonctionne réellement » comme des règles, pas comme une compétence à envisager ; et la checklist de revue, dont les tags font échouer une pull request qui les ignore. Le corps de la compétence est devenu la référence canonique vers laquelle ces trois points renvoient. Comme déclencheur, il n’a rien fait.
Donc la leçon que je transmettrais à quiconque empaquette des conventions pour un agent est celle-ci. Une compétence est un bon endroit pour la version longue d’une règle. C’est un mauvais endroit pour la règle elle-même, parce que l’agent doit décider de la charger et, la plupart du temps, il ne le fera pas. Mettez la version d’un paragraphe dans le fichier toujours présent dans le contexte, mettez la version impérative dans la définition de l’agent qui écrit le code, et mettez le contrôle dans la revue qui conditionne le merge. Puis faites pointer les trois vers la compétence pour le détail.
La version publique sur github.com/LivinTribunal/grain-skill est agencée ainsi : un court SKILL.md avec les règles qu’un agent peut garder en tête, le document complet avec l’échelle et les anti-patrons, les tags de revue, et un README qui dit quel paragraphe va dans votre CLAUDE.md et lequel va dans la définition de votre implémenteur. Remplacez l’exemple travaillé par votre propre exemplaire canonique et c’est terminé.
