


La version courte
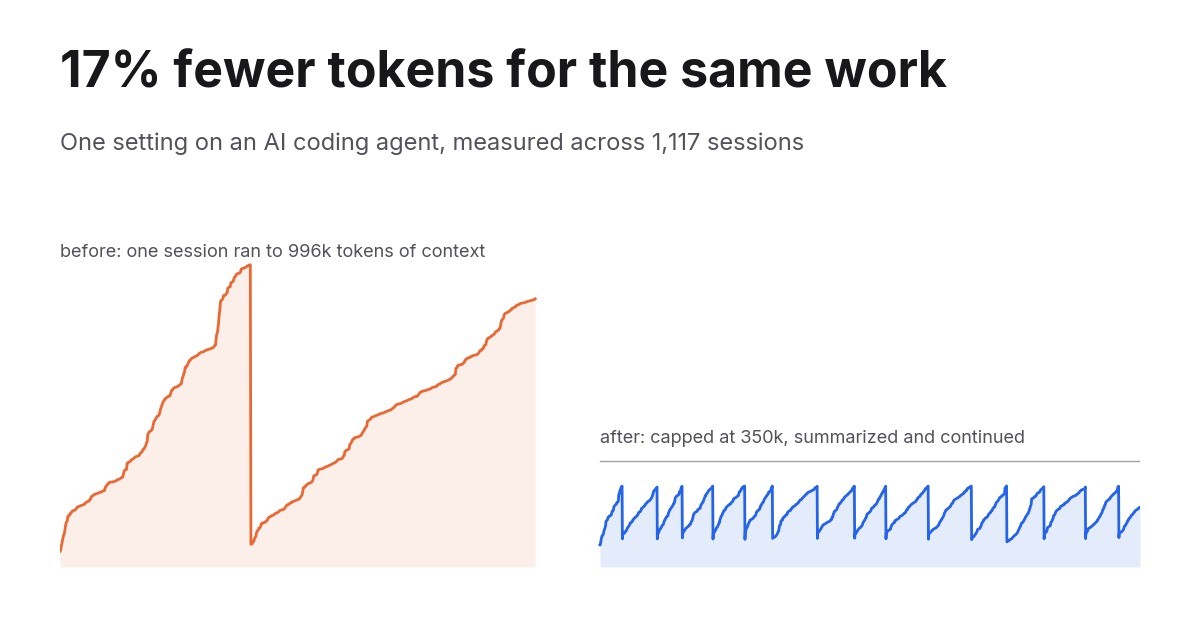
- Je fais tourner un agent de codage IA toute la journée sur un modèle doté d’une fenêtre de contexte de 1M de tokens. Les sessions grossissaient jusqu’à presque la remplir.
- J’ai ajouté une ligne à sa configuration, plafonnant une session à 350 000 tokens de contexte avant qu’elle ne se résume et ne poursuive.
- Mesuré sur 1 117 transcriptions de sessions : 17 % de tokens en moins pour le même nombre de prompts, et dans les longues sessions où le plafond mord réellement, 55 % de moins.
Voici la méthode, tous les graphiques, et ce que cela vous coûte en retour, pour que vous puissiez décider si cela s’applique à votre configuration.
Pourquoi une fenêtre de 1M coûte plus qu’elle n’en a l’air
Une conversation avec un modèle est sans état. Chaque requête transporte tout l’historique : le prompt système, chaque définition d’outil, chaque fichier lu par l’agent, chaque résultat d’outil, chaque message. Pas un delta. Tout, à chaque fois.
Ainsi, une session qui a atteint 900 000 tokens paie 900 000 tokens d’entrée à l’appel suivant, puis à celui d’après. Le tour 400 ne fait pas plus de travail que le tour 4. Il coûte simplement plusieurs fois plus cher.
Le cache de prompt adoucit cela. Les tokens que le modèle a déjà vus sont facturés environ un dixième du prix d’entrée normal. Cette remise est réelle, c’est elle qui rend les longues sessions viables tout court, et c’est aussi pourquoi personne ne se penche sur le problème. Dans mes données, 98 % de tous les tokens d’entrée étaient des lectures de cache. Un dixième d’un très grand nombre restait la ligne la plus lourde de la facture.
La question n’est pas de savoir si votre historique est mis en cache. Elle est de savoir jusqu’à quelle taille on le laisse grossir avant que quelque chose ne le réinitialise.

Prêt à développer votre entreprise?
Commencez votre essai gratuit aujourd'hui et voyez les résultats en quelques jours.
Ce que j’ai changé
L’agent est Claude Code exécutant Opus sur la fenêtre de contexte 1M. Le réglage est autoCompactWindow dans ~/.claude/settings.json. Lorsqu’une session atteint ce nombre de tokens, l’agent résume la conversation et reprend à partir du résumé.
{
  "autoCompactWindow": 350000
}
Je ne l’avais jamais défini, donc les sessions tournaient jusqu’à approcher la fenêtre complète. Sur quatre jours, j’ai essayé trois valeurs :
| Date | Réglage |
|---|---|
| 14 septembre | 250 000 |
| 15 septembre | 300 000 |
| 18 septembre | 350 000 |
Comment je l’ai mesuré
Claude Code écrit chaque session dans une transcription JSONL sous ~/.claude/projects/, y compris la consommation de tokens de chaque appel d’API. J’ai analysé les 1 117 transcriptions, couvrant cinq semaines du 19 août au 22 septembre, dédupliquées par identifiant de requête, et je n’ai gardé que les sessions interactives. Les exécutions dans GitHub Actions utilisent le même compte mais ne peuvent pas être affectées par un réglage sur mon ordinateur portable, elles sont donc exclues.
Les totaux bruts de tokens sont trompeurs en eux-mêmes. Une semaine chargée bat une semaine calme, quoi que vous changiez. Chaque chiffre ci-dessous est donc pondéré par le cache, c’est-à-dire ce que lit réellement le compteur : entrée fraîche à 1x, écritures de cache à 1,25x (cache de 5 minutes) ou 2x (cache d’une heure), lectures de cache à 0,1x. Et chaque comparaison est normalisée par le travail effectué, soit les prompts que j’ai saisis, soit les appels d’API que l’agent a faits.
Rejoignez notre newsletter
Recevez gratuitement les derniers conseils, tendances et offres.
Deux sessions, même agent
Voici le mécanisme en une image. À gauche, une vraie session du 3 septembre, avant le plafond. À droite, une vraie session du 15 septembre, après.
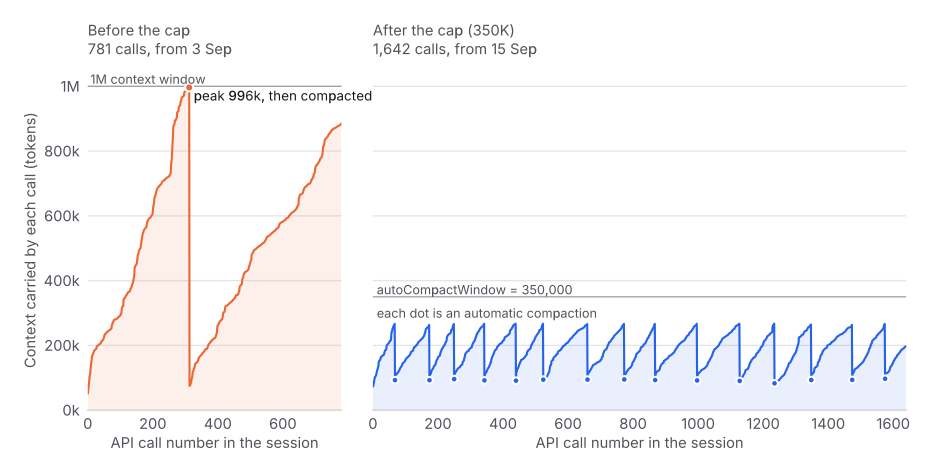
La session de gauche a duré 781 appels. Elle est montée à 996 000 tokens de contexte, a heurté le mur de la fenêtre 1M, s’est compactée une fois, puis est remontée directement à 880 000. Pendant la seconde moitié de cette session, chaque appel relisait plus d’un demi-million de tokens.
La session de droite a duré 1 642 appels, plus de deux fois plus longtemps, et n’a jamais transporté plus de 270 000 tokens. Elle s’est compactée quinze fois. Chaque compactage est un point.
Les chiffres hebdomadaires
Sessions interactives uniquement. Les barres représentent les tokens d’entrée pondérés par le cache par appel d’API, le chiffre unique le plus équitable car il ne dépend pas de la quantité de travail fournie dans une semaine donnée.
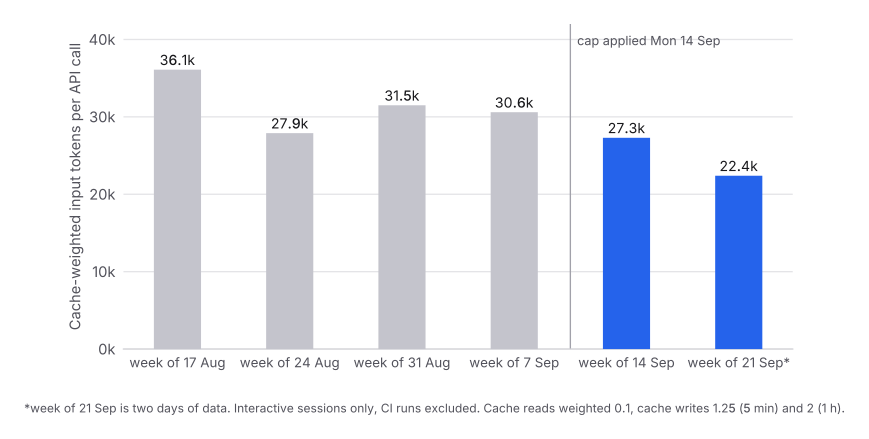
La comparaison la plus propre du jeu de données est la semaine du 7 septembre face à celle du 14 septembre, parce que je ne les ai pas choisies. Elles se sont simplement trouvées de part et d’autre du changement, et j’ai saisi presque exactement le même nombre de prompts dans chacune.
| Semaine du | Prompts | Appels d’API | Entrée pondérée par le cache | Par appel |
|---|---|---|---|---|
| 7 sept. | 971 | 11 364 | 348,1M | 30,6k |
| 14 sept. | 968 | 10 555 | 288,5M | 27,3k |
971 prompts contre 968. L’entrée effective passe de 348,1M à 288,5M. Cela représente 17 % de moins pour la même quantité de prompting. Les deux jours de la semaine suivante se situent à 22,4k par appel, encore plus bas.
Où partait l’argent
Répartissez chaque appel d’API selon la quantité de contexte qu’il transportait, et le mécanisme devient visible directement.
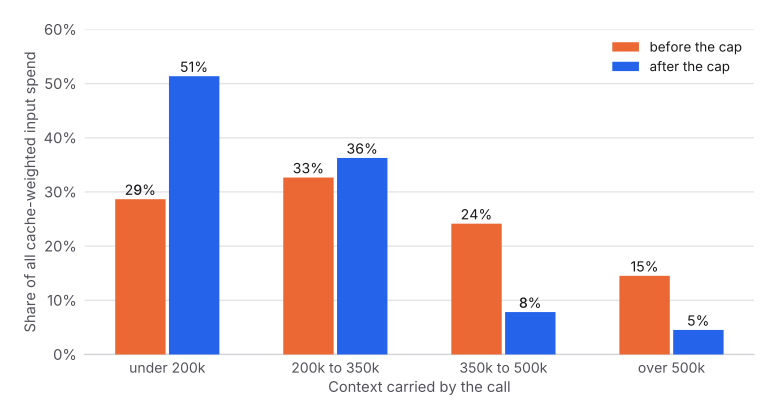
Avant le plafond, 39 % de tout ce que j’ai dépensé allait à des appels traînant plus de 350 000 tokens d’historique derrière eux. Ces appels ne faisaient pas plus de travail que les autres. C’était le même travail, avec plus de bagages. Après le plafond, cette part est de 12 %.
Le plafond a-t-il tenu
Un point par session, placé au plus grand contexte que cette session ait jamais transporté.
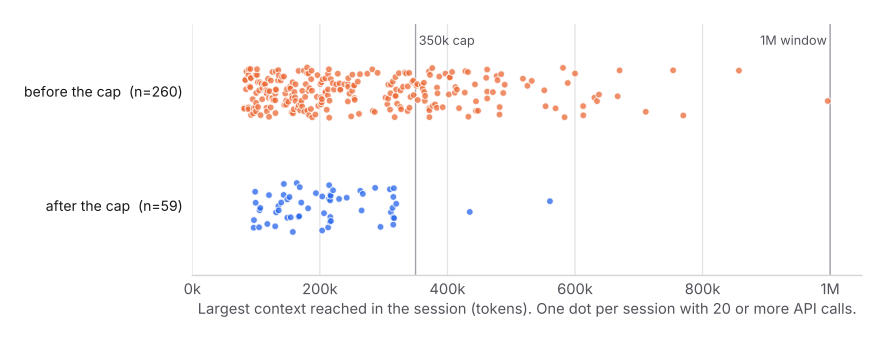
Deux sessions des deux premiers jours ont encore dépassé le plafond, à 434 000 et 561 000, et je n’ai pas découvert pourquoi. Depuis que le réglage à 350 000 a été mis en place le 18 septembre, aucune session ne l’a dépassé. La traîne des sessions vivant entre 500k et 1M, là où se trouvait l’essentiel du gaspillage, a disparu.
Ce que cela aurait coûté sans le plafond
Pour en donner un total, j’ai rejoué chaque session démarrée après le changement comme si le contexte supprimé n’avait jamais été résumé et était encore relu à chaque appel ultérieur, borné à la fenêtre 1M.
| Entrée pondérée par le cache | |
|---|---|
| Réel, 73 sessions, 9 675 appels, 55 compactages | 216,8M |
| Les mêmes sessions sans le plafond | 479,2M |
| Évité | 262,5M, soit 55 % |
La session de droite du premier graphique en représente 118,5M à elle seule. Un long refactoring qui, sinon, aurait passé ses dernières centaines d’appels à relire près d’un million de tokens à chaque fois.
Considérez 55 % comme l’extrémité optimiste. Sans le plafond, je n’aurais pas vraiment laissé une session peiner à 900k pendant des heures ; j’aurais fini par la vider à la main, ce qui réinitialise aussi le coût. L’extrémité prudente est le chiffre observé par appel, de 30,6k à 22,4k, soit à peu près 20 % à 27 %. La vérité se situe entre ces deux bornes.
Ce que cela vous coûte
Ce n’est pas gratuit, et quiconque le recommande devrait le dire.
L’attente. 67 compactages depuis le changement, à une médiane d’environ trois minutes chacun. Environ 3,4 heures à regarder un résumé s’écrire, réparties sur huit jours.
Un peu de reprise de travail. Le compactage supprime beaucoup de choses. Au réglage 350K, le compactage médian faisait passer une session de 318 000 tokens à 24 000. L’agent perd des détails et les reconstruit parfois : les fichiers relus dans la même session sont passés de 11,5 % des lectures avant le premier compactage à 20,5 % après. L’échantillon derrière ce second chiffre est petit, lisez-le donc comme une tendance plutôt que comme une mesure.
Le choix du seuil compte. À 250K, 36 % de mes longues sessions déclenchaient un compactage. À 350K, 12 % le faisaient, alors que le plafond tenait toujours. Réglez-le trop bas et vous payez les trois minutes et la reprise de travail de façon répétée pour une économie que vous aviez déjà empochée.
Comment le mettre en place
Claude Code. Ajoutez autoCompactWindow dans ~/.claude/settings.json. Sur un modèle à contexte 1M, 350 000 était la meilleure des trois valeurs que j’ai essayées. Sur un modèle 200K, réduisez l’échelle et commencez autour de 120 000 à 140 000. Les nouvelles sessions le prennent en compte ; une session déjà en cours conserve l’ancienne valeur.
Autres agents. Cherchez la même idée sous un autre nom : un déclencheur de compactage, une limite de contexte, un seuil de résumé-puis-continue. S’il n’y en a aucun, la version manuelle consiste à vider la session plus souvent qu’il ne semble naturel. L’instinct de garder une longue session vivante toute la journée parce qu’elle « connaît le projet » est celui qui coûte cher.
Quoi que vous utilisiez, deux habitudes font plus que n’importe quel réglage. Conservez l’état durable dans des fichiers plutôt que dans la conversation, afin que l’agent puisse relire un seul fichier à faible coût au lieu de transporter pour toujours chaque réponse précédente. Et déléguez le travail gourmand en lecture à des sous-agents dotés de leur propre contexte éphémère, pour que les vingt fichiers qu’ils lisent n’entrent jamais dans la session principale.
Si vous êtes sur une limite hebdomadaire
Si vous payez un abonnement avec une limite d’usage hebdomadaire plutôt qu’une facture au token, c’est le levier offrant le meilleur rapport effort/effet que j’aie trouvé. Une ligne de JSON, aucun changement dans votre façon de travailler, et la même limite s’étire de façon mesurable. Dans mon cas, le même volume hebdomadaire de prompting a coûté 17 % de moins, et les longues sessions environ moitié moins.
À lire ensuite
On vend les fenêtres de contexte comme de la capacité. Elles se comportent comme un compteur qui tourne, facturé à chaque tour pour tout ce que vous y avez jamais mis. Si vous voulez les mécanismes derrière tout cela plutôt que le simple réglage, l’article complémentaire détaille ce qui remplit réellement une fenêtre de contexte, pourquoi une longue session coûte bien plus que le travail qu’elle accomplit, et comment le cache, le vidage et le compactage changent chacun l’arithmétique.
