


Il y a quelques jours, Anthropic a fait de Fable un élément permanent des offres Max. Le timing raconte l’histoire : c’est arrivé juste après la sortie de GPT-5.6 Sol par OpenAI et — surtout — juste après que Kimi K3 a publié ses poids. Il aura fallu un modèle open source pour forcer le plus grand laboratoire d’IA à redescendre sur terre et mettre fin au battage marketing autour de son modèle phare. Rien que pour cela, tous ceux qui paient ces factures méritent de lever leur verre.
Mais “inclus dans votre abonnement” n’est pas synonyme de “bon marché”, et ce n’est certainement pas synonyme de “bon marché pour toujours”. C’est pourquoi, pendant que Fable était encore facturé à l’usage, nous avons reconstruit notre flux de travail pour que le modèle coûteux soit mécaniquement empêché d’écrire du code. Il réfléchit, planifie et relit. Les modèles moins chers tapent. Cet article montre comment cela fonctionne, et ce que cela a réellement donné sur l’ensemble de nos transcriptions — 606 sessions réelles couvrant un monorepo SaaS de production, une application d’exploitation de drones, un site marketing et les agents de CI qui les servent.
Partie 1 — Le piège et le principe
Voici notre point de départ, honnêtement : nous ne pouvons plus fonctionner sans modèles de pointe. Personne dans l’équipe ne pourrait maintenir la production actuelle sans eux — et cette dépendance est exactement le levier que détiennent les grands laboratoires. Selon notre lecture, les abonnements IA actuels fournissent nettement plus de calcul qu’ils ne coûtent ; ce sont des prix de conquête de marché, et les prix de conquête de marché finissent par disparaître. Le jour où cela arrivera, ceux qui ont bâti leur culture d’ingénierie sur les “tokens de pointe illimités” paieront le prix demandé.
Il existe deux défenses. La première consiste à garder une porte de sortie crédible : les modèles ouverts comme DeepSeek et Kimi sont ce qui a forcé la correction tarifaire de cette semaine, et ils ne restent un levier que si nos flux de travail restent réellement portables vers eux. La seconde est la discipline de processus : ne dépenser des tokens de pointe que là où rien de moins cher ne fonctionne. Cet article porte sur la seconde — parce que c’est celle que vous pouvez commencer dès lundi.
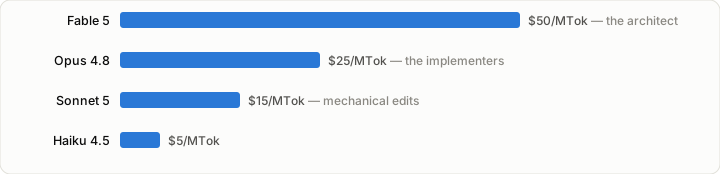
Le principe est assez ancien pour qu’un bâtiment porte son nom : l’architecte ne pose pas de briques. L’avantage d’un modèle de pointe sur un modèle de gamme intermédiaire est énorme en conception, en décomposition et en revue — et proche de zéro quand il s’agit de taper un renommage dans quarante fichiers. Alors séparez les rôles. L’échelle des prix dit la même chose en dollars :
Comment fonctionne le patron fable-architect
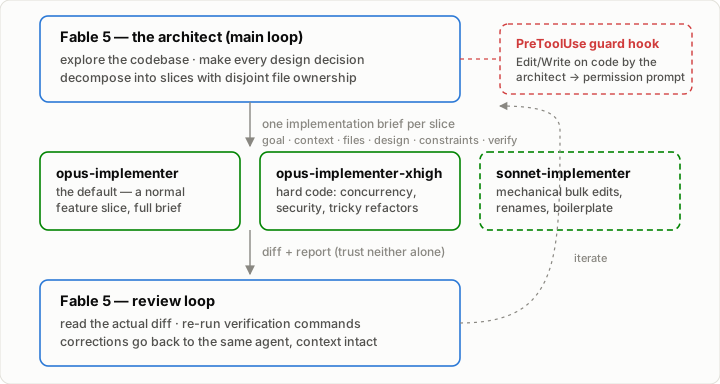
La compétence fable-architect est un fichier markdown d’environ 100 lignes plus un hook shell, chargé chaque fois qu’une session Claude Code tourne sur le modèle de pointe. Elle impose une division du travail :
- L’architecte fait : interroger l’exigence, explorer la base de code, prendre toutes les décisions de conception — approche, flux de données, noms, signatures, cas limites — décomposer le travail en tranches indépendantes, relire les diffs renvoyés, exécuter la vérification et rédiger toute la prose (plans, briefs, descriptions de PR, messages de commit).
- L’architecte ne fait jamais : écrire ou modifier un fichier source. Pas de code dans le chat au-delà de courtes signatures à l’intérieur d’un brief.
Trois choses font que cela fonctionne en pratique et non sur une diapositive.
1. Le brief est l’interface
Chaque tranche reçoit un seul brief d’implémentation. L’implémenteur démarre avec une fenêtre de contexte vierge — tout ce qui n’est pas dans le brief, il doit le redécouvrir ou le deviner. Cette contrainte est une fonctionnalité : elle oblige l’architecte à finir de décider avant de déléguer. Un brief contient des décisions, pas des options.
## Implementation brief: <slice>
Goal:         one sentence, observable outcome
Context:      what exploration already found — excerpts, the nearest
              pattern to mirror, line anchors, gotchas
Files:        paths to create/modify — this slice's exclusive ownership
Design:       the decided approach — data flow, names, signatures, edges
Constraints:  project rules that apply: style, layers, security
Out of scope: what not to touch, including files owned by other slices
Delegation:   may this slice spawn sub-implementers, and how many
Verify:       exact commands and expected outcome
Deux de ces lignes sont plus récentes que les autres, et elles existent parce que le niveau des implémenteurs a changé sous nos pieds — voir la mise à jour plus bas.
2. L’application mécanique, pas l’intuition
Un hook de garde PreToolUse surveille la session : si l’architecte tente de modifier un fichier qui n’est pas de la prose, une demande d’autorisation se déclenche. Approuver cette demande est l’exception documentée pour les modifications triviales (une faute de frappe, un incrément de version — des cas où la surcharge de délégation coûte plus cher que la frappe). La friction, c’est la politique. Sans le hook, “le modèle coûteux ne devrait pas coder” tient exactement jusqu’à la première échéance.
3. La boucle de revue comble l’écart de qualité
L’architecte lit le rapport de l’agent et le diff réel — sans faire confiance à l’un ou à l’autre seul — et relance les commandes de vérification clés quand l’enjeu le justifie. Un problème trouvé ? La correction repart vers le même agent, qui détient encore tout son contexte de travail. Pas de correction à la main, pas de relance à froid.
Notez qu’il s’agit de la vérification de l’architecte, et elle reste. Ce que nous avons commencé à retirer, c’est la vérification que nous écrivions dans les briefs — des instructions demandant à l’implémenteur de se contrôler lui-même. Les modèles implémenteurs plus récents le font sans qu’on le demande, et le leur demander à nouveau achète une seconde passe que vous avez déjà payée.

Prêt à développer votre entreprise?
Commencez votre essai gratuit aujourd'hui et voyez les résultats en quelques jours.
Ce que nous avons mesuré
Pour vérifier s’il s’agit d’un véritable mécanisme économique ou d’un simple rituel agréable, nous avons fouillé toutes les transcriptions Claude Code de nos projets, en dédupliquant les requêtes API et en valorisant chaque token aux tarifs catalogue actuels. Trois hypothèses, enregistrées avant de regarder les chiffres par session :
- H1 — Ce sont les implémenteurs qui tapent. Si c’est vrai, les sous-agents implémenteurs devraient produire plus de tokens de sortie que la boucle principale de l’architecte dans les sessions déléguées.
- H2 — La délégation coûte moins cher. Si c’est vrai, revaloriser le travail des implémenteurs aux tarifs du modèle architecte devrait donner un montant nettement plus élevé que ce que nous avons réellement payé.
- H3 — La qualité tient. La plus difficile : le code délégué ne devrait pas exiger plus de reprises que le code tapé par l’architecte.
Règles de base. Une requête API s’étale sur de nombreuses lignes de transcription qui répètent le même objet d’usage — nous avons regroupé par identifiant de requête, compté les tokens d’entrée et de cache une fois par requête, et retenu l’instantané de sortie maximal (une somme naïve ligne par ligne surcompte de 2 à 3×). Les coûts utilisent les tarifs catalogue Anthropic actuels — Fable 10 $/50 $, Opus 5 $/25 $, Sonnet 3 $/15 $ par million de tokens d’entrée/sortie — avec les lectures de cache à 10 % du prix d’entrée et les écritures de cache à leurs tarifs par TTL. 31 des 354 sessions du magasin interactif remplissent les critères de session fable-architect selon un classificateur conservateur ; les chiffres portent sur les huit plus coûteuses. Nous rapportons des ratios et des pourcentages plutôt que nos dépenses absolues.
Partie 2 — Les justificatifs
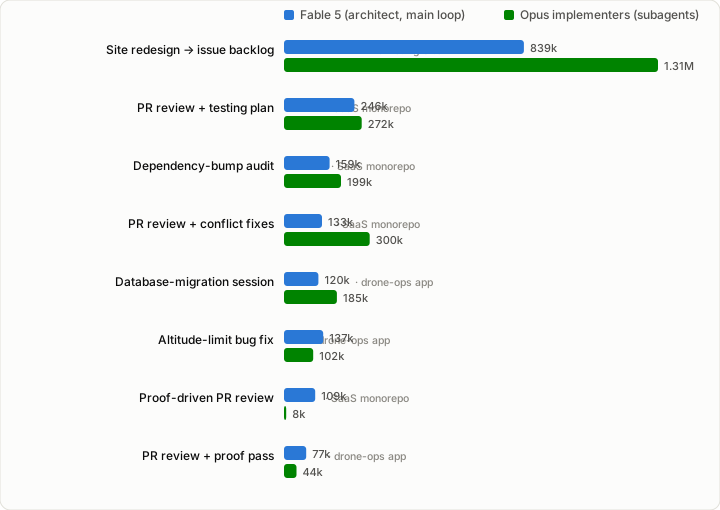
H1 — Mitigé… disait la première comptabilité. Dans les plus grosses sessions de délégation, l’hypothèse tient nettement — jusqu’à 2,3× plus de sortie chez les implémenteurs que chez l’architecte. Mais sur l’ensemble des 31 sessions fable-architect, l’architecte a tout de même produit plus que les implémenteurs, 3,59 M contre 3,15 M de tokens. En partie c’est normal — la sortie de l’architecte comprend tous les plans, les briefs et la prose de revue, ce qui est exactement son travail — et en partie cela ressemblait à des sessions qui déléguaient une tranche et gardaient le reste. Puis nous nous sommes rappelé que la refonte de notre site n’avait pas du tout donné l’impression d’être à forte teneur en architecte, et nous sommes partis chercher les tokens que la comptabilité des sous-agents ne pouvait pas voir.
Rejoignez notre newsletter
Recevez gratuitement les derniers conseils, tendances et offres.
Le second canal : le gestionnaire de tickets comme bus de délégation
La comptabilité des sous-agents a un angle mort : elle ne voit que la délégation qui se produit à l’intérieur d’une session. La session de refonte du site — la plus grosse ligne du graphique ci-dessus — s’est révélée tout autre chose : une unique session de boucle architecte qui a tourné 107 heures d’affilée (292 réveils programmés), a découpé la refonte en tickets GitHub, les a étiquetés pour notre pipeline de CI, puis a supervisé : interroger les exécutions, relire les pull requests du pipeline, ouvrir des tickets de suivi à mesure que le QA faisait remonter des bugs.
La frappe a eu lieu là où notre exploration par session n’avait même pas regardé : une flotte distincte de runners auto-hébergés, où les étapes plan → implémentation → évaluation des écarts → revue du pipeline se sont exécutées sous forme de 252 sessions Opus indépendantes sur 4,5 jours, touchant 48 tickets et PR distincts.
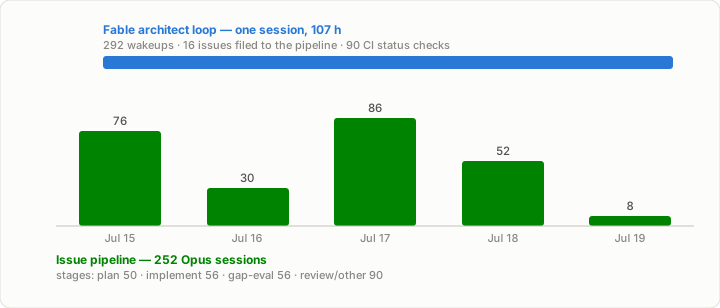
H1, revisitée — Confirmée à l’échelle du projet. Comptez les deux canaux et l’image s’inverse : le pipeline a tapé 10× plus de tokens de sortie que la boucle architecte qui l’a déclenché (9,07 M contre 877 k), le tout aux tarifs Opus. Faire tourner cette vague d’implémentation sur le modèle de l’architecte aurait coûté 2,1× plus cher — sur une seule refonte, en une semaine, avant même de compter les sous-agents en session. Un ticket n’est qu’un brief à grain plus grossier : même interface, même économie, un cran au-dessus.
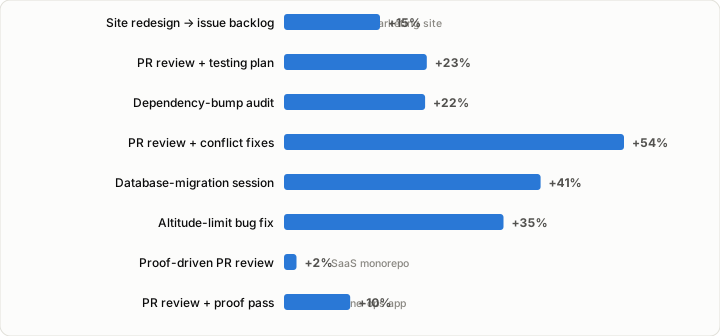
H2 — Confirmée, avec une nuance. Revaloriser les volumes exacts de tokens des implémenteurs aux tarifs du modèle architecte rend chaque session plus coûteuse — de +2 % à +54 %, 17 % sur les huit premières. De l’argent réel, mais moins que ne le suggère l’écart de 2× sur le prix de sortie. La nuance : ce n’est pas la sortie qui engloutit l’argent. Dans la plus grande session, les lectures de cache de l’architecte ont coûté environ 13× tout ce qu’il a tapé — la dépense dominante, c’est le modèle coûteux qui maintient et relit un large contexte d’orchestration, pas qui tape. La délégation plafonne la facture de sortie ; le prochain levier est de garder le contexte de l’architecte léger.
H3 — Non mesurée ici. La comptabilité de tokens ne voit pas la qualité du code. Ce que nous pouvons dire par observation : la boucle de revue est porteuse — rapports et diffs divergent assez souvent pour que lire les deux soit non négociable — et les corrections renvoyées à un agent dont le contexte est encore chaud convergent vite. Si vous reproduisez cela et mesurez correctement les reprises, nous voulons le voir, surtout si cela nous contredit.
Ce que les données plus larges nous ont appris
- L’adoption est un dégradé, pas un interrupteur. Sur l’application drone-ops — plus petite, plus rapide — 18 % des sessions utilisent le patron fable-architect ; sur le monorepo SaaS plus ancien, c’est 9 %. Le projet qui a le plus délégué l’a fait aux deux grains à la fois : des briefs d’implémentation en session et 252 sessions de pipeline déclenchées via le gestionnaire de tickets.
- La flotte de CI n’exécute pas la compétence — parce qu’elle est l’implémenteur. Nos sessions de runner automatisées ne lancent jamais de sous-agent implémenteur, et au début cela ressemblait à une non-adoption. Les prompts disent le contraire : chacune est une étape de pipeline — vérification, revue, évaluation des écarts — et environ six sur dix travaillent sur un ticket ou une PR précis. À l’échelle du projet, les runners de pipeline sont le niveau implémenteur.
- Le niveau le moins cher n’a pas encore eu son premier jour de travail. Les 78+ exécutions d’implémenteur étaient toutes de classe Opus ; le niveau d’édition mécanique Sonnet n’a été ajouté que récemment et n’a pas encore été invoqué. Quelles que soient les économies mesurées ici, elles constituent un plancher.
L’interface, c’est l’essentiel : un brief entre, un diff sort — un ticket entre, une PR sort. Le jour où la hausse de prix tombe, vous changez le maçon, pas le processus.
Divulgation complète. Modèles vérifiés à partir des chaînes des transcriptions, pas supposés. Nous nous sommes corrigés deux fois (un surcomptage de tokens ligne par ligne, puis une table de prix provisoire). Le contrefactuel suppose que l’architecte aurait dépensé les mêmes volumes de tokens que les implémenteurs — les marges d’erreur vont dans les deux sens. Les sessions de pipeline vivent dans un magasin de transcriptions que nos deux premières passes d’exploration n’avaient pas couvert ; une frontière comptable nous a caché un canal de délégation de 9 M de tokens, et le vôtre en cache probablement un aussi. Les projets d’un seul ingénieur, surtout des corrections de revue et du développement de fonctionnalités — pas un benchmark contrôlé. Le corpus s’arrête aussi avant la sortie d’Opus 5 : tous les chiffres ci-dessus concernent Fable comme architecte sur des implémenteurs de classe Opus 4. Les prix des échelons n’ont pas bougé à l’arrivée d’Opus 5, donc les ratios mesurés tiennent — mais voyez la section suivante pour ce qui a bougé.
Mise à jour — l’échelle a bougé sous nos pieds
Opus 5 est sorti après la clôture de ces mesures, et rien n’a changé dans l’échelle des prix : Opus est toujours à 5 $/25 $ par million de tokens d’entrée/sortie, Fable toujours à 10 $/50 $, et le graphique ci-dessus reste correct. Ce qui a changé, c’est la capacité à chaque échelon. Anthropic positionne Opus 5 comme un saut qualitatif sur le raisonnement profond et le travail agentique de longue haleine — c’est-à-dire exactement le travail dont le rôle d’architecte est fait, à la moitié du prix du niveau architecte.
Cela pointe droit vers notre propre nuance sur H2. Si le coût dominant de l’architecte est constitué de lectures de cache, et que les lectures de cache sont facturées à 10 % du prix d’entrée, alors un architecte tournant sur Opus 5 relit son contexte d’orchestration à 0,50 $ par million de tokens au lieu du 1,00 $ de Fable. Le poste qui coûtait 13× tout ce que l’architecte tapait est divisé par deux. Nous n’avons pas mesuré cela — c’est de l’arithmétique sous la même hypothèse de volumes de tokens égaux que celle signalée pour le contrefactuel de 2,1×, et c’est la prochaine chose que nous comptons tester. Si cela se vérifie, la question intéressante cesse d’être quels types de modèles et devient si l’architecte a besoin du plus haut échelon tout court.
Trois choses concernant le nouveau niveau d’implémenteur changent le patron lui-même, pas seulement son prix :
- Il recourt volontiers aux sous-agents — l’inverse de son prédécesseur, qu’il fallait convaincre de déléguer. Un implémenteur qui engendre discrètement ses propres implémenteurs multiplie la facture sans que personne ne regarde. D’où la ligne
Delegation:dans le brief : une tranche indique désormais si elle peut se ramifier, et jusqu’où. - Il vérifie son propre travail sans qu’on le lui demande. Les instructions de vérification écrites pour des modèles plus anciens achètent désormais une seconde passe redondante, elles disparaissent donc des briefs. La boucle de revue de l’architecte reste intacte.
- Il élargit le périmètre.
Out of scope:cesse d’être du texte de remplissage et devient la ligne qui empêche une tranche de déborder.
Et l’échelon que nous n’avons jamais utilisé s’est affûté sans que nous regardions : Sonnet 5 atteint une qualité proche d’Opus sur le travail de codage à 3 $/15 $, avec un tarif de lancement encore plus bas jusqu’à fin août. “Quelles que soient les économies mesurées ici, elles constituent un plancher” était une précaution quand nous l’avons écrit. Cela ressemble aujourd’hui à une litote.
Partie 3 — Où cela nous mène délibérément
Nous nous dirigeons délibérément vers une séparation dans laquelle, selon nous, chaque équipe d’ingénierie finira par être forcée d’entrer : des modèles de pointe coûteux pour le brainstorming, l’architecture et la revue uniquement ; des modèles de plus en plus bon marché pour la programmation elle-même. Aujourd’hui nos implémenteurs sont de classe Opus. Rien ne change dans le flux de travail quand ils deviennent de classe Sonnet, DeepSeek ou Kimi — l’interface est agnostique au modèle par construction. C’est là toute la valeur stratégique : le jour où la subvention prend fin et où la facture double, les équipes dotées de cette discipline changent une ligne de configuration. Celles qui ne l’ont pas renégocient toute leur structure de coûts sous la contrainte.
Fable-architect est un premier petit pas — l’adoption est partielle et le niveau le moins cher n’a pas encore connu sa première exécution. Mais c’est le pas qui construit le muscle : écrire des briefs qui spécifient entièrement une tranche, relire des diffs que vous n’avez pas tapés, traiter l’attention du modèle coûteux comme un budget. Et la vague de refonte montre où mène ce muscle : une fois que les briefs fonctionnent, les tickets fonctionnent, et le modèle coûteux cesse complètement de s’occuper de l’implémentation.
Ce que vous pouvez faire lundi
- Séparez les rôles dans votre harnais d’agent. Une règle au niveau de la session : le modèle de pointe planifie et relit ; déléguez toutes les modifications de fichiers à un agent implémenteur moins cher. Dans Claude Code, c’est une compétence plus des définitions de sous-agents — un après-midi de mise en place.
- Rendez la frontière mécanique. Ajoutez un hook pré-édition qui conteste les écritures de fichiers du modèle coûteux lui-même. Une règle qui ne coûte rien à enfreindre sera enfreinte avant vendredi.
- Rédigez les briefs avec un gabarit fixe. Objectif, contexte, fichiers, conception, contraintes, hors périmètre, budget de délégation, vérification. Le gabarit, c’est la discipline — et le budget de délégation empêche un implémenteur d’embaucher silencieusement les siens.
- Relisez à la fois le rapport et le diff. Ne faites jamais confiance à l’un seul ; relancez les commandes de vérification qui comptent.
- Mesurez votre propre séparation. Vos transcriptions contiennent déjà les données — regroupez par requête, valorisez par modèle et voyez qui tape réellement. Les nôtres nous ont révélé un niveau bon marché inutilisé et un canal de délégation de 9 M de tokens que nous ignorions.
- Élargissez l’interface, des briefs aux tickets. Un brief délègue une heure de travail ; un ticket en délègue une journée. Une fois que vos tickets portent des critères d’acceptation sur lesquels un pipeline peut agir, le modèle coûteux peut verser le travail dans le gestionnaire de tickets et superviser au lieu de rester dans la boucle pour chaque tranche.
- Gardez une porte de sortie chaude. Faites tourner un modèle bon marché ou ouvert comme implémenteur sur une tranche à faible risque par semaine. Une portabilité que vous n’exercez jamais est une portabilité que vous n’avez pas.
- Revalorisez l’architecte, pas seulement le maçon. Chaque sortie de modèle déplace les échelons sans déplacer l’échelle. Si l’essentiel de vos dépenses d’architecte est du contexte plutôt que de la frappe, un niveau architecte moins cher vaut plus qu’un niveau implémenteur moins cher — vérifiez lequel vos propres transcriptions disent que vous achetez.
Les laboratoires continueront de nous dire que leurs meilleurs modèles valent n’importe quel prix, et — c’est exaspérant — pour le travail de jugement, ils ont en grande partie raison. La solution n’est pas de s’abstenir. Elle est d’arrêter de payer des prix de pointe pour des boucles for.
