


La versione breve
- Ho preso un vero issue dal backlog di FlowHunt e ho fatto implementare a Claude Code 13 volte su Opus 5.5, con sette diverse configurazioni di istruzioni. Ogni esecuzione è partita dallo stesso commit, in un clone proprio con il proprio database, ed è passata attraverso la nostra CI reale su GitHub. Due revisioni in cieco di Opus hanno valutato ogni risultato.
- Il CLAUDE.md da 33 KB del repository non ha comprato qualità misurabile. Le esecuzioni che lo avevano hanno ottenuto 2,0 rilievi bloccanti e maggiori per revisione. Un’esecuzione senza alcun file di istruzioni ha ottenuto lo stesso. Un file da 5,5 KB ha ottenuto 1,0.
- Una fase di pianificazione separata ha peggiorato le cose. Entrambe le configurazioni che eseguivano un prompt di pianificazione e poi un prompt di implementazione sono costate più dei loro gemelli con prompt semplice, e hanno prodotto quattro dei cinque bloccanti su tutte le 26 revisioni.
- Il vincitore è stato un CLAUDE.md da 8 KB, tre skill, lavoratori Sonnet e un prompt semplice. Le sue due esecuzioni sono costate in media 6,68 $ al prezzo di listino delle API. La configurazione completa con i prompt di pipeline è costata in media 11,49 $, circa 1,7 volte tanto, e ha avuto più rilievi.
- Ciò che è sopravvissuto di tutta la struttura che avevo costruito è il brief: una descrizione breve e già decisa di una fetta di lavoro che il modello principale scrive per un lavoratore più economico. I piani per il modello principale stesso non hanno ripagato. Il modello pianifica bene da solo.
Questo segue il post sul pattern architect , che misurava chi dovrebbe scrivere il codice. Questo qui chiede quanto bisogna dire al modello principale prima che inizi.
Perché l’ho fatto
Il nostro monorepo aveva accumulato molte istruzioni per gli agenti. Il CLAUDE.md di root era di 33 KB: comandi di build, cadenza dei test, stile del codice, architettura, percorsi critici, regole di sicurezza, regole su permessi e crediti, le due superfici agente, apertura di issue, convenzioni per le PR. Sotto .claude/skills/ c’erano dieci skill. In più, la nostra pipeline CI (la chiamiamo harnext) faceva passare un issue attraverso un tagger, uno step di triage, uno step di pianificazione che scriveva un piano come commento dell’issue e uno step di implementazione che rileggeva il piano e scriveva il codice, ognuno con il proprio lungo system prompt.
Ogni riga era stata aggiunta per una ragione, di solito dopo che un agente aveva sbagliato qualcosa. La domanda che nessuno aveva posto era se servisse ancora. Un CLAUDE.md viene caricato in ogni sessione e rinviato a ogni turno. Se il modello avrebbe comunque fatto la cosa giusta, quei token sono una tassa, e come spiega quanto costa una finestra di contesto , una tassa su ogni turno si accumula più in fretta di quanto sembri.

Pronto a far crescere il tuo business?
Inizia oggi la tua prova gratuita e vedi i risultati in pochi giorni.
Il test
L’issue riguardava una sequenza email temporizzata per le nuove iscrizioni: un amministratore definisce passi come “giorno 0: benvenuto” e “giorno 5: la tua prova sta per finire”, e un task in background invia una mail a ogni account nel giorno giusto, si ferma quando la persona acquista un piano a pagamento e salta gli account creati prima del lancio. Richiede una migrazione, un repository, un service, un task Celery beat, endpoint REST, tool MCP per gli agenti e una UI di console in 11 lingue. È una feature realistica da prima settimana, e ha diversi edge case facili da mancare.
Ogni esecuzione era una sessione headless di Claude Code su Opus 5.5, isolata nel proprio clone e database, con uno script che spingeva il suo commit su una PR in bozza e rimandava il risultato della CI nella sessione, fino a tre round. Il costo è il total_cost_usd di Claude Code stesso per la sessione principale più ogni subagente, al prezzo di listino delle API. Io pago un abbonamento, quindi questa è una misura del lavoro, non della mia fattura.
Le sette configurazioni:
| Configurazione | Esecuzioni | |
|---|---|---|
| A | CLAUDE.md completo da 33 KB e dieci skill, prompt di pipeline (pianifica, poi implementa) | 2 |
| B | CLAUDE.md e skill completi, prompt semplice | 3 |
| C | Nessun CLAUDE.md, nessuna skill, prompt semplice | 2 |
| D | CLAUDE.md completo più la skill architect, prompt semplice | 2 |
| E | CLAUDE.md da 8 KB, architect, grain-ponytail e unslop, prompt di pipeline | 1 |
| F | CLAUDE.md da 5,5 KB, nessuna skill, prompt semplice | 1 |
| G | CLAUDE.md da 8 KB, architect, grain-ponytail e unslop, prompt semplice | 2 |
Da A a D sono venute prima. Da E a G sono state costruite su ciò che avevano mostrato, e la terza esecuzione di B è andata insieme a loro come controllo. Il file da 8 KB è quello da 5,5 KB più una breve lista delle skill e di quando caricarle, e le regole di routing dei modelli che fanno delegare la skill architect a Sonnet.
Ogni risultato è poi andato a due revisori Opus che vedevano solo una lettera, il diff, il repository e l’issue. Elencavano ogni modifica che avrebbero chiesto prima di approvare, classificandola come bloccante, maggiore, minore o dettaglio, e verificavano ogni criterio di accettazione rispetto a un file e a una riga.
Costo
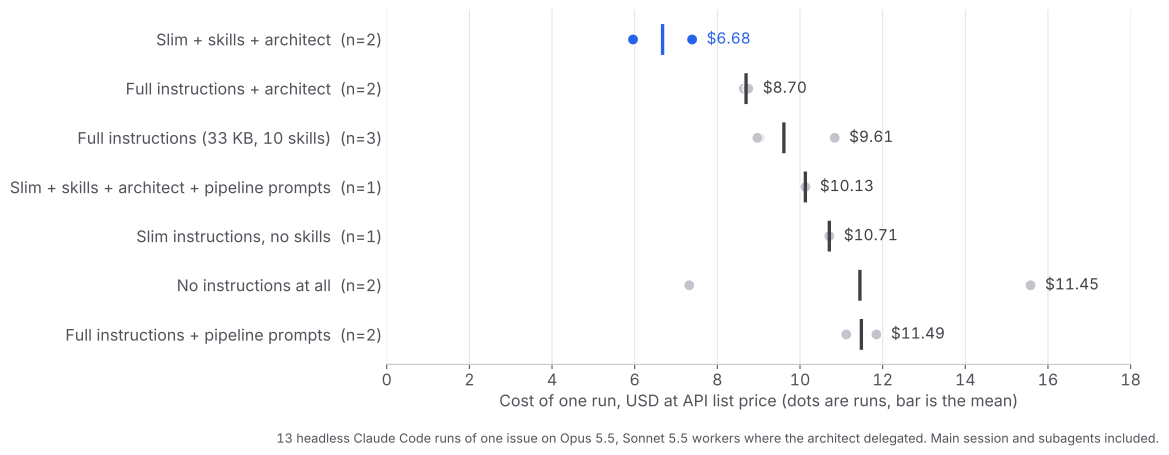
La configurazione vincente, G, è costata 5,96 $ e 7,39 $. La configurazione completa con prompt di pipeline, A, è costata 11,12 $ e 11,85 $. Il divario è soprattutto nei turni e in ciò che ogni turno porta con sé. Le sessioni principali di A hanno fatto 172 e 144 turni su Opus con 24-28 milioni di token di input. Quelle di G ne hanno fatti 79 e 95 con 13-16 milioni, e hanno passato circa 60 turni in più ai lavoratori Sonnet, che costano una frazione della tariffa. G ha anche finito il lavoro in circa 21 minuti contro i 45 di A.
Due cose in questo grafico mi hanno sorpreso. Nessuna istruzione non è affatto l’opzione economica: le sue due esecuzioni sono costate 7,32 $ e 15,58 $, e quella più cara ha anche fallito la CI e scritto il diff più grande del test. E il file da 5,5 KB senza skill, F, non è stato più economico della configurazione completa. Ha scritto più codice, 1.601 righe di prodotto, e l’ha pagato. Il risparmio di G non viene dal solo file corto. Viene dal file corto più le due skill che cambiano come si fa il lavoro.
Iscriviti alla nostra newsletter
Ricevi gratuitamente gli ultimi consigli, tendenze e offerte.
Qualità
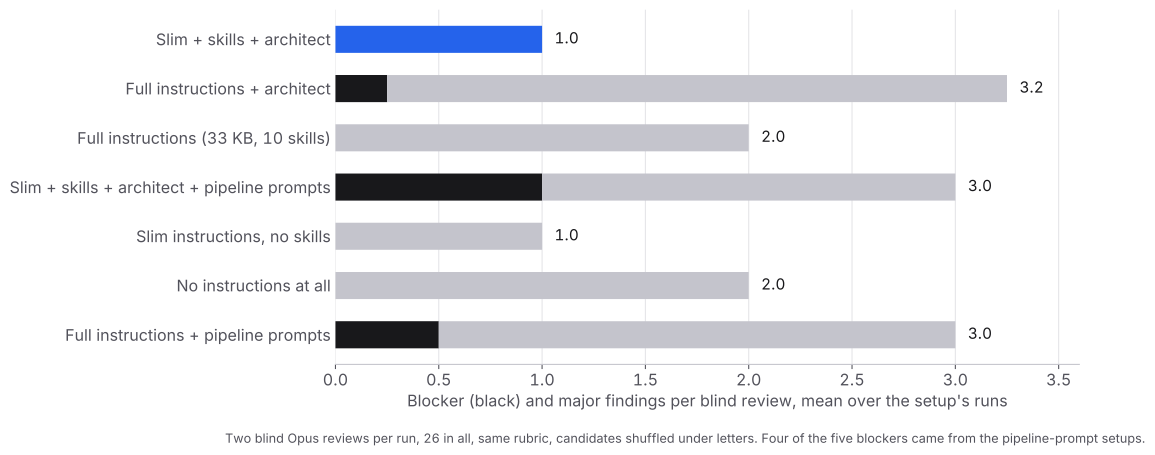
La configurazione più economica ha anche avuto il minor numero di rilievi seri: nessun bloccante e 1,5 e 0,5 rilievi maggiori per revisione nelle sue due esecuzioni. Il CLAUDE.md completo, B, si è fermato a 2,0 maggiori in tutte e tre le sue esecuzioni, esattamente come nessun CLAUDE.md.
Questo è il risultato che mi interessa di più. Il file ha lunghe sezioni su sicurezza, permessi e crediti, scritte perché un agente una volta le aveva saltate. Con o senza il file, i revisori hanno trovato lo stesso numero di problemi seri, e gli stessi tipi sono ricomparsi tra le configurazioni: un iscritto che paga e poi annulla, un’email persa o inviata due volte quando un lavoratore fallisce a metà, un editor che sovrascrive contenuto che non riesce a mostrare. Sono lacune di ragionamento sullo stato nel tempo. Nessuna lista di regole nel CLAUDE.md le copriva, perché non puoi scrivere una regola per un edge case a cui non hai ancora pensato.
Ciò che invece le ha coperte è stata una modifica alla skill architect tra i round. Prima di scrivere qualunque brief, il modello principale ora scrive una tabella: ogni criterio di accettazione, cosa succede quando lo stato da cui dipende cambia nel tempo, e il comportamento deciso. Ogni riga entra poi nel brief con un test nominato. Le esecuzioni di G hanno scritto 774 e 818 righe di test, contro 510-670 per B.
La fase di pianificazione
A ed E sono le due configurazioni che eseguivano i prompt della nostra pipeline CI: un prompt di pianificazione che scrive un piano, poi un prompt di implementazione che legge il piano e lo esegue. Confrontiamo ciascuna con il suo gemello che ha invece ricevuto un prompt semplice. A è costata 11,49 $ a esecuzione contro i 9,61 $ di B e ha avuto bloccanti dove B non ne aveva. E è costata 10,13 $ contro i 6,68 $ di G e ha avuto un bloccante in ognuna delle sue revisioni dove G non ne aveva.
Penso che la ragione sia che un piano è un documento che il modello scrive per sé stesso e poi deve rileggere come un’istruzione esterna. La seconda sessione tratta il piano come una specifica, lo segue dove è sbagliato e spende turni a riconciliarlo con ciò che trova nel codice. Un modello così capace pianifica meglio dentro la sessione che sta per fare il lavoro, dove piano e codice sono nello stesso contesto.
La parte della pianificazione che è sopravvissuta è il brief. Quando il modello principale affida una fetta a un lavoratore Sonnet, il lavoratore parte con un contesto vuoto e costruisce esattamente ciò che gli viene detto. Quel passaggio richiede una descrizione scritta e già decisa: l’obiettivo, i file, il pattern da rispecchiare, gli edge case, il test da scrivere. Un piano per sé stessi è un costo inutile. Un brief per qualcun altro è l’unico modo per trasmettere il lavoro.
Cosa ha fatto grain-ponytail
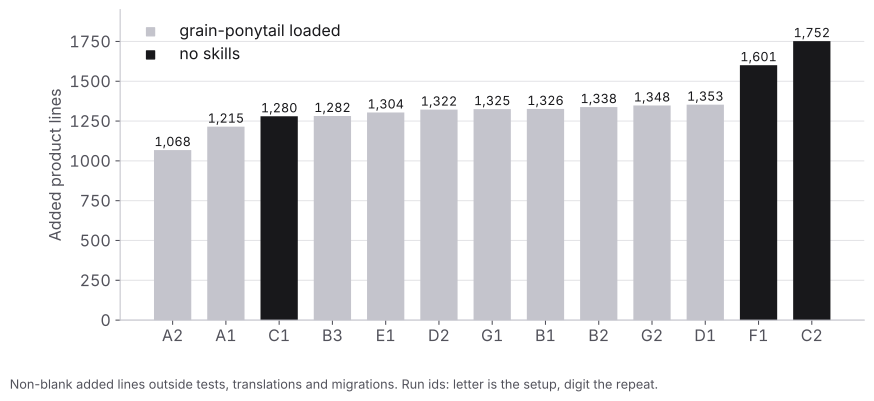
La skill di codice secondo la vena dice al modello di rispecchiare l’esempio esistente più vicino e di rilasciare il minimo codice che funziona. Ogni esecuzione che la aveva caricata ha scritto tra 1.068 e 1.353 righe di prodotto. I due diff più grandi, 1.601 e 1.752, sono venuti da esecuzioni senza skill. Un’esecuzione senza skill è rimasta a 1.280, quindi la skill non decide da sola la dimensione, ma ha eliminato la coda.
È anche il caso più chiaro di quale tipo di istruzione ripaga ancora. “Rispecchia l’esempio più vicino” cambia ciò che il modello fa su ogni file che scrive. “Usa snake_case per le funzioni” ripete qualcosa che già fa.
Cosa hanno comunque trovato le revisioni
L’esecuzione vincente non era pulita. Dopo il test ho fatto rebase del lavoro di G2 su main e l’ho fatto passare attraverso il nostro controllo PR completo, che revisiona il diff, dimostra ogni rilievo con un test che fallisce e guida la modifica in un browser reale. Ha trovato che l’editor dei passi eliminava ogni blocco tranne il primo HTML quando un amministratore modificava un passo creato via MCP, e che un rilascio di claim fallito poteva inviare la mail due volte ad alcuni utenti. Entrambe le cose sono state corrette, con i test, prima che la PR andasse in revisione umana.
I revisori in cieco hanno anche segnalato più over-engineering nelle esecuzioni con architect che in quelle con istruzioni complete: 2,5 voci per revisione per G contro 0-1,0 per le esecuzioni di A e B. Meno rilievi seri, più dettagli. Accetterei questo scambio, ma è pur sempre uno scambio.
Cosa ho cambiato
- Il CLAUDE.md da 33 KB è diventato un AGENTS.md da 12 KB che legge anche Codex, e CLAUDE.md ora lo importa soltanto. Conserva i comandi, la cadenza dei test, l’architettura e le regole che un modello non può dedurre dal codice, come quali percorsi sono critici e che le due superfici agente devono restare allineate.
- La fase di pianificazione è sparita dalla pipeline. Il triage passa l’issue direttamente a uno step di implementazione il cui prompt si è ridotto a sei passi: leggi l’issue, crea il branch, carica le skill architect e grain-ponytail, testa, committa, apri una PR in bozza.
- La skill architect ha guadagnato la tabella degli edge case, un campo Tests nel brief e un passaggio finale che verifica l’intero diff rispetto all’issue invece che rispetto ai brief. Quella versione è pubblica su github.com/LivinTribunal/architect-skill .
La modifica al repository è in revisione al momento in cui scrivo.
Cosa portarsi a casa
Se il tuo CLAUDE.md è cresciuto un incidente alla volta, probabilmente sta pagando per regole che il modello già segue. Riducilo a ciò che il modello non può scoprire leggendo il codice, e misura prima e dopo su un compito reale invece di fidarti dell’idea che più indicazioni siano più sicure.
Tieni le istruzioni che cambiano come si fa il lavoro: chi scrive il codice, come si produce il brief di una fetta di lavoro, quale pattern esistente copiare. Elimina la pipeline pianifica-poi-esegui se il tuo modello principale è un frontier attuale. Scrivi brief per i lavoratori, non piani per te stesso.
Metodo
13 esecuzioni headless di Claude Code 2.1.289 il 5 ottobre 2026, modello principale Opus 5.5, lavoratori Sonnet 5.5 dove la skill architect delegava. Tutte le esecuzioni sono partite da un commit del monorepo FlowHunt, ciascuna in un clone APFS con il proprio database Postgres, isolata dalle altre esecuzioni e dai file dell’esperimento stesso. Un broker spingeva il commit di ogni esecuzione su una PR in bozza contro un branch base congelato e riprendeva la sessione con il risultato della CI, fino a tre round. Il costo è il total_cost_usd massimo per sessione, sommato sulla sessione principale e sui suoi subagenti. Le righe di prodotto sono righe aggiunte non vuote al di fuori di test, traduzioni e migrazioni.
Ogni risultato ha ricevuto due revisioni in cieco di Opus con un’unica rubrica: correttezza, criteri di accettazione, aderenza alla vena del codice, campi privati e stato nascosto, over-engineering, sicurezza e permessi, test, migrazioni. I candidati sono stati mescolati sotto lettere, e i revisori potevano leggere il repository ma non eseguire nulla. I rilievi per revisione sono mediati sulle esecuzioni di una configurazione. Con una a tre esecuzioni per configurazione, considerate rumorosa la media di una singola configurazione. Le conclusioni sopra sono quelle che hanno tenuto in entrambi i round.
