


La versione breve
- Gli agenti di coding AI sono bravi ad aggiungere codice e pessimi nel notare che il codice esiste già. Lasciati soli regalano a un repository un secondo helper per ogni primo, e ogni lettore deve controllare entrambi per fidarsi di uno dei due.
- La soluzione sono due abitudini messe per iscritto perché un agente le segua. Grain: trova l’esempio esistente più vicino dello stesso tipo di cosa e rispecchiane forma, posizione e nomi. Ponytail: sali una scala da “deve esistere davvero” a “il minimo che funziona” e fermati al primo piolo che regge.
- Entrambe sono ora una skill pubblica, con licenza MIT: grain-skill su GitHub . Contiene le regole di scrittura, un passaggio di review con tag fissi e la forma della riga finale che spinge l’agente a dichiarare cosa ha rispecchiato.
- Nel nostro repository principale da agosto: 386 issue e pull request portano un commento di pianificazione che nomina l’esemplare da rispecchiare, su 1.333 commit in un albero di circa 18.000 file. 35 punti nel codice portano un commento
ponytail:che nomina una semplificazione deliberata e il suo percorso di upgrade. - La scoperta scomoda: l’agente ha invocato la skill come skill zero volte. Le regole hanno funzionato perché le ho messe anche nel CLAUDE.md del progetto, nelle definizioni degli agenti worker e nella checklist di review. Metti la regola dove l’agente legge già.
Ho già scritto di questo una volta e il risultato non mi è piaciuto, perché descriveva il principio e non il meccanismo. Questa è la versione con il meccanismo.
Il fallimento per cui esiste
Tre esempi dal nostro backend, tutti reali, tutti da pull request scritte da agenti che avevano passato i loro test.
Una nuova route REST che pescava il servizio applicativo direttamente da una factory. Ogni route sorella nel repository va da route a controller a servizio a repository, con ogni salto iniettato. Questa aveva collassato la catena a route → servizio. Funzionava. Significava anche che l’unico posto dove vivono la validazione della richiesta e la costruzione della risposta per quella funzionalità non esisteva, e che il prossimo agente a toccare la funzionalità avrebbe avuto due forme tra cui scegliere.
Un servizio sovradimensionato diviso in _payloads.py, _protocol.py e _tokens.py, ognuno un modulo di async def nudi, con il servizio che chiamava protocol.discover(...) via import. Il controllo sulla lunghezza dei file è diventato verde. La cosa che la dependency injection esiste per prevenire è tornata subito: un collaboratore scelto al momento dell’import, non sostituibile senza fare patching del modulo, assente dal costruttore che documenta da cosa dipende il servizio.
Un secondo normalizzatore. Ce n’era già uno. L’agente non l’ha trovato, ne ha scritto un altro da otto righe che faceva quasi la stessa cosa, e ora due funzioni con comportamenti diversi sui casi limite pretendono entrambe di canonicalizzare lo stesso campo.
Nessuno di questi è un bug nel senso che un test cattura. Ognuno è un agente che sceglie il codice che sapeva generare invece del codice che esisteva. Fallo su qualche centinaio di pull request e il repository smette di avere una forma.

Pronto a far crescere il tuo business?
Inizia oggi la tua prova gratuita e vedi i risultati in pochi giorni.
Grain
Il nuovo codice dovrebbe essere indistinguibile dal codice che lo circonda. La skill trasforma quella frase in cinque passi che un agente compie prima di scrivere.
Prima trova l’esemplare. Per un endpoint, un servizio, un repository, un query hook, una slice di store o un componente, individua quello esistente più vicino e copiane forma, posizione del file e nomenclatura. Non inventare struttura quando esiste un pattern. Nel nostro repository la slice branding è l’esemplare nominato per il backend perché è piccola, pulita e attraversa ogni layer, e la tabella della skill dice, per ogni tipo di artefatto, quale file aprire e cosa rispecchiare.
Rispetta i layer. La presentazione chiama l’applicazione, l’applicazione chiama il dominio, e l’infrastruttura implementa il dominio. Un nuovo import che attraversa quelle linee fa fallire il controllo di architettura. Leggi il documento sui layer, non ri-derivarlo.
Grain locale contro grain del repository. Allineati alle tue sorelle. Ma se le sorelle stesse divergono dalla catena canonica, segui la catena canonica e annota la divergenza invece di copiare la deriva. “È coerente con le altre cinque route in questo file” non basta se tutte e sei saltano un layer che la slice canonica usa. Hai confrontato troppo in locale.
Riusa l’helper canonico. Se un helper, un tipo o un pattern vive già nel repository, usalo. Due normalizzatori obbligano ogni lettore a fare il diff di entrambi.
I nomi portano significato. Riusa il vocabolario già presente nel codice. Un nuovo nome per un concetto esistente è un bug in attesa di un lettore.
Il test finale è quello che do ai reviewer: se riesci a capire quali righe ha scritto l’agente solo dalla loro forma, ha combattuto contro il grain.
Ponytail
Pigro significa efficiente, non negligente. Il codice migliore è il codice mai scritto. Comprendi prima a fondo il problema, ogni file che la modifica tocca, il vero flusso end-to-end, e poi sali questa scala e fermati al primo piolo che regge.
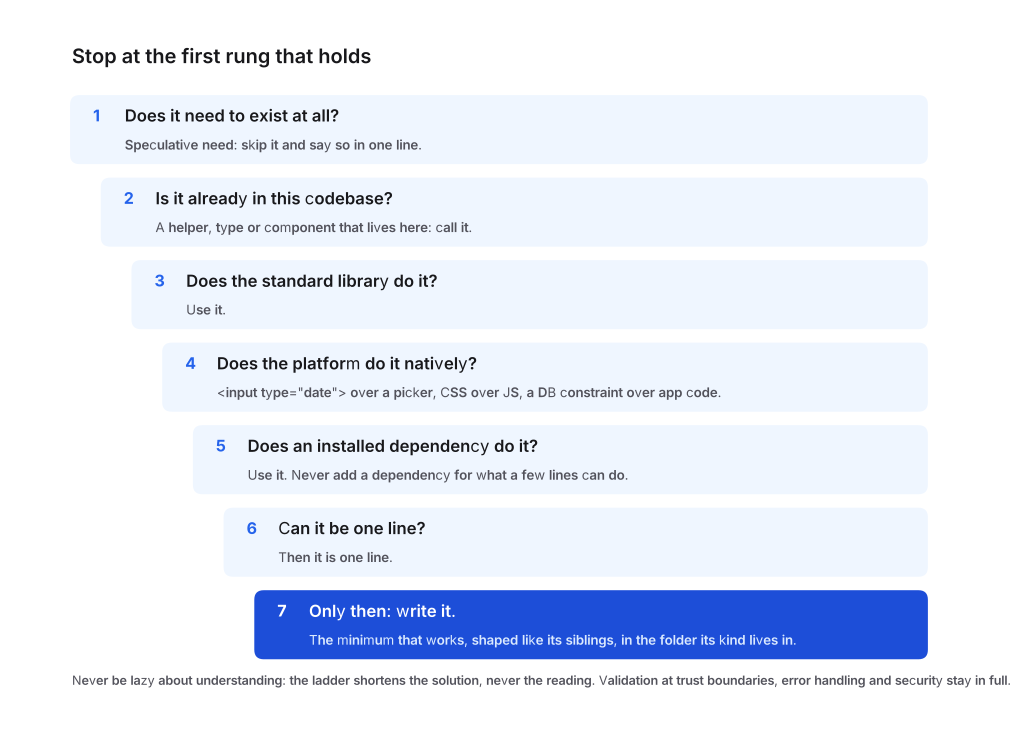
Due regole viaggiano insieme alla scala.
Una correzione di bug è una causa radice, non un sintomo. Un ticket nomina un sintomo. Fai grep su ogni chiamante della funzione che stai per toccare. Una guardia nella funzione condivisa è un diff più piccolo di una guardia in ogni chiamante, e correggere solo il percorso che il ticket nomina lascia rotti i chiamanti sorelle.
Tieni il diff minimo. Il diff è ciò che la review legge. Nessun refactoring di passaggio, nessun rename, nessuna riformattazione, nessun miglioramento “già che sono qui”, nessun toccare file che l’attività non richiedeva. Ognuno di questi seppellisce la vera modifica. Se il diff è più grande del problema, riducilo. I miglioramenti che hai notato sono una issue successiva, non commit extra su questo branch.
E i limiti, perché “pigro” è la parola che rischia più di essere fraintesa. Non semplificare mai via la validazione dell’input a un confine di fiducia, la gestione degli errori che previene perdita di dati, la sicurezza, le basi dell’accessibilità o qualsiasi cosa l’utente abbia chiesto. Non essere mai pigro nella comprensione: la scala accorcia la soluzione, mai la lettura. Un diff piccolo nel posto sbagliato è un secondo bug. La logica non banale lascia dietro di sé un controllo eseguibile, la cosa più piccola che fallisce se la logica si rompe.
Quando l’agente sceglie un piolo di proposito e conosce il tetto, lo dichiara nel codice:
# ponytail: lock globale, lock per account se il throughput conta
Ce ne sono 35 nel nostro repository ora. Ognuno è una decisione che un lettore futuro altrimenti dovrebbe ricostruire, e un segnaposto su dove guardare quando si tocca il tetto.
Iscriviti alla nostra newsletter
Ricevi gratuitamente gli ultimi consigli, tendenze e offerte.
Far sì che un agente lo faccia davvero
Un principio in un documento non è un comportamento. Tre meccanismi hanno trasformato questi due in comportamenti, e li ordinerei in questo modo.
Il brief porta con sé l’esemplare. In il pattern dell’architetto il modello principale scrive un brief per un worker, e il campo Design del brief nomina il pattern esistente più vicino da rispecchiare e la modifica minima di causa radice. Il worker non deve trovare il grain. Gli viene consegnato. Nel nostro repository è questo che sono i 491 commenti di pianificazione su 386 issue e pull request: un passo di pianificazione che nomina cosa rispecchiare prima che qualcuno scriva.
L’agente chiude con ciò che ha rispecchiato. Il report di ogni implementatore termina con una riga, mirrored: <path>, oppure nomina il nuovo pattern e perché nessuna sorella andava bene. Costa poco ed è il miglior aiuto alla review che abbia aggiunto. Una riga mirrored: che punta al tipo di file sbagliato ti dice che il diff è sbagliato prima che tu lo apra. Una riga mancante ti dice che l’agente non ha guardato.
La review fa rispettare la stessa asticella, in un ordine fisso. La nostra skill di review ha due passaggi con tag fissi, e sono i tag a rendere i risultati comparabili tra reviewer e tra agenti.
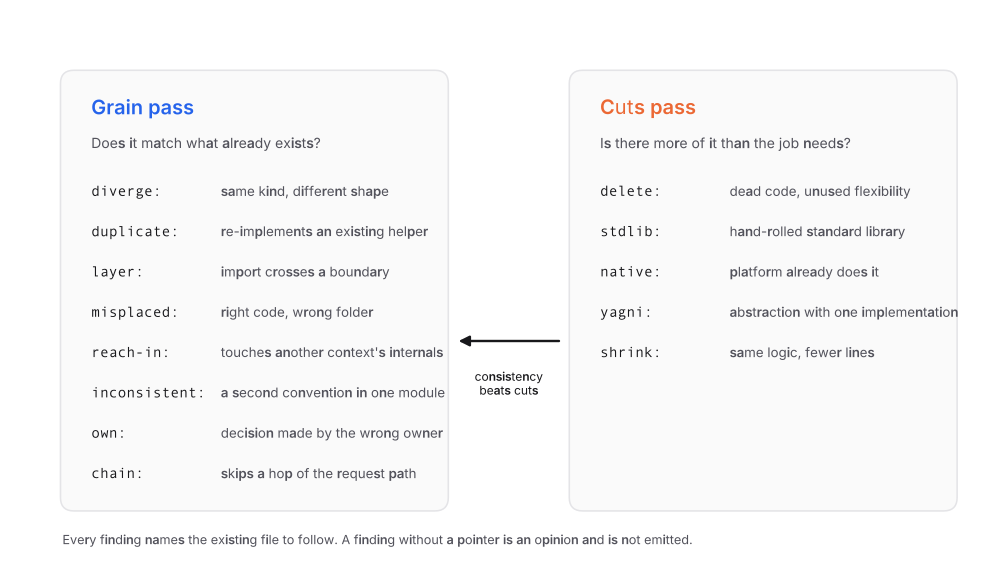
Prima la struttura. Questo diverge dall’esemplare più vicino, duplica un helper esistente, attraversa un layer, sta nel posto sbagliato, va a leggere nelle viscere di un altro modulo, usa nomi incoerenti, si prende la proprietà di qualcosa che dovrebbe iniettare o rompe la catena di chiamata canonica? Poi i tagli. Cosa si potrebbe eliminare, sostituire con la standard library, sostituire con una funzionalità nativa, scartare come speculativo o ridurre?
L’ordine è una regola, non una preferenza. La coerenza batte i tagli. Un taglio che lascia il codice divergente dalle sue sorelle non è una vittoria, perché ora il lettore deve imparare due forme per risparmiare otto righe. Fai girare prima la struttura e il passaggio sui tagli tocca solo codice che già combacia.
Cosa è successo nel repository, inclusa la parte che non ha funzionato
Dal 1° agosto il nostro repository principale ha preso 1.333 commit, la maggior parte scritti da agenti sotto review. 386 delle issue e pull request di quel periodo portano un commento di pianificazione che nomina l’esemplare da rispecchiare, 491 commenti di questo tipo in totale. La catena canonica è la forma predefinita di un nuovo endpoint, e le due route legacy che saltano il controller sono elencate nel documento come una divergenza in fase di dismissione, non come un secondo stile.
I 35 commenti ponytail: sono un numero più piccolo di quanto mi aspettassi e penso sia giusto così. La maggior parte delle semplificazioni non merita un commento. Quelle che lo meritano sono quelle con un tetto.
Ora la parte che preferirei non riportare. Ho pubblicato grain e ponytail come skill di Claude Code: una descrizione nell’indice delle skill, un corpo che si carica su richiesta e una riga nel CLAUDE.md che dice di invocarla prima di scrivere codice. In cinque settimane di trascrizioni l’agente l’ha invocata per nome zero volte. La riga finale mirrored: è comparsa in sette risposte.
Le regole sono comunque attecchite. Sono attecchite perché lo stesso testo era anche in tre posti che l’agente legge senza scegliere di farlo: il CLAUDE.md del progetto, che è nel contesto fin dal primo turno; le definizioni degli agenti worker, che dicono “rispecchia forma, posizione e nomenclatura dell’esempio esistente più vicino” e “punta alla soluzione più pigra che funzioni davvero” come regole, non come una skill da considerare; e la checklist di review, i cui tag fanno fallire una pull request che li ignora. Il corpo della skill è diventato il riferimento canonico verso cui quei tre puntano. Come trigger, non ha fatto nulla.
Quindi la lezione che passerei a chiunque impacchetti convenzioni per un agente è questa. Una skill è un buon posto per la versione lunga di una regola. È un cattivo posto per la regola stessa, perché l’agente deve decidere di caricarla e nella maggior parte dei casi non lo farà. Metti la versione di un paragrafo nel file che è sempre nel contesto, metti la versione imperativa nella definizione dell’agente che scrive il codice e metti il controllo nella review che fa da gate al merge. Poi fai puntare tutti e tre alla skill per il dettaglio.
La versione pubblica su github.com/LivinTribunal/grain-skill è strutturata così: un breve SKILL.md con le regole che un agente può tenere in testa, il documento completo con la scala e gli anti-pattern, i tag di review e un README che dice quale paragrafo va nel tuo CLAUDE.md e quale va nella definizione del tuo implementatore. Sostituisci l’esempio pratico con il tuo esemplare canonico e il gioco è fatto.
