


La versione breve
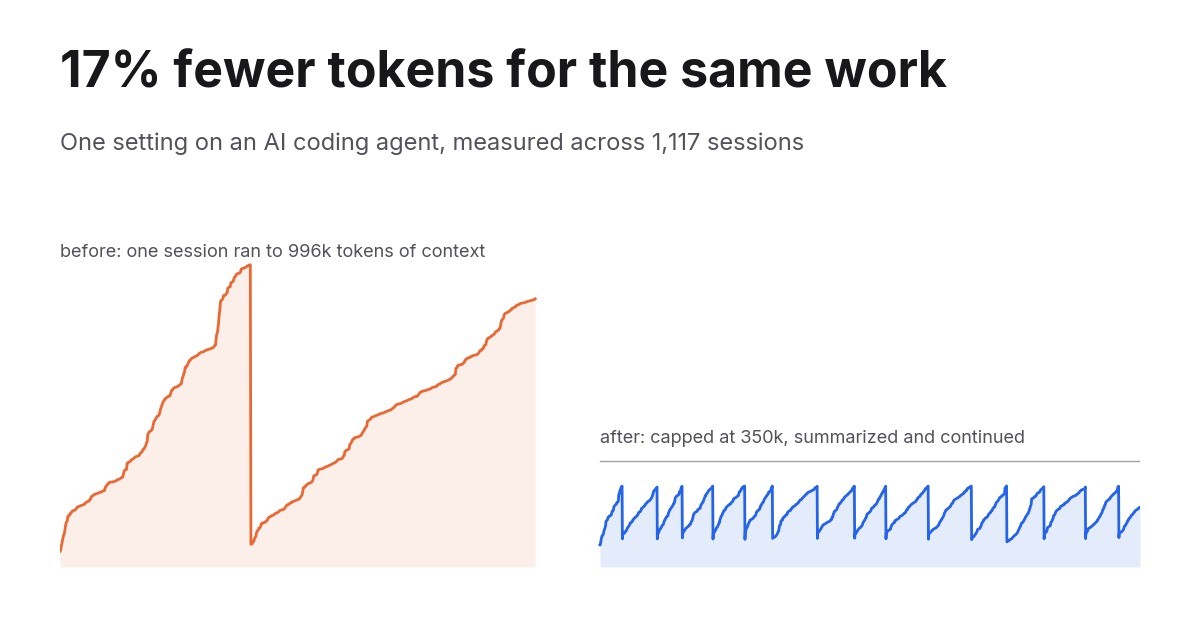
- Uso un agente di coding AI tutto il giorno su un modello con una finestra di contesto da 1M di token. Le sessioni crescevano finché quasi la riempivano.
- Ho aggiunto una riga alla sua configurazione, limitando una sessione a 350.000 token di contesto prima che si riassuma da sola e continui.
- Misurato su 1.117 trascrizioni di sessione: 17% di token in meno a parità di prompt, e nelle sessioni lunghe in cui il limite entra davvero in azione, 55% in meno.
Di seguito il metodo, tutti i grafici e quanto ti costa in cambio, così puoi decidere se si applica al tuo setup.
Perché una finestra da 1M costa più di quanto sembri
Una conversazione con un modello è stateless. Ogni richiesta porta con sé l’intera cronologia: il system prompt, ogni definizione di tool, ogni file che l’agente ha letto, ogni risultato di tool, ogni messaggio. Non un delta. Tutto, ogni volta.
Quindi una sessione cresciuta fino a 900.000 token paga 900.000 token di input alla chiamata successiva, e a quella dopo ancora. Il turno 400 non fa più lavoro del turno 4. Costa semplicemente molte volte di più.
Il prompt caching attenua questo effetto. I token che il modello ha già visto vengono fatturati a circa un decimo del prezzo di input normale. Quello sconto è reale, è ciò che rende sostenibili le sessioni lunghe, ed è anche il motivo per cui nessuno guarda il problema. Nei miei dati, il 98% di tutti i token di input erano letture da cache. Un decimo di un numero molto grande restava comunque la voce più alta della fattura.
La domanda non è se la tua cronologia è in cache. È quanto grande le è permesso diventare prima che qualcosa la azzeri.

Pronto a far crescere il tuo business?
Inizia oggi la tua prova gratuita e vedi i risultati in pochi giorni.
Cosa ho cambiato
L’agente è Claude Code che esegue Opus sulla finestra di contesto da 1M. L’impostazione è autoCompactWindow in ~/.claude/settings.json. Quando una sessione raggiunge quel numero di token, l’agente riassume la conversazione e continua dal riassunto.
{
  "autoCompactWindow": 350000
}
Non l’avevo mai impostata, quindi le sessioni andavano avanti finché non si avvicinavano alla finestra piena. In quattro giorni ho provato tre valori:
| Data | Impostazione |
|---|---|
| 14 settembre | 250.000 |
| 15 settembre | 300.000 |
| 18 settembre | 350.000 |
Come l’ho misurato
Claude Code scrive ogni sessione in una trascrizione JSONL sotto ~/.claude/projects/, incluso l’utilizzo di token di ogni chiamata API. Le ho analizzate tutte e 1.117, coprendo cinque settimane dal 19 agosto al 22 settembre, deduplicate per ID di richiesta, e ho tenuto solo le sessioni interattive. Le esecuzioni in GitHub Actions usano lo stesso account ma non possono essere influenzate da un’impostazione sul mio laptop, quindi sono escluse.
I totali grezzi di token sono fuorvianti da soli. Una settimana intensa batte una settimana tranquilla, qualunque cosa tu cambi. Quindi ogni numero qui sotto è ponderato per la cache, che è ciò che il contatore legge davvero: input fresco a 1x, scritture in cache a 1,25x (cache da 5 minuti) o 2x (cache da 1 ora), letture da cache a 0,1x. E ogni confronto è normalizzato per il lavoro svolto, ossia i prompt che ho digitato o le chiamate API che l’agente ha fatto.
Iscriviti alla nostra newsletter
Ricevi gratuitamente gli ultimi consigli, tendenze e offerte.
Due sessioni, stesso agente
Questo è il meccanismo in un’unica immagine. A sinistra, una sessione reale del 3 settembre, prima del limite. A destra, una sessione reale del 15 settembre, dopo.
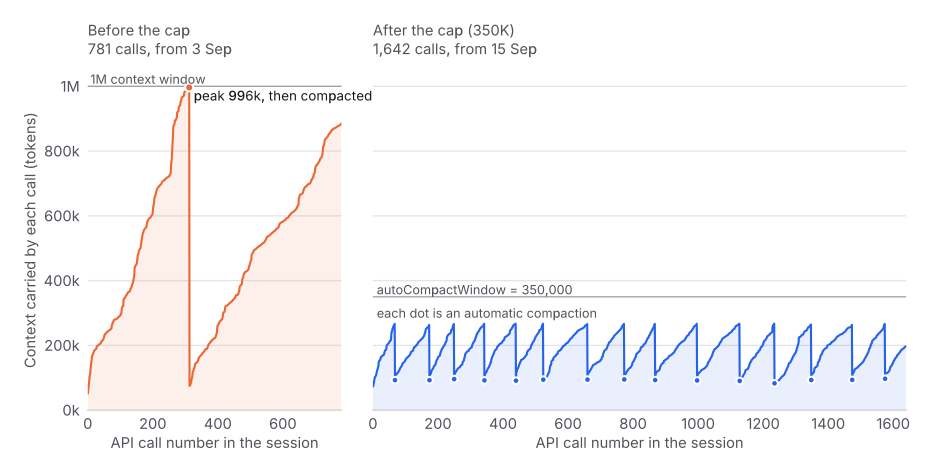
La sessione a sinistra è durata 781 chiamate. È salita a 996.000 token di contesto, ha sbattuto contro il muro della finestra da 1M, si è compattata una volta e poi è risalita dritta a 880.000. Per la seconda metà di quella sessione, ogni singola chiamata rileggeva più di mezzo milione di token.
La sessione a destra è durata 1.642 chiamate, più del doppio, e non ha mai portato più di 270.000. Si è compattata quindici volte. Ogni compattazione è un punto.
I numeri settimanali
Solo sessioni interattive. Le barre sono i token di input ponderati per la cache per chiamata API, che è il singolo numero più equo perché non gli importa quanto ho lavorato in una data settimana.
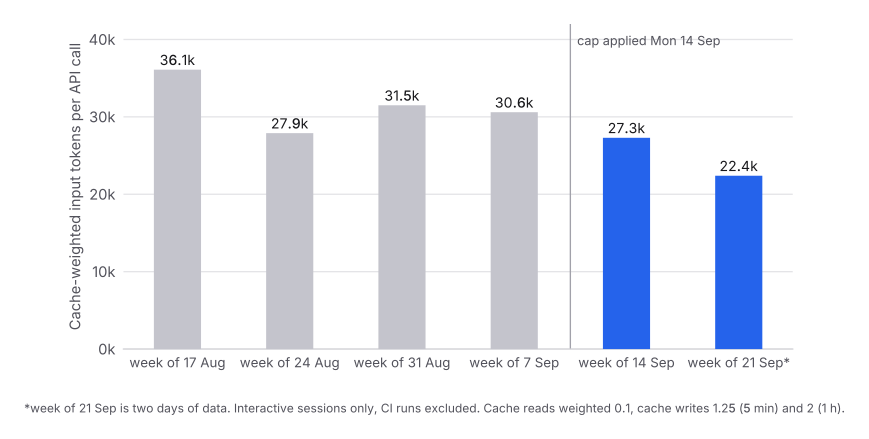
Il confronto più pulito nel dataset è la settimana del 7 settembre contro quella del 14 settembre, perché non le ho scelte io. Sono semplicemente capitate ai due lati del cambiamento, e in ciascuna ho digitato quasi esattamente lo stesso numero di prompt.
| Settimana del | Prompt | Chiamate API | Input ponderato per cache | Per chiamata |
|---|---|---|---|---|
| 7 set | 971 | 11.364 | 348,1M | 30,6k |
| 14 set | 968 | 10.555 | 288,5M | 27,3k |
971 prompt contro 968. Input effettivo sceso da 348,1M a 288,5M. Sono il 17% in meno a parità di prompting. I due giorni della settimana successiva sono arrivati a 22,4k per chiamata, ancora più in basso.
Dove finivano i soldi
Suddividi ogni chiamata API per quanta parte di contesto portava con sé, e il meccanismo è visibile direttamente.
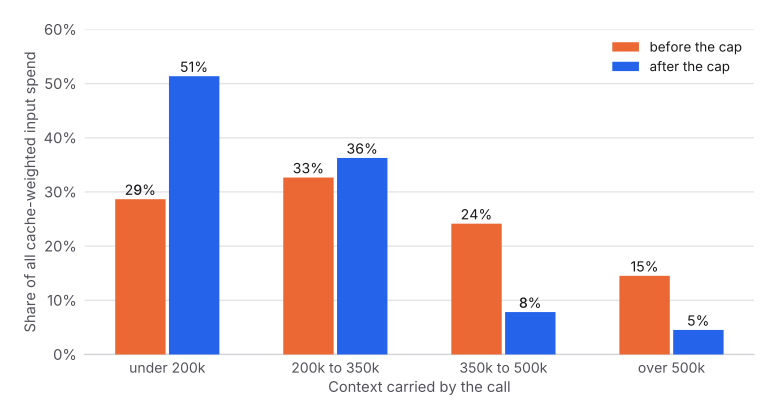
Prima del limite, il 39% di tutto ciò che spendevo finiva in chiamate che si trascinavano dietro più di 350.000 token di cronologia. Quelle chiamate non facevano più lavoro delle altre. Era lo stesso lavoro, con più bagaglio. Dopo il limite quella quota è del 12%.
Il tetto ha tenuto?
Un punto per sessione, posizionato al contesto più grande che quella sessione abbia mai portato.
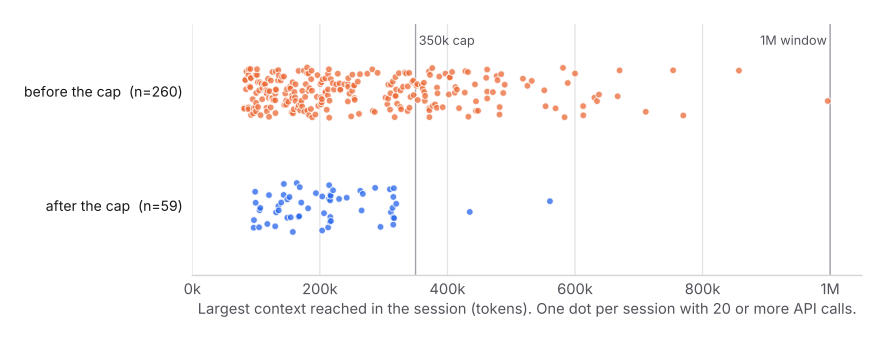
Due sessioni nei primi due giorni sono comunque andate oltre il limite, a 434.000 e 561.000, e non ho scoperto perché. Da quando il valore 350.000 è stato inserito il 18 settembre, nessuna sessione l’ha superato. La coda di sessioni che vivevano tra 500k e 1M, dove stava la maggior parte dello spreco, è sparita.
Quanto sarebbe costato senza il limite
Per mettere un totale, ho rigiocato ogni sessione iniziata dopo il cambiamento come se il contesto eliminato non fosse mai stato riassunto e venisse ancora riletto a ogni chiamata successiva, con il tetto della finestra da 1M.
| Input ponderato per cache | |
|---|---|
| Reale, 73 sessioni, 9.675 chiamate, 55 compattazioni | 216,8M |
| Le stesse sessioni senza il limite | 479,2M |
| Evitato | 262,5M, ovvero 55% |
La sessione a destra del primo grafico ne rappresenta da sola 118,5M. Un lungo refactoring che altrimenti avrebbe passato le sue ultime centinaia di chiamate a rileggere quasi un milione di token ciascuna.
Considera il 55% come l’estremo ottimistico. Senza il limite non avrei davvero lasciato una sessione macinare a 900k per ore; prima o poi l’avrei svuotata a mano, il che azzera comunque il costo. L’estremo conservativo è il valore osservato per chiamata, da 30,6k a 22,4k, quindi circa il 20%-27%. La verità sta da qualche parte tra i due.
Quanto ti costa
Non è gratis, e chiunque lo consigli dovrebbe dirlo.
Attesa. 67 compattazioni dal cambiamento, con una mediana di circa tre minuti ciascuna. All’incirca 3,4 ore passate a guardare un riassunto che viene scritto, distribuite su otto giorni.
Un po’ di rilavorazione. La compattazione elimina molto. Con l’impostazione a 350K, la compattazione mediana portava una sessione da 318.000 token a 24.000. L’agente perde dettagli e a volte li ricostruisce: i file riletti all’interno della stessa sessione sono passati dall'11,5% delle letture prima della prima compattazione al 20,5% dopo. Il campione dietro a quel secondo numero è piccolo, quindi leggilo come una direzione più che come una misurazione.
La scelta della soglia conta. A 250K, il 36% delle mie sessioni lunghe arrivava a una compattazione. A 350K, ci arrivava il 12%, mentre il tetto teneva comunque. Impostala troppo bassa e paghi i tre minuti e la rilavorazione ripetutamente per un risparmio che avevi già incassato.
Come configurarlo
Claude Code. Aggiungi autoCompactWindow a ~/.claude/settings.json. Su un modello con contesto da 1M, 350.000 è stato il migliore dei tre valori provati. Su un modello da 200K, scala verso il basso e inizia intorno a 120.000-140.000. Le nuove sessioni la recepiscono; una sessione già in corso mantiene il vecchio valore.
Altri agenti. Cerca la stessa idea sotto un altro nome: un trigger di compattazione, un limite di contesto, una soglia di riassumi-e-continua. Se non c’è, la versione manuale è svuotare la sessione più spesso di quanto sembri naturale. L’istinto di tenere viva un’unica lunga sessione tutto il giorno perché “conosce il progetto” è quello costoso.
Qualunque cosa tu usi, due abitudini fanno più di qualsiasi impostazione. Tieni lo stato durevole nei file invece che nella conversazione, così l’agente può rileggere un file a basso costo invece di portarsi dietro per sempre ogni risposta precedente. E sposta il lavoro a forte lettura verso subagenti con un loro contesto di breve durata, così i venti file che leggono non entrano mai nella sessione principale.
Se hai un limite settimanale
Se paghi un abbonamento con un limite di utilizzo settimanale invece di una fattura per token, questa è la leva con il miglior rapporto tra sforzo ed effetto che abbia trovato. Una riga di JSON, nessun cambiamento a come lavori, e lo stesso limite si allunga in modo misurabile. Nel mio caso lo stesso volume settimanale di prompt è costato il 17% in meno, e le sessioni lunghe circa la metà.
Leggi anche
Le finestre di contesto vengono vendute come capacità. Si comportano come un contatore che gira, addebitato a ogni turno per tutto ciò che hai mai inserito. Se vuoi i meccanismi dietro a questo e non solo l’impostazione, l’articolo complementare spiega cosa riempie davvero una finestra di contesto, perché una sessione lunga costa molto più del lavoro che fa e come caching, svuotamento e compattazione cambiano ciascuno l’aritmetica.
