

Punti chiave
- Scrivere codice non è più la parte lenta. In 31 giorni il nostro repo principale ha mergiato 473 pull request. 130 di loro avevano bisogno che qualcuno tornasse e mergiasse main nel branch, 239 merge commit in totale, e 238 di quelli sono stati fatti da una persona.
- I PR che avevano bisogno di questo hanno impiegato una mediana di 44 ore dall’apertura al merge. Quelli che non l’avevano fatto hanno impiegato 2. Dei 60 PR rimasti aperti per più di tre giorni, 51 avevano bisogno di almeno un merge di main.
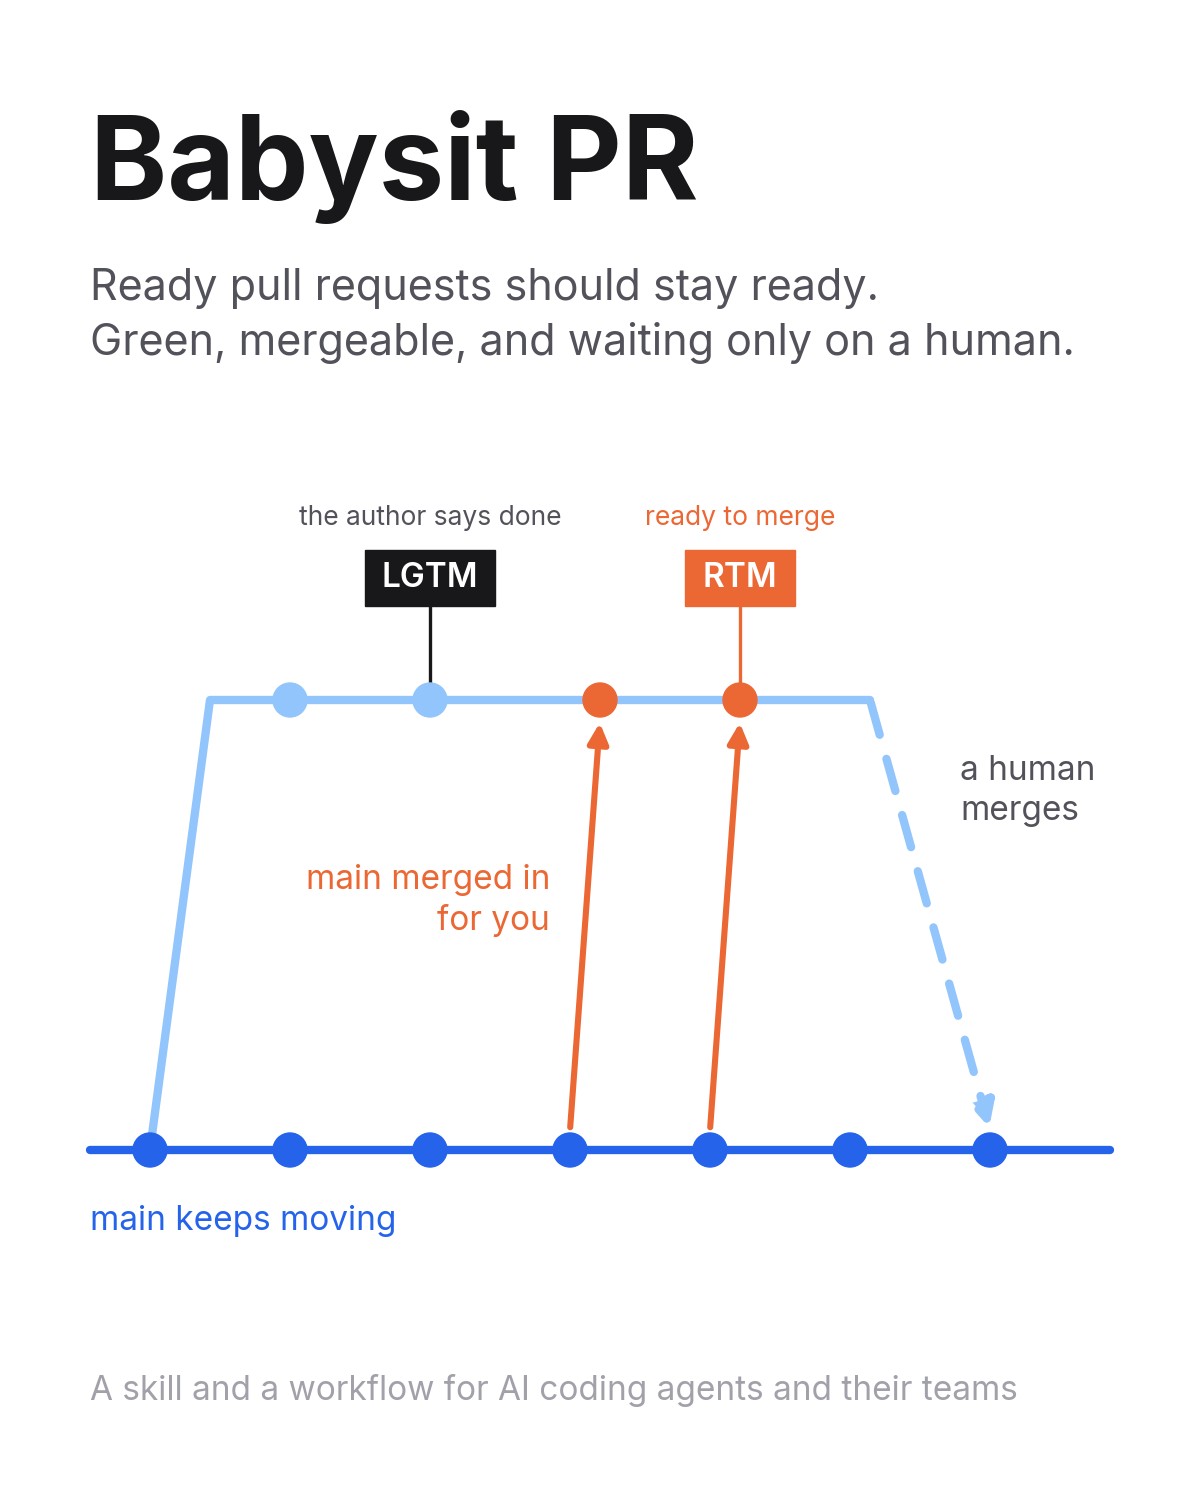
- babysit-pr divide il lavoro a una etichetta:
LGTM, “guarda, mi sembra buono”, che l’autore aggiunge quando il lavoro è completato. Prima di questo, una skill mantiene l’agente sul PR finché CI non è verde e ogni bot di revisione non è stato risposto. Dopo, un workflow GitHub Actions mantiene il PR mergibile finché una persona non lo merggia, e aggiungeRTM, “pronto per il merge”, una volta che qualcuno diverso dall’autore approva. - Il workflow non merggia mai, non chiude mai e non cambia mai una riga scritta dall’autore. Un conflitto che non può risolvere intorno al codice dell’autore torna all’autore come
REWORK. - La skill è pubblica, con licenza MIT: babysit-pr-skill on GitHub , con lo script watcher e la progettazione del workflow. Il workflow stesso è ancora in dry run nel nostro repo, e spiego di seguito il perché.
Perché i pull request finiti diventano stalli?
Scrivere il codice ha smesso di essere la parte lenta. Con il modello architect e gli agenti che fanno la maggior parte della digitazione, il nostro repo prende circa 13 commit al giorno in main. Questo è buono per il rilascio ed è cattivo per ogni pull request aperto, perché ognuno di questi commit può mettere un PR in conflitto o rendere la sua CI rossa.
Ho estratto gli ultimi 31 giorni di PR mergiati per vedere dove è andata la maggior parte del tempo.
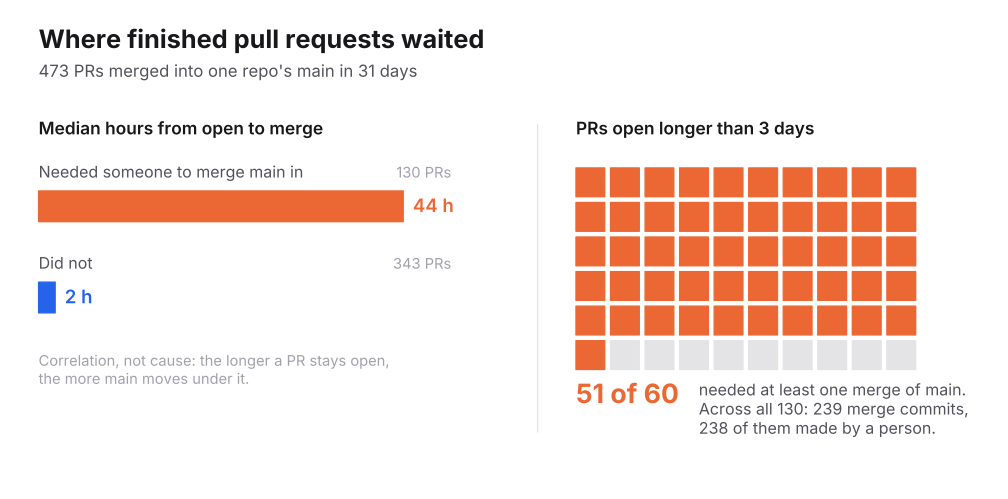
Il 44 rispetto a 2 è una correlazione, non una causa. Un PR che rimane aperto più a lungo dà a main più tempo per muoversi sotto di esso, quindi è più probabile che abbia bisogno di un merge. Ma i merge stessi sono un vero lavoro che qualcuno ha fatto 239 volte in un mese. Cinque persone ne hanno fatti 238 a mano. Un PR ha avuto bisogno di otto merge di main durante i sette giorni in cui era aperto.
L’approvazione stessa è stata veloce. Una volta che un PR ha ricevuto la sua prima approvazione, il tempo mediano al merge è stato zero ore. L’attesa è accaduta prima: l’autore ha finito, quindi il PR è rimasto seduto finché un revisore non ci è arrivato, e mentre sedeva, main si è mosso. Abbiamo iniziato a etichettare i PR finiti LGTM il 20 ottobre. I 20 che si sono mergiati da allora hanno aspettato una mediana di 38 ore tra LGTM e merge, e uno su quattro ha aspettato più di 78.
Questo è lo spazio per cui è fatto. Nessuno è sconsiderato qui. L’autore pensa di aver finito, il revisore non l’ha ancora aperto, e il branch marcisce nel mezzo.

Pronto a far crescere il tuo business?
Inizia oggi la tua prova gratuita e vedi i risultati in pochi giorni.
Perché non chiudere i pull request stalli con actions/stale?
La solita risposta ai pull request stalli è actions/stale : un GitHub Action che aggiunge un’etichetta stale a problemi e pull request dopo un numero impostato di giorni di inattività, e li chiude automaticamente alcuni giorni dopo a meno che qualcuno non commenti o faccia push.
Questo è adatto a un pull request su cui nessuno sta lavorando. Non fa nulla per i nostri. I nostri erano lavori finiti che sono diventati stalli mentre aspettavano un revisore, perché main si è mosso sotto di loro. Chiuderli butta il lavoro, e un’etichetta stale dice all’autore quello che già sa. Quello che il PR ha bisogno è che qualcuno merggia main in, riesegua il job CI rosso e lo mantenga verde finché una persona lo approva. Quindi invece di chiudere i pull request stalli, li manteniamo mergibili.
Come babysit-pr mantiene i pull request mergibili
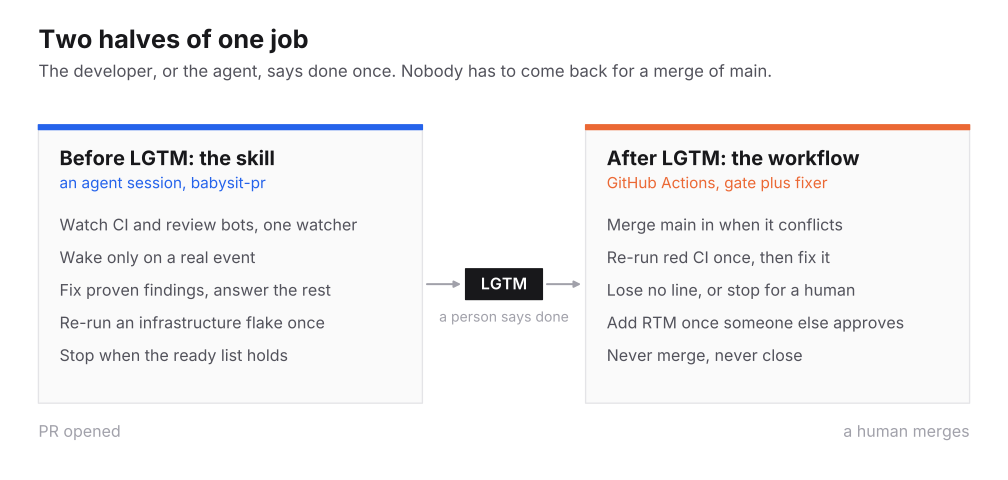
La divisione segue chi sta aspettando. Prima di LGTM l’autore è ancora sul PR, di solito una sessione di agente, e la skill mantiene quella sessione a fare un lavoro utile invece di dichiarare la vittoria quando il codice si compila. Dopo LGTM l’autore si è spostato, quindi il lavoro va a qualcosa che non ha bisogno di loro: un workflow che viene eseguito indipendentemente da se qualcuno sta guardando.
LGTM sta per “guarda, mi sembra buono”. Nella maggior parte dei team un revisore lo dice del codice di qualcun altro. Qui l’autore lo mette sul proprio PR come un’etichetta che significa “Ho finito, non c’è niente più per me da fare”. È la parola di una persona: l’agente la aggiunge solo quando gli è stato detto di consegnare il PR. Quell’etichetta è l’opt-in per tutto ciò che viene dopo, ed è la cosa che rende uno sviluppatore a suo agio nel lasciare che un bot faccia un push nel suo branch.
Iscriviti alla nostra newsletter
Ricevi gratuitamente gli ultimi consigli, tendenze e offerte.
Prima di LGTM: una skill Claude Code porta il PR a pronto
La skill è iniziata come la skill babysit-pr nel tstack
di Theo Browne. Ho mantenuto il suo watcher e le sue regole fondamentali e ho cambiato dove si ferma.
Un watcher per pull request
pr-wait controlla un pull request e stampa una riga per evento reale: un check non è riuscito, tutti i check sono finiti, qualcuno ha commentato o revisionato, main si è mosso sotto i file che questo PR tocca, il branch è rimasto indietro o in conflitto, il PR è stato mergiato. In Claude Code viene eseguito sotto lo strumento Monitor, quindi ogni riga risveglia l’agente una volta. Un evento che non ha bisogno di azione termina il turno senza un messaggio. “Ancora in attesa” non è una novità, e un agente che lo dice cinquanta volte riempie il suo stesso contesto di nulla.
Ordina il job CI rosso prima di toccare il codice
Ci sono quattro tipi di rosso, e solo uno è una correzione del codice:
- Il PR l’ha rotto. Correggilo con il cambiamento più piccolo.
- Il runner ha fatto un flake. Riesegui i job falliti una volta. Un secondo fallimento sulla stessa head non è un flake.
- Main è rosso. Non correggere main su un branch di funzionalità di qualcuno. Segnalalo e aspetta.
- Un check di processo è rosso, ad esempio il PR non collega un problema approvato. Questo è un passaggio per una persona.
Gli agenti lasciati soli trattano tutti e quattro come il primo, e il PR cresce un workaround per un test che è rotto su main.
Prova un risultato di revisione prima di correggerlo
Un risultato di revisione che l’agente accetta riceve prima un test fallito, poi la correzione. Un risultato che rigetta riceve una ragione scritta. Questa è la stessa regola della nostra skill di revisione provata, ed è ciò che impedisce ai bot di revisione di sterzare un PR per volume.
Mantieni il PR della dimensione del suo obiettivo
I loop di revisione fanno crescere un PR un fix dal prezzo basso alla volta: una guardia per un caso limite che nessuno colpisce, un test per un comportamento che non è cambiato, un shim di compatibilità. La skill corregge i bug reali nel caso inteso e rifiuta il resto per iscritto. Quelli utili diventano problemi.
Ready è una lista di controllo
Ogni job CI di gating verde sulla head attuale, ogni bot di revisione finito su questa head, niente in attesa di un umano, nessun thread non risolto, nessun conflitto. Quando ciò è vero l’agente lo segnala e smette di osservare.
Dopo LGTM: un workflow GitHub Actions risolve i conflitti di merge
Il workflow ha due job.
Il gate decide cosa serve a ogni PR
Il gate è economico: nessun agente, nessun checkout del codice PR. Viene eseguito su ogni push a main, ogni completamento di CI, ogni etichetta e revisione, e ogni 30 minuti, e una query GraphQL gli fornisce ogni PR aperto LGTM. Per ognuno una funzione pura decide cosa fare. Aggiungi RTM se è approvato da qualcuno diverso dall’autore, verde e privo di conflitti. Lascialo stare se una revisione è in esecuzione. Riesegui CI rosso una volta. Invia un conflitto, o CI che è ancora rosso dopo il suo re-run, al fixer.
L’agente fixer merggia main in
Il fixer è un job di agente per un PR in una head. Merggia main nel branch senza committare, dà all’agente i file in conflitto e i log falliti, e lo lascia modificare solo i file in conflitto e i file che il PR già cambia. Quindi fa una domanda.
Questo PR può atterrare senza cambiare una riga scritta dall’autore?
Se sì, il verdetto è MODERNIZE. L’agente risolve il conflitto intorno alle righe dell’autore, un validatore controlla il risultato, e il workflow fa push di un normale merge commit. Se no, perché main ha eliminato la funzione che il PR modifica o il codice del PR stesso non passa CI, il verdetto è REWORK. Non viene fatto alcun push, LGTM viene tolto, e l’autore riceve un commento con la riscrittura più piccola. Se main già fa quello che fa il PR, il verdetto è CLOSE, e una persona lo chiude.
Il validatore mantiene ogni riga che l’autore ha scritto
Il validatore è quello che rende la regola. Rifiuta qualsiasi merge che elimina una riga che il PR ha aggiunto, o una riga che main ha aggiunto a un file in conflitto. Rifiuta le modifiche al di fuori dei file consentiti, i marcatori di conflitto rimanenti e le modifiche ai file CI o di sicurezza. Un agente che prova a “correggere” il codice dell’autore finisce con un’etichetta che chiede un umano, mai con un push. Il workflow fa push senza forzare, e solo se il branch non si è mosso da quando il tentativo è iniziato. Un tentativo per head e base, due per head, tre commenti per PR al giorno.
Non merggia mai
RTM, “pronto per il merge”, è la dichiarazione del gate che un PR ha tutto ciò che serve: il LGTM dell’autore, un’approvazione da parte di qualcun altro, CI verde e nessun conflitto. Una persona fa il merge. Questo ha mantenuto il design piccolo, e ha mantenuto l’argomento su se un bot dovrebbe merggiare fuori dalla revisione.
Cosa cambia per l’autore, il revisore e chiunque merggia
L’autore dice fatto una volta. Non torna tre giorni dopo per merggiare main e aspettare CI di nuovo, e il PR di un agente non marcisce perché la sessione che l’ha aperto è finita.
Il revisore apre un PR che è verde e mergibile su main di oggi, quindi la sua approvazione è l’ultimo passaggio e non l’inizio di un altro round.
Chiunque merggia lavora da una lista. RTM rimane una volta che il gate l’aggiunge, e se main rompe il PR dopo, il workflow lo corregge e l’etichetta rimane.
E l’autore mantiene il controllo del suo codice. Il peggio che il bot può fare a un branch è aggiungere un merge commit che un validatore ha controllato riga per riga.
Perché il nostro vecchio resolver di conflitti di merge non è mai stato eseguito
Avevamo un resolver di conflitti prima di questo. Un detector ha trovato PR in conflitto e ha commentato su di loro, e il resolver è stato eseguito quando qualcuno ha aggiunto un’etichetta chiedendogli di. Nello stesso periodo il detector è stato eseguito circa 2.500 volte. Il resolver è stato eseguito zero volte.
Non penso che nessuno fosse pigro. Uno sviluppatore che considera un PR finito non torna a pressare un pulsante. L’automazione che aspetta di essere chiesta non sarà chiesta. Per questo uno inizia da LGTM, il momento in cui l’autore dice di aver finito, e fa il resto senza di loro.
Cosa non funziona ancora?
Due cose, e preferirei dirle qui piuttosto che farvi voi trovarle.
Il workflow è in dry run
Il suo gate registra solo quello che farebbe finché una variabile di repository non dice diversamente. Prima di arrivare così lontano, una revisione che mantiene solo i risultati che può provare con un test fallito ha trovato undici bug. Alcuni vale la pena sapere se costruisci il tuo. La ricerca per etichette di GitHub è in ritardo, quindi un PR che restituisce potrebbe aver perso l’etichetta pochi secondi fa, e la decisione deve controllare le etichette live. Un marcatore “questa head ha già avuto il suo re-run” scritto prima che la chiamata di re-run abbia successo lascia che un fallimento API non riuscito usi il solo retry della head. E un controllo “non perdere alcuna riga” che non segue i rename vede ogni riga di un file rinominato come perso.
I runner dell’agente erano giù
Dal 19 ottobre ogni job rivolto ai nostri runner di agenti non è riuscito a ottenere una macchina: 406 cancellati, 24 ancora in coda quando ho controllato. Il gate viene eseguito altrove ed è a posto, ma il fixer ha bisogno di un runner di agente, e uno morto sembra esattamente un giorno tranquillo. Niente non è riuscito ad alta voce. I job in coda e poi sono stati cancellati. Se costruisci questo, avvisa su fixer che vengono eseguiti in coda.
Quindi i numeri sopra sono l’immagine prima. In questo momento abbiamo 27 PR aperto LGTM, 7 di loro con CI rosso e nessuno con RTM. Questi sono i numeri che questo dovrebbe cambiare, e riferirò quello che ha fatto.
Come installare la skill babysit-pr
github.com/LivinTribunal/babysit-pr-skill ha:
SKILL.md, la skill, con una breve sezione “configura una volta” per i tuoi workflow CI, bot di revisione e controlli di processo.scripts/pr-wait, il watcher. Ha bisogno di Python e di unghautenticato.docs/after-lgtm.md, la progettazione del workflow dopo-LGTM: le etichette, il gate, il fixer, la regola che non cambia mai le righe dell’autore, e gli undici bug.
Il workflow è una progettazione piuttosto che un file da copiare, perché il nostro gira contro le etichette, i runner e il CI di un’azienda. Costruisci il tuo dai documenti, spediscilo in modalità solo log, leggi un giorno delle sue decisioni, poi attivalo.
Si abbina con il modello architect , che decide chi scrive il codice, e grain , che decide come appare il codice. babysit-pr è quello che accade dopo che uno dei due apre il pull request. Se stai sintonizzando l’agente stesso, il test A/B CLAUDE.md e il limite di contesto che ha ridotto l’uso di token del 17% coprono le istruzioni e il costo.