


Pochi giorni fa Anthropic ha reso Fable una parte permanente dei piani Max. Il tempismo racconta la storia: è arrivato subito dopo il lancio di GPT-5.6 Sol da parte di OpenAI e — cosa più rilevante — subito dopo che Kimi K3 ha rilasciato i suoi pesi. È servito un modello open source per costringere il più grande laboratorio AI a fare i conti con la realtà e a mettere fine alla confusione marketing intorno al suo flagship. Solo per questo merita un brindisi da chiunque paghi queste fatture.
Ma “incluso nel tuo abbonamento” non è la stessa cosa di “economico”, e di sicuro non è la stessa cosa di “economico per sempre”. Ecco perché, mentre Fable era ancora a consumo, abbiamo ricostruito il nostro workflow in modo che il modello costoso sia meccanicamente bloccato dallo scrivere codice. Pensa, pianifica e revisiona. I modelli più economici digitano. Questo post mostra come funziona e cosa ha effettivamente prodotto su ogni transcript che abbiamo — 606 sessioni reali che spaziano su un monorepo SaaS di produzione, un’app per operazioni con droni, un sito marketing e gli agenti CI che li servono.
Parte 1 — La trappola e il principio
Ecco la nostra onesta posizione di partenza: non possiamo più operare senza modelli di frontiera. Nessuno nel team potrebbe sostenere l’output attuale senza di essi — e quella dipendenza è esattamente la leva che i grandi laboratori detengono. Nella nostra lettura, gli abbonamenti AI di oggi offrono molta più capacità di calcolo di quanto costino; sono prezzi di conquista del mercato, e i prezzi di conquista finiscono. Quando finiranno, chi ha costruito la propria cultura ingegneristica intorno ai “token di frontiera illimitati” pagherà qualunque cifra venga chiesta.
Ci sono due difese. La prima è mantenere una via d’uscita credibile: modelli aperti come DeepSeek e Kimi sono ciò che ha forzato la correzione di prezzo di questa settimana, e restano una leva solo se manteniamo davvero i nostri workflow portabili verso di loro. La seconda è la disciplina di workflow: spendere token di frontiera solo dove nulla di più economico funziona. Questo post riguarda la seconda — perché è quella che puoi iniziare lunedì.
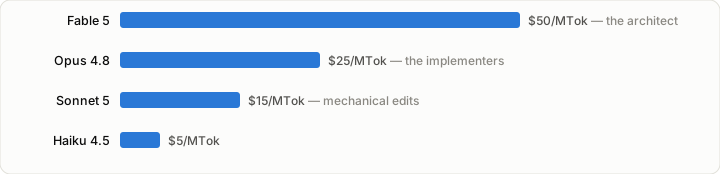
Il principio è così antico da avere un edificio che porta il suo nome: l’architetto non posa i mattoni. Il vantaggio di un modello di frontiera rispetto a un modello di fascia media è enorme nella progettazione, nella scomposizione e nella revisione — e vicino a zero quando si tratta di digitare un rename su quaranta file. Quindi separa i ruoli. La scala dei prezzi dice la stessa cosa in dollari:
Come funziona il pattern fable-architect
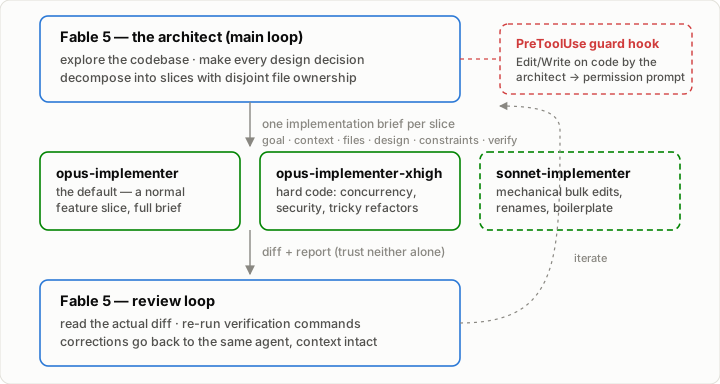
La skill fable-architect è un file markdown di circa 100 righe più un hook shell, caricato ogni volta che una sessione di Claude Code gira sul modello di frontiera. Impone una divisione del lavoro:
- L’architetto fa: interroga il requisito, esplora il codebase, prende ogni decisione di progettazione — approccio, flusso di dati, nomi, firme, casi limite — scompone il lavoro in slice indipendenti, revisiona i diff restituiti, esegue la verifica e scrive tutta la prosa (piani, brief, corpi delle PR, messaggi di commit).
- L’architetto non fa mai: scrivere o modificare un file sorgente. Nessun codice in chat oltre a brevi firme all’interno di un brief.
Tre cose fanno funzionare tutto questo nella pratica, e non su una slide.
1. Il brief è l’interfaccia
Ogni slice riceve un brief di implementazione. L’implementatore parte con una finestra di contesto nuova: tutto ciò che non è nel brief deve essere riscoperto o indovinato. Questo vincolo è un vantaggio: costringe l’architetto a finire di decidere prima di delegare. Un brief contiene decisioni, non opzioni.
## Implementation brief: <slice>
Goal:         one sentence, observable outcome
Context:      what exploration already found — excerpts, the nearest
              pattern to mirror, line anchors, gotchas
Files:        paths to create/modify — this slice's exclusive ownership
Design:       the decided approach — data flow, names, signatures, edges
Constraints:  project rules that apply: style, layers, security
Out of scope: what not to touch, including files owned by other slices
Delegation:   may this slice spawn sub-implementers, and how many
Verify:       exact commands and expected outcome
Due di queste righe sono più recenti delle altre, ed esistono perché il livello dell’implementatore è cambiato sotto i nostri piedi — vedi l’aggiornamento più avanti.
2. Applicazione, non sensazioni
Un hook di guardia PreToolUse sorveglia la sessione: se l’architetto prova a modificare un file che non è prosa, scatta una richiesta di autorizzazione. Approvare la richiesta è l’eccezione documentata per le modifiche banali (un refuso, un bump di versione — casi in cui l’overhead della delega costa più della digitazione). L’attrito è la politica. Senza l’hook, “il modello costoso non dovrebbe scrivere codice” dura esattamente fino alla prima scadenza.
3. Il ciclo di revisione colma il divario di qualità
L’architetto legge il report dell’agente e il diff effettivo — non fidandosi di nessuno dei due da solo — e riesegue i comandi di verifica chiave quando l’affermazione conta. Trovato un problema? La correzione torna allo stesso agente, che conserva ancora tutto il suo contesto di lavoro. Niente correzioni a mano, nessun nuovo avvio da zero.
Nota che questa è la verifica dell’architetto, e resta. Quello che abbiamo iniziato a rimuovere è la verifica che scrivevamo nei brief — istruzioni che dicevano all’implementatore di ricontrollare se stesso. I modelli implementatori più recenti lo fanno senza che glielo si chieda, e dirglielo di nuovo compra un secondo passaggio che hai già pagato.

Pronto a far crescere il tuo business?
Inizia oggi la tua prova gratuita e vedi i risultati in pochi giorni.
Cosa abbiamo misurato
Per verificare se si tratta di un vero meccanismo economico o solo di un rituale piacevole, abbiamo analizzato ogni transcript di Claude Code dei nostri progetti, deduplicando le richieste API e prezzando ogni token alle tariffe di listino attuali. Tre ipotesi, registrate prima di guardare i numeri per sessione:
- H1 — Gli implementatori fanno la digitazione. Se è vero, i subagenti implementatori dovrebbero produrre più token di output del loop principale dell’architetto nelle sessioni delegate.
- H2 — La delega costa meno. Se è vero, riprezzare il lavoro degli implementatori alle tariffe del modello architetto dovrebbe risultare sensibilmente più costoso di quanto abbiamo effettivamente pagato.
- H3 — La qualità tiene. Quella difficile: il codice delegato non dovrebbe richiedere più rilavorazioni del codice digitato dall’architetto.
Regole di base. Una richiesta API copre molte righe di transcript che ripetono lo stesso oggetto di utilizzo: abbiamo raggruppato per ID di richiesta, contato i token di input e cache una volta per richiesta e preso lo snapshot massimo di output (la somma ingenua riga per riga sovrastima di 2–3×). I costi usano i prezzi di listino attuali di Anthropic — Fable $10/$50, Opus $5/$25, Sonnet $3/$15 per milione di token di input/output — con le letture di cache al 10% del prezzo di input e le scritture di cache alle rispettive tariffe per TTL. 31 delle 354 sessioni interactive-store si qualificano come sessioni fable-architect secondo un classificatore conservativo; le cifre mostrano le otto più costose. Riportiamo rapporti e percentuali invece della nostra spesa assoluta.
Parte 2 — Le prove
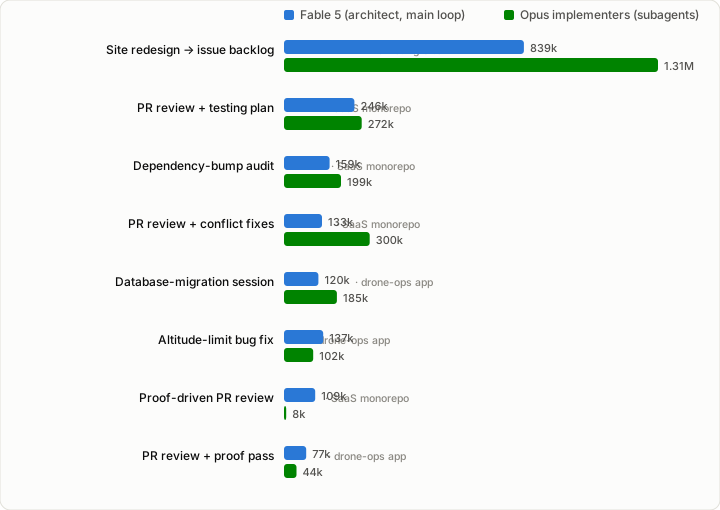
H1 — Risultato misto… secondo la prima contabilizzazione. Nelle più grandi sessioni di delega l’ipotesi regge in modo netto — fino a 2,3× più output degli implementatori rispetto a quello dell’architetto. Ma su tutte le 31 sessioni fable-architect l’architetto ha comunque prodotto più degli implementatori: 3,59M contro 3,15M di token. In parte è giusto così — l’output dell’architetto include tutti i piani, i brief e la prosa di revisione, che è esattamente il suo lavoro — e in parte sembravano sessioni che delegavano una slice e tenevano il resto. Poi ci siamo ricordati che il nostro redesign del sito non ci era sembrato affatto pesante di architetto, e siamo andati a cercare i token che la contabilità dei subagenti non poteva vedere.
Iscriviti alla nostra newsletter
Ricevi gratuitamente gli ultimi consigli, tendenze e offerte.
Il secondo canale: l’issue tracker come bus di delega
La contabilità dei subagenti ha un punto cieco: vede solo la delega che avviene dentro una sessione. La sessione di redesign del sito — la riga più grande nel grafico sopra — si è rivelata qualcosa di completamente diverso: un’unica sessione del loop dell’architetto che ha girato per 107 ore di fila (292 risvegli programmati), ha spezzato il redesign in issue GitHub, le ha etichettate per la nostra pipeline CI e poi ha supervisionato: interrogando le esecuzioni, revisionando le pull request della pipeline, aprendo issue di follow-up quando il QA faceva emergere bug.
La digitazione è avvenuta in un punto che la nostra analisi per sessione non aveva nemmeno guardato: una flotta separata di runner self-hosted, dove le fasi plan → implement → gap-evaluation → review della pipeline sono state eseguite come 252 sessioni Opus indipendenti in 4,5 giorni, toccando 48 issue e PR distinte.
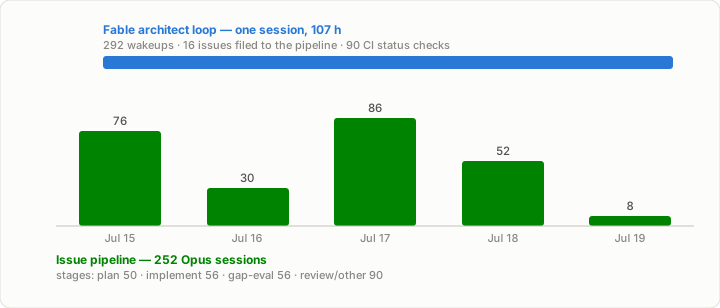
H1, rivisitata — Confermata alla scala del progetto. Contando entrambi i canali, il quadro si inverte: la pipeline ha digitato 10× più token di output del loop dell’architetto che l’ha inviata (9,07M contro 877k), tutti a tariffe Opus. Eseguire quella ondata di implementazione sul modello dell’architetto sarebbe costato 2,1× tanto — su un solo redesign, in una settimana, e senza contare i subagenti in sessione. Una issue è solo un brief a granularità più grossolana: stessa interfaccia, stessa economia, un livello più su.
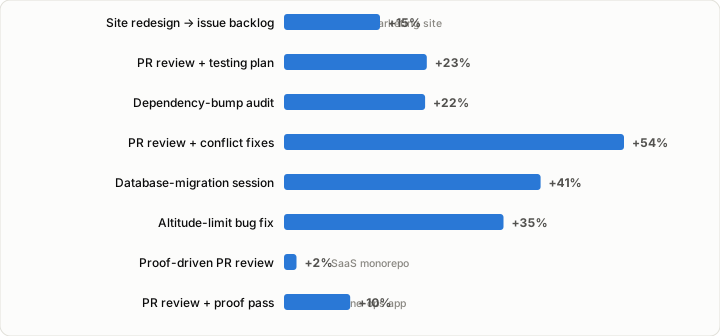
H2 — Confermata, con un colpo di scena. Riprezzare gli esatti volumi di token degli implementatori alle tariffe del modello architetto rende ogni sessione più costosa — da +2% a +54%, 17% sulle otto principali. Soldi veri, ma meno di quanto suggerisca il divario del 2× sul prezzo di output. Il colpo di scena: l’output non è dove vanno i soldi. Nella sessione più grande, le letture di cache dell’architetto sono costate circa 13× tutto ciò che ha digitato — la spesa dominante è il modello costoso che mantiene e rilegge un grande contesto di orchestrazione, non la digitazione. La delega limita la bolletta dell’output; la prossima leva è mantenere snello il contesto dell’architetto.
H3 — Non misurata qui. La contabilità dei token non vede la qualità del codice. Quello che possiamo dire per osservazione: il ciclo di revisione è portante — report e diff sono in disaccordo abbastanza spesso da rendere imprescindibile leggerli entrambi — e le correzioni rimandate a un agente con il contesto caldo convergono in fretta. Se replichi questo esperimento e misuri le rilavorazioni come si deve, vogliamo vederlo, soprattutto se ci smentisce.
Cosa ci hanno insegnato i dati più ampi
- L’adozione è un gradiente, non un interruttore. Sull’app di drone-ops — più piccola e più veloce — il 18% delle sessioni usa il pattern fable-architect; sul monorepo SaaS più vecchio è il 9%. Il progetto che ha delegato di più l’ha fatto su entrambe le granularità insieme: brief di implementazione in sessione e 252 sessioni di pipeline inviate tramite l’issue tracker.
- La flotta CI non esegue la skill — perché è l’implementatore. Le nostre sessioni di runner automatizzate non generano mai un subagente implementatore, e all’inizio questo sembrava una mancata adozione. I prompt dicono il contrario: ognuna è una fase di pipeline — verifica, revisione, valutazione dei gap — e circa sei su dieci lavorano su una issue o una PR specifica. Alla scala del progetto, i runner della pipeline sono il livello implementatore.
- Il livello più economico non ha ancora fatto il suo primo giorno di lavoro. Tutte le 78+ esecuzioni di implementatori erano di classe Opus; il livello di modifiche meccaniche Sonnet è stato aggiunto solo di recente e non è mai stato invocato. Qualunque risparmio venga misurato qui, è un minimo.
L’interfaccia è il punto: brief in ingresso, diff in uscita — issue in ingresso, PR in uscita. Il giorno in cui arriva l’aumento di prezzo, cambi il muratore, non il processo.
Divulgazione completa. Modelli verificati dalle stringhe dei transcript, non presunti. Ci siamo corretti due volte (un conteggio eccessivo di token per riga, poi una tabella di prezzi segnaposto). Il controfattuale presume che l’architetto avrebbe speso gli stessi volumi di token degli implementatori — le barre di errore vanno in entrambe le direzioni. Le sessioni della pipeline vivono in un archivio di transcript che le nostre prime due passate di analisi non avevano incluso nello scope; un confine contabile ci ha nascosto un canale di delega da 9M token, e probabilmente anche il tuo ne ha uno. Progetti di un solo ingegnere, per lo più review-and-fix e sviluppo di funzionalità — non un benchmark controllato. Il corpus si chiude inoltre prima dell’uscita di Opus 5: ogni cifra sopra riguarda Fable come architetto su implementatori di classe Opus 4. I prezzi dei gradini non sono cambiati con l’arrivo di Opus 5, quindi i rapporti misurati restano validi — ma vedi la sezione successiva per ciò che è cambiato.
Aggiornamento — la scala si è mossa sotto i nostri piedi
Opus 5 è uscito dopo la chiusura di queste misurazioni, e nulla è cambiato nella scala dei prezzi: Opus è ancora $5/$25 per milione di token di input/output, Fable è ancora $10/$50, e il grafico sopra è ancora corretto. Ciò che è cambiato è la capacità a ogni gradino. Anthropic posiziona Opus 5 come un salto di qualità nel ragionamento profondo e nel lavoro agentico a lungo orizzonte — cioè esattamente nel lavoro di cui è fatto il ruolo dell’architetto, a metà del prezzo del livello architetto.
Questo punta dritto al nostro colpo di scena su H2. Se il costo dominante dell’architetto sono le letture di cache, e le letture di cache si fatturano al 10% del prezzo di input, allora un architetto che gira su Opus 5 rilegge il suo contesto di orchestrazione a $0,50 per milione di token invece di $1,00 di Fable. La voce di costo che costava 13× tutto ciò che l’architetto ha digitato si dimezza. Non l’abbiamo misurato — è aritmetica sotto la stessa assunzione di volumi di token uguali che abbiamo segnalato per il controfattuale del 2,1×, ed è la prossima cosa che intendiamo testare. Se regge, la domanda interessante smette di essere quali tipi di modello e diventa se l’architetto abbia davvero bisogno del gradino più alto.
Tre cose del nuovo livello implementatore cambiano il pattern stesso, non solo il suo prezzo:
- Ricorre volentieri ai subagenti — il contrario del suo predecessore, che doveva essere convinto a delegare. Un implementatore che genera silenziosamente i propri implementatori moltiplica la bolletta senza che nessuno guardi. Da qui la riga
Delegation:nel brief: una slice ora dichiara se può diramarsi e quanto in largo. - Verifica il proprio lavoro senza che glielo si chieda. Le istruzioni di verifica scritte per i modelli più vecchi ora comprano un secondo passaggio ridondante, quindi escono dai brief. Il ciclo di revisione dell’architetto resta intatto.
- Espande lo scope.
Out of scope:smette di essere testo standard e diventa la riga che mantiene una slice una slice.
E il gradino che non abbiamo mai usato è diventato più affilato mentre non guardavamo: Sonnet 5 arriva vicino alla qualità di Opus sul lavoro di coding a $3/$15, con prezzi introduttivi ancora più bassi fino alla fine di agosto. “Qualunque risparmio venga misurato qui, è un minimo” era una cautela quando l’abbiamo scritto. Ora suona come un’attenuazione.
Parte 3 — Dove stiamo andando di proposito
Ci stiamo orientando, di proposito, verso una divisione in cui pensiamo che ogni team di ingegneria prima o poi sarà costretto: modelli di frontiera costosi solo per il brainstorming, l’architettura e la revisione; modelli sempre più economici per la programmazione vera e propria. Oggi i nostri implementatori sono di classe Opus. Nulla cambia nel workflow quando diventano di classe Sonnet, DeepSeek o Kimi — l’interfaccia è agnostica rispetto al modello per costruzione. È tutto qui il valore strategico: il giorno in cui il sussidio finisce e la fattura raddoppia, i team con questa disciplina cambiano una riga di configurazione. I team senza la rinegoziano l’intera struttura di costi sotto pressione.
Fable-architect è un piccolo passo — l’adozione è parziale e il livello più economico non ha ancora visto la sua prima esecuzione. Ma è il passo che costruisce il muscolo: scrivere brief che specificano completamente una slice, revisionare diff che non hai digitato, trattare l’attenzione del modello costoso come un budget. E l’ondata del redesign mostra dove porta quel muscolo: una volta che i brief funzionano, funzionano anche le issue, e il modello costoso smette del tutto di occuparsi dell’implementazione.
Cosa puoi fare lunedì
- Dividi i ruoli nel tuo harness di agenti. Una regola a livello di sessione: il modello di frontiera pianifica e revisiona; delega tutte le modifiche ai file a un agente implementatore più economico. In Claude Code è una skill più le definizioni dei subagenti — un pomeriggio di configurazione.
- Rendi il confine meccanico. Aggiungi un hook pre-edit che contesti le scritture di file del modello costoso stesso. Una regola che non costa nulla infrangere verrà infranta entro venerdì.
- Scrivi i brief con un template fisso. Obiettivo, contesto, file, design, vincoli, fuori scope, budget di delega, verifica. Il template è la disciplina — e il budget di delega è ciò che impedisce a un implementatore di assumerne silenziosamente altri per conto proprio.
- Revisiona sia il report sia il diff. Non fidarti mai di uno solo dei due; riesegui i comandi di verifica che contano.
- Misura la tua divisione. I tuoi transcript contengono già i dati — raggruppa per richiesta, prezza per modello e guarda chi sta effettivamente digitando. I nostri ci hanno mostrato un livello economico inutilizzato e un canale di delega da 9M token che non conoscevamo.
- Allarga l’interfaccia dai brief alle issue. Un brief delega un’ora di lavoro; una issue ne delega una giornata. Una volta che le tue issue portano criteri di accettazione su cui una pipeline può agire, il modello costoso può depositare lavoro nel tracker e supervisionare invece di stare nel loop per ogni slice.
- Tieni calda una via d’uscita. Usa un modello economico o aperto come implementatore per una slice a basso rischio a settimana. La portabilità che non eserciti mai è portabilità che non hai.
- Riprezza l’architetto, non solo il muratore. Ogni rilascio di modello sposta i gradini senza spostare la scala. Se la maggior parte della spesa per l’architetto è contesto più che digitazione, un livello architetto più economico vale più di un livello implementatore più economico — controlla quale dei due stai comprando secondo i tuoi transcript.
I laboratori continueranno a dirci che i loro modelli top valgono qualsiasi prezzo e — cosa esasperante — per il lavoro di giudizio hanno per lo più ragione. La mossa non è astenersi. È smettere di pagare prezzi di frontiera per dei cicli for.
