


短いまとめ
- FlowHuntのバックログから実際のイシューを1つ取り出し、Claude CodeにOpus 5.5上で7種類の異なる指示構成のもと13回実装させた。すべての実行は同じコミットから始まり、それぞれ専用のクローンと専用のデータベースを持ち、本番のGitHub CIを通した。2名のブラインドのOpusレビュアーが各結果を採点した。
- リポジトリの33KBのCLAUDE.mdは、測定可能な品質を買わなかった。それを入れた実行はレビューあたり2.0件のブロッカーおよび重大な指摘だった。指示ファイルが一切ない実行も同じだった。5.5KBのファイルは1.0だった。
- 独立した計画ステージは事態を悪化させた。計画プロンプトの後に実装プロンプトを実行する両方の構成は、素のプロンプトだけの双子の構成より高くつき、全26件のレビュー中のブロッカー5件のうち4件を生み出した。
- 勝者は8KBのCLAUDE.md、3つのスキル、Sonnetワーカー、そして素のプロンプトだった。その2回の実行はAPI定価で平均$6.68。パイプライン用プロンプトを備えたフル構成は平均$11.49で約1.7倍、しかも指摘は多かった。
- 私が積み上げた構造のうち生き残ったのはブリーフだ。メインモデルがより安いワーカー向けに書く、1つの作業スライスについての短く決定済みの記述である。メインモデル自身のための計画は報われなかった。モデルは自分で十分うまく計画する。
これは、コードを誰に書かせるべきかを測定したarchitectパターン の記事に続くものだ。今回の記事は、メインモデルが着手前にどれだけ教えられる必要があるかを問うている。
なぜ実行したのか
私たちのモノレポにはエージェント向けの指示が大量に溜まっていた。ルートのCLAUDE.mdは33KBで、ビルドコマンド、テストの頻度、コードスタイル、アーキテクチャ、クリティカルパス、セキュリティルール、権限とクレジットのルール、2つのエージェントサーフェス、イシュー起票、PRの規約が書かれていた。.claude/skills/ の下には10個のスキルがあった。さらにその上、私たちのCIパイプライン(harnextと呼んでいる)は、イシューをタガー、トリアージ段階、計画をイシューのコメントとして書く計画段階、そしてその計画を読み返してコードを書く実装段階へと通し、それぞれに独自の長いシステムプロンプトを持っていた。
その一行一行は理由があって追加されたもので、たいていはエージェントが何かを間違えた後だった。誰も問わなかったのは、それがまだ役に立っているのかどうかだ。CLAUDE.mdは毎セッション読み込まれ、毎ターン再送信される。もしモデルがどうせ正しいことをしたのなら、そのトークンは税金であり、コンテキストウィンドウにはいくらかかるのか で説明しているとおり、毎ターンの税金は見た目より速く積み上がる。
テスト
イシューは新規登録者向けの時間指定メールシーケンスだった。管理者が「0日目: ようこそ」「5日目: まもなくトライアル終了」のようなステップを定義し、バックグラウンドタスクが各アカウントに正しい日にメールを送り、その人が有料プランを購入したら停止し、ローンチ前に作成されたアカウントはスキップする。マイグレーション、リポジトリ、サービス、Celery beatタスク、RESTエンドポイント、エージェント用のMCPツール、そして11言語のコンソールUIが必要だ。これは現実的な1週目向けの機能であり、見落としやすいエッジケースがいくつもある。
各実行はOpus 5.5上のヘッドレスのClaude Codeセッションで、専用のクローンとデータベースにサンドボックス化され、コミットをドラフトPRにプッシュしてCIの結果をセッションにフィードバックするスクリプトを使い、最大3ラウンドまで行った。コストは、メインセッションとすべてのサブエージェントのClaude Code自身の total_cost_usd をAPI定価で計算したものだ。私はサブスクリプションを支払っているので、これは作業量の指標であり、私の請求額の指標ではない。
7つの構成:
| 構成 | 実行回数 | |
|---|---|---|
| A | 33KBのCLAUDE.md全体と10スキル、パイプライン用プロンプト(計画→実装) | 2 |
| B | CLAUDE.md全体とスキル、素のプロンプト | 3 |
| C | CLAUDE.mdなし、スキルなし、素のプロンプト | 2 |
| D | CLAUDE.md全体 + architectスキル、素のプロンプト | 2 |
| E | 8KBのCLAUDE.md、architect、grain-ponytail、unslop、パイプライン用プロンプト | 1 |
| F | 5.5KBのCLAUDE.md、スキルなし、素のプロンプト | 1 |
| G | 8KBのCLAUDE.md、architect、grain-ponytail、unslop、素のプロンプト | 2 |
A〜Dが先に行った。E〜Gは彼らが示したものから作られ、3回目のBは対照としてそれらと並行して実行した。8KBのファイルは5.5KBのものに、スキルの短い一覧とそれらをいつ読み込むか、そしてarchitectスキルにSonnetへ委任させるモデルルーティングのルールを足したものだ。
その後、各結果は2名のOpusレビュアーに渡された。彼らが見たのは文字1つ、差分、リポジトリ、イシューだけだ。彼らは承認前に求めるすべての変更を列挙し、ブロッカー、重大、軽微、些細の4段階で格付けし、各受け入れ基準をファイルと行に対して確認した。
コスト
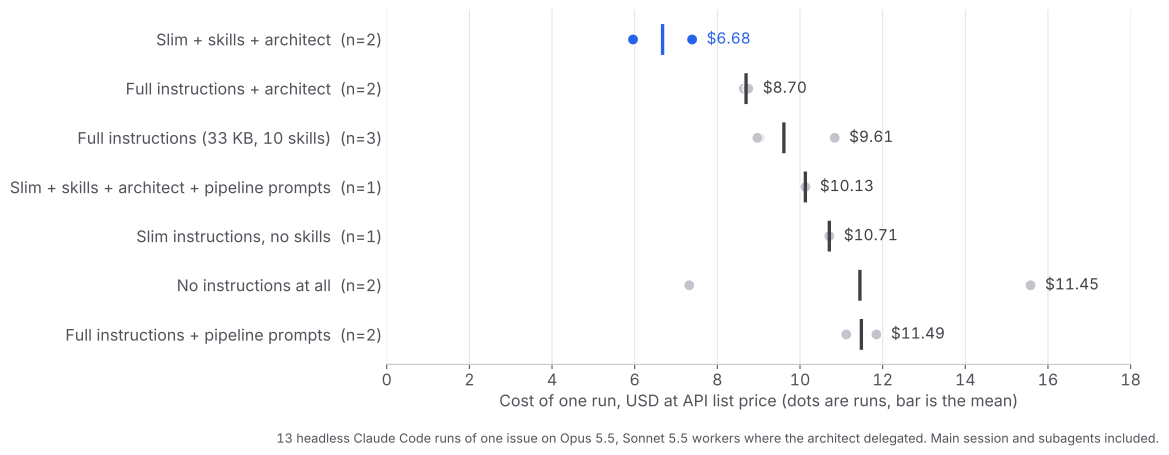
勝った構成Gは$5.96と$7.39だった。パイプライン用プロンプト付きのフル構成Aは$11.12と$11.85だった。差は主にターン数と、各ターンが運ぶものによる。AのメインセッションはOpus上で172ターンと144ターン、入力トークンは2,400万〜2,800万だった。Gは79ターンと95ターンで1,300万〜1,600万、そして約60ターン多くをSonnetワーカーに渡しており、その料金はごく一部だ。Gはまた約21分で作業を終えたのに対し、Aは45分だった。
このグラフで私が驚いた点が2つある。指示が一切ないのは安い選択肢ではない。その2回の実行は$7.32と$15.58で、高いほうはCIにも失敗し、テスト中で最大の差分を書いた。そしてスキルなしの5.5KBのファイルFは、フル構成より安くはなかった。より多くのコード、製品コード1,601行を書き、その分を支払った。Gの節約は短いファイルだけから来るものではない。短いファイルに加えて、仕事の進め方を変える2つのスキルから来るのだ。

ニュースレターに登録
最新のヒント、トレンド、お得な情報を無料で入手。
品質
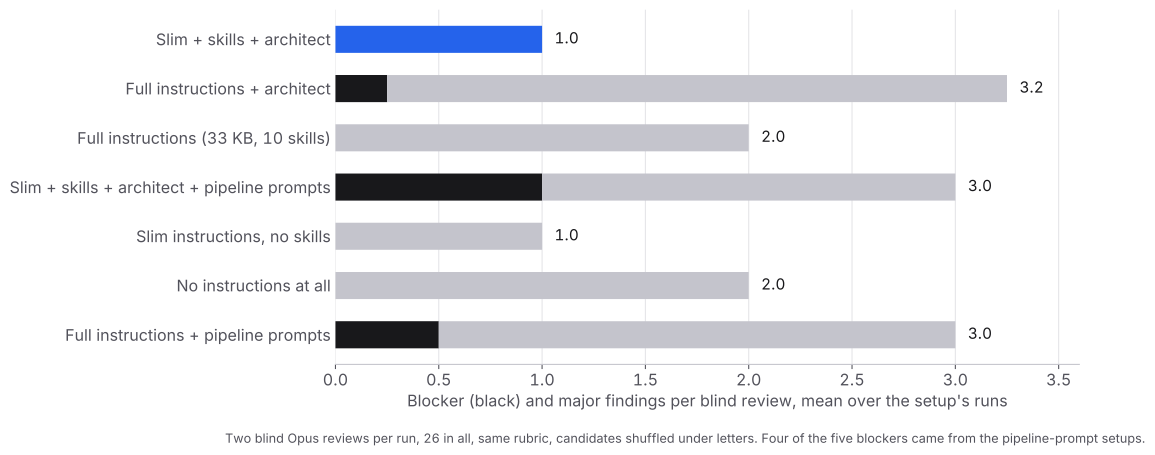
最も安い構成が、最も深刻な指摘も少なかった。ブロッカーはゼロ、その2回の実行でレビューあたり1.5件と0.5件の重大な指摘だった。CLAUDE.md全体のBは、その3回すべてで重大2.0件で、CLAUDE.mdなしとまったく同じだった。
これが私が最も気にしている結果だ。このファイルには、セキュリティ、権限、クレジットに関する長いセクションがあり、それはかつてエージェントがそれらを飛ばしたから書かれた。ファイルがあってもなくても、レビュアーは同じ数の深刻な問題を見つけ、同じ種類の問題が構成をまたいで再発した。支払った後にキャンセルする登録者、ワーカーが途中で失敗したときにメールが失われるか二重に送られる問題、表示できない内容を上書きしてしまうエディタなどだ。これらは時間経過に伴う状態についての推論の穴である。CLAUDE.mdのどんなルール一覧もこれらをカバーしていなかった。まだ思いついていないエッジケースのルールは書けないからだ。
それをカバーしたのは、ラウンド間でのarchitectスキルの変更だった。メインモデルがブリーフを書く前に、今では表を書く。各受け入れ基準、それが依存する状態が時間とともに変化したときに何が起きるか、そして決定済みの挙動だ。各行は名前付きのテストとともにブリーフに入る。Gの実行は774行と818行のテストを書き、Bの510〜670行に対して多かった。
計画ステージ
AとEは、私たちのCIパイプラインのプロンプトを実行した2つの構成だ。計画を書く計画プロンプト、次にその計画を読んで実行する実装プロンプトである。それぞれを、代わりに素のプロンプトを与えた双子と比べてみよう。Aは1回あたり$11.49でBの$9.61に対して高く、Bにはなかったブロッカーがあった。Eは$10.13でGの$6.68に対して高く、Gにはなかったブロッカーがそのレビューごとに1件あった。
理由はこうだと思う。計画とは、モデルが自分のために書いた文書であり、それを外部からの指示として読み返さなければならない。2番目のセッションは計画を仕様として扱い、それが間違っているところでも従い、コードに見つけたものと突き合わせるのにターンを費やす。これほど有能なモデルなら、これから作業を行うそのセッションの中で計画するほうがうまく計画できる。そこでは計画とコードが同じコンテキストにあるからだ。
計画のうち生き残った部分はブリーフだ。メインモデルがスライスをSonnetワーカーに渡すと、ワーカーは空のコンテキストから始め、言われたとおりのものだけを作る。その引き継ぎには書かれた決定済みの記述が必要だ。目標、ファイル、踏襲するパターン、エッジケース、書くべきテスト。自分のための計画はオーバーヘッドである。他人のためのブリーフだけが、作業を伝える唯一の方法だ。
grain-ponytailがやったこと
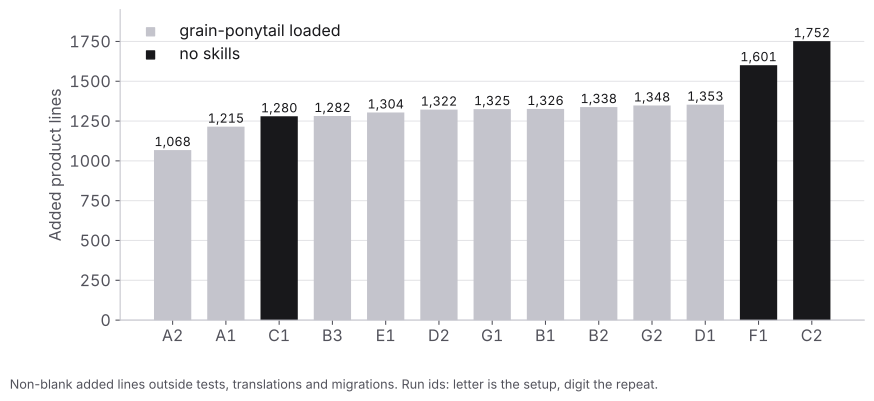
grainに沿ってコードを書く のスキルは、モデルに最も近い既存例を踏襲し、動く最小限のコードだけを出すよう指示する。これを読み込んだすべての実行は1,068〜1,353行の製品コードを書いた。最大の2つの差分1,601行と1,752行は、スキルなしの実行から出た。スキルなしのある実行は1,280行にとどまったので、スキルだけでサイズが決まるわけではないが、裾は削られた。
これは、どんな種類の指示がまだ報われるかを示す最も明快な例でもある。「最も近い例を踏襲せよ」は、モデルが書くすべてのファイルでの振る舞いを変える。「関数にはsnake_caseを使え」は、すでにやっていることの言い換えだ。
レビューがそれでも捕まえたもの
勝った実行はクリーンではなかった。テスト後にG2の作業をmainにリベースし、私たちの完全なPRチェックに通した。それは差分をレビューし、各指摘を失敗するテストで証明し、実際のブラウザで変更を動かす。そこで見つかったのは、管理者がMCP経由で作成されたステップを編集したとき、ステップエディタが最初のHTMLブロック以外のすべてのブロックを落とすこと、そして失敗したクレームの解放が一部のユーザーにメールを二重に送りうることだった。どちらもPRが人間のレビューに上がる前にテスト付きで修正された。
ブラインドレビュアーはまた、architectの実行のほうがフル指示の実行より過剰設計を多く指摘した。Gはレビューあたり2.5件で、AとBの実行の0〜1.0件に対してだ。深刻な指摘は少なく、些細な指摘は多い。私はその交換を受け入れるが、それは交換ではある。
私が変えたこと
- 33KBのCLAUDE.mdは12KBのAGENTS.mdになり、Codexもそれを読む。CLAUDE.mdは今ではそれをインポートするだけだ。コマンド、テストの頻度、アーキテクチャ、そしてモデルがコードから推測できないルール(どのパスがクリティカルか、2つのエージェントサーフェスは歩調を合わせ続けなければならないことなど)は残した。
- 計画ステージはパイプラインから削除した。トリアージはイシューを直接実装段階に渡し、そのプロンプトは6ステップに縮んだ。イシューを読む、ブランチを切る、architectとgrain-ponytailスキルを読み込む、テストする、コミットする、ドラフトPRを開く。
- architectスキルにはエッジケース表、ブリーフ内のTestsフィールド、そしてブリーフではなくイシューに対して差分全体を確認する最終パスが加わった。そのバージョンはgithub.com/LivinTribunal/architect-skill で公開している。
リポジトリの変更は執筆時点でレビュー中だ。
ここから持ち帰るべきこと
あなたのCLAUDE.mdが1件のインシデントごとに育ってきたのなら、それはモデルがすでに従っているルールに対しておそらく支払っている。モデルがコードを読んでも分からないことだけに削り、より多くの指示のほうが安全だと信じるのではなく、実際のタスクで前後を測定しよう。
仕事の進め方を変える指示は残す。誰がコードを書くか、スライスをどうブリーフィングするか、どの既存パターンをコピーするか。メインモデルが現行のフロンティアモデルなら、計画してから実行するパイプラインは捨てる。ワーカーのためのブリーフを書き、自分のための計画は書かない。
手法
2026年10月5日にClaude Code 2.1.289をヘッドレスで13回実行、メインモデルはOpus 5.5、ワーカーはarchitectスキルが委任した場合はSonnet 5.5。すべての実行はFlowHuntモノレポの1つのコミットから始まり、それぞれAPFSクローン内で専用のPostgresデータベースを持ち、他の実行および実験自体のファイルからサンドボックス化された。ブローカーが各実行のコミットを凍結されたベースブランチに対するドラフトPRにプッシュし、CIの結果でセッションを再開、最大3ラウンドまで行った。コストはセッションあたりの最大 total_cost_usd をメインセッションとそのサブエージェントについて合計したもの。製品コード行数は、テスト、翻訳、マイグレーションを除いた空白以外の追加行である。
各結果はOpusによる2回のブラインドレビューを受け、ルーブリックは1つだった。正しさ、受け入れ基準、grain、プライベートフィールドと隠れた状態、過剰設計、セキュリティと権限、テスト、マイグレーション。候補は文字の下でシャッフルされ、レビュアーはリポジトリを読めるが何も実行できなかった。レビューあたりの指摘は構成の実行回数で平均した。構成あたり1〜3回の実行なので、単一構成の平均はノイズが多いものとして扱ってほしい。上記の結論は、両ラウンドを通じて保たれたものだ。
