


要点
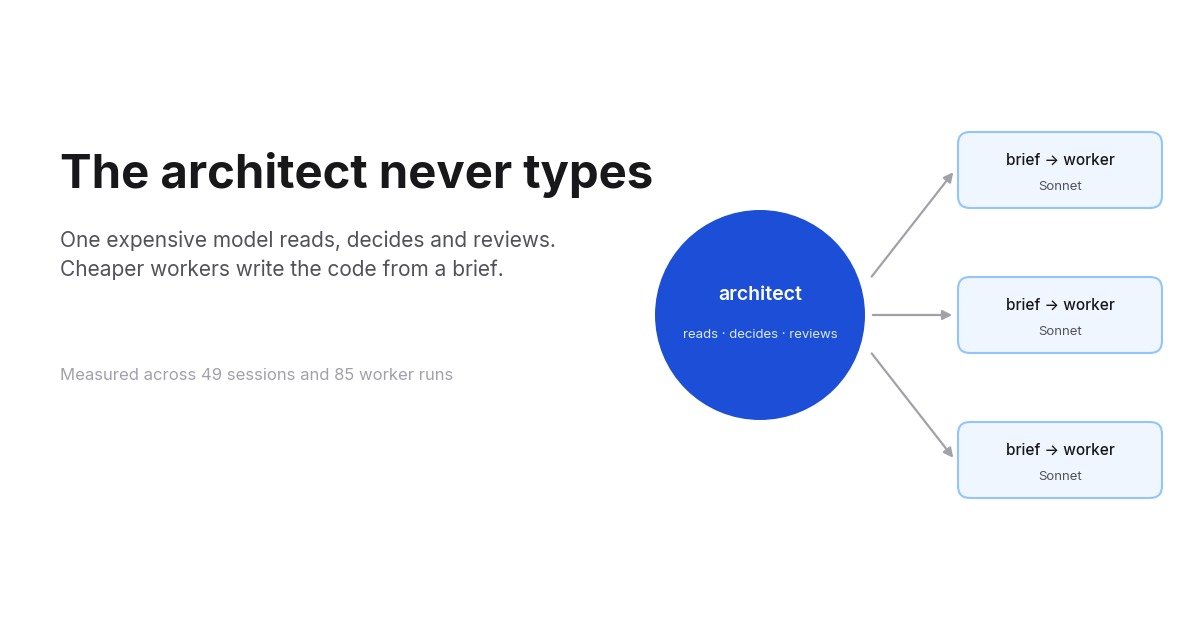
- 5週間、私はコーディングエージェントを分業体制で動かした。メインモデル(Opus、後にFable)が読み、判断し、レビューし、ワーカーエージェントが書かれたブリーフからコードを書く。私はこれをアーキテクトパターンと呼んでいて、今では公開スキルになっている:architect-skill on GitHub 、MITライセンス。
- メインモデルはタイプするのをやめた。49回のアーキテクトセッションで、1,467プロンプトの中でソースファイルを編集したのは6回だった。同じ週に275回の通常セッションでは、3,081プロンプトで244ファイルを編集した。100プロンプトあたり0.4回対7.9回である。
- プロンプトあたりの総トークン数は減らなかった。2週間はひどく増え、その後は通常セッションと同水準まで戻った。変わったのは誰がそれを消費したかである。ワーカートークンに占めるOpusの割合は100%から約4%になり、9月14日以降、アーキテクトセッションの1プロンプトはメインモデルで36.4万、Sonnetワーカーで20.5万、Opusワーカーで8万の加重トークンを消費している。
- サブスクリプションが気にするのはこの内訳である。Claude Maxは全モデル共通の週次上限を各モデルのレートで計量するので、SonnetのトークンはOpusのトークンの40%で上限を消費し、Fableにはワーカーが触れることのない、より厳しい専用の週次上限がある。
- 私はワーカーをヘッドレスなClaude Code経由でDeepSeekに流すことも試した。定価で計算すると、同じトラフィックは10ドルで、Sonnetなら202ドル、Opusなら505ドルだった。サブスクリプションではこの節約は存在しない。すでに支払い済みだからである。私はそれをやめた。トークン単位で支払っている人は、それでもこの節を読んでほしい。数字こそが要点だからである。
これはシリーズの3本目の記事です。1本目はある設定がコンテキストウィンドウに何をしたかを計測し(トークン17%削減 )、2本目はコンテキストウィンドウにかかるコスト とその理由を説明しています。今回はもう一方のレバー、つまりコンテキストの大きさではなく、それをどのモデルが抱えているかについてです。
このパターンとは何か
コーディングエージェントのセッションには2種類の仕事がある。考えること。コードベースを読み、何を変えるかを割り出し、名前やシグネチャやエッジケースを決め、差分を確認する。そしてタイプすること。コードを書き、テストファイルを走らせ、リントを直す。フロンティアモデルがその価格に見合うのは考える方である。タイプする方はそうではない。そのほとんどは直前の判断によって決まっており、決定済みの計画を実行するのは、小さなモデルでも大きなモデルとほぼ同じようにできる。
そこでこのスキルはセッションを分業する。メインモデルがアーキテクトである。ソースファイルを編集すること以外、メインループのすべてを行う:
- 要件を問い詰め、コードベースを調査する。
- 設計を決める:アプローチ、データフロー、名前、シグネチャ、エッジケース。踏襲すべき最も近い既存パターン。根本原因を直す最小の変更。
- 互いに重複しないファイル群を持つスライスに分解する。
- スライスごとに実装ブリーフを1つ書く。
- 返ってきた差分をレビューし、ゲートを実行し、コミットする。
ワーカーは新しいコンテキストウィンドウを持つサブエージェントである。ブリーフだけを受け取り、コードを書き、ブリーフが指定したテストファイルを実行し、短い構造化レポートを返す。そしてそのコンテキストは破棄される。ワーカーがメインセッションの履歴の一部になることはない。これは聞こえる以上に重要である。メインセッションが読んだものはすべて以降の呼び出しで再送されるので、自分のコンテキストで12ファイルとテストログを読むワーカーは、それらすべてをアーキテクトの請求から外しておける。
ブリーフが契約のすべてである。私のものには7つのフィールドがあり、このスキルは主にそれらをうまく埋めることに関するものだ:
## Implementation brief: <slice>
Goal: one sentence, observable outcome
Context: what exploration found: excerpts, the pattern to mirror, line anchors, gotchas
Files: paths to create/modify, exclusive ownership for this slice
Design: the decided approach: data flow, names, signatures, edge cases
Constraints: project rules that apply: style, layers, security
Out of scope: what not to touch, including files owned by other slices
Verify: exact commands and expected outcome
ブリーフに含まれるのは選択肢ではなく決定である。まだ2つのアプローチを天秤にかけているなら、委譲する準備はできていない。
例外が1つある。委譲には固定のオーバーヘッドがある。ブリーフの作成、ワーカーの起動、レポートの読解、差分のレビュー。タイポの修正、設定値、バージョン更新、不要なキーの削除、1行の修正とそのリグレッションテスト。そうしたものはアーキテクトが直接編集する。ブリーフの方が編集より高くつくからだ。基準はコストであり、行数ではない。編集に設計上の判断が必要になった瞬間、あるいはリポジトリが重要と印を付けたパスに触れた瞬間、それはワーカーへ回される。
サブスクリプションが計算を変える理由
トークン単位で支払っているなら話は単純である。Opus 5は入力100万トークンあたり5ドル、出力100万トークンあたり25ドル、Sonnet 5は2ドルと10ドル。OpusからSonnetへ移る実装トークンはすべて、以前の40%のコストになる。
私はサブスクリプションを支払っている。そこでは話が違い、そして私が思うに、より強い。Claude Maxには週次上限が1つではなく2つある。すべてのモデルにまたがる上限で、すべてのトークンがそのモデルのレートで消費する。そしてFableだけが消費する、より厳しい別の上限。Opusには専用の上限がない。このことが分業に2つの効果をもたらす。Sonnetワーカーが行う仕事は、共有上限をOpusワーカーが消費するレートの40%で消費するので、セッションのトークンの3分の2をSonnetへ移せば、総トークン数が変わらなくても週がより長く持つ。そしてアーキテクトがFableであるとき、タイプに使わなかったトークンは、最初に尽きる上限に残されたトークンである。したがって、アーキテクトパターンが通常セッションとまったく同じ数のトークンを消費したとしても、誰が消費するかが週の終わりを決めることに変わりはない。
その「たとえ〜でも」が、実際にはかなり大きな仕事をしていた。
トランスクリプトが語るもの
Claude CodeはすべてのセッションをJSONLトランスクリプトに、すべてのワーカー実行をセッションディレクトリ配下の兄弟ファイルに書き出す。私は8月19日以降のすべてを持っている。3つ以上のプロンプトがある対話セッションが324件、うち49件がこのパターンを使った。つまり実装エージェントを起動したか、ブリーフを送ったセッションである。トークンは請求と同じ方法で加重する。新規入力は1、キャッシュ書き込みは1.25または2、キャッシュ読み取りは0.1。CIの実行は除外する。
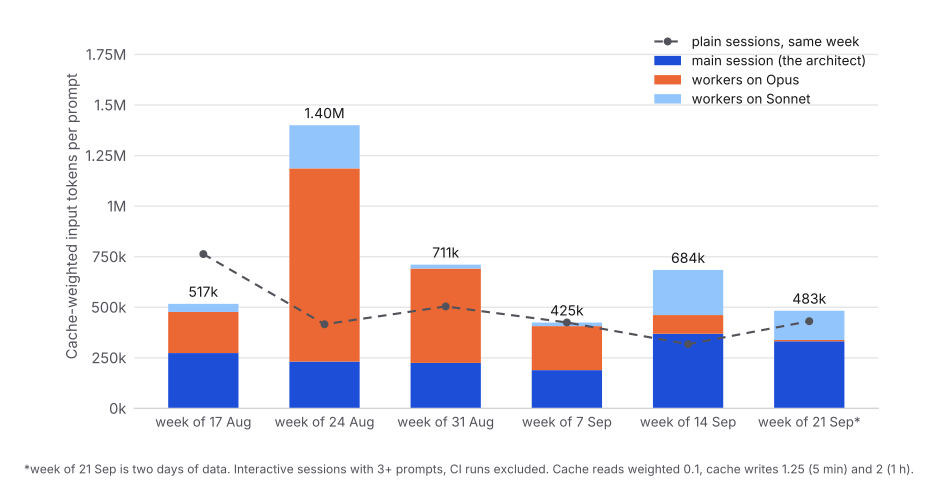
左から右へ読むと、最初の2週間は成功談ではない。
8月24日の週、アーキテクトセッションは1プロンプトあたり140万の加重トークンを消費した。同じ週の通常セッションは42万だった。3.5倍で、その超過分のほとんどはオレンジ、つまりOpusワーカーだった。私はワーカーに良いモデルとルールなしを与え、ワーカーはルールなしの良いモデルのように振る舞った。その週のOpusワーカー実行の中央値は176ターンだった。いくつかはバックエンドのフルテストスイートを走らせ、その出力約100 KBを、以降の毎ターン再送されるコンテキストに入れた。私がすでに対策を締め始めていた後の9月14日の、6ワーカーのあるセッションは、約6,000行の差分を生むために1,585ターンで2億4,500万入力トークンを燃やした。プロンプトキャッシュはずっと91.6%のヒット率で効いていた。請求を膨らませたのは価格ではなく量だった。
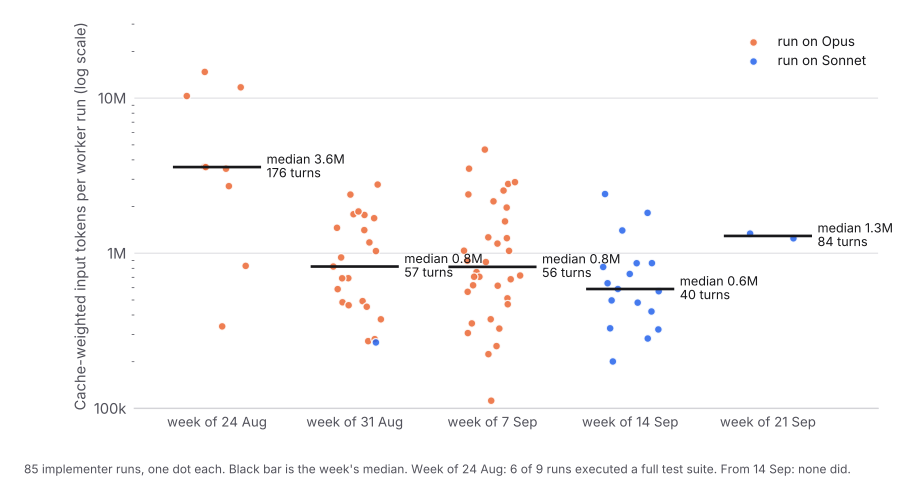
ワーカーの帯は、ルールがどこに効いたかを示している。そのうち3つがほぼすべての仕事をした。私はそれらをブリーフではなくエージェント定義に書き込んだので、私が覚えていてもいなくても適用される:
- ワーカーは決してフルテストスイートを実行しない。ブリーフが指定したテストファイルを実行する。ゲートはアーキテクトが実行する。
maxTurnsはエージェント定義で上限を設ける。Sonnetは140、Opusは160。250ターンを要するスライスは、ブリーフの書き方が間違っていた。- スライスは約12ファイル以内、ブリーフは約8 KB以内に保つ。ブリーフも毎ターン再送される。
8月31日の週には、ワーカー実行の中央値は57ターン、80万加重トークンだった。デフォルトのルートをSonnetに移した9月14日以降は40ターン、60万で、それ以来フルスイートを走らせたワーカーは1つもない。
プロンプトあたりの合計もそれに従った。直近4週で71.1万、42.5万、68.4万、48.3万、通常セッションは50.5万、42.5万、31.8万、43.1万。アーキテクトセッションは今や通常セッションとほぼ同じコストである。4週のうち2週は少し多く、1週は少し少ない。それと引き換えに得られるものが次の2つのグラフである。

ニュースレターに登録
最新のヒント、トレンド、お得な情報を無料で入手。
メインモデルはタイプするのをやめた
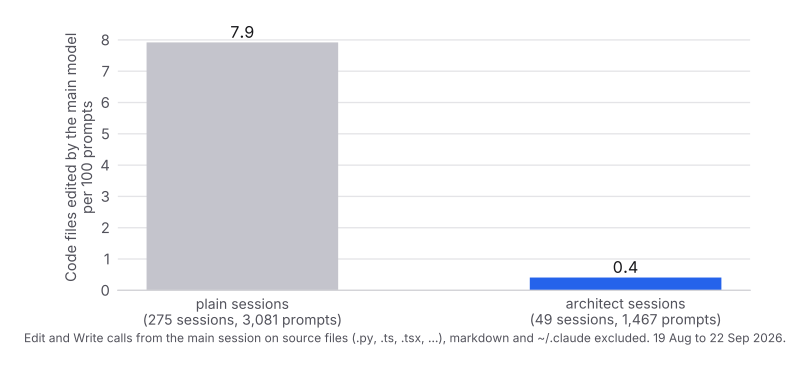
これは私が変えようとした数字で、実際に変わった。通常セッションではメインモデルは3,081プロンプトでソースファイルに対して244回のEditまたはWrite呼び出しを行った。アーキテクトセッションでは1,467プロンプトで6回だった。その6回はすべて、私が説明できる小さな修正の例外である。
一方でワーカーは生産的だった。85回のワーカー実行で2,510回のソースファイル編集が行われた。メインループとワーカーを合計すると、アーキテクトセッションは1,467プロンプトから2,516回のコード編集を生み、通常セッションは3,081プロンプトから943回だった。コード編集1回あたり、アーキテクトセッションは合計40.3万加重トークン、うちOpus系モデルに33万を費やした。通常セッションは141万と132.4万だった。この比較は慎重に扱いたい。2つの集団は同じ仕事ではないからだ。コードを委譲した時点でセッションはアーキテクトに分類されるので、アーキテクトセッションは構造上コーディング寄りであり、通常セッションには何も編集しない調査・レビュー・デバッグが含まれる。これは「このパターンはトークンあたり大量のコードを書く」と読むべきで、4倍の効率という主張ではない。
より明確な主張はモデルの内訳である。9月14日以降、アーキテクトセッションの1プロンプトはメインループで36.4万加重トークン、Sonnetワーカーで20.5万、Opusワーカーで8万を消費する。全ワーカートークンに占めるOpusワーカーの割合は8月に100%、9月21日の週に約4%だった。Maxプランでは、これは実装作業のほぼすべてで共有週次上限がOpusのレートではなくSonnetのレートで消費されるということであり、そのどれもFableの上限に触れていない。
改善しなかったことが2つあり、グラフに逆のことをほのめかさせるよりは明言しておきたい。メインセッション自身のコンテキストは縮まなかった。アーキテクトセッションは100プロンプトあたり8.7回コンパクト化し、通常セッションは4.7回だった。アーキテクトはブリーフを書く前に大量に読むからだ。そしてこのパターンは小さなタスクでは実時間で遅い。ワーカーの起動とレポートには、自分で編集するだけなら払わなくてよい数分がかかる。小さな修正の例外があるのは、スキルの最初のバージョンにそれがあり、私が2行の変更のために3 KBのブリーフを書くのを自分で見ていたからだ。
DeepSeekへの寄り道
ワーカーがSonnetになった時点で、次に明らかな疑問は、ワーカーはそもそもClaudeのモデルである必要があるのか、だった。9月13日から18日まで、私は ANTHROPIC_BASE_URL を互換エンドポイントに設定したヘッドレスClaude Codeを通して、ワーカーをDeepSeek V4.1 Flashに向けた。最初はOpenRouter経由、その後はネイティブで。ブリーフの形式もレポートの形式も同じ、アーキテクトも同じ。2,732回の呼び出し、4億3,100万入力トークン(うち88%はキャッシュ読み取り)、170万出力トークン。
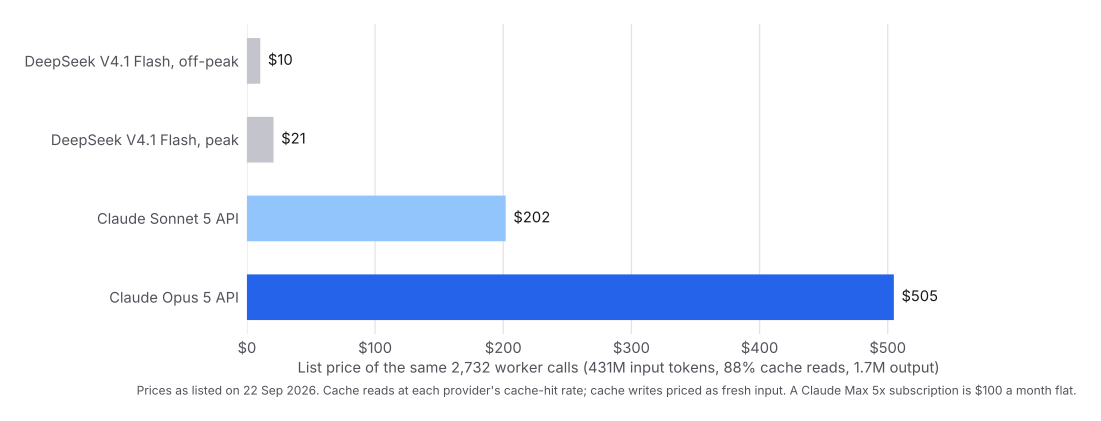
9月22日の定価では、このトラフィックはDeepSeekオフピークで約10ドル、ピークで21ドル、Sonnet APIで202ドル、Opus APIで505ドルかかる。もし私がトークン単位で支払っていたなら、これが記事の見出しになっていただろうし、私は使い続けていただろう。
私はトークン単位では支払っていない。そしてそれが議論のすべてである。Maxサブスクリプションは、週次上限を30%使っても100%使っても月100ドルである。ワーカーのトラフィックをDeepSeekに移しても、その請求は1セントも下がらなかった。それどころか、すでに容量を支払い済みのプランの容量を節約するために、週10〜21ドルの第2の請求が上乗せされた。「APIより安い」と「自分が払っているものより安い」を混同していたのであり、自分が払っているものが定額であるとき、この2つは同じではない。サブスクライバーにとって正しい比較は、DeepSeek対2つ目のサブスクリプションである。そこでは2つ目のClaudeプランやCodex付きのChatGPTプランが、DeepSeekを適度に使う1か月とほぼ同じ費用で、専用の週次上限と専用のモデルが付き、監視すべき従量課金もない。
もう半分は品質だった。5つのバックエンドスライスはクリーンに返ってきて、そのままコミットされた。あるフロントエンドスライスはエクスポートされたシンボルを削除し、その利用側をすべて手つかずに残したので、ツリーはコンパイルできず、後のスライスが後始末をすることになった。これはまさに、仕様を実行するモデルが持つ失敗であり、兄弟からコンポーネントの形を推論するモデルが持たない失敗である。スキルは今そう書いている。共有APIサーフェスの変更はSonnetへ回し、ワーカーのルールは「同じ実行内ですべての利用側を移行せずにエクスポートされたシンボルを削除または改名しない」と読む。DeepSeek Flashは優れた実行者である。アーキテクトパターンが必要とするのは、ブリーフが利用側を数え落としたことに気づくワーカーであり、それはブリーフには提供できない唯一のものである。
したがって今日のルーティングテーブルには2つの行がある。定型作業、満たすべきテストを伴う詳細なブリーフに基づくバックエンド作業、既存のデザイン文法に従うフロントエンド作業、共有APIサーフェスへのあらゆる変更は sonnet-implementer へ。難しさが推論にある作業は opus-implementer へ。非同期の競合、ブリーフが列挙できない箇所に正しさが依存する複数箇所のリファクタリング、単一のテストでは証明できないバックフィルマイグレーション。形でルーティングし、決してリスクでルーティングしない。リスクは差分がどれだけ厳しくレビューされるか、人間が署名するかを変える。誰が書くかは決して変えない。
レビューループこそ、このパターンが元を取るか失うかの分かれ目
ワーカーのレポートは主張である。このスキルのレビューループは短く、その一行一行は焼かれた経験から来ている:
- レポートと実際の
git diffを読む。ワーカーが引用したdiffstatと自分が見たものを照合する。 - その主張が重要なものであれば、主要な検証を自分で再実行する。
- 問題を見つけた? 修正を同じワーカーに送る。ワーカーはまだコンテキストを持っていて、止まったところから再開する。手で直さない、新しいワーカーを起こさない。
- 修正が2回失敗したら、それはモデルが小さすぎるのではなくブリーフの記述が不足していたということ。分解し、欠けていた抜粋をContextに入れ、再実行する。より大きなモデルに登るのはやめる。同じ誤解をより流暢に実装するだけだから。
- 何かを受け入れる前にスコープされたゲートを実行する。触れたテスト、触れたファイルに対するリンター、リポジトリが持つ規約スクリプトなど。
トランスクリプトでは、ワーカー実行あたり約1回の修正を送った。85回の実行に対して52回であり、Opusの実行7回が160ターンの上限に達し、そのすべてが今なら分割するスライスだった。私が見ているのはこの2つの数字である。実行あたりの修正が増えれば、私のブリーフが怠惰になっている。ワーカーが上限に達すれば、私のスライスが大きすぎる。
ここから何を持ち帰るか
トークン単位で支払っているなら:高価なモデルを判断とレビューに置き、安いモデルを実装に置き、どの安いモデルを選ぶ前にワーカーのトラフィックを定価で計算せよ。4本の棒グラフがその議論である。
サブスクリプションを支払っているなら:このパターンはトークン数を削らない。実装トークンを、共有週次上限を最もゆっくり消費するモデルへ移し、Fableだけがすべき仕事のためにFableの上限を取っておき、最も高価なモデルがタイプにターンを費やすのを止める。すでに買った容量を「節約」するために、横に従量課金のAPIを足してはいけない。ワーカーの容量が足りなくなったら、2つ目のサブスクリプションを買えばよい。
どちらにせよ、これを機能させたルールは退屈なものだった。ワーカーにフルテストスイートを走らせない。ターン数に上限を設ける。小さなスライス、短いブリーフ。同じワーカーを一度だけ修正し、それからブリーフを直す。
スキル、3つのエージェント定義、ガードフックはMITライセンスのもと github.com/LivinTribunal/architect-skill にあります。ワーカーに、自分が着地するリポジトリに合ったコードの書き方を伝える相棒のスキルは grain-skill で、それについての記事はリポジトリの流儀に沿ったコード です。
方法
この記事が説明するものはすべて github.com/LivinTribunal/architect-skill にあります。スキル本体、ブリーフのテンプレート、ルーティングテーブル、ターン上限とコンテキストルールを持つ3つの実装エージェント定義、そしてガードフック。インストールすれば、以下の数字が生まれた構成が手に入ります。
セッションは2026年8月19日から9月22日までのClaude Code JSONLトランスクリプトで、entrypoint はcli、ユーザープロンプトが3つ以上。セッションがアーキテクトとして分類されるのは、opus-implementer、opus-implementer-xhigh、sonnet-implementer のいずれかを起動した、ds-slice ワーカーを実行した、アーキテクトスキルを呼び出した、または実装ブリーフを含むメッセージを汎用エージェントに送った場合である。後者は名前付きエージェントが存在する前の初期数週間の動き方である。ワーカー実行は各セッションディレクトリ配下のサブエージェントトランスクリプト。使用量はリクエストIDで重複排除し、新規入力1、5分キャッシュ書き込み1.25、1時間キャッシュ書き込み2、キャッシュ読み取り0.1で加重する。「コード編集」とは .py、.ts、.tsx、.js、.sql などのソースファイルへのEditまたはWrite呼び出しで、markdownと ~/.claude 配下のものは除く。DeepSeekの価格は2026年9月22日のネイティブ定価で、オフピークとピーク、キャッシュ読み取りはキャッシュヒット率、キャッシュ書き込みは新規入力として価格設定している。Claude APIの価格は公表されているOpus 5とSonnet 5の定価で、キャッシュ読み取りは入力の10分の1。9月21日の週は2日分のデータである。
