



MotherDuck MCP インテグレーション
FlowHuntをMotherDuckのDuckDB MCPサーバーと連携し、AIアシスタントやIDE向けに安全でスケーラブル、サーバーレスなSQL分析を実現します。ローカルDuckDBとクラウドベースMotherDuckデータベースを簡単に接続し、クラウドストレージへアクセス、堅牢なセキュリティで分析ワークフローも効...
1 分で読める
AI
MotherDuck
+6
MotherDuck MCP サーバーは、Model Context Protocol (MCP) の実装であり、AIアシスタントやIDEとDuckDB・MotherDuckデータベースを橋渡しします。ユーザーは、ローカルのDuckDBファイルやクラウドのMotherDuckデータベースを標準化されたインターフェースでクエリし、高度なSQL分析を実行できます。このサーバーはハイブリッド実行をサポートし、ローカルとクラウドストレージ(MotherDuckの統合によるAmazon S3など)双方からのシームレスなデータアクセスを実現します。データベース操作をAIシステムのツールとして公開することで、開発者やAIエージェントが、手動設定やサーバー管理なしでデータベースクエリ・データ管理・ワークフロー効率化を容易に行えます。このサーバーレスアプローチは、AI駆動環境から直接、分析・データ共有・パイプライン開発を加速します。
query (string, 必須): 実行するSQL文。
最新のヒント、トレンド、お得な情報を無料で入手。
Node.js と Windsurf をインストールします。
Windsurf の設定ファイル(通常は windsurf.config.json)を開きます。
mcpServers セクションに MotherDuck MCP サーバーを追加します:
{
  "mcpServers": {
    "motherduck": {
      "command": "uvx",
      "args": ["mcp-server-motherduck", "--transport", "stream", "--db-path", "md:"]
    }
  }
}
設定を保存し、Windsurf を再起動します。
Windsurf で MotherDuck MCP サーバーが稼働・利用可能か確認します。
MotherDuckトークン等の機密情報は環境変数で指定してください:
{
  "mcpServers": {
    "motherduck": {
      "command": "uvx",
      "args": ["mcp-server-motherduck", "--transport", "stream", "--db-path", "md:"],
      "env": {
        "motherduck_token": "${MOTHERDUCK_TOKEN}"
      }
    }
  }
}
Claude および Node.js をインストールします。
Claude の設定ファイル(通常は claude.config.json)を開きます。
mcpServers に以下を追加します:
{
  "mcpServers": {
    "motherduck": {
      "command": "uvx",
      "args": ["mcp-server-motherduck", "--transport", "stream", "--db-path", "md:"]
    }
  }
}
Claude を再起動し、UIでサーバーが表示されることを確認します。
上記と同様に環境変数でAPIキーを安全に管理してください。
Cursor をインストール・最新化します。
Cursor の設定(cursor.config.json)を開きます。
mcpServers に以下を追加します:
{
  "mcpServers": {
    "motherduck": {
      "command": "uvx",
      "args": ["mcp-server-motherduck", "--transport", "stream", "--db-path", "md:"]
    }
  }
}
保存して Cursor を再起動します。
機密トークンは環境変数で設定してください。
Cline と必要な依存パッケージをインストールします。
cline.config.json を編集し、以下を含めます:
{
  "mcpServers": {
    "motherduck": {
      "command": "uvx",
      "args": ["mcp-server-motherduck", "--transport", "stream", "--db-path", "md:"]
    }
  }
}
設定を保存し、Cline を再起動します。
motherduck_token を環境変数に設定することでセキュリティを確保します。
FlowHuntでMCPサーバーをワークフローに統合するには、まずMCPコンポーネントをフローに追加し、AIエージェントに接続します。
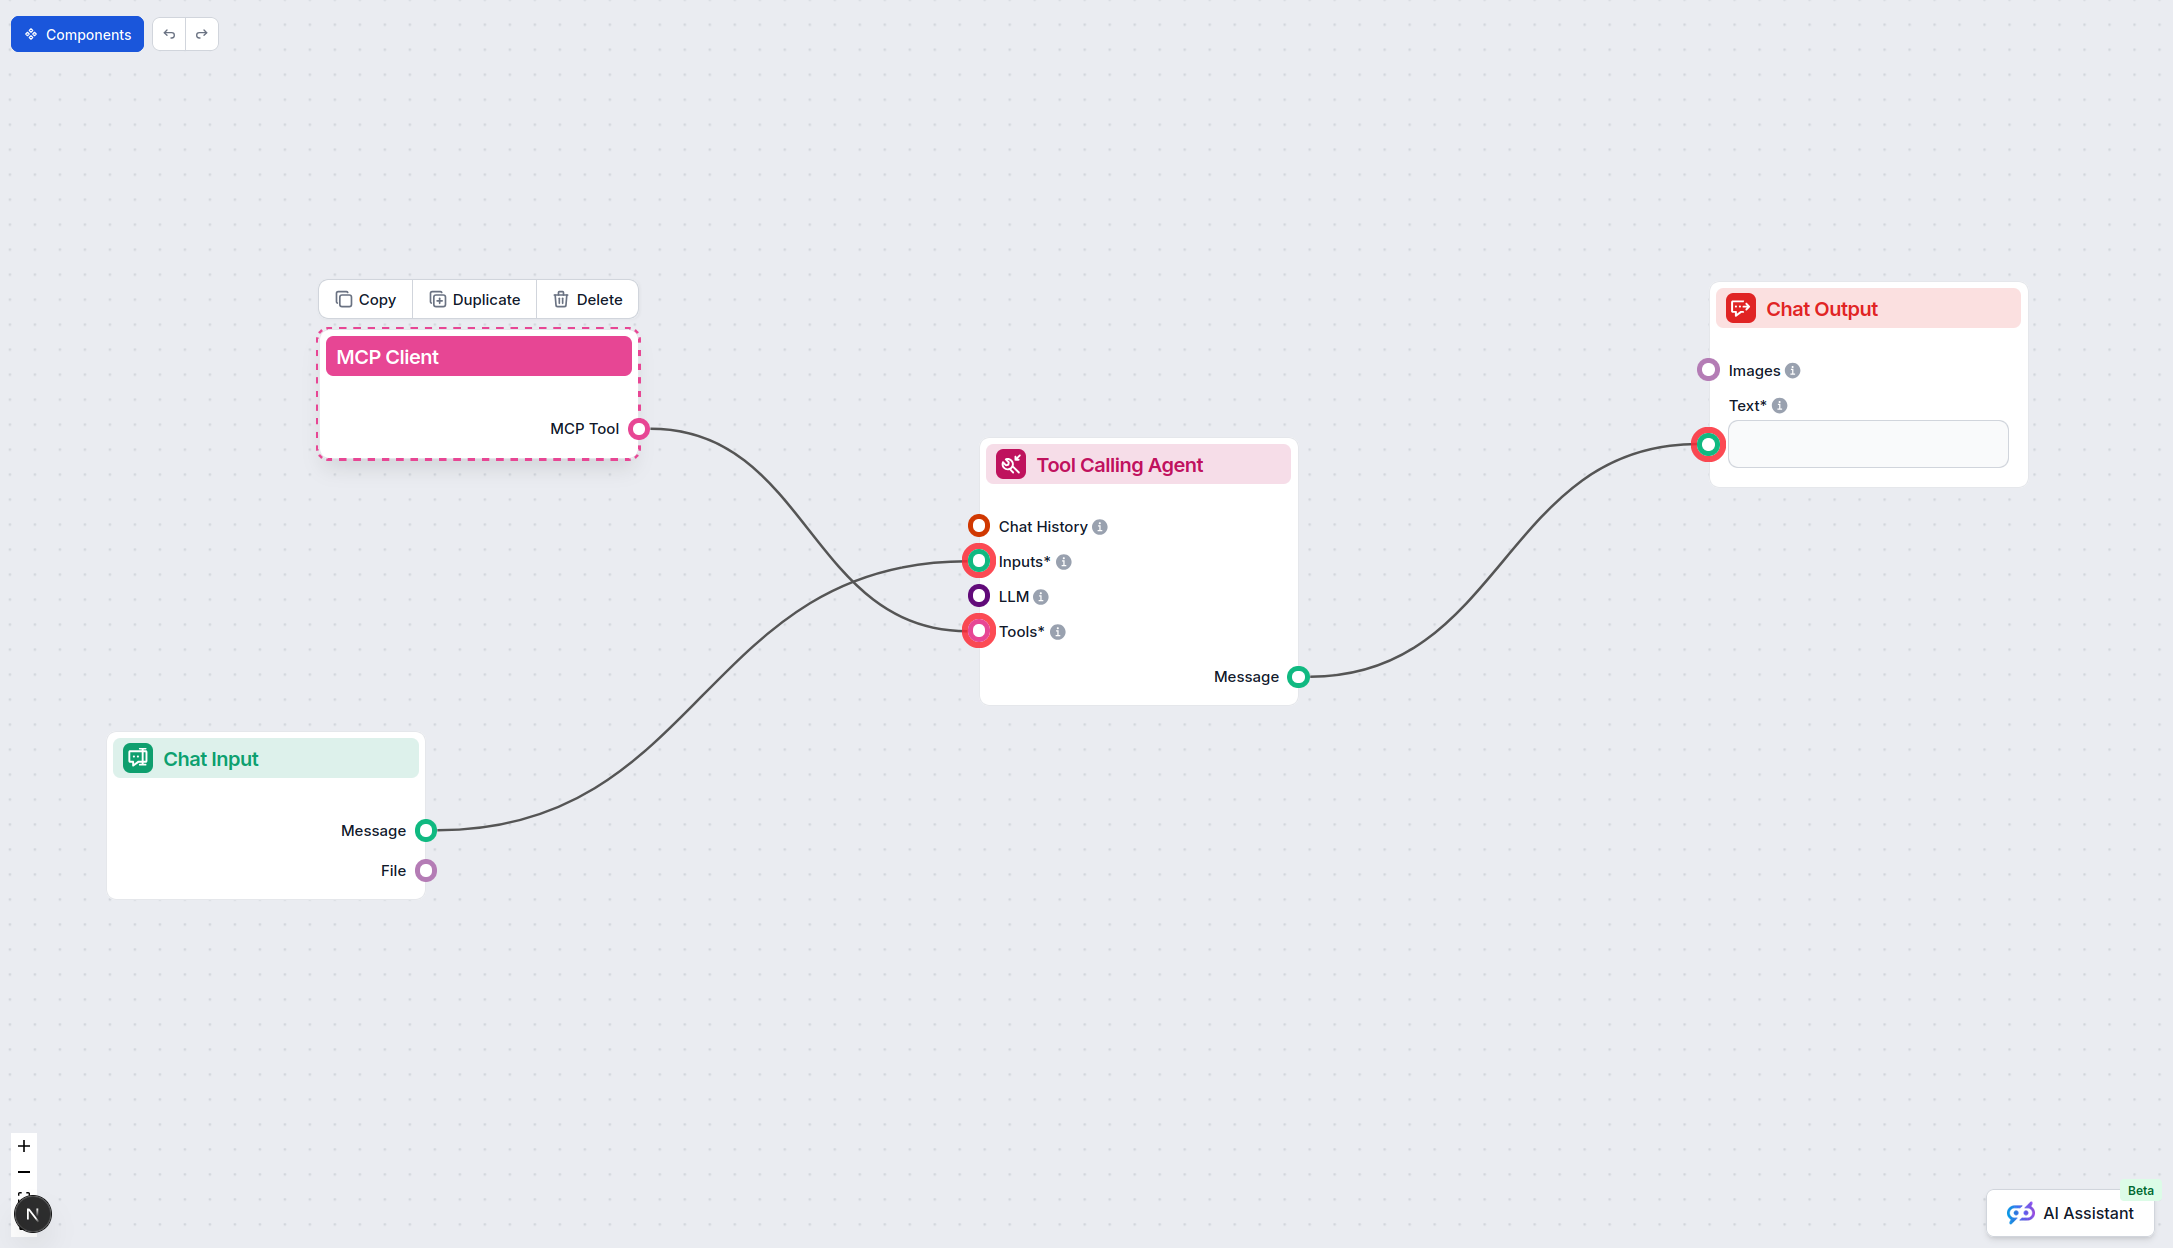
MCPコンポーネントをクリックして設定パネルを開き、「システムMCP設定」セクションで、下記JSON形式でMCPサーバー情報を入力します:
{
  "motherduck": {
    "transport": "streamable_http",
    "url": "https://yourmcpserver.example/pathtothemcp/url"
  }
}
設定が完了すると、AIエージェントがこのMCPをツールとして利用でき、全機能にアクセス可能になります。"motherduck" はご自身のMCPサーバー名に、URLもご自身のMCPサーバーURLへ変更してください。
| セクション | 有無 | 詳細・備考 |
|---|---|---|
| 概要 | ✅ | README.mdに記載 |
| プロンプト一覧 | ✅ | duckdb-motherduck-initial-prompt |
| リソース一覧 | ✅ | 2つのリソース(ブログ記事、YouTube動画)がREADME.mdに記載 |
| ツール一覧 | ✅ | query ツール |
| APIキーの安全管理 | ✅ | motherduck_token を環境変数として利用(README.md) |
| サンプリング対応(評価上重要度低) | ⛔ | 記載なし |
この2つの表から、MotherDuck MCP サーバーは明確なプロンプト・ツール・リソース・セキュリティ対策が記載され、Rootsやサンプリング対応の明記はありませんが、MCPインターフェースによるデータベース分析に実用的かつ堅実な実装といえます。
| ライセンスあり | ✅ (MIT) |
|---|---|
| 1つ以上のツールあり | ✅ |
| フォーク数 | 23 |
| スター数 | 205 |
FlowHuntをMotherDuckのDuckDB MCPサーバーと連携し、AIアシスタントやIDE向けに安全でスケーラブル、サーバーレスなSQL分析を実現します。ローカルDuckDBとクラウドベースMotherDuckデータベースを簡単に接続し、クラウドストレージへアクセス、堅牢なセキュリティで分析ワークフローも効...
YDB MCPサーバーはAIアシスタントやLLMとYDBデータベースを接続し、自然言語によるYDBインスタンスへのアクセス・クエリ・管理を可能にします。AI主導のワークフローを実現し、手動SQLなしでデータベース運用を効率化します。...

JDBC MCPサーバーはAIアシスタントとSQLデータベースをJDBCプロトコルで橋渡しし、リアルタイムクエリ、分析自動化、FlowHuntや他のAI駆動環境内での効率的なデータベース管理を可能にします。...