


짧은 요약
- FlowHunt 백로그에서 실제 이슈 하나를 가져와 Claude Code가 Opus 5.5에서 일곱 가지 서로 다른 지침 구성으로 13번 구현하게 했습니다. 모든 실행은 같은 커밋에서 시작했고, 각자의 클론과 데이터베이스를 가졌으며, 우리의 실제 GitHub CI를 통과했습니다. 두 명의 블라인드 Opus 리뷰어가 각 결과를 평가했습니다.
- 저장소의 33KB CLAUDE.md는 측정 가능한 품질을 사지 못했습니다. 그것을 쓴 실행은 리뷰당 2.0개의 블로커 및 주요 지적을 받았습니다. 지침 파일이 전혀 없는 실행도 같은 결과였습니다. 5.5KB 파일은 1.0이었습니다.
- 별도의 계획 단계는 상황을 더 나쁘게 만들었습니다. 계획 프롬프트를 실행한 뒤 구현 프롬프트를 실행한 두 구성 모두 일반 프롬프트만 준 짝 구성보다 비쌌고, 전체 26개 리뷰의 다섯 개 블로커 중 네 개를 만들어냈습니다.
- 승자는 8KB CLAUDE.md, 스킬 세 개, Sonnet 워커, 일반 프롬프트였습니다. 이 구성의 두 실행은 API 정가 기준으로 평균 $6.68이었습니다. 파이프라인 프롬프트를 포함한 전체 구성은 평균 $11.49로 약 1.7배였고 지적 사항도 더 많았습니다.
- 제가 쌓아 올린 모든 구조에서 살아남은 것은 브리프입니다. 메인 모델이 더 저렴한 워커를 위해 작성하는, 작업 한 조각에 대한 짧고 결정이 끝난 설명입니다. 메인 모델 자신을 위한 계획은 이득이 없었습니다. 모델은 스스로 잘 계획합니다.
이 글은 누가 코드를 타이핑해야 하는지를 측정한 architect 패턴 글을 이어갑니다. 이번 글은 메인 모델이 시작하기 전에 얼마나 많은 것을 알려줘야 하는지를 묻습니다.
왜 이 테스트를 했는가
우리 모노레포에는 에이전트 지침이 잔뜩 쌓여 있었습니다. 루트 CLAUDE.md는 33KB였습니다. 빌드 명령, 테스트 주기, 코드 스타일, 아키텍처, 핵심 경로, 보안 규칙, 권한 및 크레딧 규칙, 두 개의 에이전트 표면, 이슈 등록, PR 관례가 들어 있었습니다. .claude/skills/ 아래에는 스킬 10개가 있었습니다. 그 위에 우리 CI 파이프라인(우리는 harnext라고 부릅니다)이 이슈를 태거, 트리아지 단계, 계획을 이슈 댓글로 작성하는 계획 단계, 그 계획을 다시 읽고 코드를 작성하는 구현 단계를 거쳐 실행했고, 각 단계에는 저마다 긴 시스템 프롬프트가 있었습니다.
그 모든 줄은 이유가 있어 추가된 것이었고, 대개 에이전트가 뭔가를 잘못한 뒤였습니다. 아무도 묻지 않았던 질문은 그것이 여전히 도움이 되는가였습니다. CLAUDE.md는 모든 세션에 로드되고 매 턴마다 다시 전송됩니다. 모델이 어차피 옳은 일을 했을 것이라면 그 토큰들은 세금이고, 컨텍스트 윈도우에 드는 비용 에서 설명하듯이 매 턴의 세금은 보이는 것보다 훨씬 빠르게 누적됩니다.
테스트
이슈는 신규 가입자를 위한 시간 지정 이메일 시퀀스였습니다. 관리자가 “0일차: 환영"과 “5일차: 곧 체험판이 끝납니다” 같은 단계를 정의하면, 백그라운드 작업이 각 계정에 맞는 날에 메일을 보내고, 사용자가 유료 플랜을 구매하면 멈추고, 출시 전에 생성된 계정은 건너뜁니다. 마이그레이션, 리포지터리, 서비스, Celery beat 작업, REST 엔드포인트, 에이전트용 MCP 도구, 그리고 11개 언어의 콘솔 UI가 필요합니다. 현실적인 첫 주 기능이고, 놓치기 쉬운 엣지 케이스가 여러 개 있습니다.
각 실행은 Opus 5.5의 헤드리스 Claude Code 세션이었고, 자체 클론과 데이터베이스로 샌드박스되었으며, 커밋을 드래프트 PR로 푸시하고 CI 결과를 세션에 다시 넣어주는 스크립트를 사용해 최대 세 라운드까지 진행했습니다. 비용은 메인 세션과 모든 서브에이전트에 대한 Claude Code 자체의 total_cost_usd이며, API 정가로 계산했습니다. 저는 구독제를 쓰기 때문에 이것은 제 청구서가 아니라 작업량의 측정값입니다.
일곱 가지 구성:
| 구성 | 실행 수 | |
|---|---|---|
| A | 33KB CLAUDE.md 전체와 스킬 10개, 파이프라인 프롬프트(계획 후 구현) | 2 |
| B | 전체 CLAUDE.md와 스킬, 일반 프롬프트 | 3 |
| C | CLAUDE.md 없음, 스킬 없음, 일반 프롬프트 | 2 |
| D | 전체 CLAUDE.md에 architect 스킬 추가, 일반 프롬프트 | 2 |
| E | 8KB CLAUDE.md, architect, grain-ponytail, unslop, 파이프라인 프롬프트 | 1 |
| F | 5.5KB CLAUDE.md, 스킬 없음, 일반 프롬프트 | 1 |
| G | 8KB CLAUDE.md, architect, grain-ponytail, unslop, 일반 프롬프트 | 2 |
A부터 D가 먼저였습니다. E부터 G는 그것들이 보여준 것을 바탕으로 만들어졌고, 세 번째 B 실행은 대조군으로 그들과 함께 진행되었습니다. 8KB 파일은 5.5KB 파일에 스킬 목록과 언제 로드할지에 대한 짧은 설명, 그리고 architect 스킬이 Sonnet에 위임하게 만드는 모델 라우팅 규칙을 더한 것입니다.
그다음 모든 결과는 문자 하나, diff, 저장소, 이슈만 본 두 명의 Opus 리뷰어에게 전달되었습니다. 그들은 승인 전에 요구할 모든 변경을 나열하고, 블로커, 주요, 사소, nit로 등급을 매기고, 각 수용 기준을 파일과 줄에 대조해 확인했습니다.
비용
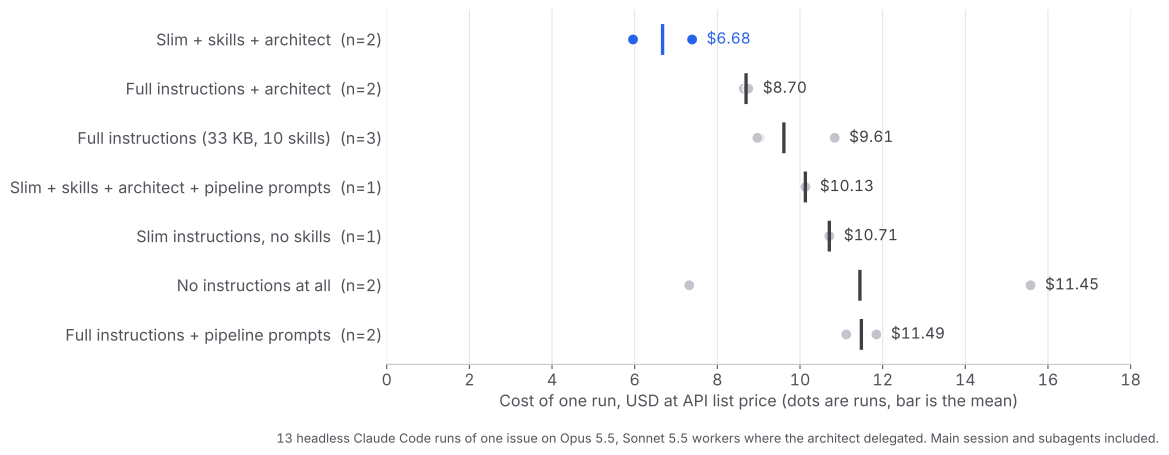
승리 구성인 G는 $5.96과 $7.39가 들었습니다. 파이프라인 프롬프트를 포함한 전체 구성인 A는 $11.12와 $11.85가 들었습니다. 격차는 대부분 턴 수와 각 턴이 나르는 것에서 나옵니다. A의 메인 세션은 Opus에서 172턴과 144턴을 돌며 입력 토큰 2,400만2,800만 개를 썼습니다. G는 79턴과 95턴에 1,300만1,600만 개를 썼고, 약 60턴을 더 Sonnet 워커에 넘겼는데 그 요금은 훨씬 저렴합니다. G는 또한 A의 45분에 비해 약 21분 만에 작업을 끝냈습니다.
이 차트에서 두 가지가 저를 놀라게 했습니다. 지침이 전혀 없는 것이 저렴한 선택이 아닙니다. 그 두 실행은 $7.32와 $15.58이 들었고, 비싼 쪽은 CI에도 실패했으며 테스트 전체에서 가장 큰 diff를 작성했습니다. 그리고 스킬 없이 5.5KB 파일만 쓴 F는 전체 구성보다 저렴하지 않았습니다. 코드를 더 많이, 제품 코드 1,601줄을 작성했고 그 대가를 치렀습니다. G의 절약은 짧은 파일만으로 오지 않습니다. 짧은 파일에 더해 일하는 방식을 바꾸는 두 스킬에서 옵니다.

뉴스레터 가입
최신 팁, 트렌드 및 특가 정보를 무료로 받아보세요.
품질
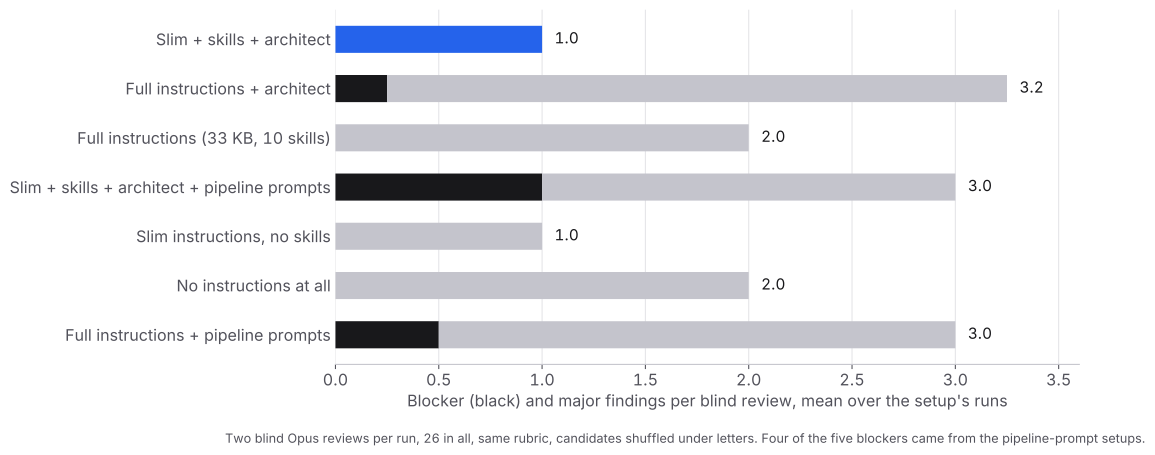
가장 저렴한 구성이 심각한 지적도 가장 적었습니다. 블로커는 없었고, 두 실행에서 리뷰당 주요 지적이 1.5개와 0.5개였습니다. 전체 CLAUDE.md를 쓴 B는 세 번의 실행 모두에서 2.0개의 주요 지적에 머물렀고, 이는 CLAUDE.md를 전혀 쓰지 않은 경우와 같습니다.
이것이 제가 가장 중요하게 보는 결과입니다. 그 파일에는 보안, 권한, 크레딧에 대한 긴 섹션이 있고, 이는 한때 에이전트가 그것들을 건너뛰었기 때문에 작성된 것입니다. 파일이 있든 없든 리뷰어들은 같은 수의 심각한 문제를 찾았고, 구성 전반에 걸쳐 같은 종류가 반복되었습니다. 가입했다가 결제한 뒤 취소하는 사용자, 워커가 중간에 실패했을 때 이메일이 유실되거나 두 번 발송되는 문제, 표시할 수 없는 콘텐츠를 덮어쓰는 편집기. 이것들은 시간에 따른 상태에 관한 추론의 빈틈입니다. CLAUDE.md의 어떤 규칙 목록도 이를 다루지 못했습니다. 아직 생각해 보지 않은 엣지 케이스에 대한 규칙은 쓸 수 없기 때문입니다.
그것들을 다룬 것은 라운드 사이에 architect 스킬에 가한 변경이었습니다. 이제 메인 모델은 브리프를 쓰기 전에 표를 작성합니다. 각 수용 기준, 그것이 의존하는 상태가 시간에 따라 변할 때 무슨 일이 일어나는지, 그리고 결정된 동작입니다. 그런 다음 각 행이 이름 붙은 테스트와 함께 브리프에 들어갑니다. G의 실행은 테스트 코드 774줄과 818줄을 작성했고, B는 510~670줄이었습니다.
계획 단계
A와 E는 우리 CI 파이프라인의 프롬프트를 실행한 두 구성입니다. 계획을 작성하는 계획 프롬프트, 그리고 그 계획을 읽고 실행하는 구현 프롬프트입니다. 각각을 일반 프롬프트를 받은 짝 구성과 비교해 보세요. A는 실행당 $11.49로 B의 $9.61보다 비쌌고, B에는 없던 블로커가 있었습니다. E는 $10.13으로 G의 $6.68보다 비쌌고, G에는 없던 블로커가 리뷰마다 하나씩 있었습니다.
이유는 계획이 모델이 자기 자신을 위해 작성한 뒤 외부 지침처럼 다시 읽어야 하는 문서이기 때문이라고 생각합니다. 두 번째 세션은 계획을 명세로 취급하고, 틀린 부분도 따라가며, 코드에서 발견한 것과 그것을 맞추는 데 턴을 소모합니다. 이 정도 성능의 모델은 그 일을 막 하려는 세션 안에서, 계획과 코드가 같은 컨텍스트에 있을 때 더 잘 계획합니다.
계획 중에서 살아남은 부분은 브리프입니다. 메인 모델이 한 조각을 Sonnet 워커에게 넘길 때, 워커는 빈 컨텍스트로 시작해 시킨 것을 정확히 만듭니다. 그 인계에는 서면으로 결정된 설명이 필요합니다. 목표, 파일, 따라 할 패턴, 엣지 케이스, 작성할 테스트입니다. 자신을 위한 계획은 부대비용입니다. 다른 누군가를 위한 브리프만이 일을 전달하는 유일한 방법입니다.
grain-ponytail이 한 일
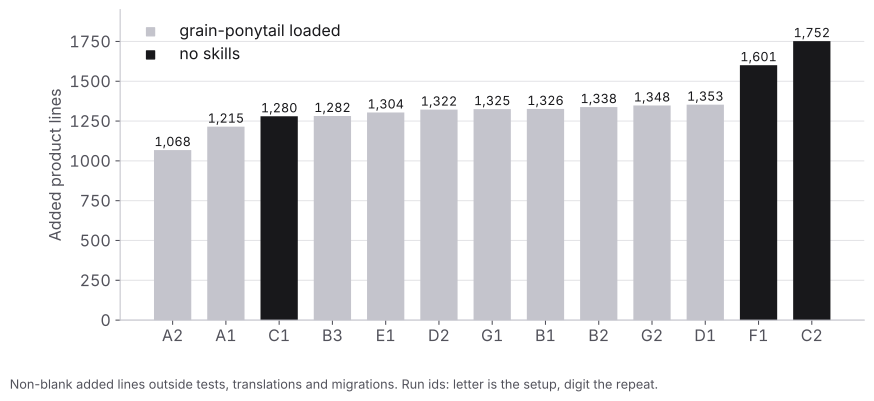
결에 맞게 코드 작성하기 의 스킬은 모델에게 가장 가까운 기존 예시를 그대로 따르고 작동하는 최소한의 코드를 내놓으라고 지시합니다. 이 스킬을 로드한 모든 실행은 제품 코드 1,068줄에서 1,353줄 사이를 작성했습니다. 가장 큰 두 diff인 1,601줄과 1,752줄은 스킬이 없는 실행에서 나왔습니다. 스킬 없는 실행 하나는 1,280줄에 머물렀으니, 스킬이 크기를 단독으로 결정하지는 않지만 꼬리를 잘라냈습니다.
이것은 어떤 종류의 지침이 여전히 이득인지를 보여주는 가장 명확한 사례이기도 합니다. “가장 가까운 예시를 그대로 따라라"는 모델이 작성하는 모든 파일에서 행동을 바꿉니다. “함수에는 snake_case를 써라"는 이미 하고 있는 일을 다시 말할 뿐입니다.
리뷰가 여전히 잡아낸 것
승리한 실행도 깨끗하지는 않았습니다. 테스트 후 G2의 작업을 main에 리베이스하고 우리의 전체 PR 검사를 통과시켰습니다. 이 검사는 diff를 리뷰하고, 각 지적을 실패하는 테스트로 증명하고, 실제 브라우저에서 변경을 실행합니다. 그 결과, 관리자가 MCP로 생성된 단계를 편집할 때 단계 편집기가 첫 번째 HTML 블록을 제외한 모든 블록을 버린다는 점, 그리고 클레임 해제가 실패하면 일부 사용자에게 메일이 두 번 발송될 수 있다는 점을 찾아냈습니다. 둘 다 테스트와 함께 수정된 뒤 PR이 사람 리뷰로 올라갔습니다.
블라인드 리뷰어들은 또한 architect 실행에서 전체 지침 실행보다 과잉 설계를 더 많이 지적했습니다. G는 리뷰당 2.5개, A와 B의 실행은 0~1.0개였습니다. 심각한 지적은 적고 nit는 많습니다. 저는 이 맞바꿈을 받아들이겠지만, 그것은 맞바꿈입니다.
제가 바꾼 것
- 33KB CLAUDE.md는 Codex도 읽는 12KB AGENTS.md가 되었고, 이제 CLAUDE.md는 그것을 가져오기만 합니다. 명령, 테스트 주기, 아키텍처, 그리고 모델이 코드에서 추론할 수 없는 규칙, 예컨대 어떤 경로가 핵심인지, 두 에이전트 표면이 함께 움직여야 한다는 점은 남겼습니다.
- 계획 단계는 파이프라인에서 사라졌습니다. 트리아지가 이슈를 곧바로 구현 단계에 넘기고, 그 프롬프트는 여섯 단계로 줄었습니다. 이슈 읽기, 브랜치 생성, architect와 grain-ponytail 스킬 로드, 테스트, 커밋, 드래프트 PR 열기.
- architect 스킬에는 엣지 케이스 표, 브리프의 Tests 필드, 그리고 브리프가 아니라 이슈에 대해 전체 diff를 확인하는 마지막 단계가 추가되었습니다. 그 버전은 github.com/LivinTribunal/architect-skill 에 공개되어 있습니다.
저장소 변경은 이 글을 쓰는 시점에 리뷰 중입니다.
여기서 얻을 교훈
CLAUDE.md가 사건 하나씩 늘어난 파일이라면, 그것은 모델이 이미 따르는 규칙에 돈을 쓰고 있을 가능성이 큽니다. 모델이 코드를 읽어서 알 수 없는 것만 남기고, 더 많은 안내가 더 안전하다고 믿지 말고 실제 작업에서 전후를 측정하세요.
일하는 방식을 바꾸는 지침은 남기세요. 누가 코드를 타이핑하는지, 한 조각을 어떻게 브리핑하는지, 어떤 기존 패턴을 복사할지입니다. 메인 모델이 최신 프런티어 모델이라면 계획 후 실행 파이프라인은 버리세요. 자신을 위한 계획이 아니라 워커를 위한 브리프를 쓰세요.
방법
2026년 10월 5일, Claude Code 2.1.289의 헤드리스 실행 13회, 메인 모델은 Opus 5.5, architect 스킬이 위임한 곳에서는 워커가 Sonnet 5.5였습니다. 모든 실행은 FlowHunt 모노레포의 한 커밋에서 시작했고, 각각 자체 Postgres 데이터베이스를 가진 APFS 클론에서 다른 실행과 실험 자체의 파일로부터 샌드박스되었습니다. 브로커가 각 실행의 커밋을 고정된 베이스 브랜치에 대한 드래프트 PR로 푸시하고 CI 결과와 함께 세션을 재개했으며, 최대 세 라운드까지 진행했습니다. 비용은 세션당 최대 total_cost_usd로, 메인 세션과 그 서브에이전트를 합산한 값입니다. 제품 코드 줄 수는 테스트, 번역, 마이그레이션을 제외한 비어 있지 않은 추가 줄입니다.
각 결과는 하나의 루브릭으로 Opus의 블라인드 리뷰 두 개를 받았습니다. 정확성, 수용 기준, 결(grain), 비공개 필드와 숨은 상태, 과잉 설계, 보안과 권한, 테스트, 마이그레이션입니다. 후보들은 문자 아래에서 섞였고, 리뷰어는 저장소를 읽을 수는 있었지만 아무것도 실행할 수는 없었습니다. 리뷰당 지적 사항은 구성의 실행들에 대해 평균을 낸 값입니다. 구성당 1~3회의 실행이므로 단일 구성의 평균은 잡음이 많다고 보아야 합니다. 위의 결론은 두 라운드 모두에서 유지된 것들입니다.
