


짧은 요약
- AI 코딩 에이전트는 코드를 더하는 데는 능하지만, 코드가 이미 존재한다는 사실을 알아차리는 데는 서툽니다. 그대로 두면 저장소에는 첫 번째 헬퍼마다 두 번째 헬퍼가 생기고, 읽는 사람은 둘 중 어느 쪽도 신뢰하려면 두 벌을 다 확인해야 합니다.
- 해결책은 에이전트가 따르도록 문서로 적어 둔 두 가지 습관입니다. 결(grain): 같은 종류의 것에 해당하는 가장 가까운 기존 예시를 찾아 그 형태와 위치, 이름을 그대로 따르는 것입니다. 포니테일(ponytail): “이것이 존재해야 하는가"에서 “작동하는 최소한"까지 사다리를 올라가 가장 먼저 버티는 칸에서 멈추는 것입니다.
- 이제 둘 다 공개 스킬이며 MIT 라이선스입니다: GitHub의 grain-skill . 여기에는 작성 규칙, 고정 태그를 쓰는 리뷰 단계, 그리고 에이전트가 무엇을 그대로 따랐는지 스스로 밝히게 만드는 마무리 문장의 형태가 들어 있습니다.
- 8월 이후 우리 메인 저장소에서는: 386개의 이슈와 풀 리퀘스트에 그대로 따를 예시를 명시한 계획 댓글이 달려 있고, 약 18,000개 파일로 이루어진 트리에 1,333개의 커밋이 들어갔습니다. 코드에는 의도적인 단순화와 그 업그레이드 경로를 밝히는
ponytail:주석이 35곳 있습니다. - 불편한 발견: 에이전트가 그 스킬을 스킬로서 호출한 횟수는 0회였습니다. 규칙이 통한 것은 제가 그것을 프로젝트의 CLAUDE.md, 워커 에이전트 정의, 리뷰 체크리스트에도 넣었기 때문입니다. 규칙은 에이전트가 이미 읽는 곳에 두세요.
이 주제에 대해 전에도 한 번 쓴 적이 있는데 결과가 마음에 들지 않았습니다. 원리만 설명하고 메커니즘은 설명하지 않았기 때문입니다. 이번 글은 메커니즘이 들어간 버전입니다.
이 글이 겨냥하는 실패
우리 백엔드에서 가져온 세 가지 예시입니다. 모두 실제 사례이고, 모두 테스트를 통과한 에이전트 작성 풀 리퀘스트에서 나온 것입니다.
팩토리에서 애플리케이션 서비스를 곧바로 가져온 새 REST 라우트. 저장소의 다른 모든 형제 라우트는 라우트에서 컨트롤러, 서비스, 리포지터리로 이어지며 각 단계가 주입됩니다. 이 라우트는 그 사슬을 라우트에서 서비스로 축약했습니다. 작동은 했습니다. 그런데 그 기능의 요청 검증과 응답 형태 구성이 사는 유일한 자리가 사라졌고, 그다음 이 기능을 건드린 에이전트는 두 가지 형태 중에서 고를 수 있게 되었습니다.
너무 커진 서비스를 _payloads.py, _protocol.py, _tokens.py로 쪼갠 사례. 각각 맨 async def들로만 이루어진 모듈이었고, 서비스는 임포트로 protocol.discover(...)를 호출했습니다. 파일 길이 검사는 통과했습니다. 그러자 의존성 주입이 막으려던 바로 그 문제가 그대로 돌아왔습니다. 임포트 시점에 선택되는 협력자, 모듈을 패치하지 않고서는 대체할 수 없는 것, 서비스가 무엇에 의존하는지 문서화하는 생성자에서 빠져 있는 것.
두 번째 정규화기. 이미 하나가 있었습니다. 에이전트는 그것을 찾지 못하고 거의 같은 일을 하는 여덟 줄을 더 썼고, 이제 경계 조건에서 다르게 동작하는 두 함수가 같은 필드를 정규화한다고 주장합니다.
이 중 어느 것도 테스트가 잡아내는 의미의 버그는 아닙니다. 각각은 에이전트가 존재하는 코드보다 자기가 생성할 수 있는 코드를 택한 것입니다. 그것을 수백 개의 풀 리퀘스트에 걸쳐 하면, 저장소는 더 이상 형태를 가지지 못합니다.
결(Grain)
새 코드는 주변 코드와 구별되지 않아야 합니다. 이 스킬은 그 한 문장을 에이전트가 쓰기 전에 밟는 다섯 단계로 바꿉니다.
먼저 예시를 찾으세요. 엔드포인트, 서비스, 리포지터리, 쿼리 훅, 스토어 슬라이스, 컴포넌트라면 가장 가까운 기존 것을 찾아 그 형태와 파일 위치, 이름 짓기를 그대로 따르세요. 패턴이 존재하는데 구조를 새로 발명하지 마세요. 우리 저장소에서는 백엔드의 명명된 예시가 branding 슬라이스인데, 작고 깔끔하면서 모든 계층에 걸쳐 있기 때문입니다. 그리고 스킬의 표에는 산출물 종류별로 어느 파일을 열고 무엇을 그대로 따라야 하는지가 적혀 있습니다.
계층을 존중하세요. 프레젠테이션이 애플리케이션을 호출하고 애플리케이션이 도메인을 호출하며, 인프라가 도메인을 구현합니다. 그 경계를 넘는 새 임포트는 아키텍처 검사에서 실패합니다. 계층 문서를 읽고, 스스로 다시 도출하지 마세요.
국소적 결 대 저장소의 결. 형제들과 맞추세요. 하지만 형제들 자체가 표준 사슬에서 벗어나 있다면, 그 표류를 베끼지 말고 표준 사슬을 따르고 그 차이를 기록하세요. 표준 슬라이스가 쓰는 계층을 여섯 라우트 모두 건너뛴다면 “이 파일의 다른 다섯 라우트와 맞습니다"로는 충분하지 않습니다. 너무 국소적으로 비교한 것입니다.
표준 헬퍼를 재사용하세요. 헬퍼, 타입, 패턴이 이미 저장소에 있다면 그것을 쓰세요. 정규화기가 둘이면 읽는 모든 사람이 두 벌을 비교해야 합니다.
이름은 의미를 담습니다. 코드에 이미 있는 어휘를 재사용하세요. 이미 있는 개념에 새 이름을 붙이는 것은 독자를 기다리는 버그입니다.
마지막 시험은 제가 리뷰어들에게 주는 것입니다. 형태만 보고 에이전트가 쓴 줄을 알아낼 수 있다면, 그것은 결을 거슬러 싸운 것입니다.
포니테일(Ponytail)
게으름은 효율을 뜻하지, 부주의를 뜻하지 않습니다. 가장 좋은 코드는 끝내 쓰이지 않은 코드입니다. 먼저 문제를 완전히 이해하세요. 변경이 건드리는 모든 파일, 실제 엔드투엔드 흐름까지요. 그다음 이 사다리를 올라가 가장 먼저 버티는 칸에서 멈추세요.
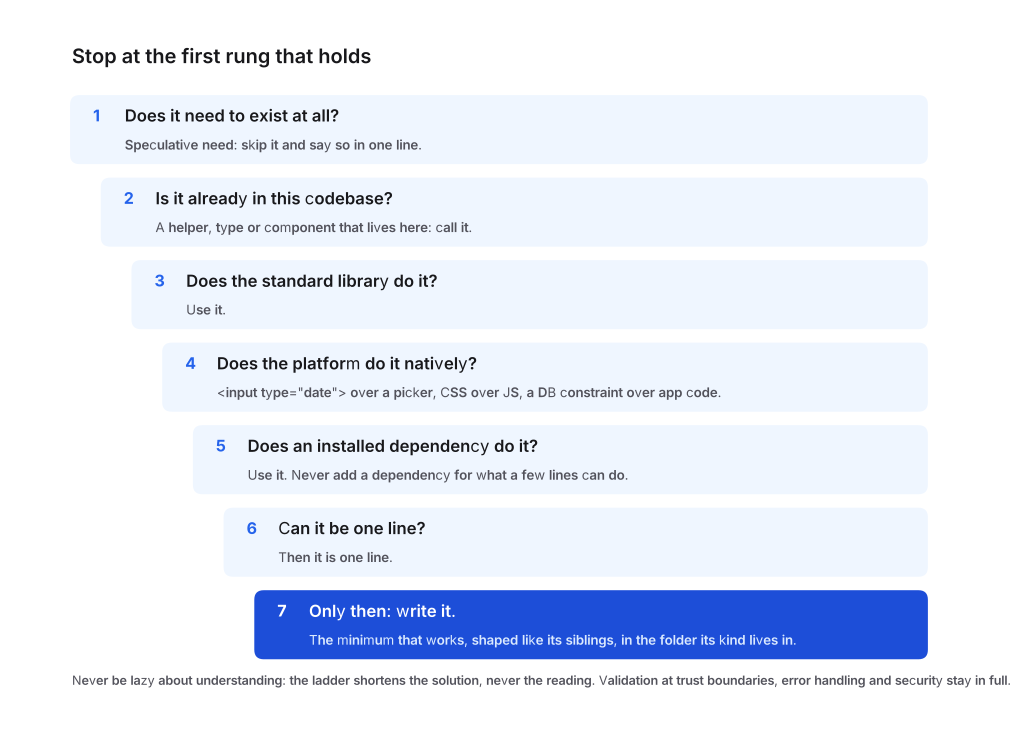
사다리와 함께 따라오는 두 가지 규칙이 있습니다.
버그 수정은 증상이 아니라 근본 원인을 다룹니다. 티켓은 증상을 말합니다. 건드리려는 함수의 모든 호출자를 grep하세요. 공용 함수에 가드를 하나 두는 편이 모든 호출자에 가드를 두는 것보다 diff가 작고, 티켓이 말한 경로만 패치하면 형제 호출자들은 깨진 채로 남습니다.
diff를 최소한으로 유지하세요. 리뷰가 읽는 것은 diff입니다. 지나가다 하는 리팩터링도, 이름 변경도, 서식 재정렬도, “온 김에” 하는 개선도, 과제가 요구하지 않은 파일 건드리기도 없습니다. 그것들 각각이 진짜 변경을 묻어 버립니다. diff가 문제보다 크다면 줄이세요. 눈에 띈 개선 사항은 이 브랜치에 추가 커밋을 얹는 것이 아니라 후속 이슈입니다.
그리고 한계도 있습니다. “게으름"은 가장 잘못 읽히기 쉬운 단어니까요. 신뢰 경계에서의 입력 검증, 데이터 손실을 막는 에러 처리, 보안, 접근성 기본 사항, 사용자가 요청한 것은 무엇이든 게으름을 핑계로 없애지 마세요. 이해하는 데 게을러지지도 마세요. 사다리는 해결책을 줄일 뿐, 읽는 양을 줄이지 않습니다. 잘못된 자리에 있는 작은 diff는 두 번째 버그입니다. 사소하지 않은 로직은 실행 가능한 검사를 하나 남깁니다. 그 로직이 깨지면 실패하는 가장 작은 것입니다.
에이전트가 의도적으로 어떤 칸을 택했고 그 한계를 알고 있다면, 코드에 그렇게 밝힙니다.
# ponytail: global lock, per-account locks if throughput matters
지금 우리 저장소에는 그런 것이 35개 있습니다. 각각은 미래의 독자가 그렇지 않으면 다시 구성해야 했을 결정이며, 한계에 부딪혔을 때 어디를 봐야 하는지 알려 주는 표식입니다.

뉴스레터 가입
최신 팁, 트렌드 및 특가 정보를 무료로 받아보세요.
에이전트가 실제로 하게 만들기
문서에 있는 원리는 행동이 아닙니다. 이 두 가지를 행동으로 만든 세 가지 메커니즘이 있고, 저는 이 순서로 순위를 매기겠습니다.
브리프가 예시를 들고 옵니다. 아키텍트 패턴 에서는 메인 모델이 워커를 위한 브리프를 쓰고, 그 브리프의 Design 필드가 그대로 따를 가장 가까운 기존 패턴과 최소한의 근본 원인 변경을 명시합니다. 워커는 결을 스스로 찾을 필요가 없습니다. 건네받습니다. 우리 저장소 전체에서 386개 이슈와 풀 리퀘스트에 달린 491개의 계획 댓글이 바로 그것입니다. 누구도 쓰기 전에 무엇을 그대로 따를지 명시하는 계획 단계입니다.
에이전트는 무엇을 그대로 따랐는지로 끝맺습니다. 모든 구현자의 보고는 mirrored: <path> 한 줄로 끝나거나, 새 패턴의 이름과 왜 형제 중에 맞는 것이 없었는지를 밝힙니다. 이것은 비용이 적게 들고, 제가 추가한 것 중 단연 최고의 리뷰 보조 수단입니다. 잘못된 종류의 파일을 가리키는 mirrored: 줄은 열어 보기도 전에 그 diff가 틀렸다고 알려 줍니다. 아예 없는 줄은 에이전트가 찾아보지 않았다고 알려 줍니다.
리뷰가 같은 기준을 고정된 순서로 강제합니다. 우리 리뷰 스킬에는 고정 태그를 쓰는 두 단계가 있고, 그 태그가 있어서 발견 사항을 리뷰어 간에, 에이전트 간에 비교할 수 있습니다.
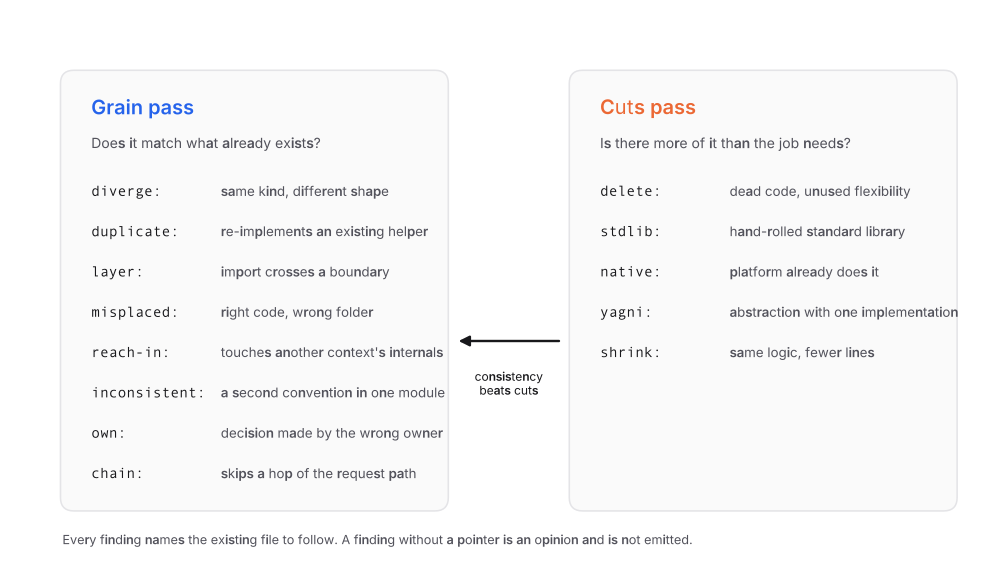
구조가 먼저입니다. 가장 가까운 예시에서 벗어나는가, 기존 헬퍼를 중복하는가, 계층을 넘는가, 잘못된 자리에 있는가, 다른 모듈의 내부를 건드리는가, 일관되지 않은 이름을 쓰는가, 주입해야 할 것의 소유권을 가져가는가, 표준 호출 사슬을 깨는가? 그다음 삭제입니다. 무엇을 지울 수 있는가, 표준 라이브러리로 대체할 수 있는가, 플랫폼 네이티브 기능으로 대체할 수 있는가, 추측성 코드로 버릴 수 있는가, 줄일 수 있는가?
이 순서는 선호가 아니라 규칙입니다. 일관성이 삭제보다 우선합니다. 형제들과 어긋나게 만드는 삭제는 승리가 아닙니다. 읽는 사람이 여덟 줄을 아끼자고 두 가지 형태를 배워야 하니까요. 구조를 먼저 돌리면 삭제 단계는 이미 일치하는 코드만 건드립니다.
저장소에서 벌어진 일, 잘 되지 않은 부분까지
8월 1일 이후 우리 메인 저장소는 1,333개의 커밋을 받았고, 대부분은 리뷰 아래에서 에이전트가 작성한 것입니다. 그 기간의 이슈와 풀 리퀘스트 중 386개에 그대로 따를 예시를 명시한 계획 댓글이 달려 있고, 그런 댓글은 총 491개입니다. 표준 사슬이 새 엔드포인트의 기본 형태이고, 컨트롤러를 건너뛰는 두 개의 레거시 라우트는 두 번째 스타일이 아니라 퇴역시키는 중인 차이로 문서에 적혀 있습니다.
ponytail: 주석 35개는 제가 예상했던 것보다 적은 수이고, 저는 그게 맞다고 생각합니다. 대부분의 단순화는 주석을 달 가치가 없습니다. 주석이 필요한 것은 한계가 있는 것들입니다.
이제 차라리 보고하지 않고 싶은 부분입니다. 저는 grain과 ponytail을 Claude Code 스킬로 배포했습니다. 스킬 인덱스에 설명을 넣고, 요청 시 불러오는 본문을 만들고, 코드를 쓰기 전에 그것을 호출하라고 CLAUDE.md에 한 줄을 넣었습니다. 5주간의 기록에서 에이전트가 그것을 이름으로 호출한 횟수는 0회였습니다. mirrored: 마무리 줄은 일곱 개 응답에 나타났습니다.
그래도 규칙은 자리 잡았습니다. 자리 잡은 이유는 같은 텍스트를 에이전트가 선택하지 않고도 읽는 세 곳에도 넣었기 때문입니다. 첫 턴부터 컨텍스트에 있는 프로젝트의 CLAUDE.md, “가장 가까운 기존 예시의 형태와 위치, 이름을 그대로 따르라"와 “실제로 작동하는 가장 게으른 해결책에 손을 뻗으라"를 고려할 스킬이 아니라 규칙으로 말하는 워커 에이전트 정의, 그리고 그 태그를 무시한 풀 리퀘스트를 실패시키는 리뷰 체크리스트입니다. 스킬 본문은 이 세 곳이 가리키는 표준 참조가 되었습니다. 트리거로서는 아무 일도 하지 않았습니다.
그래서 에이전트를 위해 컨벤션을 패키징하려는 누구에게든 전하고 싶은 교훈은 이것입니다. 스킬은 규칙의 긴 버전을 두기에 좋은 자리입니다. 규칙 자체를 두기에는 나쁜 자리입니다. 에이전트가 불러올지 스스로 결정해야 하고, 대개는 불러오지 않기 때문입니다. 한 문단짜리 버전은 항상 컨텍스트에 있는 파일에 넣고, 명령형 버전은 코드를 쓰는 에이전트의 정의에 넣고, 검사는 머지를 막는 리뷰에 넣으세요. 그런 다음 셋 모두가 세부 내용을 위해 스킬을 가리키게 하세요.
github.com/LivinTribunal/grain-skill 에 있는 공개 버전은 그렇게 배치되어 있습니다. 에이전트가 머릿속에 담을 수 있는 규칙을 담은 짧은 SKILL.md, 사다리와 안티패턴이 담긴 전체 문서, 리뷰 태그, 그리고 어떤 문단을 당신의 CLAUDE.md에 넣고 어떤 문단을 구현자 정의에 넣어야 하는지 알려 주는 README가 있습니다. 예제로 든 사례를 당신의 표준 예시로 바꾸면 끝입니다.
