


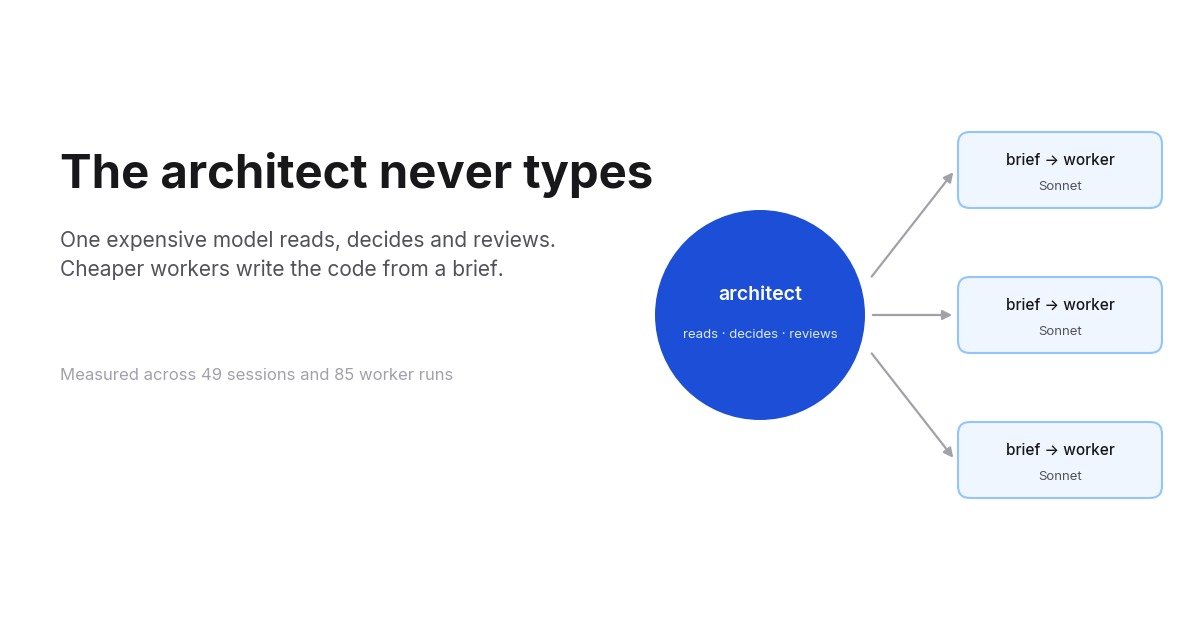
짧은 요약
- 5주 동안 나는 코딩 에이전트를 분리해서 운영했다. 메인 모델(Opus, 이후 Fable)은 읽고, 결정하고, 리뷰하며, 워커 에이전트는 작성된 브리프를 바탕으로 코드를 작성한다. 나는 이것을 아키텍트 패턴이라 부르고, 이제 공개 스킬이다: GitHub의 architect-skill , MIT 라이선스.
- 메인 모델은 타이핑을 그만두었다. 49개의 아키텍트 세션에서 1,467개 프롬프트 동안 소스 파일을 편집한 횟수는 6회였다. 같은 기간의 275개 일반 세션에서는 3,081개 프롬프트 동안 244개 파일을 편집했다. 100 프롬프트당 0.4 대 7.9다.
- 프롬프트당 총 토큰은 줄지 않았다. 2주 동안은 심하게 늘었다가 이후 일반 세션이 있는 수준으로 돌아왔다. 달라진 것은 누가 그것을 썼는가다. 워커 토큰에서 Opus의 몫은 100%에서 약 4%로 떨어졌고, 9월 14일 이후 아키텍트 세션의 프롬프트 하나는 메인 모델에서 가중 토큰 364k, Sonnet 워커에서 205k, Opus 워커에서 80k를 소비한다.
- 구독이 신경 쓰는 것이 바로 그 분배다. Claude Max는 전체 모델 주간 한도를 각 모델의 요율로 측정하므로 Sonnet 토큰은 Opus 토큰의 40%만 소모하고, Fable에는 어떤 워커도 건드리지 않는 별도의 더 빡빡한 주간 한도가 있다.
- 나는 워커를 헤드리스 Claude Code를 통해 DeepSeek로 라우팅하는 것도 시도했다. 정가로 계산하면 같은 트래픽이 Sonnet에서 $202, Opus에서 $505가 아니라 $10이었다. 구독에서는 그 절감이 존재하지 않는다. 구독은 이미 지불되었기 때문이다. 그래서 접었다. 토큰당 지불한다면 그 섹션을 그래도 읽어보라. 숫자가 핵심이기 때문이다.
이 글은 시리즈의 세 번째 글이다. 첫 번째는 설정 하나가 컨텍스트 윈도우에 무엇을 했는지 측정했고, 토큰 17% 절감 , 두 번째는 컨텍스트 윈도우에 드는 비용 과 그 이유를 설명한다. 이 글은 다른 지렛대에 관한 것이다. 컨텍스트가 얼마나 큰지가 아니라, 어떤 모델이 그것을 들고 있는지에 관한 것이다.
패턴이란 무엇인가
코딩 에이전트 세션은 두 종류의 일을 한다. 생각한다: 코드베이스를 읽고, 무엇을 바꿀지 파악하고, 이름과 시그니처와 엣지 케이스를 결정하고, diff를 확인한다. 그리고 타이핑한다: 코드를 작성하고, 테스트 파일을 실행하고, 린트를 고친다. 생각은 프런티어 모델이 그 가격을 정당화하는 부분이다. 타이핑은 그렇지 않다. 타이핑의 대부분은 앞서 내려진 결정에 의해 정해지며, 작은 모델도 결정된 계획을 큰 모델만큼 잘 실행한다.
그래서 이 스킬은 세션을 분리한다. 메인 모델이 아키텍트다. 소스 파일 편집을 제외한 메인 루프의 모든 것을 수행한다:
- 요구사항을 캐물어 확인하고 코드베이스를 탐색한다.
- 설계 결정을 내린다: 접근법, 데이터 흐름, 이름, 시그니처, 엣지 케이스. 따라 할 가장 가까운 기존 패턴. 근본 원인을 해결하는 가장 작은 변경.
- 서로 겹치지 않는 파일 집합을 소유하는 슬라이스로 분해한다.
- 슬라이스당 하나의 구현 브리프를 작성한다.
- 돌아온 diff를 리뷰하고, 게이트를 실행하고, 커밋한다.
워커는 새 컨텍스트 윈도우를 가진 서브에이전트다. 브리프만 받고 다른 것은 받지 않으며, 코드를 작성하고, 브리프가 지정한 테스트 파일을 실행하고, 짧은 구조화 보고서를 반환한다. 그러면 그 컨텍스트는 버려진다. 워커는 메인 세션의 기록에 결코 포함되지 않는데, 이것은 들리는 것보다 중요하다. 메인 세션이 읽는 모든 것은 이후 호출마다 다시 전송되므로, 자기 컨텍스트에서 열두 개 파일과 테스트 로그를 읽는 워커는 그 전부를 아키텍트의 청구서에서 빼준다.
브리프가 곧 계약의 전부다. 내 브리프에는 일곱 개의 필드가 있고, 이 스킬은 대부분 그것들을 잘 채우는 것에 관한 것이다:
## Implementation brief: <slice>
Goal: one sentence, observable outcome
Context: what exploration found: excerpts, the pattern to mirror, line anchors, gotchas
Files: paths to create/modify, exclusive ownership for this slice
Design: the decided approach: data flow, names, signatures, edge cases
Constraints: project rules that apply: style, layers, security
Out of scope: what not to touch, including files owned by other slices
Verify: exact commands and expected outcome
브리프에는 선택지가 아니라 결정이 담긴다. 내가 여전히 두 접근법을 저울질하고 있다면 나는 위임할 준비가 안 된 것이다.
예외가 하나 있다. 위임에는 고정 비용이 따른다: 브리프 작성, 워커 시작, 보고서 읽기, diff 리뷰. 오타 수정, 설정 값, 버전 범프, 죽은 키 삭제, 한 줄 수정과 그 회귀 테스트 같은 경우에는 아키텍트가 직접 편집한다. 브리프가 편집보다 더 많은 비용이 들기 때문이다. 기준은 비용이지 줄 수가 아니다. 편집에 설계 판단이 필요하거나 저장소가 중요하다고 표시한 경로를 건드리는 순간, 그것은 워커에게 간다.
구독이 계산을 바꾸는 이유
토큰당 지불한다면 사안은 단순하다. Opus 5의 정가는 백만 입력 토큰당 $5, 백만 출력 토큰당 $25이고, Sonnet 5는 $2와 $10이다. Opus에서 Sonnet으로 옮겨가는 모든 구현 토큰은 이전 비용의 40%가 된다.
나는 구독을 지불하고, 거기서는 사안이 다르며, 내 생각에는 더 강력하다. Claude Max에는 하나가 아니라 두 개의 주간 한도가 있다: 모든 모델에 걸친 한도로, 모든 토큰이 해당 모델의 요율로 소모하며, Fable만 소모하는 별도의 더 빡빡한 한도가 있다. Opus에는 자체 한도가 없다. 그래서 이 분할은 두 가지 효과를 낸다. Sonnet 워커가 하는 일은 Opus 워커가 소모할 요율의 40%로 공용 한도를 소모하므로, 세션 토큰의 3분의 2를 Sonnet으로 옮기면 총 토큰 수가 그대로여도 주간 한도가 더 오래간다. 그리고 아키텍트가 Fable일 때, 타이핑에 쓰지 않는 모든 토큰은 가장 먼저 바닥나는 한도에 남겨지는 토큰이다. 따라서 아키텍트 패턴이 일반 세션과 정확히 같은 수의 토큰을 썼더라도, 누가 그것을 쓰는지가 여전히 그 주가 언제 끝나는지를 결정할 것이다.
그 “그럼에도 불구하고"는 알고 보니 많은 일을 하고 있었다.
트랜스크립트가 말하는 것
Claude Code는 모든 세션을 JSONL 트랜스크립트로, 모든 워커 실행을 세션 디렉터리 아래의 형제 파일로 기록한다. 나는 8월 19일 이후의 모든 것을 갖고 있다: 프롬프트가 세 개 이상인 대화형 세션 324개, 그중 49개가 이 패턴을 사용했다. 즉 구현자 에이전트를 생성했거나 브리프를 하나에 보낸 경우다. 토큰은 청구서와 같은 방식으로 가중된다: 새 입력 1, 캐시 쓰기 1.25 또는 2, 캐시 읽기 0.1. CI 실행은 제외한다.
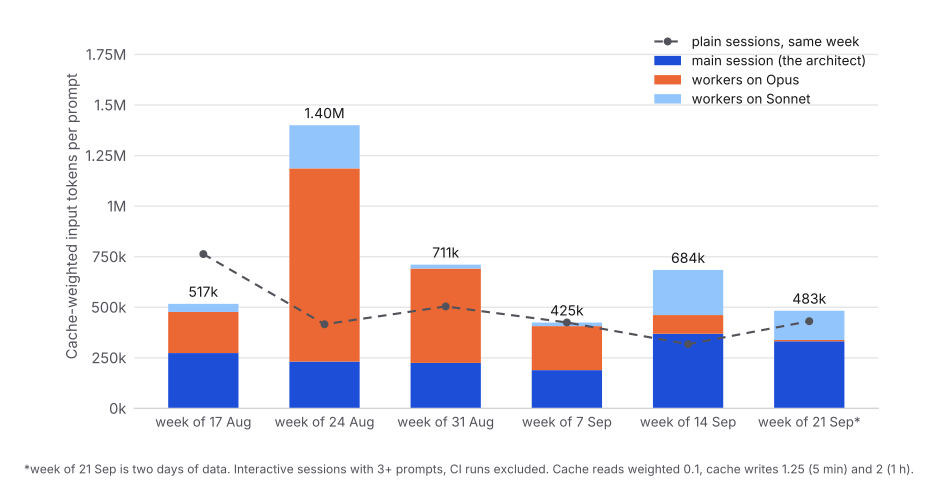
왼쪽에서 오른쪽으로 읽으면 첫 2주는 성공 사례가 아니다.
8월 24일 주간에 아키텍트 세션은 프롬프트당 가중 토큰 1.40M을 소비했다. 같은 주 일반 세션은 0.42M이었다. 3.5배 더 많았고, 초과분의 거의 전부가 주황색이었다: Opus 워커. 나는 워커들에게 좋은 모델과 규칙 없음을 줬고, 그들은 규칙 없는 좋은 모델처럼 행동했다. 그 주 Opus 워커 실행의 중앙값은 176턴이었다. 여러 개가 전체 백엔드 테스트 스위트를 실행했고, 이는 약 100KB의 출력을 컨텍스트에 넣어 이후 모든 턴마다 다시 전송되게 만들었다. 이미 조이기 시작한 뒤인 9월 14일의 워커 6개 세션 하나는 약 6천 줄의 diff를 만들기 위해 1,585턴에 걸쳐 245M 입력 토큰을 여전히 태웠다. 프롬프트 캐싱은 내내 91.6% 적중률로 작동하고 있었다. 청구서는 가격이 아니라 양이었다.
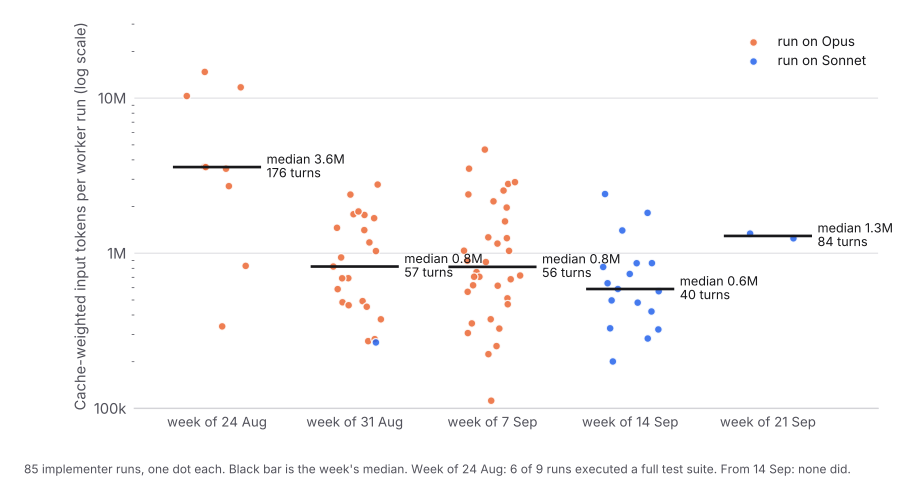
워커 스트립은 규칙이 어디에 자리 잡았는지 보여준다. 그중 세 가지가 대부분의 일을 했고, 나는 그것들을 브리프가 아니라 에이전트 정의에 적어 넣어서 내가 기억하든 못 하든 적용되게 했다:
- 워커는 전체 테스트 스위트를 절대 실행하지 않는다. 브리프가 지정한 테스트 파일만 실행한다. 게이트는 아키텍트가 실행한다.
maxTurns는 에이전트 정의에서 제한된다. Sonnet은 140, Opus는 160. 250턴이 필요한 슬라이스는 브리프가 잘못된 것이다.- 슬라이스는 약 12개 파일 이하, 브리프는 약 8KB 이하로 유지한다. 브리프도 매 턴마다 다시 전송된다.
8월 31일 주간에는 워커 실행의 중앙값이 57턴과 가중 토큰 0.8M이었다. 기본 경로를 Sonnet으로 옮긴 9월 14일부터는 40턴과 0.6M이었고, 그 이후 어떤 워커도 전체 스위트를 실행하지 않았다.
프롬프트당 총량도 따라왔다: 지난 4주 동안 711k, 425k, 684k, 483k였고, 일반 세션은 505k, 425k, 318k, 431k였다. 이제 아키텍트 세션은 일반 세션과 비슷한 비용이 든다. 4주 중 2주는 조금 더 많고, 1주는 조금 더 적다. 그 대가로 얻는 것은 다음 두 차트다.

뉴스레터 가입
최신 팁, 트렌드 및 특가 정보를 무료로 받아보세요.
메인 모델이 타이핑을 멈췄다
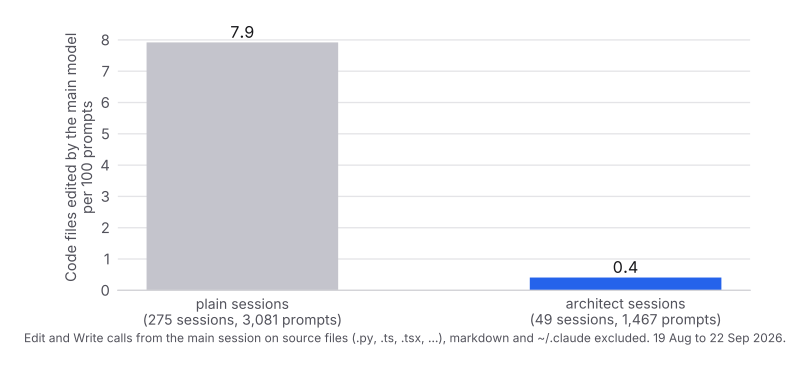
이것이 내가 바꾸려 했던 숫자이고, 바뀌었다. 일반 세션에서 메인 모델은 3,081개 프롬프트에 걸쳐 소스 파일에 244번의 Edit 또는 Write 호출을 했다. 아키텍트 세션에서는 1,467개에 걸쳐 6번이었다. 그 6번은 모두 내가 설명할 수 있는 작은 편집 예외다.
한편 워커들은 생산적이었다. 85번의 워커 실행이 2,510번의 소스 파일 편집을 했다. 메인 루프와 워커를 합쳐서, 아키텍트 세션은 1,467개 프롬프트에서 2,516번의 코드 편집을 만들어냈다. 일반 세션은 3,081개에서 943번이었다. 코드 편집 한 번당 아키텍트 세션은 총 403k 가중 토큰을, Opus 계열 모델에 330k를 썼다. 일반 세션은 1,410k와 1,324k를 썼다. 이 비교는 조심하고 싶다. 두 집단이 같은 작업이 아니기 때문이다. 세션은 코드를 위임함으로써 아키텍트로 분류되므로 아키텍트 세션은 구조적으로 코드 중심이고, 일반 세션은 아무것도 편집하지 않는 리서치, 리뷰, 디버깅을 포함한다. 이것은 “이 패턴은 토큰당 많은 코드를 작성한다"로 읽어야 하지, 4배 효율 주장으로 읽어서는 안 된다.
더 깔끔한 주장은 모델 분배다. 9월 14일 이후 아키텍트 세션의 프롬프트 하나는 메인 루프에서 가중 토큰 364k, Sonnet 워커에서 205k, Opus 워커에서 80k를 소비한다. 전체 워커 토큰에서 Opus 워커의 몫은 8월에 100%였고 9월 21일 주간에 약 4%였다. Max 요금제에서 이는 거의 모든 구현 작업에 대해 공용 주간 한도가 Opus의 요율이 아니라 Sonnet의 요율로 소모되고, 그중 어느 것도 Fable 한도를 건드리지 않는다는 뜻이다.
개선되지 않은 두 가지가 있고, 차트가 다른 인상을 주게 두기보다는 말하는 편이 낫다. 메인 세션 자체의 컨텍스트는 줄지 않았다. 아키텍트 세션은 100 프롬프트당 8.7회 압축했고 일반 세션은 4.7회였다. 아키텍트가 브리핑 전에 많은 것을 읽기 때문이다. 그리고 이 패턴은 작은 작업에서 실시간 기준으로 더 느리다. 워커의 시작과 보고서는 그냥 편집만 할 때는 지불하지 않는 몇 분이기 때문이다. 작은 편집 예외가 존재하는 이유는 스킬의 첫 버전에 그런 예외가 없었고, 내가 두 줄짜리 변경을 위해 3KB 브리프를 쓰는 것을 스스로 지켜봤기 때문이다.
DeepSeek 우회
워커가 Sonnet이 되자 다음으로 당연한 질문은 워커가 꼭 Claude 모델이어야 하는가였다. 9월 13일부터 18일까지 나는 ANTHROPIC_BASE_URL을 호환 엔드포인트로 설정한 헤드리스 Claude Code를 통해 워커를 DeepSeek V4.1 Flash로 향하게 했다. 처음에는 OpenRouter를 통해서, 그다음에는 네이티브로. 같은 브리프 형식, 같은 보고서 형식, 같은 아키텍트. 2,732회 호출, 431M 입력 토큰(그중 88%가 캐시 읽기), 1.7M 출력 토큰.
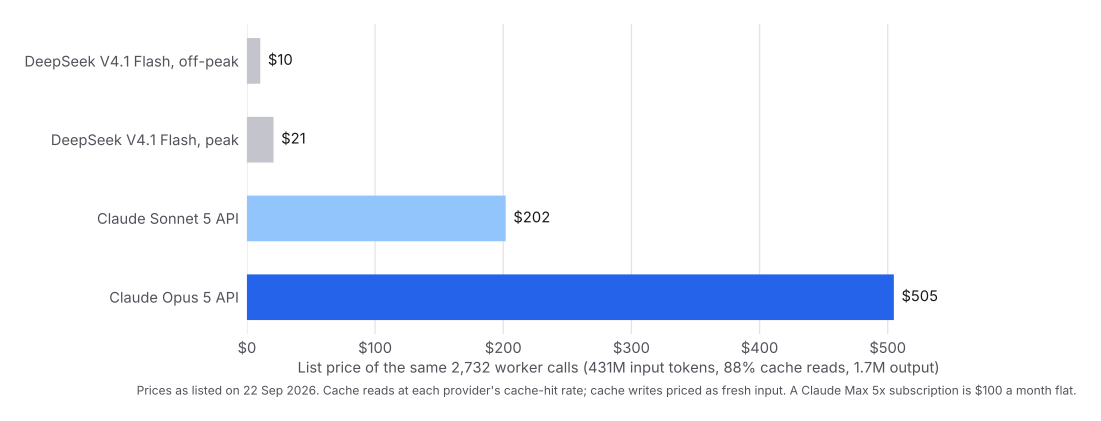
9월 22일 정가 기준으로 그 트래픽은 DeepSeek 오프피크에서 약 $10, 피크에서 $21, Sonnet API에서 $202, Opus API에서 $505가 든다. 내가 토큰당 지불한다면 이것이 이 글의 헤드라인이 되었을 것이고 나는 그것을 유지했을 것이다.
나는 토큰당 지불하지 않으며, 그것이 논증의 전부다. Max 구독은 내가 주간 한도의 30%를 쓰든 100%를 쓰든 한 달에 $100이다. 워커 트래픽을 DeepSeek로 옮긴다고 그 청구서가 1센트도 줄지 않았다. 그것은 그 위에 주당 $10에서 $21의 두 번째 청구서를 추가한 것이었고, 이미 용량 값을 다 지불한 요금제에서 용량을 아끼기 위한 것이었다. 나는 “API보다 저렴하다"와 “내가 지불하는 것보다 저렴하다"를 혼동했고, 지불하는 것이 정액일 때 이 둘은 같은 것이 아니다. 구독자에게 올바른 비교는 DeepSeek 대 두 번째 구독이며, 거기서는 두 번째 Claude 요금제나 Codex가 있는 ChatGPT 요금제가 적당한 수준의 DeepSeek 사용 한 달과 비슷한 비용이 들고, 자체 주간 한도와 자체 모델을 가지며 살필 측정도 없다.
품질이 나머지 절반이었다. 백엔드 슬라이스 다섯 개는 깨끗하게 돌아와 그대로 커밋되었다. 프런트엔드 슬라이스 하나는 내보낸 심볼을 제거하면서 그 소비자들을 모두 그대로 남겨두어, 트리가 컴파일되지 않았고 이후 슬라이스가 그것을 정리해야 했다. 이것은 명세를 실행하는 모델이 갖는 바로 그 실패이며, 형제 컴포넌트로부터 컴포넌트의 형태를 추론하는 모델은 갖지 않는다. 스킬은 이제 그렇게 말한다: 공유 API 표면 변경은 Sonnet으로 가고, 워커 규칙은 “같은 실행에서 모든 소비자를 마이그레이션하지 않고는 내보낸 심볼을 제거하거나 이름을 바꾸지 말 것"으로 되어 있다. DeepSeek Flash는 좋은 실행자다. 아키텍트 패턴에는 브리프가 소비자 수를 과소평가했을 때 그것을 알아차리는 워커가 필요하고, 그것이 브리프가 공급할 수 없는 유일한 것이다.
그래서 오늘의 라우팅 표에는 두 개의 행이 있다. 정형 작업, 테스트를 만족시켜야 하는 상세 브리프에 대한 백엔드 작업, 기존 디자인 문법을 따르는 프런트엔드 작업, 그리고 공유 API 표면에 대한 모든 변경은 sonnet-implementer로 간다. 어려움이 추론에 있는 작업은 opus-implementer로 간다: 비동기 레이스, 브리프가 열거할 수 없는 지점들에 정확성이 달려 있는 다중 지점 리팩터링, 단일 테스트로 증명되지 않는 백필 마이그레이션. 위험도가 아니라 형태로 라우팅하라. 위험도는 diff가 얼마나 엄격하게 리뷰되는지와 사람이 서명하는지를 바꾼다. 누가 그것을 작성하는지는 결코 바꾸지 않는다.
리뷰 루프, 패턴이 값을 하거나 손해를 보는 지점
워커의 보고서는 주장이다. 스킬의 리뷰 루프는 짧고, 모든 줄은 데인 경험에서 나왔다:
- 보고서와 실제
git diff를 읽어라. 워커가 인용한 diffstat을 네가 보는 것과 대조하라. - 주장이 중요할 때는 핵심 검증을 직접 다시 실행하라.
- 문제를 찾았나? 수정 사항을 같은 워커에게 보내라. 그 워커는 아직 자기 컨텍스트를 갖고 있고 멈춘 지점에서 이어간다. 손으로 고치지 말고, 새로 띄우지도 마라.
- 두 번의 수정 실패는 모델이 너무 작다는 뜻이 아니라 브리프가 불충분했다는 뜻이다. 분해하고, 빠진 발췌를 Context에 넣고, 다시 실행하라. 더 큰 모델로 올라가지 마라. 같은 오해를 더 유창하게 구현할 뿐이다.
- 무엇이든 받아들이기 전에 범위가 정해진 게이트를 실행하라: 건드린 테스트, 건드린 파일에 대한 린터, 저장소가 가진 관례 스크립트.
트랜스크립트에서 나는 워커 실행당 약 한 번의 수정을 보냈고, 85번 실행에 52번이었다. 그리고 7번의 Opus 실행이 160턴 한도에 걸렸는데, 전부 지금이라면 분할할 슬라이스였다. 이것이 내가 지켜보는 두 숫자다. 실행당 수정이 늘면 내 브리프가 게을러지고 있는 것이다. 워커가 한도에 걸리면 내 슬라이스가 너무 큰 것이다.
여기서 가져갈 것
토큰당 지불한다면: 비싼 모델은 결정과 리뷰에 두고, 저렴한 모델은 구현에 두고, 어떤 저렴한 모델을 고르기 전에 워커 트래픽을 정가로 계산해보라. 네 개 막대 차트가 그 논증이다.
구독을 지불한다면: 이 패턴은 토큰 수를 줄이지 않는다. 구현 토큰을 공용 주간 한도를 가장 느리게 소모하는 모델로 옮기고, Fable만 해야 할 일을 위해 Fable 한도를 남겨두고, 가장 비싼 모델이 타이핑에 턴을 쓰는 것을 멈춘다. 이미 사둔 용량을 “아끼려고” 측정되는 API를 옆에 추가하지 마라. 워커 용량이 부족하면 두 번째 구독을 사라.
어느 쪽이든, 그것을 작동하게 만든 규칙은 지루한 것들이었다. 워커에서 전체 테스트 스위트 금지. 턴 수 제한. 작은 슬라이스, 짧은 브리프. 같은 워커를 한 번 수정하고, 그다음 브리프를 고쳐라.
스킬, 세 개의 에이전트 정의, 가드 훅은 MIT 라이선스로 github.com/LivinTribunal/architect-skill 에 있다. 워커에게 자기가 들어가는 저장소에 맞는 코드를 작성하는 방법을 알려주는 동반 스킬은 grain-skill 이고, 그것에 관한 글은 결에 맞는 코드 다.
방법
이 글에서 설명한 모든 것은 github.com/LivinTribunal/architect-skill 에 있다: 스킬 자체, 브리프 템플릿, 라우팅 표, 턴 한도와 컨텍스트 규칙이 있는 세 개의 구현자 에이전트 정의, 그리고 가드 훅. 설치하면 아래 숫자들이 나온 설정을 갖게 된다.
세션은 2026년 8월 19일부터 9월 22일까지의 Claude Code JSONL 트랜스크립트이며, entrypoint는 cli, 사용자 프롬프트가 세 개 이상이다. 세션은 opus-implementer, opus-implementer-xhigh, sonnet-implementer 중 하나를 생성했거나, ds-slice 워커를 실행했거나, 아키텍트 스킬을 호출했거나, 구현 브리프를 포함한 메시지를 범용 에이전트에게 보낸 경우 아키텍트로 분류된다. 후자는 이름 있는 에이전트가 존재하기 전인 초기 몇 주의 방식이다. 워커 실행은 각 세션 디렉터리 아래의 서브에이전트 트랜스크립트다. 사용량은 요청 id로 중복 제거하고, 새 입력 1, 5분 캐시 쓰기 1.25, 1시간 캐시 쓰기 2, 캐시 읽기 0.1로 가중한다. “코드 편집"은 .py, .ts, .tsx, .js, .sql 또는 이와 유사한 소스 파일에 대한 Edit 또는 Write 호출이며, 마크다운과 ~/.claude 아래의 모든 것은 제외한다. DeepSeek 가격은 2026년 9월 22일의 네이티브 정가로, 오프피크와 피크이며, 캐시 읽기는 캐시 적중 요율, 캐시 쓰기는 새 입력으로 계산했다. Claude API 가격은 공개된 Opus 5와 Sonnet 5 정가이며 캐시 읽기는 입력의 10분의 1로 계산했다. 9월 21일 주간은 이틀치 데이터다.
