


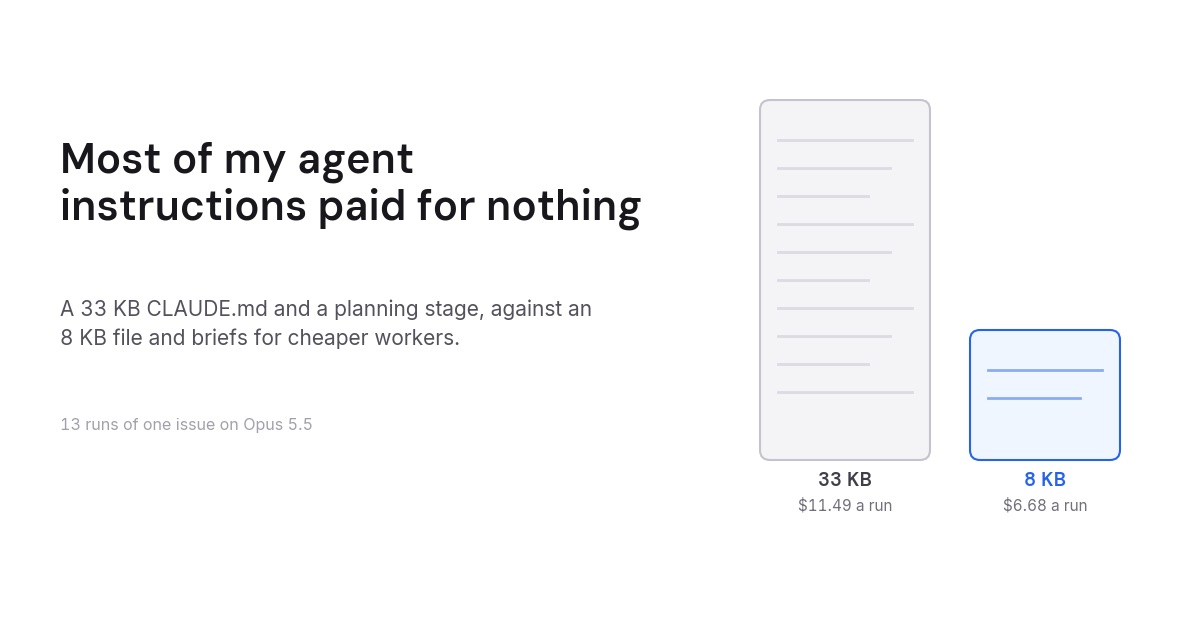
De korte versie
- Ik nam één echte issue uit de FlowHunt-backlog en liet Claude Code die 13 keer implementeren op Opus 5.5, onder zeven verschillende instructie-opstellingen. Elke run startte vanaf dezelfde commit, in een eigen clone met een eigen database, en ging door onze echte GitHub CI. Twee blinde Opus-reviews beoordeelden elk resultaat.
- De CLAUDE.md van 33 KB uit de repository leverde geen meetbare kwaliteit op. Runs ermee kregen 2,0 blocker- en major-bevindingen per review. Een run zonder enig instructiebestand kreeg hetzelfde. Een bestand van 5,5 KB kreeg 1,0.
- Een aparte planningsfase maakte het erger. Beide opstellingen die eerst een planningsprompt en daarna een implementatieprompt draaiden, kostten meer dan hun tweelingbroer met een gewone prompt, en ze leverden vier van de vijf blockers op in alle 26 reviews.
- De winnaar was een CLAUDE.md van 8 KB, drie skills, Sonnet-workers en een gewone prompt. De twee runs kostten gemiddeld $6,68 tegen API-lijstprijs. De volledige opstelling met de pijplijnprompts kostte gemiddeld $11,49, ongeveer 1,7 keer zoveel, en had meer bevindingen.
- Wat van alle structuur die ik had gebouwd overbleef, is de briefing: een korte, besliste beschrijving van één stukje werk die het hoofdmodel schrijft voor een goedkopere worker. Plannen voor het hoofdmodel zelf leverden niets op. Het model plant prima op eigen kracht.
Dit volgt op het bericht over het architect-patroon , dat mat wie de code moest typen. Dit bericht vraagt hoeveel je het hoofdmodel moet vertellen voordat het begint.
Waarom ik het deed
Onze monorepo had veel agentinstructies verzameld. De CLAUDE.md in de root was 33 KB: build-commando’s, testritme, codestijl, architectuur, kritieke paden, beveiligingsregels, permissie- en creditregels, de twee agent-oppervlakken, het aanmaken van issues, PR-conventies. Onder .claude/skills/ stonden tien skills. Daarbovenop draaide onze CI-pijplijn (we noemen die harnext) een issue door een tagger, een triagestap, een planningsstap die een plan als issue-commentaar schreef, en een implementatiestap die het plan teruglas en de code schreef, elk met een eigen lange systeemprompt.
Elke regel daarvan was om een reden toegevoegd, meestal nadat een agent iets fout had gedaan. De vraag die niemand had gesteld, was of het nog hielp. Een CLAUDE.md wordt in elke sessie geladen en bij elke beurt opnieuw meegestuurd. Als het model toch het juiste zou hebben gedaan, zijn die tokens een belasting, en zoals wat een contextvenster kost uitlegt, telt een belasting per beurt sneller op dan het lijkt.

Klaar om uw bedrijf te laten groeien?
Start vandaag uw gratis proefperiode en zie binnen enkele dagen resultaten.
De test
De issue was een getimede e-mailreeks voor nieuwe aanmeldingen: een beheerder definieert stappen zoals “dag 0: welkom” en “dag 5: je proefperiode loopt bijna af”, en een achtergrondtaak mailt elk account op de juiste dag, stopt zodra iemand een betaald abonnement koopt, en slaat accounts over die vóór de lancering zijn aangemaakt. Er is een migratie nodig, een repository, een service, een Celery beat-taak, REST-endpoints, MCP-tools voor agents, en een console-UI in 11 talen. Dat is een realistische feature voor week één, en hij heeft verschillende edge cases die makkelijk te missen zijn.
Elke run was een headless Claude Code-sessie op Opus 5.5, gesandboxed in een eigen clone en database, met een script dat de commit naar een draft-PR pushte en het CI-resultaat terugvoerde naar de sessie, tot drie rondes. Kosten zijn Claude Code’s eigen total_cost_usd voor de hoofdsessie plus elke subagent, tegen API-lijstprijs. Ik betaal een abonnement, dus dit is een maat voor het werk, niet voor mijn rekening.
De zeven opstellingen:
| Opstelling | Runs | |
|---|---|---|
| A | Volledige CLAUDE.md van 33 KB en tien skills, pijplijnprompts (eerst plannen, dan implementeren) | 2 |
| B | Volledige CLAUDE.md en skills, gewone prompt | 3 |
| C | Geen CLAUDE.md, geen skills, gewone prompt | 2 |
| D | Volledige CLAUDE.md plus de architect-skill, gewone prompt | 2 |
| E | CLAUDE.md van 8 KB, architect, grain-ponytail en unslop, pijplijnprompts | 1 |
| F | CLAUDE.md van 5,5 KB, geen skills, gewone prompt | 1 |
| G | CLAUDE.md van 8 KB, architect, grain-ponytail en unslop, gewone prompt | 2 |
A tot D kwamen eerst. E tot G zijn gebouwd op wat die lieten zien, en de derde B-run liep ernaast als controle. Het bestand van 8 KB is dat van 5,5 KB plus een korte lijst van de skills en wanneer je ze laadt, en de modelrouteringsregels die de architect-skill naar Sonnet laten delegeren.
Elk resultaat ging daarna naar twee Opus-reviewers die alleen een letter, de diff, de repository en de issue zagen. Ze somden elke wijziging op die ze zouden vragen voor ze goedkeurden, beoordeelden die als blocker, major, minor of nit, en controleerden elk acceptatiecriterium tegen een bestand en regel.
Kosten
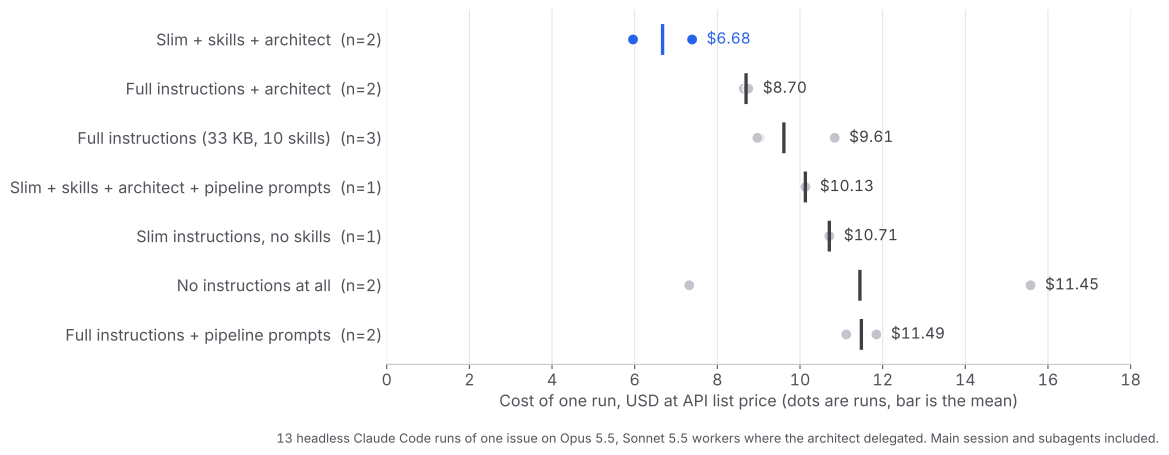
De winnende opstelling, G, kostte $5,96 en $7,39. De volledige opstelling met pijplijnprompts, A, kostte $11,12 en $11,85. Het verschil zit vooral in het aantal beurten en wat elke beurt meedraagt. De hoofdsessies van A draaiden 172 en 144 beurten op Opus met 24 tot 28 miljoen invoertokens. Die van G draaiden 79 en 95 beurten met 13 tot 16 miljoen, en gaven ongeveer 60 beurten extra door aan Sonnet-workers, die tegen een fractie van het tarief worden gefactureerd. G was ook klaar in ongeveer 21 minuten tegen 45 voor A.
Twee dingen op deze grafiek verrasten me. Geen instructies is niet de goedkope optie: de twee runs kostten $7,32 en $15,58, en de dure zakte ook nog voor CI en schreef de grootste diff van de test. En het bestand van 5,5 KB zonder skills, F, was niet goedkoper dan de volledige opstelling. Het schreef meer code, 1.601 productieregels, en betaalde daarvoor. De besparing in G komt niet alleen van het korte bestand. Ze komt van het korte bestand plus de twee skills die veranderen hoe het werk wordt gedaan.
Schrijf u in voor onze nieuwsbrief
Ontvang gratis de nieuwste tips, trends en aanbiedingen.
Kwaliteit
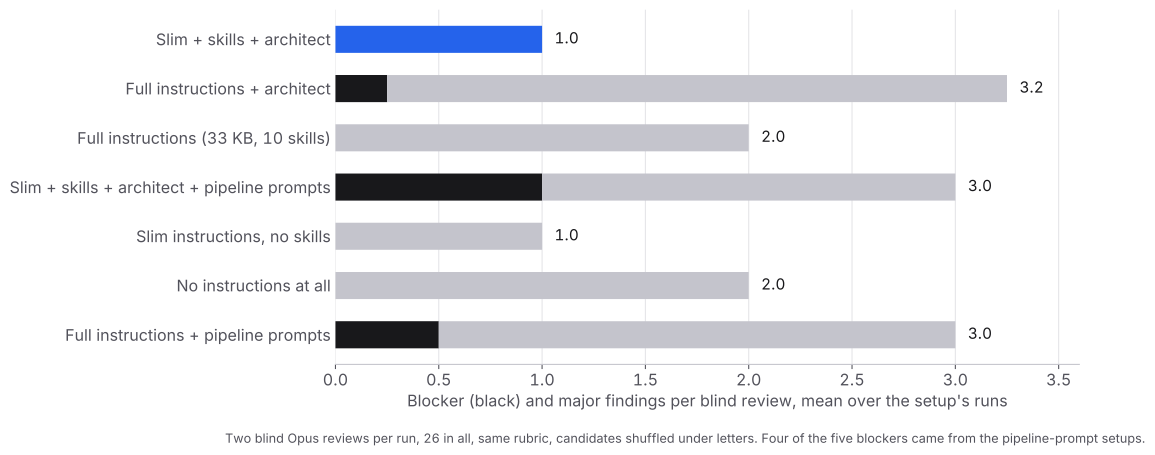
De goedkoopste opstelling had ook de minste ernstige bevindingen: geen blockers, en 1,5 en 0,5 majors per review in de twee runs. De volledige CLAUDE.md, B, bleef op 2,0 majors in alle drie de runs, hetzelfde als helemaal geen CLAUDE.md.
Dit is het resultaat dat me het meest aangaat. Het bestand heeft lange secties over beveiliging, permissies en credits, geschreven omdat een agent ze ooit oversloeg. Met of zonder het bestand vonden de reviewers hetzelfde aantal ernstige problemen, en dezelfde soorten kwamen terug bij alle opstellingen: een aanmelding die betaalt en daarna opzegt, een e-mail die verloren gaat of twee keer wordt verzonden als een worker halverwege faalt, een editor die inhoud overschrijft die hij niet kan tonen. Dat zijn redeneergaten over toestand in de tijd. Geen enkele regellijst in CLAUDE.md dekte die, want je kunt geen regel schrijven voor een edge case die je nog niet hebt bedacht.
Wat ze wel dekte, was een wijziging aan de architect-skill tussen de rondes. Voordat het hoofdmodel een briefing schrijft, schrijft het nu een tabel: elk acceptatiecriterium, wat er gebeurt als de toestand waarvan het afhangt in de tijd verandert, en het besliste gedrag. Elke rij gaat dan met een benoemde test in de briefing. De runs van G schreven 774 en 818 testregels, tegen 510 tot 670 voor B.
De planningsfase
A en E zijn de twee opstellingen die de prompts van onze CI-pijplijn draaiden: een planningsprompt die een plan schrijft, dan een implementatieprompt die het plan leest en uitvoert. Vergelijk elk met zijn tweelingbroer die in plaats daarvan een gewone prompt kreeg. A kostte $11,49 per run tegen $9,61 voor B en had blockers waar B er geen had. E kostte $10,13 tegen $6,68 voor G en had een blocker in elk van zijn reviews waar G er geen had.
Ik denk dat de reden is dat een plan een document is dat het model voor zichzelf schrijft en dan moet teruglezen als een instructie van buitenaf. De tweede sessie behandelt het plan als een specificatie, volgt het waar het fout zit, en besteedt beurten aan het verzoenen ervan met wat het in de code vindt. Een model dat zo capabel is, plant beter in de sessie die het werk gaat doen, waar het plan en de code in dezelfde context zitten.
Het deel van het plannen dat wel overleefde, is de briefing. Wanneer het hoofdmodel een stukje werk aan een Sonnet-worker geeft, begint die worker met een lege context en bouwt precies wat hem wordt gezegd. Die overdracht heeft een geschreven, besliste beschrijving nodig: het doel, de bestanden, het patroon om te spiegelen, de edge cases, de test die geschreven moet worden. Een plan voor jezelf is overhead. Een briefing voor iemand anders is de enige manier waarop het werk overkomt.
Wat grain-ponytail deed
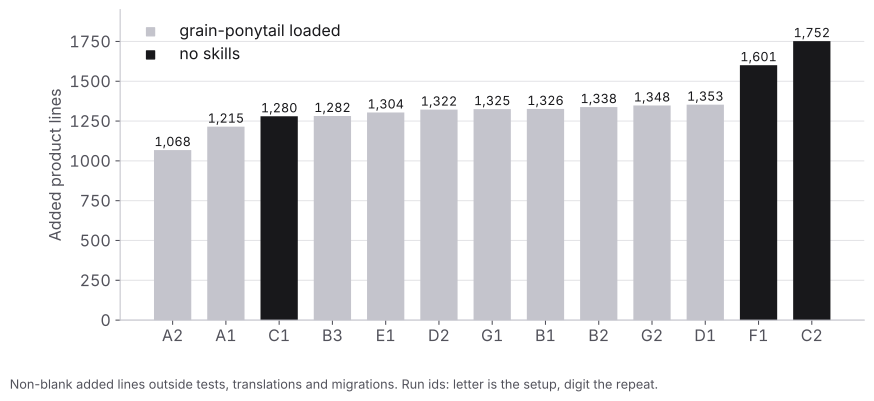
De skill uit code with the grain zegt tegen het model dat het het dichtstbijzijnde bestaande voorbeeld moet spiegelen en de minste code moet opleveren die werkt. Elke run die de skill geladen had, schreef tussen 1.068 en 1.353 productieregels. De twee grootste diffs, 1.601 en 1.752, kwamen uit runs zonder skills. Eén run zonder skills bleef op 1.280, dus de skill bepaalt de omvang niet alleen, maar hij haalde de staart eraf.
Het is ook het duidelijkste geval van wat voor soort instructie nog loont. “Spiegel het dichtstbijzijnde voorbeeld” verandert wat het model doet bij elk bestand dat het schrijft. “Gebruik snake_case voor functies” herhaalt iets wat het al doet.
Wat de reviews alsnog vingen
De winnende run was niet schoon. Na de test rebasede ik het werk van G2 op main en haalde het door onze volledige PR-check, die de diff beoordeelt, elke bevinding bewijst met een falende test, en de wijziging in een echte browser doorloopt. Die vond dat de stappeditor elk blok behalve het eerste HTML-blok liet vallen wanneer een beheerder een stap bewerkte die via MCP was aangemaakt, en dat een mislukte claim-release sommige gebruikers twee keer kon mailen. Beide zijn gerepareerd, met tests, voordat de PR naar menselijke review ging.
De blinde reviewers markeerden ook meer over-engineering in de architect-runs dan in de runs met volledige instructies: 2,5 items per review voor G tegen 0 tot 1,0 voor de runs van A en B. Minder ernstige bevindingen, meer nits. Die ruil zou ik nemen, maar het is een ruil.
Wat ik heb veranderd
- De CLAUDE.md van 33 KB werd een AGENTS.md van 12 KB die Codex ook leest, en CLAUDE.md importeert die nu alleen nog. Hij behoudt de commando’s, het testritme, de architectuur en de regels die een model niet uit de code kan afleiden, zoals welke paden kritiek zijn en dat de twee agent-oppervlakken in de pas moeten blijven.
- De planningsfase is uit de pijplijn. Triage geeft de issue direct aan een implementatiefase waarvan de prompt is ingekrompen tot zes stappen: lees de issue, maak een branch, laad de architect- en grain-ponytail-skills, test, commit, open een draft-PR.
- De architect-skill kreeg de edge-case-tabel, een Tests-veld in de briefing, en een laatste pass die de hele diff tegen de issue controleert in plaats van tegen de briefings. Die versie is openbaar op github.com/LivinTribunal/architect-skill .
De wijziging in de repository zit op het moment van schrijven in review.
Wat je hiervan moet meenemen
Als je CLAUDE.md incident per incident is gegroeid, betaal je waarschijnlijk voor regels die het model toch al volgt. Kort hem in tot wat het model niet kan ontdekken door de code te lezen, en meet voor en na op een echte taak in plaats van erop te vertrouwen dat meer begeleiding veiliger is.
Houd de instructies die veranderen hoe het werk wordt gedaan: wie de code typt, hoe een stukje werk wordt gebriefd, welk bestaand patroon je kopieert. Laat de plan-dan-uitvoeren-pijplijn vallen als je hoofdmodel een actueel frontier-model is. Schrijf briefings voor workers, geen plannen voor jezelf.
Methode
13 headless runs van Claude Code 2.1.289 op 5 oktober 2026, hoofdmodel Opus 5.5, workers Sonnet 5.5 waar de architect-skill delegeerde. Alle runs startten vanaf één commit van de FlowHunt-monorepo, elk in een APFS-clone met een eigen Postgres-database, gesandboxed van de andere runs en van de bestanden van het experiment zelf. Een broker pushte de commit van elke run naar een draft-PR tegen een bevroren basisbranch en hervatte de sessie met het CI-resultaat, tot drie rondes. Kosten zijn de maximale total_cost_usd per sessie, opgeteld over de hoofdsessie en zijn subagents. Productieregels zijn niet-lege toegevoegde regels buiten tests, vertalingen en migraties.
Elk resultaat kreeg twee blinde reviews door Opus met één rubric: correctheid, acceptatiecriteria, grain, privévelden en verborgen toestand, over-engineering, beveiliging en permissies, tests, migraties. Kandidaten werden onder letters geschud, en de reviewers mochten de repository lezen maar niets uitvoeren. Bevindingen per review zijn gemiddelden over de runs van een opstelling. Met één tot drie runs per opstelling moet je het gemiddelde van één opstelling als ruisig beschouwen. De conclusies hierboven zijn diegene die in beide rondes standhielden.
