


Een paar dagen geleden maakte Anthropic Fable een permanent onderdeel van de Max-abonnementen. De timing vertelt het verhaal: het kwam direct nadat OpenAI GPT-5.6 Sol uitbracht, en — belangrijker — direct nadat Kimi K3 zijn gewichten vrijgaf. Er was een open-source model nodig om het grootste AI-lab een realitycheck te laten ondergaan en de marketingophef rond zijn vlaggenschip te beëindigen. Alleen al dat verdient een toost van iedereen die deze facturen betaalt.
Maar “inbegrepen bij je abonnement” is niet hetzelfde als “goedkoop”, en zeker niet hetzelfde als “voor altijd goedkoop”. Daarom hebben we, terwijl Fable nog per gebruik werd afgerekend, onze workflow herbouwd zodat het dure model mechanisch geblokkeerd is om code te schrijven. Het denkt, plant en beoordeelt. Goedkopere modellen typen. Deze post laat zien hoe dat werkt, en wat het werkelijk opleverde over elk transcript dat we hebben — 606 echte sessies verspreid over een productie-SaaS-monorepo, een drone-operatie-app, een marketingsite en de CI-agenten die hen bedienen.
Deel 1 — De valkuil en het principe
Dit is ons eerlijke uitgangspunt: we kunnen niet meer werken zonder frontier-modellen. Niemand in het team zou de huidige output kunnen volhouden zonder hen — en die afhankelijkheid is precies de hefboom die de grote labs in handen hebben. Naar onze lezing leveren de AI-abonnementen van vandaag opvallend meer compute dan ze kosten; het zijn landjepikprijzen, en landjepikprijzen houden op te bestaan. Wanneer dat gebeurt, betaalt wie zijn engineeringcultuur bouwde rond “onbeperkte frontier-tokens” wat er ook gevraagd wordt.
Er zijn twee verdedigingslinies. De eerste is een geloofwaardige uitweg aanhouden: open modellen zoals DeepSeek en Kimi dwongen de prijscorrectie van deze week af, en ze blijven alleen een hefboom als we onze workflows echt overdraagbaar naar hen houden. De tweede is workflowdiscipline: besteed frontier-tokens alleen waar niets goedkopers werkt. Deze post gaat over de tweede — want die kun je maandag al beginnen.
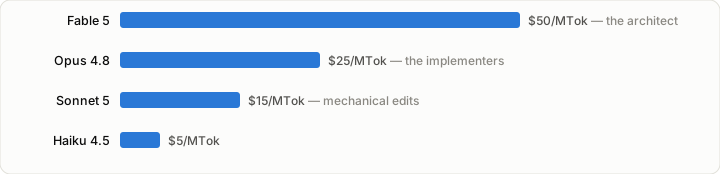
Het principe is oud genoeg om een gebouw naar zich vernoemd te hebben: de architect legt geen stenen. De voorsprong van een frontier-model op een middenklassemodel is enorm bij ontwerp, opsplitsing en review — en bijna nul bij het uittikken van een rename in veertig bestanden. Dus splits de rollen. De prijsladder zegt hetzelfde in dollars:
Hoe het fable-architect-patroon werkt
De fable-architect-skill is een markdownbestand van ongeveer 100 regels plus één shell-hook, geladen wanneer een Claude Code-sessie op het frontier-model draait. Hij dwingt een taakverdeling af:
- De architect doet: de eis ondervragen, de codebase verkennen, elke ontwerpbeslissing nemen — aanpak, datastroom, namen, signatures, randgevallen — het werk opdelen in onafhankelijke delen, de teruggekregen diffs beoordelen, verificatie uitvoeren en alle proza schrijven (plannen, brieven, PR-teksten, commit-berichten).
- De architect doet nooit: een bronbestand schrijven of bewerken. Geen code in de chat buiten korte signatures in een brief.
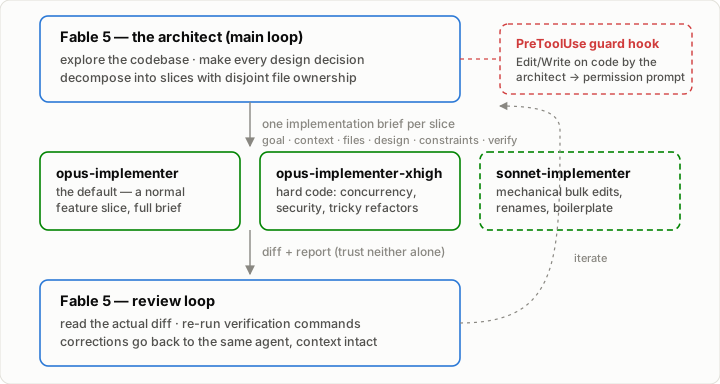
Drie dingen maken dit werkbaar in de praktijk in plaats van op een dia.
1. De brief is de interface
Elk deel krijgt één implementatiebrief. De uitvoerder begint met een vers contextvenster — alles wat niet in de brief staat, moet hij opnieuw ontdekken of gokken. Die beperking is een feature: ze dwingt de architect om klaar te zijn met beslissen voordat hij delegeert. Een brief bevat beslissingen, geen opties.
## Implementation brief: <slice>
Goal:         one sentence, observable outcome
Context:      what exploration already found — excerpts, the nearest
              pattern to mirror, line anchors, gotchas
Files:        paths to create/modify — this slice's exclusive ownership
Design:       the decided approach — data flow, names, signatures, edges
Constraints:  project rules that apply: style, layers, security
Out of scope: what not to touch, including files owned by other slices
Delegation:   may this slice spawn sub-implementers, and how many
Verify:       exact commands and expected outcome
Twee van die regels zijn nieuwer dan de rest, en ze bestaan omdat de uitvoerderslaag onder ons veranderde — zie de update hieronder.
2. Handhaving, geen gevoel
Een PreToolUse-guardhook houdt de sessie in de gaten: als de architect een niet-prozabestand probeert te bewerken, verschijnt een toestemmingsprompt. Het goedkeuren van de prompt is de gedocumenteerde uitzondering voor triviale bewerkingen (een typo, een versiebump — gevallen waarin de delegatieoverhead meer kost dan typen). Wrijving is het beleid. Zonder de hook houdt “het dure model zou niet moeten coderen” precies stand tot de eerste deadline.
3. De reviewloop dicht het kwaliteitsgat
De architect leest het rapport van de agent en de echte diff — geen van beide alleen vertrouwend — en voert de belangrijkste verificatiecommando’s opnieuw uit wanneer de bewering ertoe doet. Een probleem gevonden? De correctie gaat terug naar dezelfde agent, die nog steeds zijn volledige werkcontext heeft. Geen handmatig gefix, geen nieuwe spawn.
Let op: dit is de verificatie van de architect, en die blijft. Wat we beginnen te schrappen is de verificatie die we vroeger in brieven schreven — instructies waarin de uitvoerder zichzelf moest dubbelchecken. Nieuwere uitvoerdermodellen doen dat ongevraagd, en hen nog eens zeggen het te doen levert een tweede ronde op die je al betaald hebt.

Klaar om uw bedrijf te laten groeien?
Start vandaag uw gratis proefperiode en zie binnen enkele dagen resultaten.
Wat we hebben gemeten
Om te controleren of dit een echt economisch mechanisme is of slechts een plezierig ritueel, hebben we elk Claude Code-transcript in onze projecten gedolven, API-verzoeken gededupliceerd en elke token geprijsd tegen de huidige lijsttarieven. Drie hypotheses, geregistreerd voordat we naar de cijfers per sessie keken:
- H1 — De uitvoerders doen het typwerk. Als dit klopt, zouden uitvoerder-subagenten in gedelegeerde sessies meer outputtokens moeten produceren dan de hoofdlus van de architect.
- H2 — Delegatie is goedkoper. Als dit klopt, zou het herprijzen van het werk van de uitvoerders tegen de tarieven van het architectmodel beduidend duurder uitvallen dan wat we werkelijk betaalden.
- H3 — De kwaliteit blijft overeind. De moeilijke: gedelegeerde code zou niet meer herwerk mogen vergen dan code die de architect zelf typte.
Spelregels. Eén API-verzoek beslaat vele transcriptregels die hetzelfde usage-object herhalen — we groepeerden per request-ID, telden input- en cachetokens één keer per verzoek en namen de maximale output-snapshot (naïeve sommatie per regel overschat 2–3×). Kosten gebruiken de huidige Anthropic-lijstprijzen — Fable $10/$50, Opus $5/$25, Sonnet $3/$15 per miljoen input/outputtokens — met cachreads tegen 10% van de inputprijs en cachewrites tegen hun tarief per TTL. 31 van de 354 interactieve-store-sessies kwalificeren als fable-architect-sessies onder een conservatieve classifier; de cijfers tonen de acht duurste. We rapporteren ratio’s en percentages in plaats van onze absolute uitgaven.
Deel 2 — De bonnen
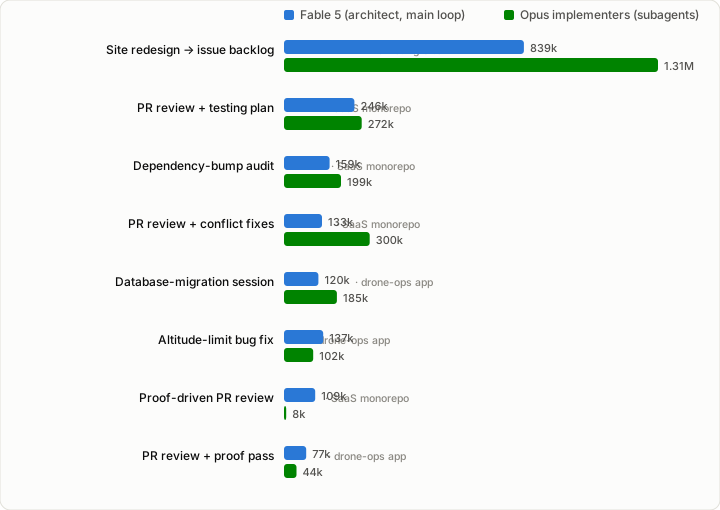
H1 — Gemengd… zei de eerste boekhouding. In de grootste delegatiesessies houdt de hypothese stand: tot 2,3× meer uitvoerderoutput dan architectoutput. Maar over alle 31 fable-architect-sessies produceerde de architect nog steeds meer dan de uitvoerders: 3,59M tegen 3,15M tokens. Deels is dat terecht — de output van de architect omvat alle plannen, brieven en reviewproza, wat precies zijn taak is — en deels leek het erop dat sessies één deel delegeerden en de rest zelf hielden. Toen herinnerden we ons dat onze site-redesign helemaal niet architectzwaar aanvoelde, en gingen we op zoek naar de tokens die de subagentboekhouding niet kon zien.
Schrijf u in voor onze nieuwsbrief
Ontvang gratis de nieuwste tips, trends en aanbiedingen.
Het tweede kanaal: de issuetracker als delegatiebus
Subagentboekhouding heeft een blinde vlek: ze ziet alleen delegatie die binnen een sessie plaatsvindt. De site-redesignsessie — de grootste lijn in de grafiek hierboven — bleek iets heel anders te zijn: één enkele architect-lussessie die 107 uur onafgebroken draaide (292 geplande wakeups), de redesign opdeelde in GitHub-issues, ze tagde voor onze CI-pipeline en vervolgens supervisie voerde: runs pollen, pull requests van de pipeline beoordelen, vervolgissues aanmaken wanneer QA bugs aan het licht bracht.
Het typwerk gebeurde ergens waar onze analyse per sessie niet eens had gekeken: een aparte vloot van self-hosted runners, waar de fasen plan → implementeren → hiaatanalyse → review van de pipeline werden uitgevoerd als 252 onafhankelijke Opus-sessies over 4,5 dag, met 48 verschillende issues en PR’s.
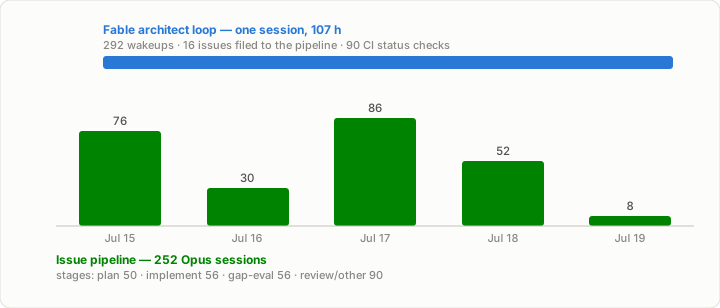
H1, opnieuw bekeken — Bevestigd op projectschaal. Tel beide kanalen mee en het beeld keert om: de pipeline typte 10× meer outputtokens dan de architect-lus die hem aanstuurde (9,07M tegen 877k), allemaal tegen Opus-tarieven. Die implementatiegolf op het model van de architect draaien zou 2,1× zoveel hebben gekost — voor één redesign, in één week, nog voordat de subagenten binnen de sessie meetelden. Een issue is gewoon een groverkorrelige brief: dezelfde interface, dezelfde economie, één niveau hoger.
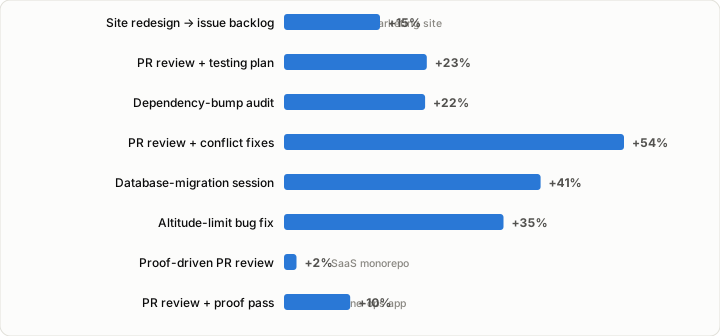
H2 — Bevestigd, met een wending. Het herprijzen van de exacte tokenvolumes van de uitvoerders tegen de tarieven van het architectmodel maakt elke sessie duurder — van +2% tot +54%, en 17% over de top acht. Echt geld, maar minder dan de 2×-kloof in outputprijs suggereert. De wending: de output is niet waar het geld naartoe gaat. In de grootste sessie kostten de cachreads van de architect ongeveer 13× zoveel als alles wat hij typte — de dominante uitgave is het dure model dat een grote orkestratiecontext vasthoudt en herleest, niet het typen. Delegatie begrenst de outputrekening; de volgende hefboom is de context van de architect slank houden.
H3 — Hier niet gemeten. Tokenboekhouding kan codekwaliteit niet zien. Wat we observationeel kunnen zeggen: de reviewloop is dragend — rapporten en diffs verschillen vaak genoeg van elkaar dat beide lezen niet onderhandelbaar is — en correcties die teruggaan naar een contextwarme agent convergeren snel. Als je dit repliceert en herwerk goed meet, willen we het zien, vooral als het ons weerlegt.
Wat de bredere data ons leerde
- Adoptie is een gradiënt, geen schakelaar. Bij de drone-ops-app — kleiner, sneller bewegend — draait 18% van de sessies op het fable-architect-patroon; bij de oudere SaaS-monorepo is dat 9%. Het project dat het hardst delegeerde, deed dat op beide korrelniveaus tegelijk: implementatiebrieven binnen de sessie en 252 pipelinesessies die via de issuetracker werden aangestuurd.
- De CI-vloot draait de skill niet — omdat zij de uitvoerder is. Onze geautomatiseerde runner-sessies spawnen nooit een uitvoerder-subagent, en in eerste instantie las dat als niet-adoptie. De prompts zeggen iets anders: elke sessie is een pipelinefase — verifiëren, reviewen, hiaatanalyse — en ongeveer zes op de tien werken aan een specifiek issue of PR. Op projectschaal zijn de pipelinerunners de uitvoerderslaag.
- De goedkoopste laag heeft nog geen eerste werkdag gehad. Alle 78+ uitvoerderruns waren Opus-klasse; de Sonnet-laag voor mechanische bewerkingen is pas recent toegevoegd en is nog niet aangeroepen. Welke besparing dit ook meet, het is een ondergrens.
De interface is het punt: brief erin, diff eruit — issue erin, PR eruit. Op de dag dat de prijsverhoging komt, vervang je de metselaar, niet het proces.
Volledige openheid. Modellen geverifieerd op basis van transcriptstrings, niet aangenomen. We hebben onszelf twee keer gecorrigeerd (eerst een overtelling van tokens per regel, daarna een placeholder-prijstabel). De counterfactual gaat ervan uit dat de architect dezelfde tokenvolumes zou hebben verbruikt als de uitvoerders — de foutmarges lopen beide kanten op. De pipelinesessies staan in een transcriptstore die onze eerste twee analyserondes niet meenamen; een boekhoudkundige grens verborg een delegatiekanaal van 9M tokens voor ons, en het jouwe heeft er waarschijnlijk ook een. De projecten van één engineer, vooral review-and-fix en featurewerk — geen gecontroleerde benchmark. Het corpus sluit ook voordat Opus 5 uitkwam: elk cijfer hierboven is Fable-als-architect boven Opus-4-klasse uitvoerders. De prijzen van de treden bewogen niet toen Opus 5 kwam, dus de gemeten ratio’s blijven staan — maar zie de volgende sectie voor wat wél bewoog.
Update — de ladder bewoog onder ons
Opus 5 kwam uit nadat deze metingen waren afgesloten, en niets in de prijsladder veranderde: Opus is nog steeds $5/$25 per miljoen input/outputtokens, Fable nog steeds $10/$50, en de grafiek hierboven klopt nog. Wat veranderde, is het vermogen op elke trede. Anthropic positioneert Opus 5 als een sprong vooruit in diep redeneren en langetermijn-agentwerk — dat wil zeggen: precies het werk waaruit de architectrol bestaat, tegen de helft van de prijs van de architectlaag.
Dat wijst recht naar onze eigen H2-wending. Als de dominante architectkost cachreads zijn, en cachreads worden gefactureerd tegen 10% van de inputprijs, dan herleest een architect op Opus 5 zijn orkestratiecontext tegen $0,50 per miljoen tokens in plaats van Fable’s $1,00. De kostenpost die 13× alles wat de architect typte kostte, wordt gehalveerd. We hebben dit niet gemeten — het is rekenwerk onder dezelfde aanname van gelijke tokenvolumes die we bij de 2,1×-counterfactual al aangaven, en het is het volgende dat we willen testen. Als het standhoudt, is de interessante vraag niet langer welk model typt maar of de architect de bovenste trede überhaupt nodig heeft.
Drie dingen aan de nieuwe uitvoerderslaag veranderen het patroon zelf, niet alleen de prijs:
- Het grijpt makkelijk naar subagenten — het omgekeerde van zijn voorganger, die überhaupt overtuigd moest worden om te delegeren. Een uitvoerder die stilletjes zijn eigen uitvoerders spawnt, vermenigvuldigt de rekening zonder dat iemand kijkt. Vandaar de regel
Delegation:in de brief: een deel vermeldt nu of het mag uitwaaieren, en hoe breed. - Het verifieert zijn eigen werk ongevraagd. Verificatie-instructies die voor oudere modellen zijn geschreven, kopen nu een overbodige tweede ronde, dus ze verdwijnen uit de brieven. De reviewloop van de architect blijft onaangeroerd.
- Het rekt de scope op.
Out of scope:is niet langer standaardtekst en wordt de regel die een deel een deel houdt.
En de trede die we nooit gebruikten, werd scherper terwijl we niet keken: Sonnet 5 komt dicht bij Opus-kwaliteit voor codeerwerk tegen $3/$15, met een introductieprijs daaronder tot eind augustus. “Welke besparing dit ook meet, het is een ondergrens” was een voorzichtige formulering toen we het schreven. Nu leest het als een understatement.
Deel 3 — Waar dit bewust naartoe gaat
We sturen bewust af op een splitsing waarvan we denken dat elk engineeringteam er uiteindelijk in gedwongen wordt: dure frontier-modellen alleen voor brainstormen, architectuur en review; steeds goedkopere modellen voor het programmeren zelf. Vandaag zijn onze uitvoerders Opus-klasse. Niets in de workflow verandert wanneer ze Sonnet-klasse, DeepSeek-klasse of Kimi-klasse worden — de interface is model-agnostisch door zijn opzet. Dat is de hele strategische waarde: op de dag dat de subsidie stopt en de factuur verdubbelt, veranderen teams met deze discipline één configregel. Teams zonder die discipline heronderhandelen hun hele kostenstructuur onder druk.
Fable-architect is een babystap — de adoptie is gedeeltelijk en de goedkoopste laag heeft zijn eerste run nog niet gehad. Maar het is de stap die de spier opbouwt: brieven schrijven die een deel volledig specificeren, diffs beoordelen die je niet zelf typte, de aandacht van het dure model als een budget behandelen. En de redesigngolf laat zien waar die spier naartoe leidt: zodra brieven werken, werken issues ook, en bemoeit het dure model zich helemaal niet meer met de implementatie.
Wat je maandag kunt doen
- Splits de rollen in je agent-harness. Eén regel op sessieniveau: het frontier-model plant en beoordeelt; delegeer alle bestandsbewerkingen naar een goedkopere uitvoerder-agent. In Claude Code is dat een skill plus subagentdefinities — een middagje instellen.
- Maak de grens mechanisch. Voeg een pre-edit-hook toe die de eigen bestandswijzigingen van het dure model aanvecht. Een regel die niets kost om te overtreden, is vrijdag al overtreden.
- Schrijf brieven met een vast template. Doel, context, bestanden, ontwerp, beperkingen, buiten scope, delegatiebudget, verifiëren. Het template is de discipline — en het delegatiebudget is wat een uitvoerder tegenhoudt om stilletjes zijn eigen mensen aan te nemen.
- Beoordeel zowel het rapport als de diff. Vertrouw nooit één van beide alleen; voer de verificatiecommando’s die ertoe doen opnieuw uit.
- Meet je eigen splitsing. Je transcripten bevatten de data al — groepeer per verzoek, prijs per model, en zie wie er werkelijk typt. De onze toonden een ongebruikte goedkope laag en een delegatiekanaal van 9M tokens waarvan we niets wisten.
- Verbreed de interface van brieven naar issues. Een brief delegeert een uur werk; een issue delegeert een dag werk. Zodra je issues acceptatiecriteria bevatten waar een pipeline op kan acteren, kan het dure model werk in de tracker zetten en superviseren in plaats van bij elk deel in de lus te zitten.
- Houd een uitweg warm. Draai een goedkoop of open model als uitvoerder voor één laagrisicodeel per week. Overdraagbaarheid die je nooit oefent, is overdraagbaarheid die je niet hebt.
- Herprijs de architect, niet alleen de metselaar. Elke modelrelease verschuift de treden zonder de ladder te verschuiven. Als het grootste deel van je architectuitgaven context is in plaats van typwerk, is een goedkopere architectlaag meer waard dan een goedkopere uitvoerderslaag — controleer welke van de twee je eigen transcripten zeggen dat je koopt.
De labs blijven ons vertellen dat hun topmodellen elke prijs waard zijn, en — irritant genoeg — voor oordeelswerk hebben ze meestal gelijk. De juiste zet is niet je onthouden. Het is stoppen met frontier-prijzen betalen voor for-loops.
