


Kortversjonen
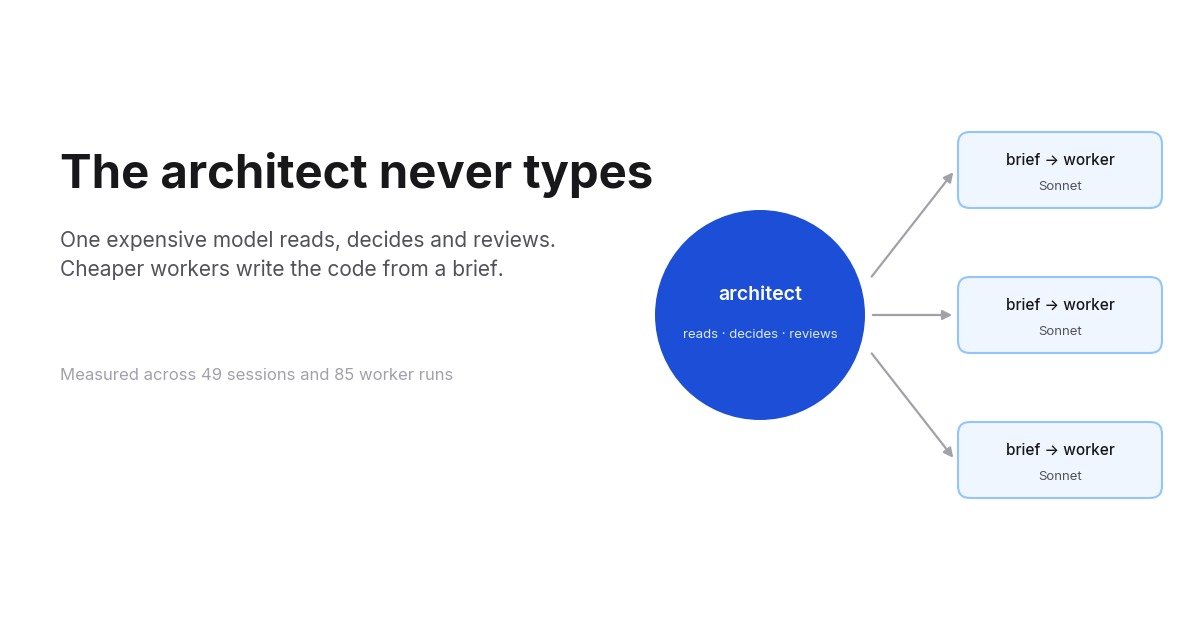
- I fem uker kjørte jeg kodeagenten min i en todeling: hovedmodellen, Opus og senere Fable, leser, bestemmer og vurderer, og en arbeideragent skriver koden fra en skriftlig brief. Jeg kaller det arkitektmønsteret, og det er nå en offentlig skill: architect-skill på GitHub , MIT-lisensiert.
- Hovedmodellen sluttet å skrive. Gjennom 49 arkitektøkter redigerte den en kildefil 6 ganger på 1 467 prompter. I 275 vanlige økter i de samme ukene redigerte den 244 filer på 3 081 prompter. Det er 0,4 mot 7,9 per 100 prompter.
- Totalt antall tokens per prompt falt ikke. De steg, kraftig, i to uker, og kom så tilbake dit vanlige økter ligger. Det som endret seg, er hvem som brukte dem: Opus-andelen av arbeider-tokens gikk fra 100 % til omtrent 4 %, og siden 14. september koster en prompt i en arkitektøkt 364k vektede tokens på hovedmodellen, 205k på Sonnet-arbeidere og 80k på Opus-arbeidere.
- Det er den fordelingen et abonnement bryr seg om. Claude Max måler sin ukentlige grense for alle modeller etter hver modells sats, så en Sonnet-token trekker på den med 40 % av en Opus-token, og Fable har en egen, strammere ukentlig grense som ingen arbeider berører.
- Jeg prøvde også å rute arbeiderne til DeepSeek gjennom en headless Claude Code. Prissatt etter listepris var den samme trafikken 10 $ i stedet for 202 $ på Sonnet eller 505 $ på Opus. På et abonnement finnes ikke den besparelsen, fordi abonnementet allerede er betalt. Jeg droppet det. Betaler du per token, bør du likevel lese den delen, for tallene er poenget.
Dette er det tredje innlegget i en serie. Det første målte hva én innstilling gjorde med et kontekstvindu, 17 % færre tokens , og det andre forklarer hva et kontekstvindu koster og hvorfor. Dette handler om den andre spaken: ikke hvor stor konteksten er, men hvilken modell som holder den.
Hva mønsteret er
En kodeagentøkt gjør to slags arbeid. Den tenker: leser kodebasen, finner ut hva som skal endres, bestemmer navn og signaturer og edge cases, sjekker diffen. Og den skriver: skriver koden, kjører testfilen, fikser lint. Tenkingen er der en frontiermodell fortjener prisen sin. Skrivingen er det ikke. Det meste av den er bestemt av beslutningen som kom før den, og en mindre modell utfører en bestemt plan omtrent like godt som en stor.
Så skillen deler økten. Hovedmodellen er arkitekten. Den gjør alt i hovedløkken bortsett fra å redigere en kildefil:
- Avhøre kravet og utforske kodebasen.
- Ta designbeslutningene: tilnærming, dataflyt, navn, signaturer, edge cases. Det nærmeste eksisterende mønsteret å speile. Den minste endringen som fikser rotårsaken.
- Dele opp i skiver som eier usammenhengende sett av filer.
- Skrive én implementeringsbrief per skive.
- Vurdere diffen som kommer tilbake, kjøre portene, committe.
Arbeideren er en subagent med et ferskt kontekstvindu. Den får briefen og ingenting annet, skriver koden, kjører testfilene briefen navngir, og returnerer en kort strukturert rapport. Så blir konteksten dens kastet. Den blir aldri en del av hovedøktens historikk, noe som betyr mer enn det høres ut som: alt hovedøkten leser, sendes på nytt ved hvert senere kall, så en arbeider som leser tolv filer og en testlogg i sin egen kontekst, holder alt det utenfor arkitektens regning.
Briefen er hele kontrakten. Min har sju felt, og skillen handler mest om å fylle dem godt:
## Implementeringsbrief: <skive>
Mål: én setning, observerbart utfall
Kontekst: hva utforskningen fant: utdrag, mønsteret som skal speiles, linjeankere, fallgruver
Filer: stier som skal opprettes/endres, eksklusivt eierskap for denne skiven
Design: den bestemte tilnærmingen: dataflyt, navn, signaturer, edge cases
Begrensninger: prosjektregler som gjelder: stil, lag, sikkerhet
Utenfor omfang: hva som ikke skal berøres, inkludert filer som eies av andre skiver
Verifiser: eksakte kommandoer og forventet utfall
En brief inneholder beslutninger, ikke alternativer. Hvis jeg fortsatt veier to tilnærminger mot hverandre, er jeg ikke klar til å delegere.
Det finnes ett unntak. Delegering har en fast overhead: å skrive briefen, oppstart av arbeideren, lese rapporten, vurdere diffen. En skrivefeilretting, en konfigurasjonsverdi, en versjonsbump, sletting av en død nøkkel, en énliniers fiks og regresjonstesten dens: for dem redigerer arkitekten direkte, fordi briefen ville koste mer enn redigeringen. Testen er kostnad, ikke antall linjer. I det øyeblikket redigeringen krever en designvurdering eller berører en sti som repoet flagger som kritisk, går den til en arbeider.

Klar til å vokse bedriften din?
Start din gratis prøveperiode i dag og se resultater i løpet av få dager.
Hvorfor et abonnement endrer regnestykket
Betaler du per token, er saken enkel. Opus 5 ligger på 5 $ per million input-tokens og 25 $ per million output; Sonnet 5 på 2 og 10. Hver token med implementering som flyttes fra Opus til Sonnet, koster 40 % av det den gjorde.
Jeg betaler et abonnement, og der er saken annerledes og, mener jeg, sterkere. Claude Max har to ukentlige grenser, ikke én: en grense på tvers av alle modeller, som hver token trekker på etter den modellens sats, og en separat, strammere grense som bare Fable trekker på. Opus har ingen egen grense. Det gir todelingen to effekter. Arbeid som en Sonnet-arbeider gjør, trekker på den delte grensen med 40 % av satsen en Opus-arbeider ville brukt, så å flytte to tredjedeler av en økts tokens til Sonnet gjør at uken varer lenger, selv om det totale antallet tokens er uendret. Og når arkitekten er Fable, er hver token den ikke bruker på å skrive, en token som blir igjen på grensen som tar slutt først. Så selv om arkitektmønsteret brukte nøyaktig like mange tokens som en vanlig økt, ville hvem som bruker dem fortsatt avgjøre når uken tar slutt.
Det “selv om” viste seg å gjøre mye arbeid.
Hva transkripsjonene sier
Claude Code skriver hver økt til en JSONL-transkripsjon, og hver arbeiderkjøring til en søsterfil under øktens katalog. Jeg har alle siden 19. august: 324 interaktive økter med tre eller flere prompter, hvorav 49 brukte mønsteret, altså at de startet en implementeragent eller sendte en brief til en. Tokens vektes slik regningen er: fersk input på 1, cache-skrivinger på 1,25 eller 2, cache-lesinger på 0,1. CI-kjøringer er utelatt.
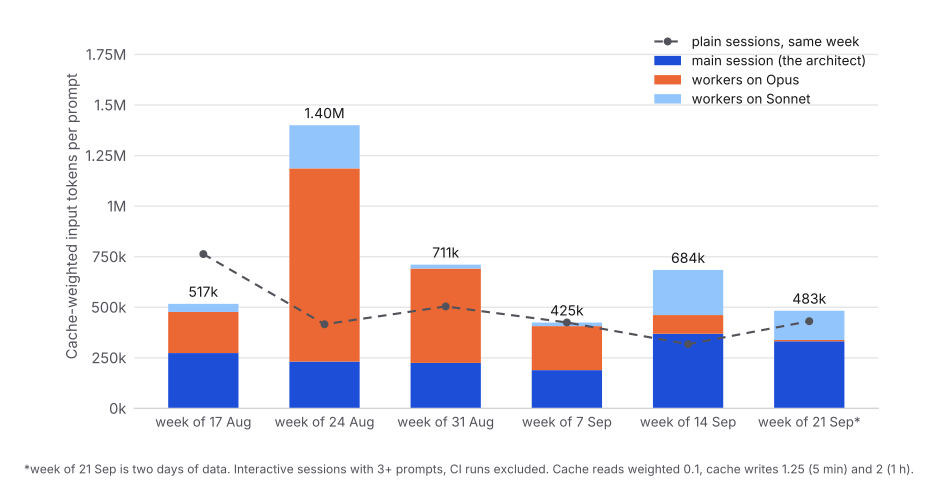
Les det fra venstre mot høyre, og det er ikke en suksesshistorie de første to ukene.
I uken 24. august kostet en arkitektøkt 1,40M vektede tokens per prompt. Vanlige økter samme uke kostet 0,42M. Tre og en halv gang mer, og nesten alt overskuddet var oransje: Opus-arbeidere. Jeg hadde gitt arbeiderne en god modell og ingen regler, og de oppførte seg som en god modell uten regler. Median Opus-arbeiderkjøring den uken var 176 runder. Flere kjørte hele backend-testsuiten, noe som legger omtrent 100 KB med output inn i en kontekst som sendes på nytt ved hver runde etterpå. Én økt med seks arbeidere 14. september, etter at jeg allerede hadde begynt å stramme inn, brant fortsatt 245M input-tokens over 1 585 runder for å produsere omtrent seks tusen linjer diff. Prompt-caching fungerte med 91,6 % treffrate hele tiden. Regningen var volum, ikke prising.
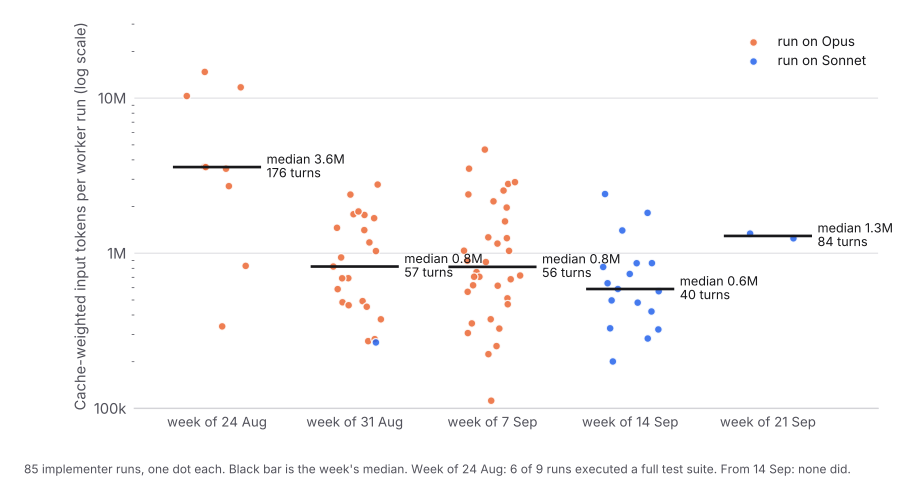
Arbeiderstripen viser hvor reglene landet. Tre av dem gjorde mesteparten av jobben, og jeg skrev dem inn i agentdefinisjonene i stedet for i briefen, så de gjelder enten jeg husker dem eller ikke:
- En arbeider kjører aldri en full testuite. Den kjører testfilene briefen navngir. Arkitekten kjører portene.
maxTurnser taket i agentdefinisjonen, 140 for Sonnet og 160 for Opus. En skive som trenger 250 runder, var briefet feil.- En skive holder seg under omtrent tolv filer, og briefen under omtrent 8 KB. Briefen sendes også på nytt hver runde.
I uken 31. august var median arbeiderkjøring 57 runder og 0,8M vektede tokens. Fra 14. september, da jeg flyttet standardruten til Sonnet, var den 40 runder og 0,6M, og ingen arbeider har kjørt en full suite siden.
Totalen per prompt fulgte etter: 711k, 425k, 684k, 483k over de fire siste ukene, mot vanlige økter på 505k, 425k, 318k, 431k. Arkitektøkter koster nå omtrent det vanlige økter koster. Litt mer i to av de fire ukene, litt mindre i én. Det de kjøper for det, er de to neste diagrammene.
Bli med i vårt nyhetsbrev
Få de siste tipsene, trendene og tilbudene gratis.
Hovedmodellen sluttet å skrive
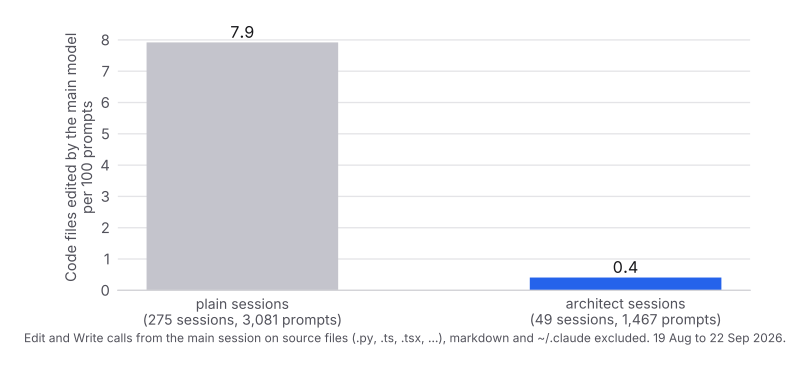
Dette er tallet jeg satte meg fore å endre, og det endret seg. I vanlige økter gjorde hovedmodellen 244 Edit- eller Write-kall på kildefiler på tvers av 3 081 prompter. I arkitektøkter gjorde den 6 på tvers av 1 467. De 6 er alle unntak for små redigeringer som jeg kan redegjøre for.
Samtidig var arbeiderne produktive. De 85 arbeiderkjøringene gjorde 2 510 kildefilredigeringer. Teller man hovedløkke og arbeidere sammen, produserte en arkitektøkt 2 516 kodeendringer fra 1 467 prompter; vanlige økter produserte 943 fra 3 081. Per kodeendring brukte en arkitektøkt 403k vektede tokens totalt og 330k på Opus-familien. En vanlig økt brukte 1 410k og 1 324k. Jeg vil være forsiktig med den sammenligningen, fordi de to populasjonene ikke er det samme arbeidet: en økt klassifiseres som arkitekt ved å delegere kode, så arkitektøkter er kodeintensive per konstruksjon, og vanlige økter inkluderer research, vurderinger og feilsøking som aldri redigerer noe. Les det som “mønsteret får skrevet mye kode per token”, ikke som en påstand om fire ganger effektivitet.
Den renere påstanden er modellfordelingen. Siden 14. september koster en prompt i en arkitektøkt 364k vektede tokens i hovedløkken, 205k i Sonnet-arbeidere og 80k i Opus-arbeidere. Opus-arbeidernes andel av alle arbeider-tokens var 100 % i august og omtrent 4 % i uken 21. september. På en Max-plan betyr det at den delte ukentlige grensen trekkes på Sonnets sats i stedet for Opus’ for nesten alt implementeringsarbeidet, og at ingenting av det berører Fable-grensen.
To ting ble ikke bedre, og jeg sier det heller enn å la diagrammene antyde noe annet. Hovedøktens egen kontekst krympet ikke: arkitektøkter kompakterte 8,7 ganger per 100 prompter mot 4,7 for vanlige økter, fordi arkitekten leser mye før den briefer. Og mønsteret er tregere i veggklokketid på små oppgaver, fordi en arbeiders oppstart og rapport er minutter du ikke betaler når du bare gjør redigeringen. Unntaket for små redigeringer finnes fordi den første versjonen av skillen ikke hadde noe, og jeg så meg selv skrive en 3 KB brief for en tolinjers endring.
DeepSeek-omveien
Da arbeiderne var blitt Sonnet, var det åpenbare neste spørsmålet om de i det hele tatt måtte være en Claude-modell. Fra 13. til 18. september pekte jeg arbeideren mot DeepSeek V4.1 Flash gjennom en headless Claude Code med ANTHROPIC_BASE_URL satt til et kompatibelt endepunkt, først via OpenRouter og deretter nativt. Samme brief-format, samme rapportformat, samme arkitekt. 2 732 kall, 431M input-tokens hvorav 88 % var cache-lesinger, 1,7M output-tokens.
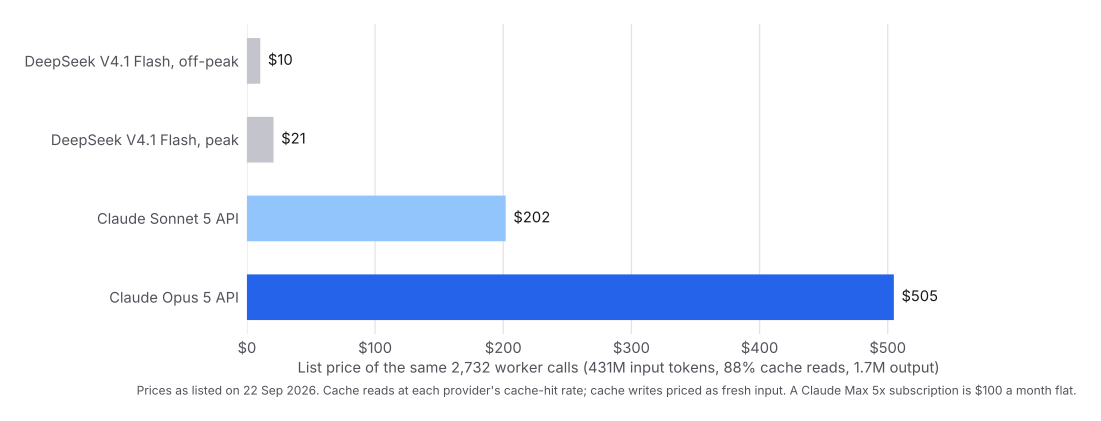
Til listepriser 22. september koster den trafikken omtrent 10 $ på DeepSeek off-peak, 21 $ på peak, 202 $ på Sonnet-API-en og 505 $ på Opus-API-en. Hadde jeg betalt per token, ville dette vært overskriften i innlegget, og jeg ville ha beholdt det.
Jeg betaler ikke per token, og det er hele argumentet. Et Max-abonnement koster 100 $ i måneden enten jeg bruker 30 % av den ukentlige grensen eller 100 %. Å flytte arbeidertrafikk til DeepSeek senket ikke den regningen med en cent. Det la til en ekstra regning på 10 til 21 $ i uken på toppen, for å spare kapasitet på en plan hvis kapasitet jeg allerede hadde betalt for. Jeg hadde forvekslet “billigere enn API-en” med “billigere enn det jeg betaler”, og de er ikke det samme når det du betaler, er flatt. Den riktige sammenligningen for en abonnent er DeepSeek mot et ekstra abonnement, og der koster en ekstra Claude-plan eller en ChatGPT-plan med Codex omtrent det samme som en måned med moderat DeepSeek-bruk, og kommer med sin egen ukentlige grense, sin egen modell og ingen måling å følge med på.
Kvalitet var den andre halvdelen. Fem backend-skiver kom tilbake rene og ble committet som de var. Én frontend-skive fjernet et eksportert symbol og lot hver forbruker av det stå urørt, så treet kompilerte ikke, og en senere skive måtte rydde opp. Det er nøyaktig feilen en modell som utfører en spesifikasjon har, og som en modell som utleder formen på en komponent fra søsknene dens ikke har, og skillen sier det nå: endringer i delt API-flate går til Sonnet, og arbeiderregelen lyder “fjern eller gi aldri nytt navn til et eksportert symbol uten å migrere hver forbruker i samme kjøring”. DeepSeek Flash er en god utfører. Arkitektmønsteret trenger en arbeider som legger merke til når briefen undervurderte forbrukerne, og det er den ene tingen en brief ikke kan levere.
Så rutetabellen i dag har to rader. Rutinearbeid, backend-arbeid mot en detaljert brief med tester som skal tilfredsstilles, frontend-arbeid som følger en eksisterende designgrammatikk, og enhver endring av en delt API-flate går til sonnet-implementer. Arbeid der vanskeligheten ligger i resonneringen, går til opus-implementer: et asynkront race, en refaktorering på flere steder der korrektheten avhenger av steder briefen ikke kan regne opp, en backfill-migrering som ingen enkelt test beviser. Rut etter form, aldri etter risiko. Risiko endrer hvor hardt diffen vurderes og om et menneske signerer den. Den endrer aldri hvem som skriver den.
Vurderingsløkken, som er der mønsteret tjener eller taper innsatsen
En arbeiders rapport er en påstand. Skillens vurderingsløkke er kort, og hver linje kom fra å bli brent:
- Les rapporten og den faktiske
git diff. Kryssjekk diffstat-en arbeideren oppgir mot den du ser. - Kjør nøkkelverifiseringen på nytt selv når påstanden betyr noe.
- Fant du et problem? Send korreksjonen til den samme arbeideren. Den har fortsatt konteksten sin og tar opp der den sluttet. Ikke fiks det for hånd, ikke start på nytt.
- To mislykkede korreksjoner betyr at briefen var underspesifisert, ikke at modellen er for liten. Del opp, legg det manglende utdraget i Kontekst, kjør på nytt. Ikke klatre til en større modell, for den vil implementere den samme misforståelsen mer flytende.
- Kjør de avgrensede portene før du aksepterer noe: de berørte testene, linteren på de berørte filene, hvilket konvensjonsskript repoet enn har.
I transkripsjonene sendte jeg omtrent én korreksjon per arbeiderkjøring, 52 over 85 kjøringer, og 7 Opus-kjøringer traff taket sitt på 160 runder, alle på en skive jeg nå ville delt opp. Det er de to tallene jeg følger med på. Hvis korreksjoner per kjøring går opp, blir briefene mine late. Hvis arbeidere treffer taket, er skivene mine for store.
Hva du bør ta med deg fra dette
Betaler du per token: sett den dyre modellen på beslutninger og vurdering, sett en billig på implementering, og prissett arbeidertrafikken din etter listepris før du velger hvilken billig en. Diagrammet med fire søyler er argumentet.
Betaler du et abonnement: mønsteret kutter ikke antallet tokens. Det flytter implementeringstokenene til modellen som trekker den delte ukentlige grensen langsomst, beholder Fable-grensen for arbeidet bare Fable bør gjøre, og hindrer din dyreste modell i å bruke rundene sine på å skrive. Ikke legg til en målt API ved siden av for å “spare” kapasitet du allerede har kjøpt. Går du tom for arbeiderkapasitet, kjøp et ekstra abonnement.
Uansett: reglene som fikk det til å fungere, var de kjedelige. Ingen fulle testsuiter i en arbeider. Sett tak på runder. Små skiver, korte briefer. Korriger den samme arbeideren én gang, og fiks så briefen.
Skillen, de tre agentdefinisjonene og vaktkroken ligger på github.com/LivinTribunal/architect-skill under MIT. Kompanjongskillen som forteller arbeideren hvordan den skal skrive kode som matcher repoet den lander i, er grain-skill , og innlegget om den er code with the grain .
Metode
Alt innlegget beskriver, ligger i github.com/LivinTribunal/architect-skill : skillen selv, briefmalen, rutetabellen, de tre implementeragentdefinisjonene med rundetakene og kontekstreglene sine, og vaktkroken. Installer den, og du har oppsettet tallene nedenfor kom fra.
Økter er Claude Code JSONL-transkripsjoner fra 19. august til 22. september 2026, entrypoint cli, tre eller flere brukerprompter. En økt klassifiseres som arkitekt hvis den startet opus-implementer, opus-implementer-xhigh eller sonnet-implementer, kjørte en ds-slice-arbeider, påkalte arkitektskillen, eller sendte en melding som inneholdt en implementeringsbrief til en general-purpose-agent, som var måten de tidlige ukene fungerte på før de navngitte agentene fantes. Arbeiderkjøringer er subagent-transkripsjonene under hver økts katalog. Bruk er deduplisert etter request-id og vektet fersk input 1, fem-minutters cache-skriving 1,25, én-times cache-skriving 2, cache-lesing 0,1. “Kodeendring” er et Edit- eller Write-kall på en .py-, .ts-, .tsx-, .js-, .sql- eller lignende kildefil, unntatt markdown og alt under ~/.claude. DeepSeek-priser er nativ listepris 22. september 2026, off-peak og peak, med cache-lesinger til cache-treffraten og cache-skrivinger priset som fersk input; Claude API-priser er de publiserte listeprisene for Opus 5 og Sonnet 5 med cache-lesinger på en tidel av input. Uken 21. september er to dager med data.
