


Kortversjonen
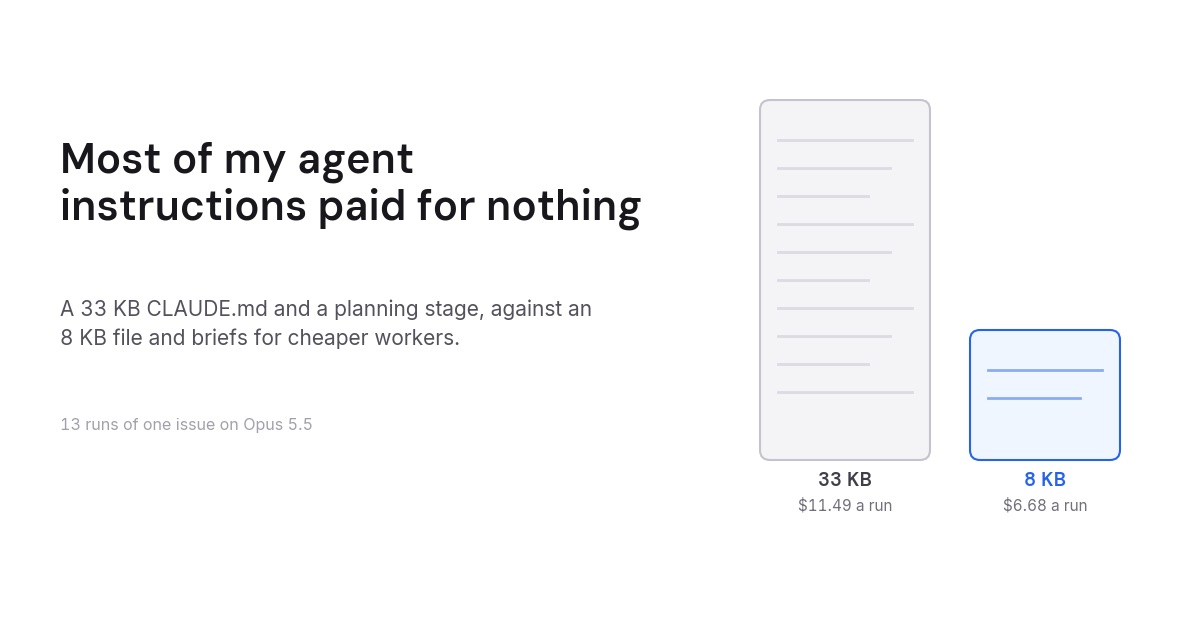
- Jeg tok én reell sak fra FlowHunt-backlogen og lot Claude Code implementere den 13 ganger på Opus 5.5, under sju ulike instruksjonsoppsett. Hver kjøring startet fra samme commit, i sin egen klone med sin egen database, og gikk gjennom vår ekte GitHub-CI. To blinde Opus-gjennomganger vurderte hvert resultat.
- CLAUDE.md-filen på 33 KB i repoet ga ikke målbar kvalitet. Kjøringer med den fikk 2,0 blokkerende og alvorlige funn per gjennomgang. En kjøring helt uten instruksjonsfil fikk det samme. En fil på 5,5 KB fikk 1,0.
- Et eget planleggingssteg gjorde ting verre. Begge oppsettene som kjørte en planleggingsprompt og deretter en implementeringsprompt, kostet mer enn tvillingene sine med vanlig prompt, og de sto for fire av de fem blokkerende funnene i alle 26 gjennomganger.
- Vinneren var en CLAUDE.md på 8 KB, tre skills, Sonnet-arbeidere og en vanlig prompt. De to kjøringene kostet i snitt $6,68 til API-listepris. Det fulle oppsettet med pipeline-prompter kostet i snitt $11,49, omtrent 1,7 ganger så mye, og hadde flere funn.
- Det som overlevde av all strukturen jeg hadde bygget, er briefen: en kort, vedtatt beskrivelse av én arbeidsbit som hovedmodellen skriver for en billigere arbeider. Planer for hovedmodellen selv lønte seg ikke. Modellen planlegger fint på egen hånd.
Dette følger opp innlegget om arkitektmønsteret , som målte hvem som bør skrive koden. Dette innlegget spør hvor mye hovedmodellen trenger å få vite før den begynner.
Hvorfor jeg kjørte testen
Monorepoet vårt hadde samlet mye agentinstruksjoner. Rot-CLAUDE.md var på 33 KB: byggekommandoer, testfrekvens, kodestil, arkitektur, kritiske stier, sikkerhetsregler, regler for tillatelser og kreditter, de to agentflatene, innsending av saker, PR-konvensjoner. Ti skills lå under .claude/skills/. På toppen av det kjørte CI-pipelinen vår (vi kaller den harnext) en sak gjennom en tagger, et triagesteg, et planleggingssteg som skrev en plan som kommentar på saken, og et implementeringssteg som leste planen tilbake og skrev koden – hvert med sin egen lange systemprompt.
Hver linje av dette var lagt til av en grunn, vanligvis etter at en agent gjorde noe feil. Spørsmålet ingen hadde stilt, var om det fortsatt hjalp. En CLAUDE.md lastes inn i hver sesjon og sendes på nytt for hver tur. Hvis modellen ville gjort det riktige likevel, er de tokenene en skatt, og som hva et kontekstvindu koster forklarer, summerer en skatt per tur seg opp raskere enn det ser ut.

Klar til å vokse bedriften din?
Start din gratis prøveperiode i dag og se resultater i løpet av få dager.
Testen
Saken var en tidsstyrt e-postsekvens for nye registreringer: en admin definerer steg som “dag 0: velkommen” og “dag 5: prøveperioden din slutter snart”, og en bakgrunnsoppgave sender e-post til hver konto på riktig dag, stopper når personen kjøper et betalt abonnement, og hopper over kontoer opprettet før lansering. Den trenger en migrasjon, et repository, en tjeneste, en Celery beat-oppgave, REST-endepunkter, MCP-verktøy for agenter og et konsollgrensesnitt på 11 språk. Det er en realistisk uke-én-funksjon, og den har flere kanttilfeller som er lette å overse.
Hver kjøring var en headless Claude Code-sesjon på Opus 5.5, sandkasset i sin egen klone og database, med et skript som pushet commiten til en draft-PR og matet CI-resultatet tilbake inn i sesjonen, opptil tre runder. Kostnad er Claude Codes egen total_cost_usd for hovedsesjonen pluss alle subagenter, priset til API-listepris. Jeg betaler et abonnement, så dette er et mål på arbeid, ikke på regningen min.
De sju oppsettene:
| Oppsett | Kjøringer | |
|---|---|---|
| A | Full CLAUDE.md på 33 KB og ti skills, pipeline-prompter (planlegg, deretter implementer) | 2 |
| B | Full CLAUDE.md og skills, vanlig prompt | 3 |
| C | Ingen CLAUDE.md, ingen skills, vanlig prompt | 2 |
| D | Full CLAUDE.md pluss architect-skillen, vanlig prompt | 2 |
| E | CLAUDE.md på 8 KB, architect, grain-ponytail og unslop, pipeline-prompter | 1 |
| F | CLAUDE.md på 5,5 KB, ingen skills, vanlig prompt | 1 |
| G | CLAUDE.md på 8 KB, architect, grain-ponytail og unslop, vanlig prompt | 2 |
A til D kom først. E til G ble bygget ut fra det de viste, og den tredje B-kjøringen gikk sammen med dem som en kontroll. Filen på 8 KB er 5,5 KB-filen pluss en kort liste over skillsene og når de skal lastes, og reglene for modellruting som får architect-skillen til å delegere til Sonnet.
Hvert resultat gikk deretter til to Opus-vurderere som bare så en bokstav, diffen, repoet og saken. De listet opp hver endring de ville bedt om før de godkjente, graderte som blokkerende, alvorlig, mindre eller bagatell, og sjekket hvert akseptansekriterium mot en fil og linje.
Kostnad
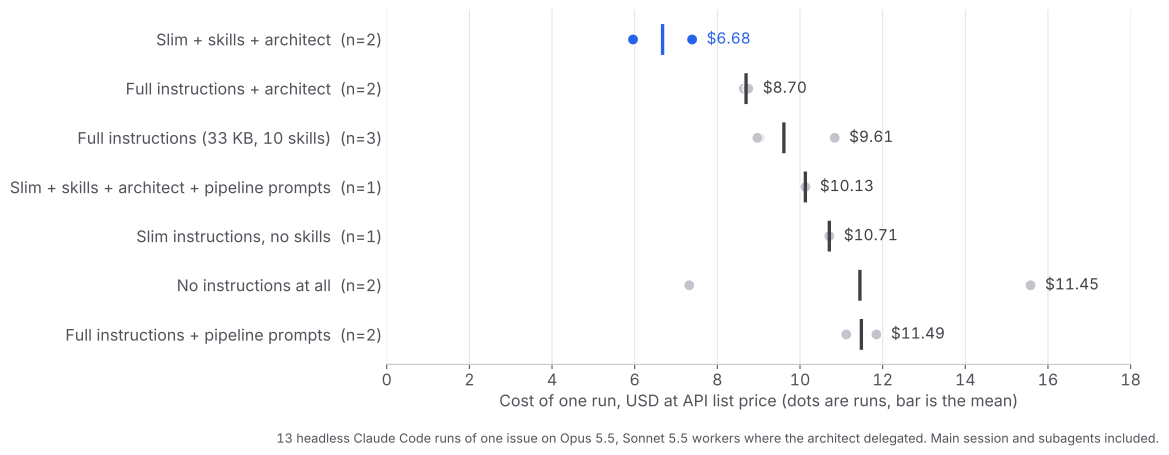
Det vinnende oppsettet, G, kostet $5,96 og $7,39. Det fulle oppsettet med pipeline-prompter, A, kostet $11,12 og $11,85. Gapet handler mest om turer og hva hver tur bærer med seg. A sine hovedsesjoner kjørte 172 og 144 turer på Opus med 24 til 28 millioner input-tokens. G sine kjørte 79 og 95 turer med 13 til 16 millioner, og ga omtrent 60 turer mer til Sonnet-arbeidere, som faktureres til en brøkdel av prisen. G ble også ferdig med arbeidet på omtrent 21 minutter, mot A sine 45.
To ting på dette diagrammet overrasket meg. Ingen instruksjoner i det hele tatt er ikke det billige alternativet: de to kjøringene kostet $7,32 og $15,58, og den dyre feilet også CI og skrev testens største diff. Og filen på 5,5 KB uten skills, F, var ikke billigere enn det fulle oppsettet. Den skrev mer kode, 1 601 produktlinjer, og betalte for det. Besparelsen i G kommer ikke fra den korte filen alene. Den kommer fra den korte filen pluss de to skillsene som endrer hvordan arbeidet gjøres.
Bli med i vårt nyhetsbrev
Få de siste tipsene, trendene og tilbudene gratis.
Kvalitet
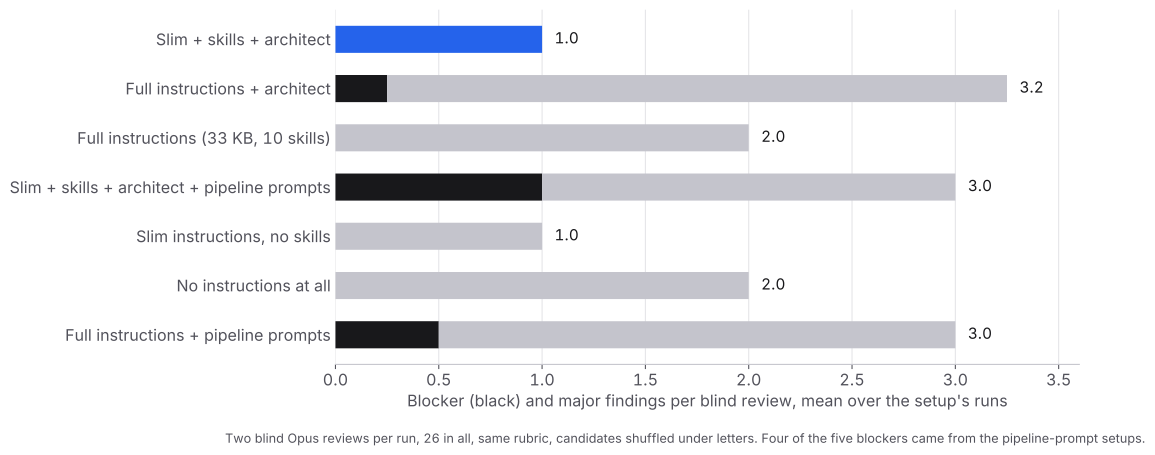
Det billigste oppsettet hadde også færrest alvorlige funn: ingen blokkerende, og 1,5 og 0,5 alvorlige funn per gjennomgang på sine to kjøringer. Den fulle CLAUDE.md, B, lå på 2,0 alvorlige funn på alle tre kjøringene, det samme som helt uten CLAUDE.md.
Dette er resultatet jeg bryr meg mest om. Filen har lange avsnitt om sikkerhet, tillatelser og kreditter, skrevet fordi en agent en gang hoppet over dem. Med eller uten filen fant vurdererne like mange alvorlige problemer, og de samme typene dukket opp på tvers av oppsettene: en registrert bruker som betaler og deretter sier opp, en e-post som forsvinner eller sendes to ganger når en arbeider feiler halvveis, en editor som overskriver innhold den ikke kan vise. Dette er resonneringshull rundt tilstand over tid. Ingen regelliste i CLAUDE.md dekket dem, fordi du ikke kan skrive en regel for et kanttilfelle du ennå ikke har tenkt på.
Det som dekket dem, var en endring i architect-skillen mellom rundene. Før hovedmodellen skriver noen brief, skriver den nå en tabell: hvert akseptansekriterium, hva som skjer når tilstanden det avhenger av endrer seg over tid, og den vedtatte oppførselen. Hver rad går så inn i briefen med en navngitt test. G sine kjøringer skrev 774 og 818 testlinjer, mot 510 til 670 for B.
Planleggingssteget
A og E er de to oppsettene som kjørte promptene fra CI-pipelinen vår: en planleggingsprompt som skriver en plan, deretter en implementeringsprompt som leser planen og utfører den. Sammenlign hver av dem med tvillingen som i stedet fikk en vanlig prompt. A kostet $11,49 per kjøring mot B sine $9,61 og hadde blokkerende funn der B ikke hadde noen. E kostet $10,13 mot G sine $6,68 og hadde et blokkerende funn i hver av gjennomgangene sine, der G ikke hadde noen.
Jeg tror grunnen er at en plan er et dokument modellen skriver til seg selv og deretter må lese tilbake som en instruks utenfra. Den andre sesjonen behandler planen som en spesifikasjon, følger den der den er feil, og bruker turer på å forene den med det den finner i koden. En modell på dette nivået planlegger bedre inne i sesjonen som skal gjøre arbeidet, der planen og koden er i samme kontekst.
Den delen av planleggingen som overlevde, er briefen. Når hovedmodellen gir en bit videre til en Sonnet-arbeider, starter arbeideren med tom kontekst og bygger nøyaktig det den får beskjed om. Den overleveringen trenger en skriftlig, vedtatt beskrivelse: målet, filene, mønsteret som skal speiles, kanttilfellene, testen som skal skrives. En plan for deg selv er overhead. En brief for noen andre er den eneste måten arbeidet kommer videre på.
Hva grain-ponytail gjorde
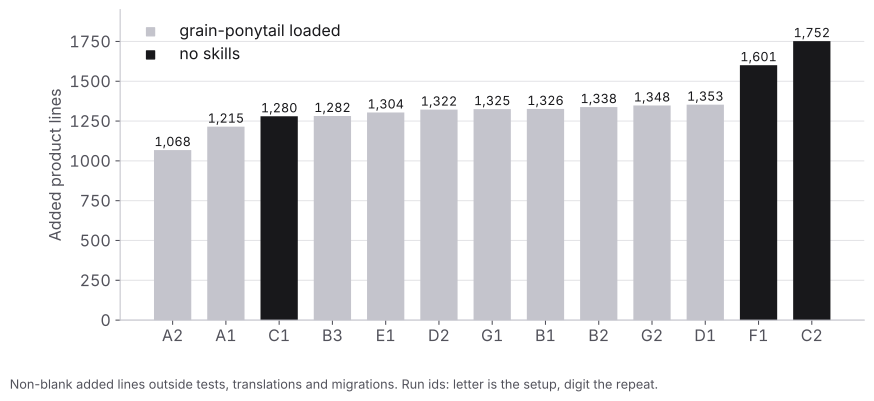
Skillen fra kode med hårene ber modellen speile det nærmeste eksisterende eksempelet og levere minst mulig kode som virker. Hver kjøring som hadde den lastet, skrev mellom 1 068 og 1 353 produktlinjer. De to største diffene, 1 601 og 1 752, kom fra kjøringer uten skills. Én kjøring uten skills holdt seg på 1 280, så skillen avgjør ikke størrelsen alene, men den fjernet halen.
Det er også det klareste eksempelet på hva slags instruksjon som fortsatt lønner seg. “Speil det nærmeste eksempelet” endrer hva modellen gjør i hver fil den skriver. “Bruk snake_case for funksjoner” gjentar noe den allerede gjør.
Hva gjennomgangene fortsatt fanget opp
Den vinnende kjøringen var ikke feilfri. Etter testen rebaset jeg arbeidet fra G2 inn på main og kjørte det gjennom vår fulle PR-sjekk, som gjennomgår diffen, beviser hvert funn med en feilende test og driver endringen i en ekte nettleser. Den fant at stegeditoren mistet alle blokker bortsett fra den første HTML-blokken når en admin redigerte et steg opprettet via MCP, og at en mislykket frigjøring av en claim kunne sende e-post til noen brukere to ganger. Begge ble fikset, med tester, før PR-en gikk til menneskelig gjennomgang.
Blindvurdererne flagget også mer overengineering i architect-kjøringene enn i dem med fulle instruksjoner: 2,5 punkter per gjennomgang for G mot 0 til 1,0 for kjøringene til A og B. Færre alvorlige funn, flere bagateller. Jeg ville tatt den byttehandelen, men det er en byttehandel.
Hva jeg endret
- CLAUDE.md på 33 KB ble en AGENTS.md på 12 KB som Codex også leser, og CLAUDE.md importerer nå bare den. Den beholder kommandoene, testfrekvensen, arkitekturen og reglene en modell ikke kan utlede fra koden, som hvilke stier som er kritiske og at de to agentflatene må holde tritt.
- Planleggingssteget er borte fra pipelinen. Triage gir saken direkte videre til et implementeringssteg der prompten er krympet til seks steg: les saken, lag branch, last architect- og grain-ponytail-skillene, test, commit, åpne en draft-PR.
- Architect-skillen fikk kanttilfelle-tabellen, et Tests-felt i briefen og en siste gjennomgang som sjekker hele diffen mot saken i stedet for mot briefene. Den versjonen er offentlig på github.com/LivinTribunal/architect-skill .
Endringen i repoet er til gjennomgang på det tidspunktet jeg skriver dette.
Hva du bør ta med deg fra dette
Hvis CLAUDE.md-en din vokste fram én hendelse om gangen, betaler den sannsynligvis for regler modellen allerede følger. Kutt den ned til det modellen ikke kan finne ut ved å lese koden, og mål før og etter på en reell oppgave i stedet for å stole på at mer veiledning er tryggere.
Behold instruksjonene som endrer hvordan arbeidet gjøres: hvem som skriver koden, hvordan en bit briefes, hvilket eksisterende mønster som skal kopieres. Dropp planlegg-deretter-utfør-pipelinen hvis hovedmodellen din er en aktuell frontier-modell. Skriv briefer for arbeidere, ikke planer for deg selv.
Metode
13 headless-kjøringer av Claude Code 2.1.289 den 5. oktober 2026, hovedmodell Opus 5.5, arbeidere Sonnet 5.5 der architect-skillen delegerte. Alle kjøringer startet fra én commit i FlowHunt-monorepoet, hver i en APFS-klone med sin egen Postgres-database, sandkasset fra de andre kjøringene og fra eksperimentets egne filer. En broker pushet hver kjørings commit til en draft-PR mot en frosset basegren og gjenopptok sesjonen med CI-resultatet, opptil tre runder. Kostnad er maksimal total_cost_usd per sesjon, summert over hovedsesjonen og subagentene dens. Produktlinjer er ikke-blanke tilførte linjer utenfor tester, oversettelser og migrasjoner.
Hvert resultat fikk to blindgjennomganger av Opus med ett vurderingsskjema: korrekthet, akseptansekriterier, grain, private felt og skjult tilstand, overengineering, sikkerhet og tillatelser, tester, migrasjoner. Kandidatene ble stokket under bokstaver, og vurdererne kunne lese repoet, men ikke kjøre noe. Funn per gjennomgang er gjennomsnittet over et oppsetts kjøringer. Med én til tre kjøringer per oppsett bør gjennomsnittet for et enkelt oppsett behandles som støyende. Konklusjonene over er de som holdt gjennom begge rundene.
