


Teknisk dokumentasjon tar utviklere bort fra å bygge. Hver time som brukes på å skrive en oppsettsguide eller forklare hver linje for en skribent, er en time som ikke brukes på å levere kode, og i det øyeblikket dokumentasjonen publiseres, fortsetter systemet bak å endre seg uten den.
Løsningen er en AI-skriver for teknisk dokumentasjon . Et verktøy som leser den faktiske kildekoden din og genererer et strukturert, nøyaktig dokument fra den på minutter i stedet for dager. Fordi inndataene er den ekte koden din og ikke en prompt som beskriver den fra hukommelsen, holder resultatet seg forankret i det systemet faktisk gjør.
Her er hvorfor dokumentasjon så lett glir ut av synk , hva disse verktøyene faktisk kan generere, hvordan du kjører ett steg for steg , og hvordan du bruker resultatet til API-referanser, brukerveiledninger og interne wikier uten å publisere noe som er feil.
Hvorfor teknisk dokumentasjon alltid er utdatert
Dokumentasjon taper prioriteringskampen nesten per design. Frister belønner fungerende kode, ikke avsnittet som forklarer den, og det finnes en vedvarende tro på at ren kode burde forklare seg selv. Stack Overflows egen forskning fant at dokumentasjon allerede tar omtrent 11 % av utvikleres arbeidstid, likevel er det fortsatt oppgaven team nedprioriterer først når en frist strammes inn.
Kostnaden ved å hoppe over det forsvinner ikke, den flytter seg bare nedover i kjeden. GetDX anslår at ingeniører bruker et sted mellom 3 og 10 timer i uken på å lete etter informasjon som allerede burde vært dokumentert, på å grave gjennom gamle pull requests, og på å finne den som tilfeldigvis husker informasjonen. I et team av enhver størrelse er det mange timer brukt på å reversere kunnskap som et dokument kunne ha bevart første gang.
En AI for teknisk skriving endrer økonomien i problemet i stedet for å prøve å fikse utviklervaner. Hvis det tar minutter og koster svært lite å regenerere et dokument, blir det realistisk – og ikke bare et ønske – å holde dokumentasjonen i synk med en kodebase i rask endring. Alt som gjenstår, er at utvikleren eller skribenten korrekturleser den raskt og sikrer at alt er nevnt og beskrevet riktig.
Hva AI-dokumentasjonsskrivere kan generere
En AI-dokumentasjonsgenerator er ikke begrenset til ett enkelt utdataformat. Avhengig av hva du gir den og hvem du oppgir som målgruppe, kan den samme underliggende prosessen produsere API-referanser, arkitekturoversikter, onboardingguider eller bruksanvisninger for et internt verktøy.
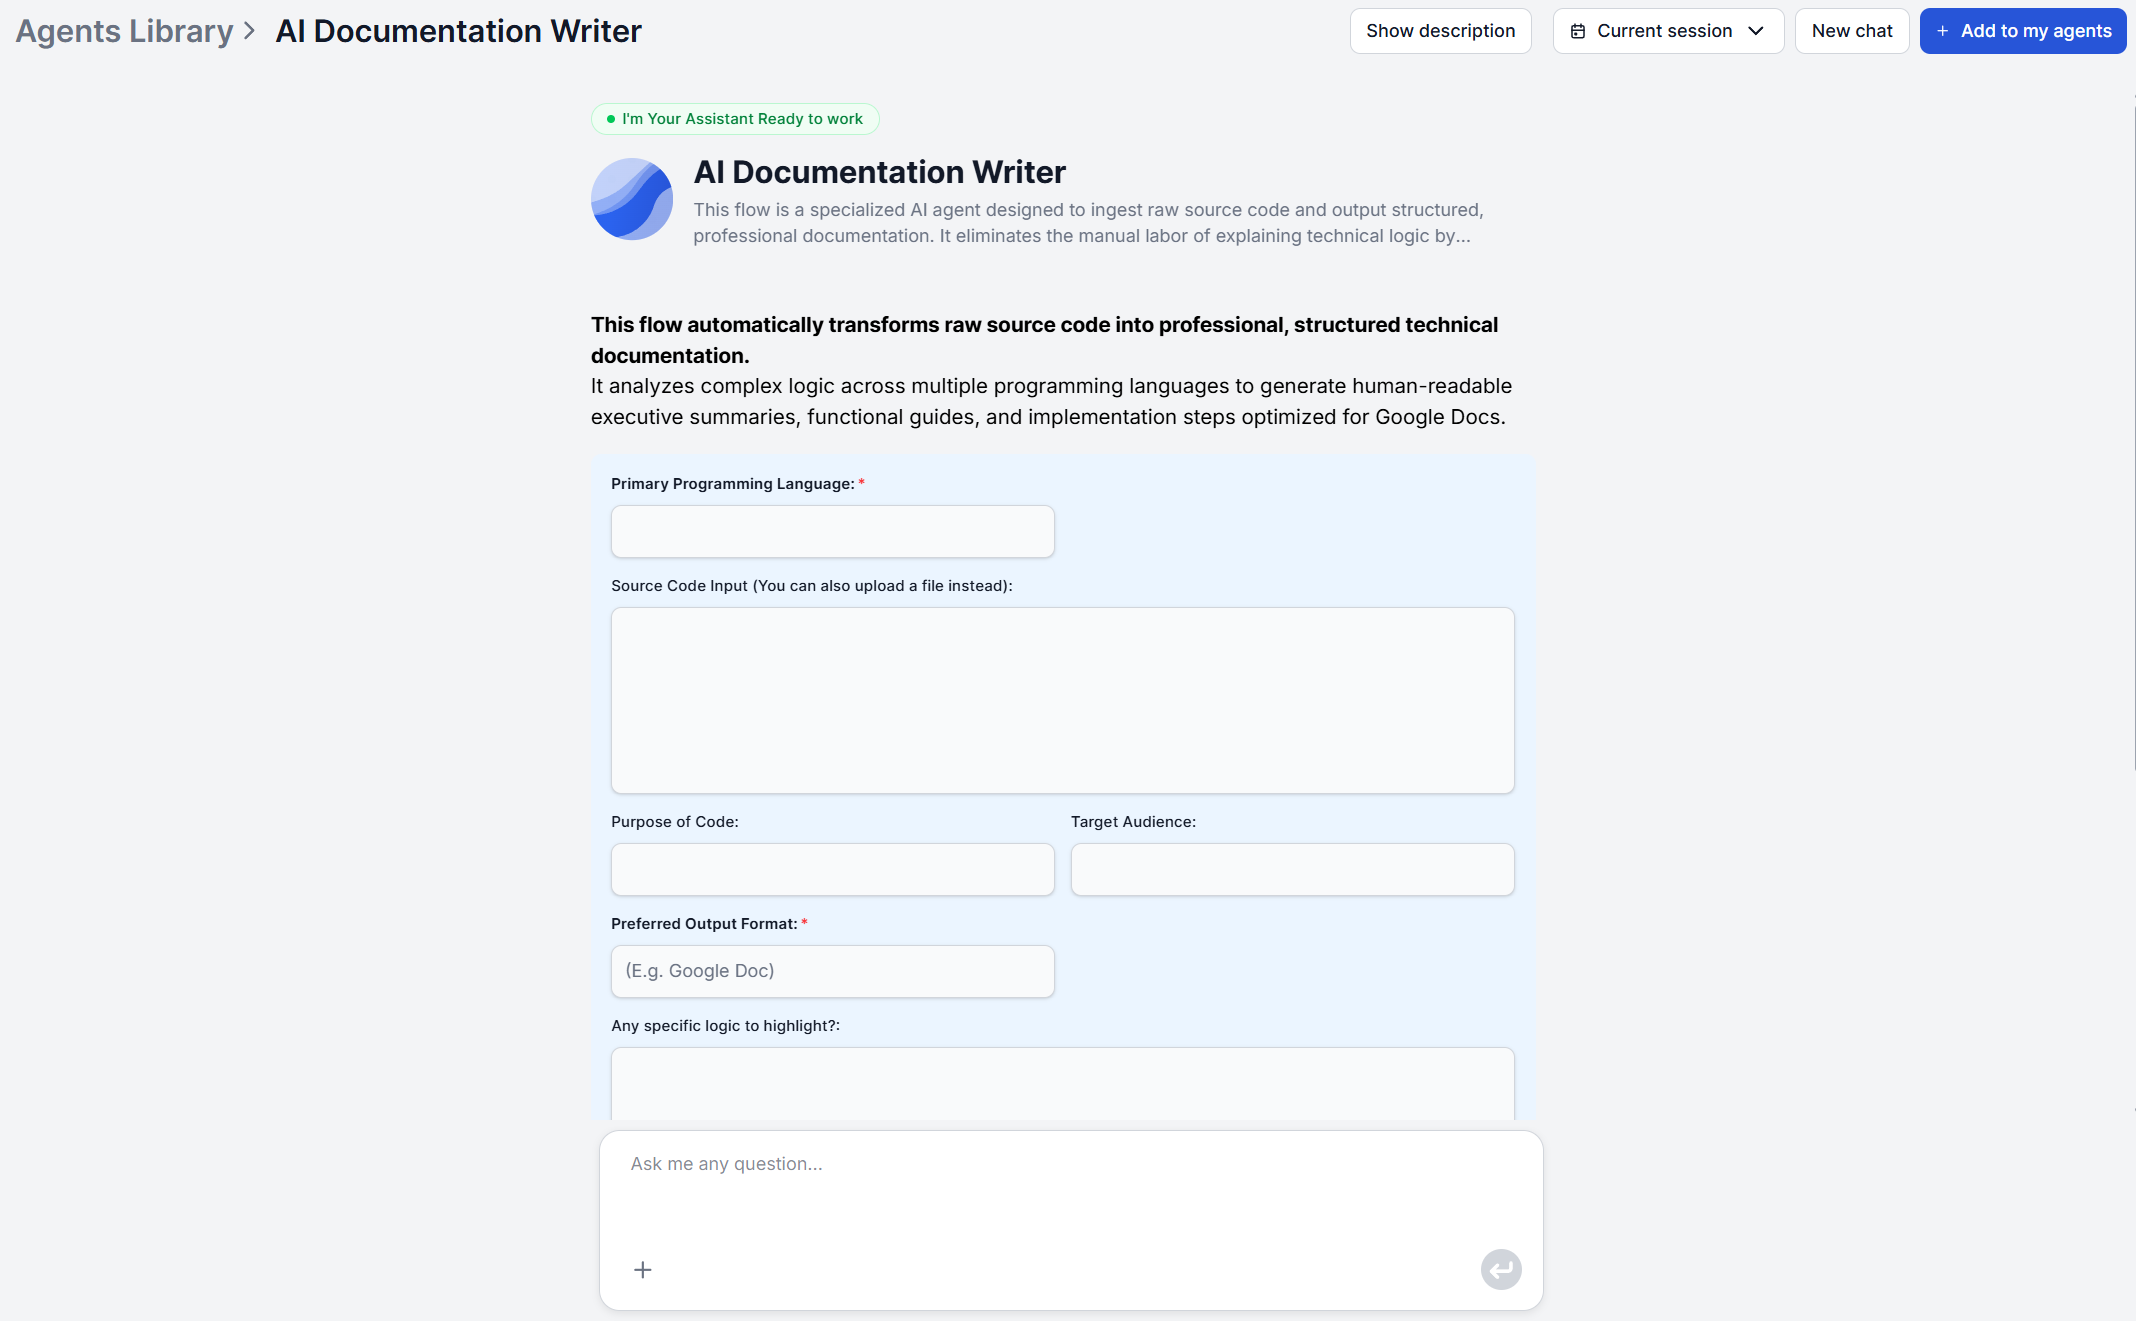
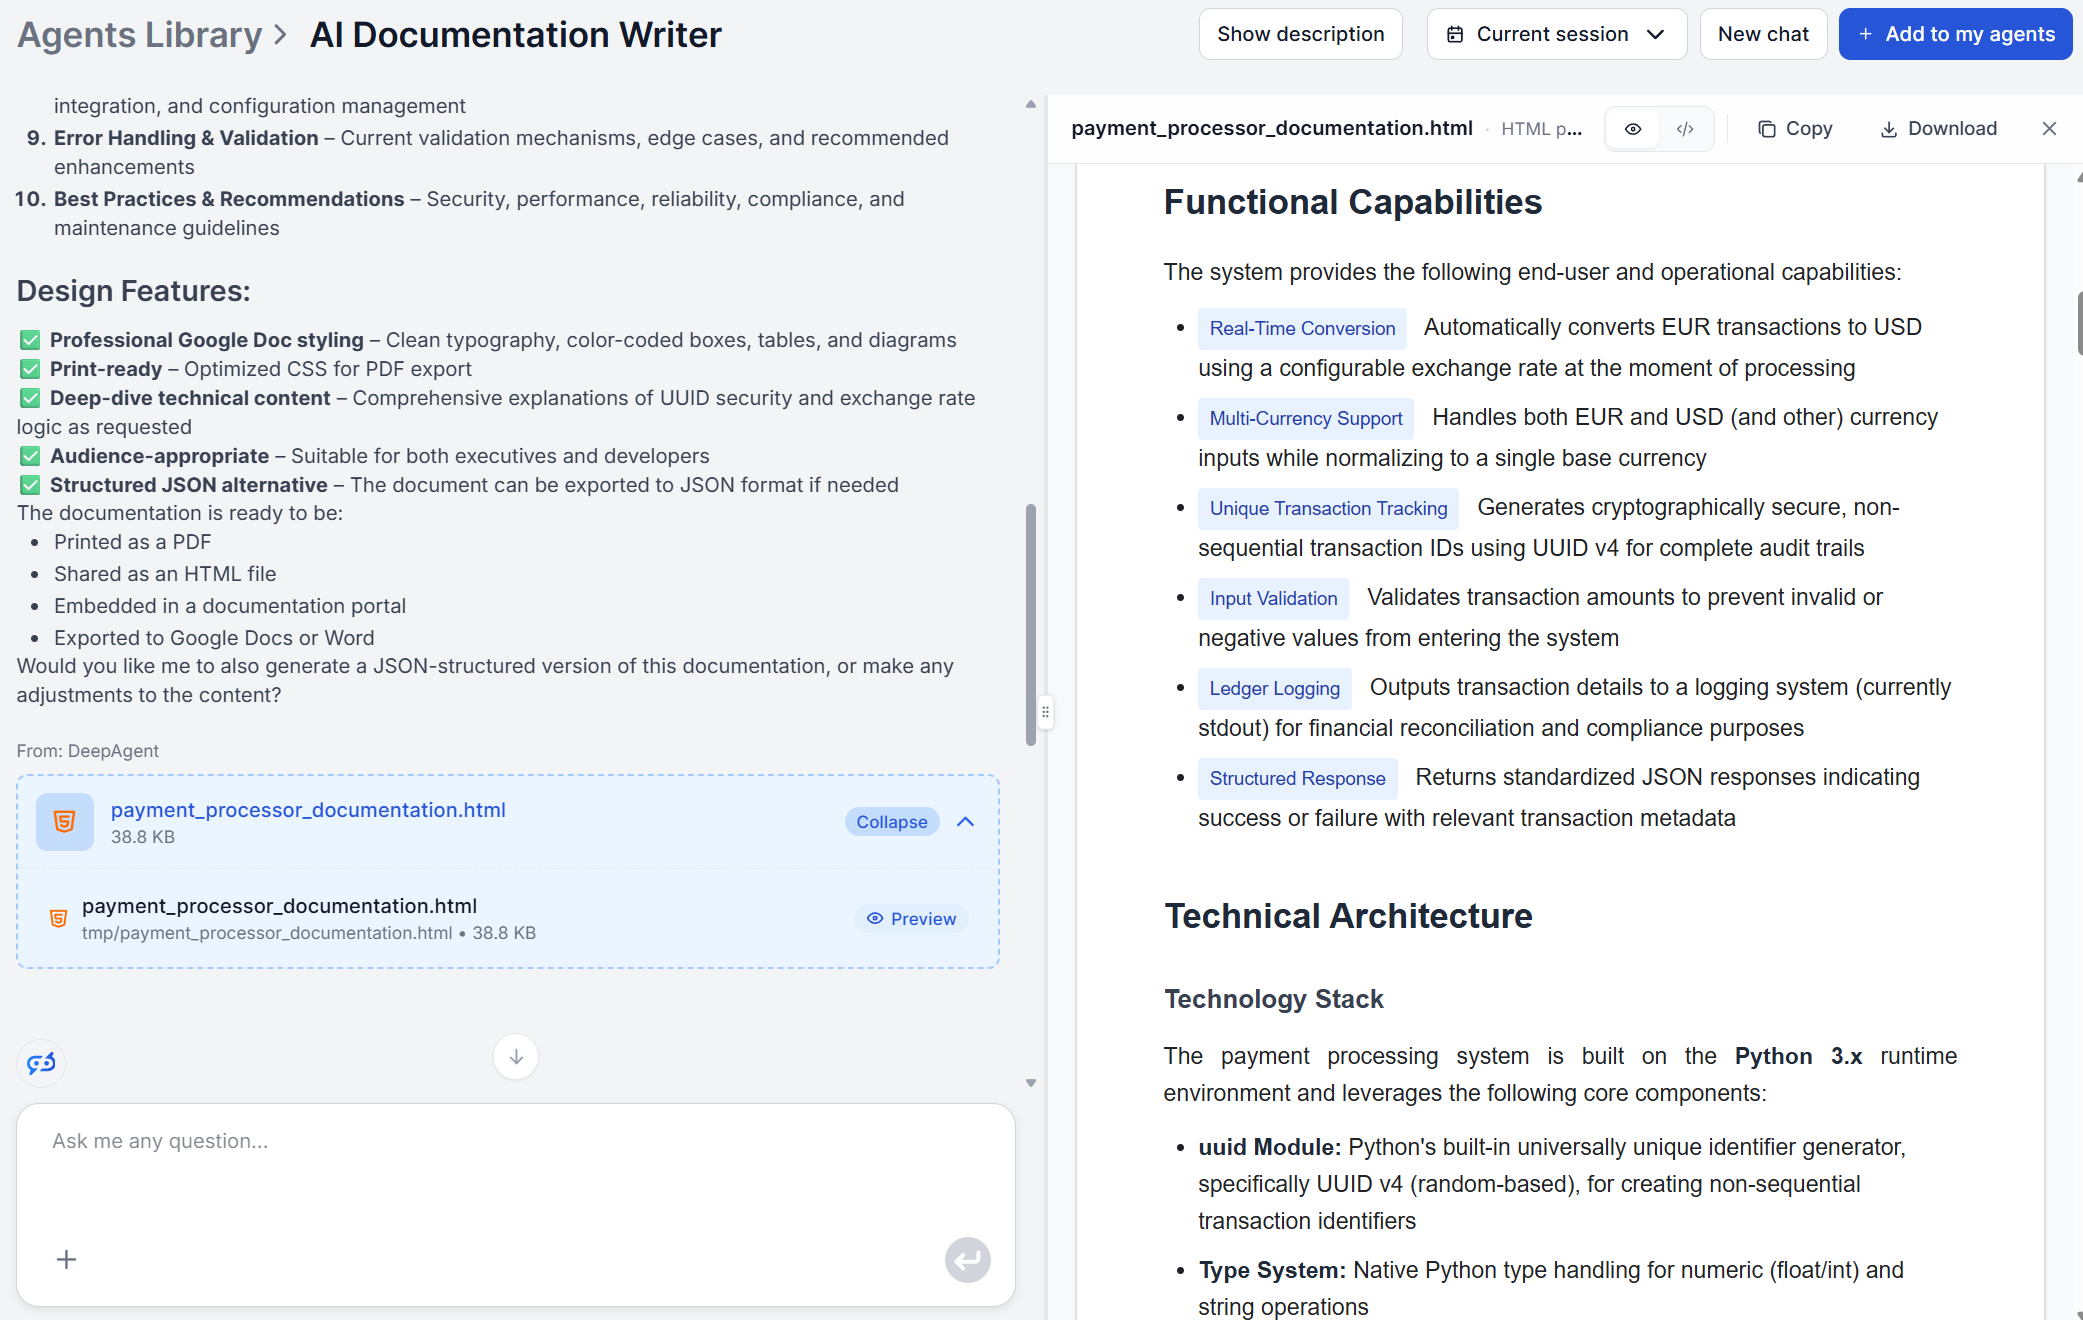
FlowHunts AI-dokumentasjonsskriver tar kildekode pluss kontekst og returnerer et strukturert JSON-dokument som dekker:
- Ledelsesoppsummering — en kort oversikt over hva programvaren gjør og hvilket problem den løser.
- Funksjonelle egenskaper — hovedfunksjonene og sluttbrukermulighetene koden muliggjør.
- Teknisk arkitektur — stacken, komponentene, rammeverkene, databasene og API-ene som er involvert.
- Logikkflyt og prosess — hvordan data beveger seg gjennom systemet og hvordan sentrale operasjoner skjer.
- Sentrale funksjoner og komponenter — hva hver viktig funksjon eller modul gjør og hva den returnerer.
- Implementering og bruksanvisning — veiledning for oppsett, konfigurasjon eller bruk, skrevet for den målgruppen du angir.
Rå kildekode er som standard utelatt fra resultatet, så det du får, leses som dokumentasjon et menneske har skrevet, ikke som en kodedump med påklistrede kommentarer. De samme seks seksjonene fungerer enten du genererer en intern wikiside for en tjeneste bare tre personer rører, eller en kundevendt manual for et levert prosjekt, siden det som endrer seg mellom disse to, er målgruppe-inndataene, ikke den underliggende prosessen.

Klar til å vokse bedriften din?
Start din gratis prøveperiode i dag og se resultater i løpet av få dager.
Steg for steg: Generer ditt første tekniske dokument
Prosessen bak AI-dokumentasjonsskriveren går gjennom fire stadier, og å forstå dem hjelper deg å få et bedre resultat på første forsøk.
Steg 1: Oppgi koden og konteksten din. Lim inn eller last opp kildekoden din, og angi deretter den øvrige inndatainformasjonen skjemaet ber om, for eksempel målgruppen din (utviklere, kunder eller ikke-tekniske interessenter) eller ønsket utdataformat.
Steg 2: Kodeanalyse. Verktøyet tolker kjernefunksjonaliteten, dataflyten og den strukturelle logikken i det du oppga, enten det er en fullstendig kodebase eller et delvis utdrag.
Steg 3: Logikkoversettelse. Tekniske operasjoner konverteres til forklaringer i klarspråk, kalibrert mot målgruppen du angav, så den samme koden kan leses svært forskjellig avhengig av hvem du sa dokumentet er for.
Steg 4: Dokumentstrukturering Forklaringene organiseres i et logisk hierarki som dekker hvorfor og hvordan koden fungerer, ikke bare hva den gjør, og leveres i et format du velger.
Hvis koden eller konteksten din er ufullstendig, utleder verktøyet den mest sannsynlige intensjonen fra det som finnes, i stedet for å stoppe, så et rotete eller delvis utdrag gir fortsatt noe brukbart. Prøv AI-dokumentasjonsskriveren for å se utdataformatet på din egen kode.
Brukstilfelle: API-dokumentasjon fra kode
API-referanser passer aller best for en AI-dokumentforfatter, siden hele prosessen til verktøyet starter fra kildekode og ikke fra en beskrivelse av hva koden skal gjøre. Pek den mot endepunkt-handlerne eller SDK-metodene dine, sett målgruppen til “utviklere” eller “API-konsumenter”, og utdataenes seksjon for sentrale funksjoner og komponenter blir en fungerende referanse: hva hver funksjon gjør, forventet atferd, og hvordan den passer inn i den bredere arkitekturen.
Det er også her verktøyet sparer mest tid sammenlignet med å skrive manuelt, siden API-dokumentasjon vanligvis må oppdateres hver gang en parameter endres eller et endepunkt legges til eller avvikles – nettopp den typen små, hyppige endringer som manuell dokumentasjon har en tendens til å sakke akterut på.
Bli med i vårt nyhetsbrev
Få de siste tipsene, trendene og tilbudene gratis.
Brukstilfelle: Brukervendte produktguider
Forskjellen mellom en API-referanse og en brukerveiledning handler nesten utelukkende om målgruppen, ikke om inndataene. Kjør den samme kildekoden gjennom dokumentasjonsskriveren, men sett målgruppen til “sluttbrukere” eller “ikke-tekniske interessenter”, og logikkoversettelsesstadiet produserer forklaringer i klarspråk i stedet for utviklerterminologi.
Dette fungerer best for dokumentasjonsoppgaver der guiden beskriver et CLI-verktøy, et SDK eller en intern applikasjon hvis bruksanvisninger faktisk kommer fra koden selv, for eksempel tilgjengelige kommandoer, konfigurasjonsalternativer eller oppsettstrinn.
Seksjonen for implementering og bruksanvisning skrives for den målgruppen du angir, så den samme kodebasen kan støtte både en teknisk manual og en forenklet guide uten å skrive noen av dem fra bunnen av to ganger.
Der denne tilnærmingen ikke passer, er dokumentasjon som er rent konseptuell eller policybasert, som en stilguide eller en eskaleringsmatrise for support, siden det ikke finnes kode verktøyet kan analysere. For slike bør du behandle AI-dokumentasjonsskriveren som én del av en bredere dokumentasjonsarbeidsflyt, ikke som det eneste verktøyet du trenger.
Brukstilfelle: Intern prosessdokumentasjon
Intern prosessdokumentasjon forfaller vanligvis raskest fordi den ofte bare finnes som institusjonell hukommelse – en senioringeniør som forklarer et deploy-skript eller en onboarding-automatisering høyt, uten at noen skriver det ned.
Hvis forklaringen skjedde i et møte som ble tatt opp, kan du først gjøre den om til strukturerte notater med en AI-generator for møtereferater for å fange konteksten før den går tapt. Ta deretter skriptet sammen med koden og kjør det gjennom dokumentasjonsskriveren for å produsere referansen som overlever at personen slutter i selskapet.
Dette brukstilfellet betyr mest for ingeniørteam som onboarder nye medlemmer, der “hvordan fungerer egentlig deploy-pipelinen vår” er et spørsmål som ikke bør avhenge av å finne den ene personen som husker det.
Hva du bør gjennomgå før du publiserer AI-generert dokumentasjon
Generert dokumentasjon er et sterkt førsteutkast, ikke et ferdig leveransepunkt. Noen sjekker er verdt å gjøre før noe går live:
- Verifiser oppsetts- og konfigurasjonstrinn mot et reelt miljø. Bruksanvisningen er utledet fra kodens logikk, så bekreft at den faktisk fungerer ende til ende, spesielt for alt som involverer miljøvariabler, påloggingsinformasjon eller eksterne tjenester.
- Sjekk seksjonen om teknisk arkitektur mot virkeligheten. Hvis kodebasen har eldre komponenter som AI-en ikke kunne utlede fra koden alene, må du legge den konteksten tilbake manuelt.
- Kryssreferer mot eventuell eksisterende dokumentasjon. Hvis tidligere dokumentasjon allerede finnes som PDF, for eksempel en gammel runbook, lar et verktøy for å chatte med PDF deg raskt sjekke om den AI-genererte versjonen manglet et trinn, uten å lese hele dokumentet på nytt.
- Bekreft at målgruppekalibreringen ble riktig. Kjør på nytt med en justert målgruppe hvis en “ikke-teknisk” guide fortsatt leses som en API-referanse.
- Faktasjekk terminologi eller bransjekonvensjoner dokumentet refererer til. Hvis du vil ha en ekstra kilde til en standard eller konvensjon som nevnes i resultatet, kan en AI-forskningsassistent hente støttekilder i samme økt.
Konklusjon
Ingenting av dette tar så lang tid som å skrive dokumentet fra bunnen av, og det er hele poenget. Å gjennomgå et strukturert utkast er en fundamentalt raskere oppgave enn å stirre på et blankt ark, og det er forskjellen mellom et dokumentasjonsverktøy som sparer tid og ett som bare flytter risikoen for en feil fra “uskrevet” til “selvsikkert feil”.