


Wersja skrócona
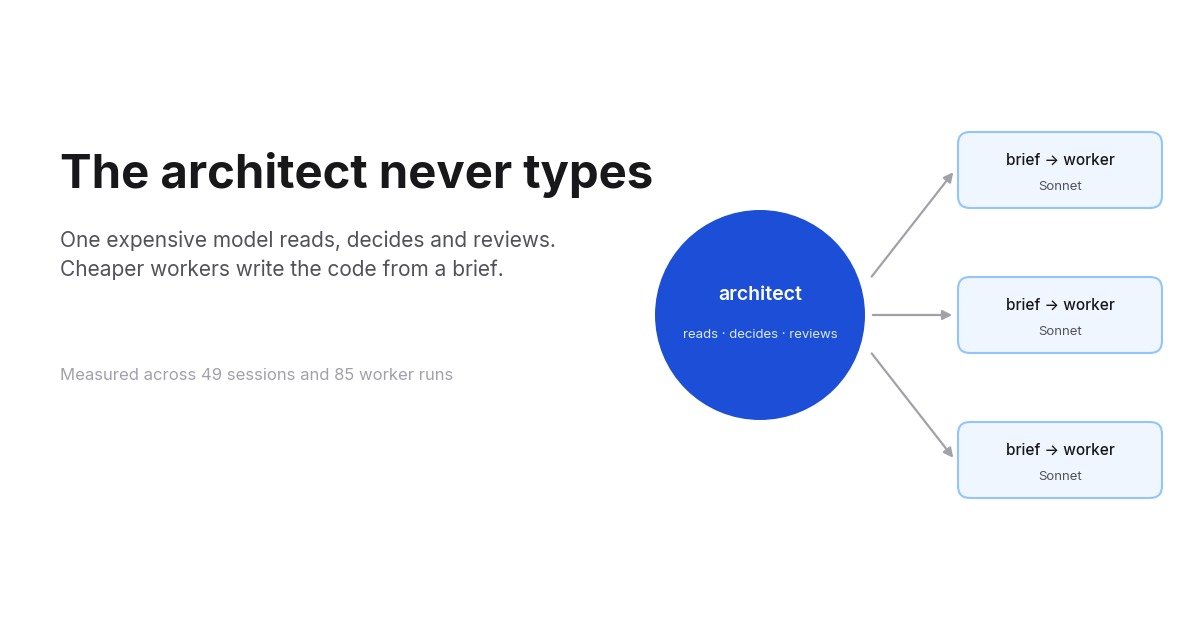
- Przez pięć tygodni prowadziłem swojego agenta kodującego w trybie podziału: główny model, Opus, a później Fable, czyta, decyduje i przegląda, a agent wykonawczy pisze kod na podstawie pisemnego briefu. Nazywam to wzorcem architekta i jest to teraz publiczny skill: architect-skill na GitHubie , na licencji MIT.
- Główny model przestał pisać. W 49 sesjach architekta edytował plik źródłowy 6 razy na 1 467 promptów. W 275 zwykłych sesjach w tych samych tygodniach edytował 244 pliki na 3 081 promptów. To 0,4 wobec 7,9 na 100 promptów.
- Łączna liczba tokenów na prompt nie spadła. Przez dwa tygodnie rosła, i to mocno, a potem wróciła do poziomu zwykłych sesji. Zmieniło się to, kto je wydawał: udział Opusa w tokenach wykonawców spadł ze 100% do około 4%, a od 14 września prompt w sesji architekta kosztuje 364 tys. ważonych tokenów w modelu głównym, 205 tys. u wykonawców Sonnet i 80 tys. u wykonawców Opus.
- Właśnie ten podział ma znaczenie przy subskrypcji. Claude Max rozlicza tygodniowy limit dla wszystkich modeli według stawki danego modelu, więc token Sonnet pobiera go w wysokości 40% tokenu Opus, a Fable ma osobny, ostrzejszy limit tygodniowy, którego żaden wykonawca nie dotyka.
- Próbowałem też kierować wykonawców do DeepSeek przez bezgłowego Claude Code. Według cennika ten sam ruch kosztował 10 USD zamiast 202 USD na Sonnet albo 505 USD na Opus. Przy subskrypcji taka oszczędność nie istnieje, bo subskrypcja jest już opłacona. Zrezygnowałem z tego. Jeśli płacisz za token, i tak przeczytaj tę sekcję, bo liczą się tu liczby.
To trzeci wpis z serii. Pierwszy mierzył, co jedno ustawienie zrobiło z oknem kontekstu, 17% mniej tokenów , a drugi wyjaśnia, ile kosztuje okno kontekstu i dlaczego. Ten jest o drugiej dźwigni: nie o tym, jak duży jest kontekst, ale o tym, który model go trzyma.
Czym jest ten wzorzec
Sesja agenta kodującego wykonuje dwa rodzaje pracy. Myśli: czyta bazę kodu, ustala, co zmienić, decyduje o nazwach, sygnaturach i przypadkach brzegowych, sprawdza diff. I pisze: tworzy kod, uruchamia plik testowy, poprawia lint. Myślenie to miejsce, w którym model frontier zarabia na swoją cenę. Pisanie już nie. W większości wynika ono z decyzji podjętej wcześniej, a mniejszy model wykonuje ustalony plan mniej więcej tak samo dobrze jak duży.
Skill dzieli więc sesję. Główny model jest architektem. Robi wszystko w głównej pętli poza edytowaniem pliku źródłowego:
- Przepytuje wymaganie i eksploruje bazę kodu.
- Podejmuje decyzje projektowe: podejście, przepływ danych, nazwy, sygnatury, przypadki brzegowe. Najbliższy istniejący wzorzec do naśladowania. Najmniejsza zmiana, która usuwa przyczynę problemu.
- Dzieli pracę na wycinki, które mają rozłączne zbiory plików.
- Pisze jeden brief implementacyjny na wycinek.
- Przegląda diff, który wraca, uruchamia bramki, robi commit.
Wykonawca to podagent ze świeżym oknem kontekstu. Dostaje brief i nic więcej, pisze kod, uruchamia pliki testowe wskazane w briefie i zwraca krótki, ustrukturyzowany raport. Potem jego kontekst jest wyrzucany. Nigdy nie staje się częścią historii głównej sesji, co ma większe znaczenie, niż brzmi: wszystko, co czyta główna sesja, jest wysyłane ponownie przy każdym kolejnym wywołaniu, więc wykonawca, który czyta dwanaście plików i log testów we własnym kontekście, trzyma to wszystko poza rachunkiem architekta.
Brief jest całym kontraktem. Mój ma siedem pól, a skill polega głównie na tym, by wypełniać je dobrze:
## Brief implementacyjny: <slice>
Cel: jedno zdanie, obserwowalny rezultat
Kontekst: co znalazła eksploracja: fragmenty, wzorzec do naśladowania, kotwice linii, pułapki
Pliki: ścieżki do utworzenia/modyfikacji, wyłączna własność dla tego wycinka
Projekt: ustalone podejście: przepływ danych, nazwy, sygnatury, przypadki brzegowe
Ograniczenia: obowiązujące zasady projektu: styl, warstwy, bezpieczeństwo
Poza zakresem: czego nie ruszać, w tym plików należących do innych wycinków
Weryfikacja: dokładne komendy i oczekiwany rezultat
Brief zawiera decyzje, nie opcje. Jeśli wciąż ważą się dwa podejścia, nie jestem gotowy delegować.
Jest jeden wyjątek. Delegowanie ma stały narzut: napisanie briefu, uruchomienie wykonawcy, przeczytanie raportu, przegląd diffu. Poprawka literówki, wartość w konfiguracji, podbicie wersji, usunięcie martwego klucza, jednolinijkowa poprawka i jej test regresyjny: przy tych architekt edytuje bezpośrednio, bo brief kosztowałby więcej niż sama edycja. Kryterium jest koszt, nie liczba linii. Gdy tylko edycja wymaga decyzji projektowej albo dotyka ścieżki oznaczonej w repo jako krytyczna, trafia do wykonawcy.

Gotowy na rozwój swojej firmy?
Rozpocznij bezpłatny okres próbny już dziś i zobacz rezultaty w ciągu kilku dni.
Dlaczego subskrypcja zmienia arytmetykę
Jeśli płacisz za token, sprawa jest prosta. Opus 5 ma cennik 5 USD za milion tokenów wejściowych i 25 USD za milion wyjściowych; Sonnet 5 — 2 USD i 10 USD. Każdy token implementacji przeniesiony z Opusa do Sonnet kosztuje 40% tego, co wcześniej.
Ja płacę subskrypcją i tu sprawa wygląda inaczej, a moim zdaniem mocniej. Claude Max ma dwa limity tygodniowe, nie jeden: limit obejmujący wszystkie modele, pobierany przez każdy token według stawki danego modelu, oraz osobny, ostrzejszy limit, który pobiera tylko Fable. Opus nie ma własnego limitu. To daje podziałowi dwa efekty. Praca wykonana przez wykonawcę Sonnet pobiera wspólny limit w wysokości 40% stawki, jaką pobrałby wykonawca Opus, więc przeniesienie dwóch trzecich tokenów sesji do Sonnet wydłuża tydzień, nawet jeśli łączna liczba tokenów się nie zmienia. A gdy architektem jest Fable, każdy token, którego nie wydaje na pisanie, to token pozostawiony na limicie, który kończy się pierwszy. Więc nawet gdyby wzorzec architekta zużywał dokładnie tyle samo tokenów co zwykła sesja, to i tak od tego, kto je wydaje, zależałoby, kiedy skończy się tydzień.
Okazało się, że to „nawet gdyby” dźwiga spory ciężar.
Co mówią transkrypty
Claude Code zapisuje każdą sesję do transkryptu JSONL, a każde uruchomienie wykonawcy do towarzyszącego pliku w katalogu sesji. Mam wszystkie od 19 sierpnia: 324 sesje interaktywne z trzema lub więcej promptami, z czego 49 korzystało ze wzorca, czyli uruchomiło agenta implementującego albo wysłało mu brief. Tokeny są ważone tak, jak wygląda rachunek: świeże wejście 1, zapisy do cache 1,25 lub 2, odczyty z cache 0,1. Przebiegi CI są wyłączone.
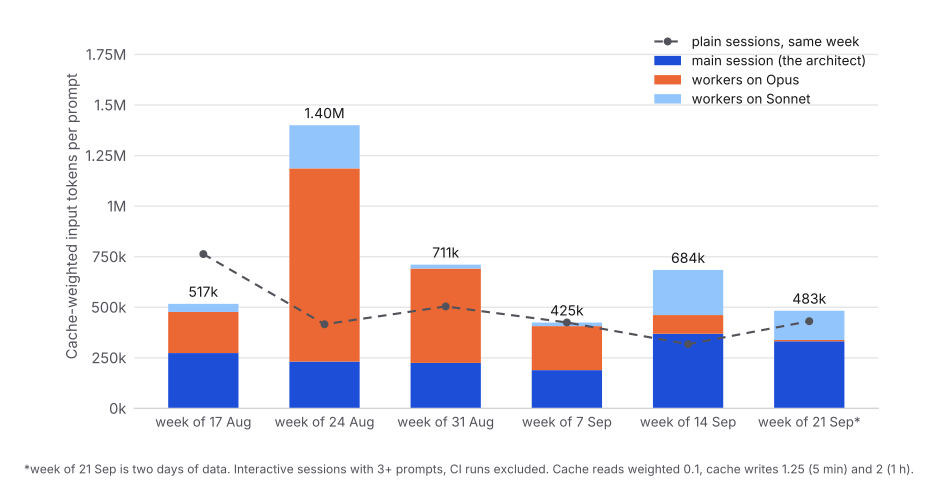
Czytane od lewej do prawej, to nie jest historia sukcesu z pierwszych dwóch tygodni.
W tygodniu 24 sierpnia sesja architekta kosztowała 1,40 mln ważonych tokenów na prompt. Zwykłe sesje w tym samym tygodniu kosztowały 0,42 mln. Trzy i pół razy więcej, a niemal cała nadwyżka była pomarańczowa: wykonawcy Opus. Dałem wykonawcom dobry model i żadnych reguł, a zachowywały się jak dobry model bez reguł. Mediana uruchomienia wykonawcy Opus w tym tygodniu wyniosła 176 tur. Kilka uruchomiło pełny zestaw testów backendu, co wrzuca około 100 KB wyjścia do kontekstu, który jest wysyłany ponownie przy każdej kolejnej turze. Jedna sesja z sześcioma wykonawcami z 14 września, gdy już zacząłem zaostrzać zasady, spaliła 245 mln tokenów wejściowych w 1 585 turach, produkując około sześciu tysięcy linii diffu. Cache’owanie promptów działało przez cały czas ze skutecznością 91,6%. Rachunek wynikał z objętości, nie z cennika.
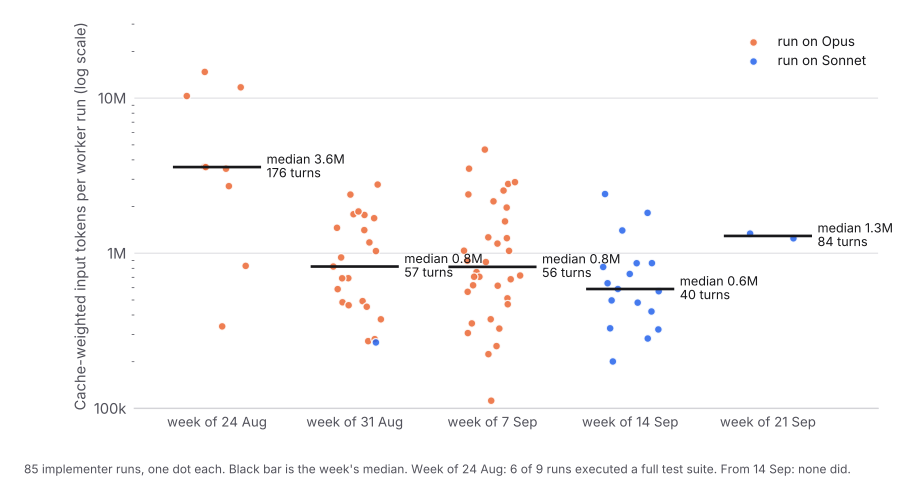
Pasek wykonawców pokazuje, gdzie trafiły reguły. Trzy z nich zrobiły najwięcej pracy, a zapisałem je w definicjach agentów, a nie w briefie, więc działają niezależnie od tego, czy pamiętam:
- Wykonawca nigdy nie uruchamia pełnego zestawu testów. Uruchamia pliki testowe wskazane w briefie. Bramki uruchamia architekt.
maxTurnsjest ograniczone w definicji agenta: 140 dla Sonnet i 160 dla Opus. Wycinek, który potrzebuje 250 tur, został źle zbriefowany.- Wycinek pozostaje poniżej około dwunastu plików, a brief poniżej około 8 KB. Brief też jest wysyłany ponownie przy każdej turze.
Do tygodnia 31 sierpnia mediana uruchomienia wykonawcy wynosiła 57 tur i 0,8 mln ważonych tokenów. Od 14 września, gdy przeniosłem domyślną trasę na Sonnet, było to 40 tur i 0,6 mln, i od tego czasu żaden wykonawca nie uruchomił pełnego zestawu.
Suma na prompt podążyła za tym: 711 tys., 425 tys., 684 tys., 483 tys. w ciągu ostatnich czterech tygodni, wobec zwykłych sesji na poziomie 505 tys., 425 tys., 318 tys., 431 tys. Sesje architekta kosztują teraz mniej więcej tyle, co zwykłe sesje. Nieco więcej w dwóch z czterech tygodni, nieco mniej w jednym. To, co za to kupują, pokazują dwa następne wykresy.
Dołącz do naszego newslettera
Otrzymuj najnowsze wskazówki, trendy i oferty za darmo.
Główny model przestał pisać
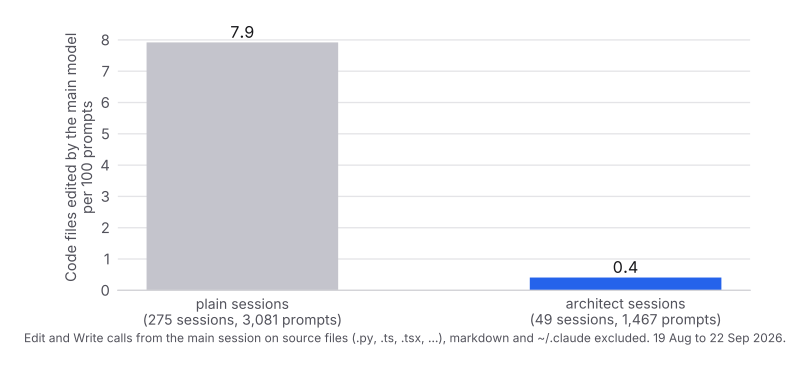
To liczba, którą chciałem zmienić, i zmieniła się. W zwykłych sesjach główny model wykonał 244 wywołania Edit lub Write na plikach źródłowych w 3 081 promptach. W sesjach architekta — 6 na 1 467. Te 6 to wyjątki dla małych edycji, które mogę wyjaśnić.
Tymczasem wykonawcy byli produktywni. 85 uruchomień wykonawców wykonało 2 510 edycji plików źródłowych. Licząc główną pętlę i wykonawców razem, sesja architekta wyprodukowała 2 516 edycji kodu z 1 467 promptów; zwykłe sesje wyprodukowały 943 z 3 081. Na jedną edycję kodu sesja architekta wydała łącznie 403 tys. ważonych tokenów, a 330 tys. na modelu z rodziny Opus. Zwykła sesja wydała 1 410 tys. i 1 324 tys. Chcę być ostrożny z tym porównaniem, bo obie populacje to nie ta sama praca: sesja jest klasyfikowana jako architekta przez delegowanie kodu, więc sesje architekta są z definicji mocno kodujące, a zwykłe sesje obejmują research, przeglądy i debugowanie, które niczego nie edytują. Czytaj to jako „wzorzec pozwala napisać dużo kodu na token”, a nie jako twierdzenie o czterokrotnej efektywności.
Wyraźniejsze jest twierdzenie o podziale modeli. Od 14 września prompt w sesji architekta kosztuje 364 tys. ważonych tokenów w głównej pętli, 205 tys. u wykonawców Sonnet i 80 tys. u wykonawców Opus. Udział wykonawców Opus w tokenach wszystkich wykonawców wynosił 100% w sierpniu i około 4% w tygodniu 21 września. W planie Max oznacza to, że wspólny limit tygodniowy jest pobierany według stawki Sonnet, a nie Opus, dla niemal całej pracy implementacyjnej, i nic z tego nie dotyka limitu Fable.
Dwie rzeczy się nie poprawiły i wolę to powiedzieć, niż pozwolić wykresom sugerować coś innego. Własny kontekst głównej sesji się nie zmniejszył: sesje architekta kompaktowały się 8,7 razy na 100 promptów wobec 4,7 w zwykłych sesjach, bo architekt dużo czyta, zanim napisze brief. A wzorzec jest wolniejszy w czasie rzeczywistym przy małych zadaniach, bo start wykonawcy i raport to minuty, których nie płacisz, gdy po prostu robisz edycję. Wyjątek dla małych edycji istnieje dlatego, że pierwsza wersja skilla go nie miała, a ja patrzyłem, jak piszę brief o rozmiarze 3 KB do dwuliniowej zmiany.
Objazd przez DeepSeek
Gdy wykonawcami był już Sonnet, nasuwało się oczywiste pytanie: czy w ogóle muszą to być modele Claude. Od 13 do 18 września kierowałem wykonawcę do DeepSeek V4.1 Flash przez bezgłowego Claude Code z ANTHROPIC_BASE_URL ustawionym na zgodny endpoint, najpierw przez OpenRouter, a potem natywnie. Ten sam format briefu, ten sam format raportu, ten sam architekt. 2 732 wywołania, 431 mln tokenów wejściowych, z czego 88% to odczyty z cache, 1,7 mln tokenów wyjściowych.
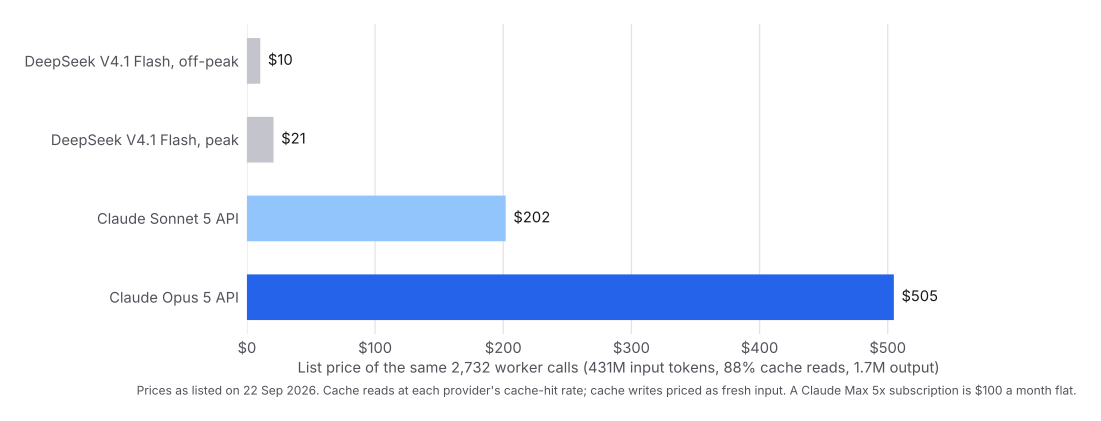
Według cen katalogowych z 22 września ten ruch kosztuje około 10 USD na DeepSeek poza szczytem, 21 USD w szczycie, 202 USD w API Sonnet i 505 USD w API Opus. Gdybym płacił za token, to byłby tytuł tego wpisu i zostawiłbym to rozwiązanie.
Nie płacę za token i na tym polega cały argument. Subskrypcja Max kosztuje 100 USD miesięcznie niezależnie od tego, czy zużyję 30% limitu tygodniowego, czy 100%. Przeniesienie ruchu wykonawców do DeepSeek nie obniżyło tego rachunku ani o centa. Dodało drugi rachunek, od 10 do 21 USD tygodniowo, na wierzch, żeby oszczędzić przepustowość w planie, za którego przepustowość już zapłaciłem. Pomyliłem „taniej niż API” z „taniej niż to, co płacę”, a to nie to samo, gdy płaci się stałą kwotę. Właściwym porównaniem dla subskrybenta jest DeepSeek kontra druga subskrypcja, a tam drugi plan Claude albo plan ChatGPT z Codexem kosztuje mniej więcej tyle, co miesiąc umiarkowanego korzystania z DeepSeek, i daje własny limit tygodniowy, własny model i żadnego mierzenia do pilnowania.
Jakość to druga połowa. Pięć wycinków backendu wróciło czystych i zostało zacommitowanych bez zmian. Jeden wycinek frontendu usunął eksportowany symbol i zostawił wszystkich jego konsumentów nietkniętych, więc drzewo się nie kompilowało i późniejszy wycinek musiał to posprzątać. To dokładnie ta awaria, którą ma model wykonujący specyfikację, a której nie ma model wnioskujący o kształcie komponentu z jego sąsiadów, i skill już to mówi: zmiany wspólnej powierzchni API trafiają do Sonnet, a reguła dla wykonawcy brzmi: „nigdy nie usuwaj ani nie zmieniaj nazwy eksportowanego symbolu bez zmigrowania wszystkich konsumentów w tym samym przebiegu”. DeepSeek Flash to dobry wykonawca. Wzorzec architekta potrzebuje wykonawcy, który zauważy, że brief zaniżył liczbę konsumentów, a tego jednego brief dostarczyć nie może.
Tak więc dzisiejsza tabela tras ma dwa wiersze. Praca rutynowa, praca backendowa według szczegółowego briefu z testami do spełnienia, praca frontendowa podążająca za istniejącą gramatyką designu i każda zmiana wspólnej powierzchni API trafiają do sonnet-implementer. Praca, której trudność tkwi w rozumowaniu, trafia do opus-implementer: wyścig asynchroniczny, refaktor wielomiejscowy, którego poprawność zależy od miejsc, których brief nie potrafi wyliczyć, migracja backfill, której nie dowodzi żaden pojedynczy test. Trasuj według kształtu, nigdy według ryzyka. Ryzyko zmienia to, jak skrupulatnie przeglądany jest diff i czy podpisuje go człowiek. Nigdy nie zmienia tego, kto go pisze.
Pętla przeglądu, czyli miejsce, w którym wzorzec zarabia albo traci
Raport wykonawcy to twierdzenie. Pętla przeglądu w skillu jest krótka, a każda jej linia powstała w wyniku sparzenia się:
- Przeczytaj raport i rzeczywisty
git diff. Porównaj diffstat podany przez wykonawcę z tym, który widzisz. - Powtórz kluczową weryfikację samodzielnie, gdy twierdzenie ma znaczenie.
- Znalazłeś problem? Wyślij poprawkę do tego samego wykonawcy. Wciąż ma swój kontekst i podejmuje pracę tam, gdzie skończył. Nie poprawiaj ręcznie, nie uruchamiaj nowego.
- Dwie nieudane poprawki oznaczają, że brief był niedookreślony, a nie że model jest za mały. Podziel pracę, wstaw brakujący fragment do Kontekstu, uruchom ponownie. Nie sięgaj po większy model, bo zaimplementuje to samo nieporozumienie płynniej.
- Uruchom bramki w zakresie zmiany, zanim cokolwiek zaakceptujesz: dotknięte testy, linter na dotkniętych plikach, dowolny skrypt konwencji, który niesie repo.
W transkryptach wysyłałem około jednej poprawki na uruchomienie wykonawcy, 52 na 85 uruchomień, a 7 uruchomień Opus trafiło w swój limit 160 tur, każde na wycinku, który dziś bym podzielił. To dwie liczby, które obserwuję. Jeśli liczba poprawek na uruchomienie rośnie, moje briefy stają się leniwe. Jeśli wykonawcy trafiają w limit, moje wycinki są za duże.
Co z tego wynieść
Jeśli płacisz za token: postaw drogi model na decyzjach i przeglądzie, tani na implementacji, a ruch wykonawców wyceń według cennika, zanim wybierzesz, który tani. Argumentem jest wykres z czterema słupkami.
Jeśli płacisz subskrypcją: wzorzec nie zmniejsza liczby tokenów. Przenosi tokeny implementacji do modelu, który najwolniej pobiera wspólny limit tygodniowy, zachowuje limit Fable dla pracy, którą powinien robić tylko Fable, i przestaje pozwalać twojemu najdroższemu modelowi wydawać tury na pisanie. Nie dodawaj rozliczanego API z boku, żeby „oszczędzić” przepustowość, którą już kupiłeś. Jeśli skończy ci się przepustowość wykonawców, kup drugą subskrypcję.
Tak czy inaczej, reguły, które sprawiły, że to działało, były nudne. Żadnych pełnych zestawów testów u wykonawcy. Limit tur. Małe wycinki, krótkie briefy. Popraw tego samego wykonawcę raz, potem napraw brief.
Skill, trzy definicje agentów i hook strażniczy są w github.com/LivinTribunal/architect-skill na licencji MIT. Towarzyszący skill, który mówi wykonawcy, jak pisać kod pasujący do repo, do którego trafia, to grain-skill , a wpis o nim to kod zgodny z repo .
Metoda
Wszystko, co opisuje ten wpis, jest w github.com/LivinTribunal/architect-skill : sam skill, szablon briefu, tabela tras, trzy definicje agentów implementujących z ich limitami tur i regułami kontekstu oraz hook strażniczy. Zainstaluj go i masz konfigurację, z której pochodzą liczby poniżej.
Sesje to transkrypty JSONL Claude Code od 19 sierpnia do 22 września 2026, entrypoint cli, trzy lub więcej promptów użytkownika. Sesja jest klasyfikowana jako architekta, jeśli uruchomiła opus-implementer, opus-implementer-xhigh lub sonnet-implementer, uruchomiła wykonawcę ds-slice, wywołała skill architekta albo wysłała wiadomość zawierającą brief implementacyjny do agenta ogólnego przeznaczenia — tak działały pierwsze tygodnie, zanim istniały nazwane agenty. Uruchomienia wykonawców to transkrypty podagentów w katalogu każdej sesji. Użycie jest deduplikowane po request id i ważone: świeże wejście 1, pięciominutowy zapis do cache 1,25, godzinny zapis do cache 2, odczyt z cache 0,1. „Edycja kodu” to wywołanie Edit lub Write na pliku źródłowym .py, .ts, .tsx, .js, .sql lub podobnym, z wyłączeniem markdownu i wszystkiego pod ~/.claude. Ceny DeepSeek to natywne ceny katalogowe z 22 września 2026, poza szczytem i w szczycie, z odczytami z cache według stawki trafień i zapisami do cache wycenionymi jak świeże wejście; ceny API Claude to opublikowane ceny katalogowe Opus 5 i Sonnet 5 z odczytami z cache na poziomie jednej dziesiątej wejścia. Tydzień 21 września to dwa dni danych.
