


W skrócie
- Wziąłem jedno prawdziwe zadanie z backlogu FlowHunt i kazałem Claude Code zaimplementować je 13 razy na Opusie 5.5, w siedmiu różnych konfiguracjach instrukcji. Każde uruchomienie startowało z tego samego commita, we własnym klonie z własną bazą danych, i przechodziło przez nasze prawdziwe CI na GitHubie. Dwie recenzje Opusa w ciemno oceniały każdy wynik.
- Plik CLAUDE.md repozytorium o rozmiarze 33 KB nie kupił mierzalnej jakości. Uruchomienia z nim dostały 2.0 uwag blokujących i poważnych na recenzję. Uruchomienie bez żadnego pliku instrukcji dostało tyle samo. Plik o rozmiarze 5,5 KB dostał 1.0.
- Osobny etap planowania pogorszył sprawę. Obie konfiguracje, które uruchamiały prompt planowania, a potem prompt implementacji, kosztowały więcej niż ich bliźniaki z prostym promptem, i wygenerowały cztery z pięciu uwag blokujących we wszystkich 26 recenzjach.
- Zwycięzcą był plik CLAUDE.md o rozmiarze 8 KB, trzy skille, workery Sonnet i prosty prompt. Jego dwa uruchomienia dały średnio 6,68 dolara według cennika API. Pełna konfiguracja z promptami potoku dała średnio 11,49 dolara, około 1,7 razy więcej, i miała więcej uwag.
- Z całej tej struktury, którą zbudowałem, przetrwała instrukcja robocza: krótki, rozstrzygnięty opis jednego wycinka pracy, który główny model pisze dla tańszego wykonawcy. Plany dla samego głównego modelu się nie opłaciły. Model sam planuje dobrze.
To nawiązuje do wpisu o architect pattern , który mierzył, kto powinien pisać kod. Ten pyta, ile trzeba powiedzieć głównemu modelowi, zanim zacznie.
Dlaczego to zrobiłem
Nasze monorepo nazbierało sporo instrukcji dla agentów. Główny CLAUDE.md miał 33 KB: komendy budowania, rytm testów, styl kodu, architektura, ścieżki krytyczne, reguły bezpieczeństwa, reguły uprawnień i kredytów, dwie powierzchnie agenta, zgłaszanie zadań, konwencje PR. Dziesięć skilli leżało w .claude/skills/. Do tego nasz potok CI (nazywamy go harnext) przeprowadzał zadanie przez tagger, etap triage’u, etap planowania, który zapisywał plan jako komentarz do zadania, i etap implementacji, który odczytywał plan z powrotem i pisał kod — każdy z własnym długim promptem systemowym.
Każda linia z tego została dodana z jakiegoś powodu, zwykle po tym, jak agent coś zrobił źle. Pytania, którego nikt nie zadał, brzmiało: czy to nadal pomaga. Plik CLAUDE.md jest wczytywany do każdej sesji i wysyłany ponownie w każdej turze. Jeśli model i tak zrobiłby to, co trzeba, te tokeny są podatkiem, a jak wyjaśnia wpis what a context window costs , podatek w każdej turze sumuje się szybciej, niż to wygląda.

Gotowy na rozwój swojej firmy?
Rozpocznij bezpłatny okres próbny już dziś i zobacz rezultaty w ciągu kilku dni.
Test
Zadaniem była sekwencja maili o określonych porach dla nowych rejestracji: administrator definiuje kroki typu „dzień 0: powitanie" i „dzień 5: twój okres próbny wkrótce się kończy", a zadanie w tle wysyła maila do każdego konta we właściwym dniu, zatrzymuje się, gdy dana osoba kupi płatny plan, i pomija konta utworzone przed startem. Potrzebna jest migracja, repozytorium, serwis, zadanie Celery beat, endpointy REST, narzędzia MCP dla agentów oraz UI konsoli w 11 językach. To realistyczna funkcja na pierwszy tydzień pracy i ma kilka przypadków brzegowych, które łatwo przeoczyć.
Każde uruchomienie to bezgłowa sesja Claude Code na Opusie 5.5, w sandboxie na własnym klonie i bazie danych, ze skryptem, który wypychał jej commit do draftowego PR-a i zwracał wynik CI do sesji, maksymalnie w trzech rundach. Koszt to własne total_cost_usd Claude Code dla sesji głównej plus każdego subagenta, wycenione według cennika API. Płacę subskrypcją, więc to miara pracy, nie mojego rachunku.
Siedem konfiguracji:
| Konfiguracja | Uruchomienia | |
|---|---|---|
| A | Pełny CLAUDE.md 33 KB i dziesięć skilli, prompty potoku (najpierw plan, potem implementacja) | 2 |
| B | Pełny CLAUDE.md i skille, prosty prompt | 3 |
| C | Brak CLAUDE.md, brak skilli, prosty prompt | 2 |
| D | Pełny CLAUDE.md plus skill architect, prosty prompt | 2 |
| E | CLAUDE.md 8 KB, architect, grain-ponytail i unslop, prompty potoku | 1 |
| F | CLAUDE.md 5,5 KB, brak skilli, prosty prompt | 1 |
| G | CLAUDE.md 8 KB, architect, grain-ponytail i unslop, prosty prompt | 2 |
A do D przyszły pierwsze. E do G zbudowałem na tym, co pokazały, a trzecie uruchomienie B poszło obok nich jako kontrola. Plik 8 KB to ten 5,5-kilobajtowy plus krótka lista skilli i tego, kiedy je wczytywać, oraz reguły routingu modeli, które sprawiają, że skill architect deleguje do Sonneta.
Każdy wynik trafił potem do dwóch recenzentów Opusa, którzy widzieli tylko literę, diff, repozytorium i zadanie. Wypisali każdą zmianę, o którą poprosiliby przed zatwierdzeniem, ocenili ją jako blokującą, poważną, drobną lub kosmetyczną i sprawdzili każde kryterium akceptacji względem pliku i linii.
Koszt
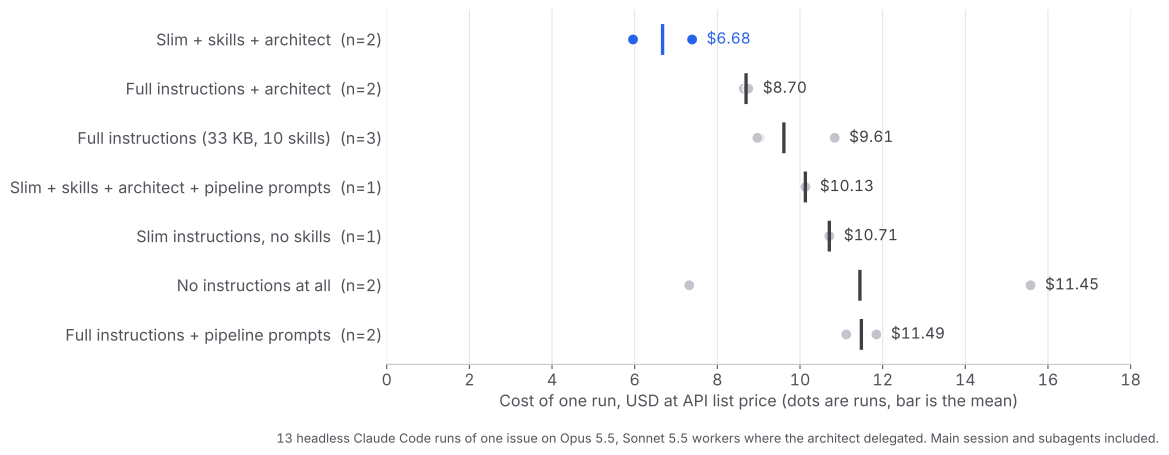
Zwycięska konfiguracja, G, kosztowała 5,96 i 7,39 dolara. Pełna konfiguracja z promptami potoku, A, kosztowała 11,12 i 11,85 dolara. Różnica to głównie tury i to, co każda tura niesie. Sesje główne A trwały 172 i 144 tury na Opusie, z 24 do 28 milionami tokenów wejściowych. Sesje G trwały 79 i 95 tur z 13 do 16 milionami i przekazały około 60 tur więcej workerom Sonnet, które rozliczają się po ułamku tej stawki. G skończyła też swoją pracę w około 21 minut wobec 45 minut A.
Dwie rzeczy na tym wykresie mnie zaskoczyły. Brak instrukcji wcale nie jest tanią opcją: jej dwa uruchomienia kosztowały 7,32 i 15,58 dolara, a to droższe zawiodło też CI i napisało największy diff w teście. A plik 5,5 KB bez skilli, F, nie był tańszy niż pełna konfiguracja. Napisał więcej kodu, 1 601 linii produktu, i za to zapłacił. Oszczędność w G nie bierze się z samego krótkiego pliku. Bierze się z krótkiego pliku plus dwóch skilli, które zmieniają sposób wykonywania pracy.
Dołącz do naszego newslettera
Otrzymuj najnowsze wskazówki, trendy i oferty za darmo.
Jakość
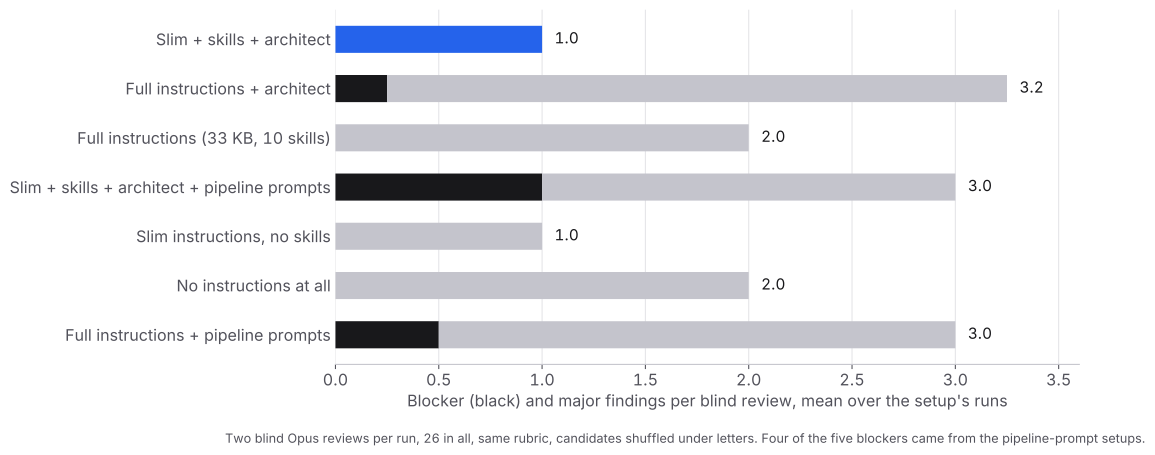
Najtańsza konfiguracja miała też najmniej poważnych uwag: żadnych blokujących i 1,5 oraz 0,5 poważnej uwagi na recenzję w swoich dwóch uruchomieniach. Pełny CLAUDE.md, B, utrzymywał się na 2.0 poważnych uwag we wszystkich trzech uruchomieniach, tyle samo co brak CLAUDE.md.
To wynik, na którym zależy mi najbardziej. Plik ma długie sekcje o bezpieczeństwie, uprawnieniach i kredytach, napisane, bo agent kiedyś je pominął. Z plikiem czy bez niego recenzenci znaleźli tyle samo poważnych problemów, a te same ich rodzaje wracały w różnych konfiguracjach: rejestracja, która płaci, a potem rezygnuje; mail zgubiony albo wysłany dwa razy, gdy worker zawiedzie w połowie; edytor, który nadpisuje treść, której nie potrafi pokazać. To luki w rozumowaniu o stanie zmieniającym się w czasie. Żadna lista reguł w CLAUDE.md ich nie obejmowała, bo nie da się napisać reguły na przypadek brzegowy, o którym jeszcze się nie pomyślało.
Obejmowała je natomiast zmiana w skillu architect między rundami. Zanim główny model napisze jakąkolwiek instrukcję roboczą, tworzy teraz tabelę: każde kryterium akceptacji, co się dzieje, gdy stan, od którego ono zależy, zmienia się w czasie, i rozstrzygnięte zachowanie. Każdy wiersz trafia potem do instrukcji razem z nazwanym testem. Uruchomienia G napisały 774 i 818 linii testów, wobec 510 do 670 dla B.
Etap planowania
A i E to dwie konfiguracje, które uruchamiały prompty naszego potoku CI: prompt planowania, który pisze plan, a potem prompt implementacji, który czyta plan i go wykonuje. Porównaj każdą z jej bliźniakiem, który dostał zamiast tego prosty prompt. A kosztowała 11,49 dolara na uruchomienie wobec 9,61 dolara w B i miała uwagi blokujące tam, gdzie B nie miała żadnej. E kosztowała 10,13 dolara wobec 6,68 dolara w G i miała uwagę blokującą w każdej swojej recenzji tam, gdzie G nie miała żadnej.
Myślę, że powodem jest to, że plan to dokument, który model pisze dla siebie, a potem musi odczytać jako zewnętrzną instrukcję. Druga sesja traktuje plan jak specyfikację, podąża za nim tam, gdzie jest błędny, i spala tury na godzenie go z tym, co znajduje w kodzie. Model o takiej zdolności planuje lepiej wewnątrz sesji, która ma wykonać pracę, gdzie plan i kod są w tym samym kontekście.
Ta część planowania, która przetrwała, to instrukcja robocza. Gdy główny model przekazuje wycinek pracy workerowi Sonnet, worker startuje z pustym kontekstem i buduje dokładnie to, co mu się każe. To przekazanie wymaga spisanego, rozstrzygniętego opisu: celu, plików, wzorca do naśladowania, przypadków brzegowych, testu do napisania. Plan dla siebie to narzut. Instrukcja robocza dla kogoś innego to jedyny sposób, by praca przeszła dalej.
Co zrobił grain-ponytail
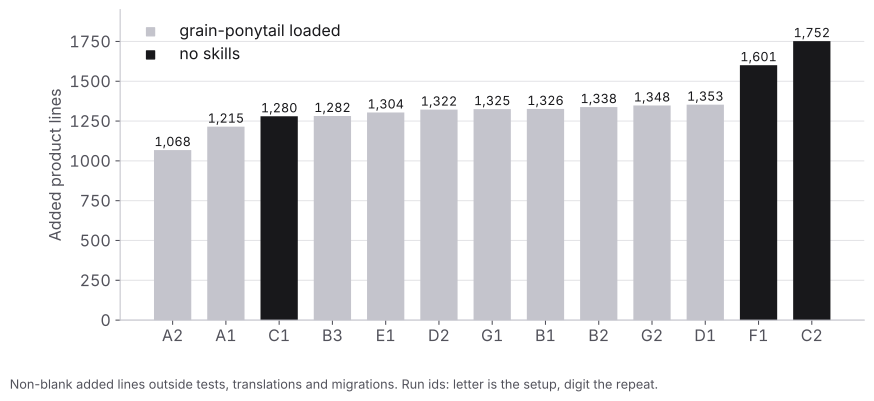
Skill z wpisu code with the grain każe modelowi naśladować najbliższy istniejący przykład i dostarczyć najmniej kodu, który działa. Każde uruchomienie, które go miało, napisało od 1 068 do 1 353 linii produktu. Dwa największe diffy, 1 601 i 1 752, pochodziły z uruchomień bez skilli. Jedno uruchomienie bez skilli zatrzymało się na 1 280, więc skill sam nie decyduje o rozmiarze, ale usunął ogon rozkładu.
To także najczystszy przykład tego, jaki rodzaj instrukcji nadal się opłaca. „Naśladuj najbliższy przykład" zmienia to, co model robi przy każdym pliku, który pisze. „Używaj snake_case dla funkcji" powtarza coś, co już robi.
Co jeszcze wyłapały recenzje
Zwycięskie uruchomienie nie było czyste. Po teście zrobiłem rebase pracy G2 na main i przepuściłem ją przez nasze pełne sprawdzenie PR, które recenzuje diff, dowodzi każdej uwagi testem, który nie przechodzi, i prowadzi zmianę w prawdziwej przeglądarce. Wykryło, że edytor kroków gubił każdy blok poza pierwszym blokiem HTML, gdy administrator edytował krok utworzony przez MCP, i że nieudane zwolnienie rezerwacji mogło wysłać maila do niektórych użytkowników dwa razy. Oba problemy naprawiono, z testami, zanim PR trafił do recenzji człowieka.
Recenzenci w ciemno zgłaszali też więcej przekombinowania w uruchomieniach z architectem niż w tych z pełnymi instrukcjami: 2,5 pozycji na recenzję dla G wobec 0 do 1,0 dla uruchomień A i B. Mniej poważnych uwag, więcej drobiazgów. Wziąłbym tę wymianę, ale to jest wymiana.
Co zmieniłem
- Plik CLAUDE.md o rozmiarze 33 KB stał się plikiem AGENTS.md o rozmiarze 12 KB, który czyta też Codex, a CLAUDE.md tylko go importuje. Zachowuje komendy, rytm testów, architekturę i reguły, których model nie wywnioskuje z kodu, takie jak to, które ścieżki są krytyczne i że dwie powierzchnie agenta muszą pozostać spójne.
- Etap planowania zniknął z potoku. Triage przekazuje zadanie prosto do etapu implementacji, którego prompt skurczył się do sześciu kroków: przeczytaj zadanie, zrób branch, wczytaj skille architect i grain-ponytail, przetestuj, zrób commit, otwórz draftowy PR.
- Skill architect zyskał tabelę przypadków brzegowych, pole Tests w instrukcji roboczej i końcowe przejście, które sprawdza cały diff względem zadania, a nie względem instrukcji roboczych. Ta wersja jest publiczna na github.com/LivinTribunal/architect-skill .
Zmiana w repozytorium jest w recenzji w momencie pisania tego tekstu.
Co z tego wynika
Jeśli twój CLAUDE.md rósł po jednym incydencie naraz, prawdopodobnie płacisz za reguły, których model już przestrzega. Odetnij go do tego, czego model nie może się dowiedzieć, czytając kod, i zmierz stan przed i po na prawdziwym zadaniu, zamiast ufać, że więcej wskazówek jest bezpieczniejsze.
Zachowaj instrukcje, które zmieniają sposób wykonywania pracy: kto pisze kod, jak przekazuje się wycinek pracy, który istniejący wzorzec kopiować. Wyrzuć potok plan-a-potem-wykonaj, jeśli twój główny model jest obecnym frontierowym modelem. Pisz instrukcje robocze dla workerów, nie plany dla siebie.
Metoda
13 bezgłowych uruchomień Claude Code 2.1.289 z 5 października 2026, model główny Opus 5.5, workery Sonnet 5.5 tam, gdzie skill architect delegował. Wszystkie uruchomienia startowały z jednego commita monorepo FlowHunt, każde w klonie APFS z własną bazą danych Postgresa, w sandboxie odseparowanym od pozostałych uruchomień i od plików samego eksperymentu. Broker wypychał commit każdego uruchomienia do draftowego PR-a wobec zamrożonej gałęzi bazowej i wznawiał sesję z wynikiem CI, maksymalnie w trzech rundach. Koszt to maksymalne total_cost_usd na sesję, zsumowane po sesji głównej i jej subagentach. Linie produktu to niepuste dodane linie poza testami, tłumaczeniami i migracjami.
Każdy wynik dostał dwie recenzje w ciemno od Opusa z jedną rubricą: poprawność, kryteria akceptacji, dopasowanie do stylu repozytorium, pola prywatne i ukryty stan, przekombinowanie, bezpieczeństwo i uprawnienia, testy, migracje. Kandydaci zostali przetasowani pod literami, a recenzenci mogli czytać repozytorium, ale nic nie mogli uruchomić. Uwagi na recenzję są uśrednione po uruchomieniach danej konfiguracji. Przy jednym do trzech uruchomień na konfigurację średnią pojedynczej konfiguracji traktuj jako zaszumioną. Wnioski powyżej to te, które utrzymały się w obu rundach.
