

Kluczowe wnioski
- Pisanie kodu to już nie wolna część. W ciągu 31 dni nasze główne repozytorium scaliło 473 żądania połączenia. 130 z nich potrzebowało, aby ktoś wrócił i scalił główną gałąź w gałęzi, 239 commitów merge w sumie, i 238 z nich zostało wykonanych przez osobę.
- Żądania połączenia, które tego potrzebowały, zajęły medianę 44 godzin od otwarcia do scalenia. Te, które tego nie potrzebowały, zajęły 2 godziny. Z 60 żądań połączenia, które pozostały otwarte dłużej niż trzy dni, 51 potrzebowało co najmniej jednego scalenia głównej gałęzi.
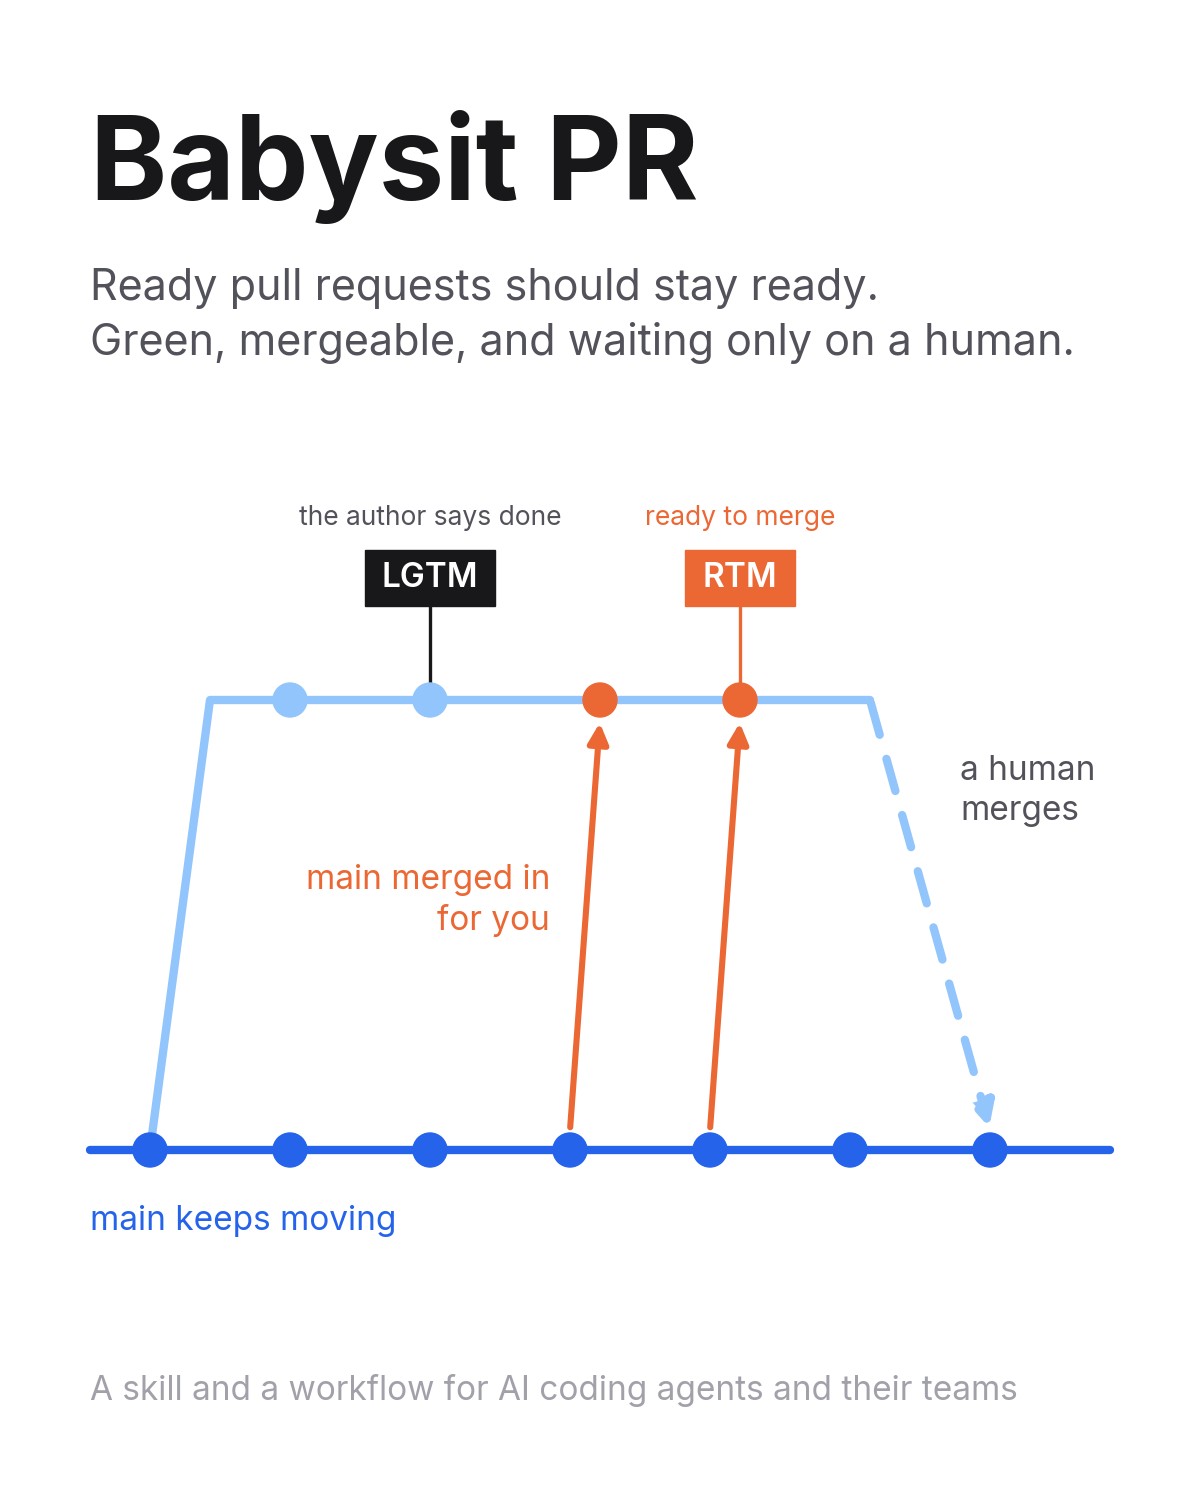
- babysit-pr dzieli zadanie na jedną etykietę:
LGTM, „looks good to me" (wygląda mi dobrze), którą autor dodaje, gdy praca jest gotowa. Przed tym umiejętność utrzymuje agenta na żądaniu połączenia, aż CI będzie zielone i każdy bot recenzji odpowie. Po tym przepływ pracy GitHub Actions utrzymuje żądanie połączenia mergowalne, aż osoba je scali, i dodajeRTM, „ready to merge" (gotowe do scalenia), gdy ktoś inny niż autor zatwierdzi. - Przepływ pracy nigdy nie scala, nigdy nie zamyka i nigdy nie zmienia linii napisanej przez autora. Konflikt, którego nie może rozwiązać wokół kodu autora, trafia z powrotem do autora jako
REWORK. - Umiejętność jest publiczna, licencja MIT: babysit-pr-skill na GitHub , ze skryptem obserwatora i projektowaniem przepływu pracy. Sam przepływ pracy jest wciąż w trybie suchych przebiegów na naszym repozytorium, i poniżej wyjaśniam dlaczego.
Dlaczego gotowe żądania połączenia stają się zaniedbane?
Pisanie kodu przestało być wolną częścią. Z wzorem architekta i agentami wykonującymi większość wpisywania, nasze repozytorium przyjmuje około 13 commitów dziennie do głównej gałęzi. To jest dobre dla wysyłki i złe dla każdego otwartego żądania połączenia, ponieważ każdy z tych commitów może umieścić żądanie połączenia w konflikcie lub pozostawić jego CI czerwone.
Pobrano ostatnie 31 dni scalonych żądań połączenia, aby zobaczyć, gdzie czas się spędzał.
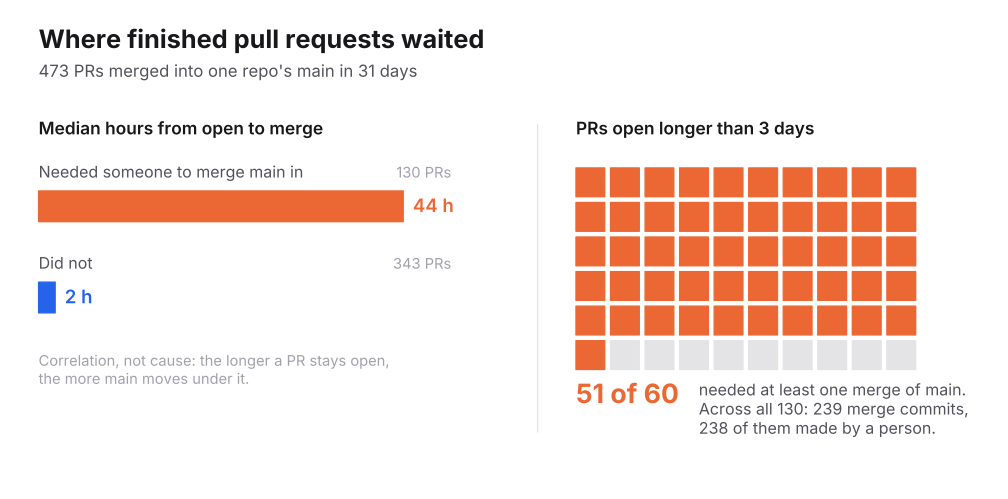
44 na 2 to korelacja, a nie przyczyna. Żądanie połączenia, które pozostaje otwarte dłużej, daje głównej gałęzi więcej czasu na zmianę poniżej, więc bardziej prawdopodobne jest, że będzie potrzebować merge. Ale scalenia same w sobie to prawdziwa praca, którą ktoś wykonał 239 razy w miesiącu. Pięć osób wykonało 238 z nich ręcznie. Jedno żądanie połączenia potrzebowało osiem scalений głównej gałęzi przez siedem dni, kiedy było otwarte.
Samo zatwierdzenie było szybkie. Po tym, jak żądanie połączenia otrzymało pierwsze zatwierdzenie, mediana czasu do scalenia wyniosła zero godzin. Oczekiwanie miało miejsce przed tym: autor skończył, następnie żądanie połączenia czekało, aż recenzent je otworzył, a podczas gdy czekało, główna gałąź się zmieniła. Zaczęliśmy oznaczać gotowe żądania połączenia LGTM 20 października. 20 tych, które scaliły się od tego czasu, czekało medianę 38 godzin między LGTM a scaleniem, a jeden na cztery czekał więcej niż 78.
To jest luka, dla której jest. Nikt tu nie jest niedbały. Autor myśli, że jest gotowy, recenzent go jeszcze nie otworzył, a gałąź gnije w międzyczasie.

Gotowy na rozwój swojej firmy?
Rozpocznij bezpłatny okres próbny już dziś i zobacz rezultaty w ciągu kilku dni.
Dlaczego nie zamknąć zaniedbanych żądań połączenia za pomocą actions/stale?
Zwykła odpowiedź na zaniedbane żądania połączenia to actions/stale : akcja GitHub, która dodaje etykietę zaniedbania do issues i żądań połączenia po określonej liczbie dni nieaktywności i automatycznie je zamyka kilka dni później, chyba że ktoś skomentuje lub wyśle zmiany.
To pasuje do żądania połączenia, nad którym nikt nie pracuje. Nic nie robi dla tych, które mieliśmy. Nasze były gotową pracą, które stały się zaniedbane, podczas gdy czekały na recenzenta, ponieważ główna gałąź zmieniła się poniżej. Zamykanie ich wyrzuca pracę na śmietnik, a etykieta zaniedbania mówi autorowi to, co już wie. To, czego żądanie połączenia potrzebuje, to ktoś, aby scalić główną gałąź, ponownie uruchomić czerwone zadanie CI i utrzymać je zielone aż do zatwierdzenia przez osobę. Zamiast zamykać zaniedbane żądania połączenia, utrzymujemy je mergowalne.
Jak babysit-pr utrzymuje żądania połączenia mergowalne
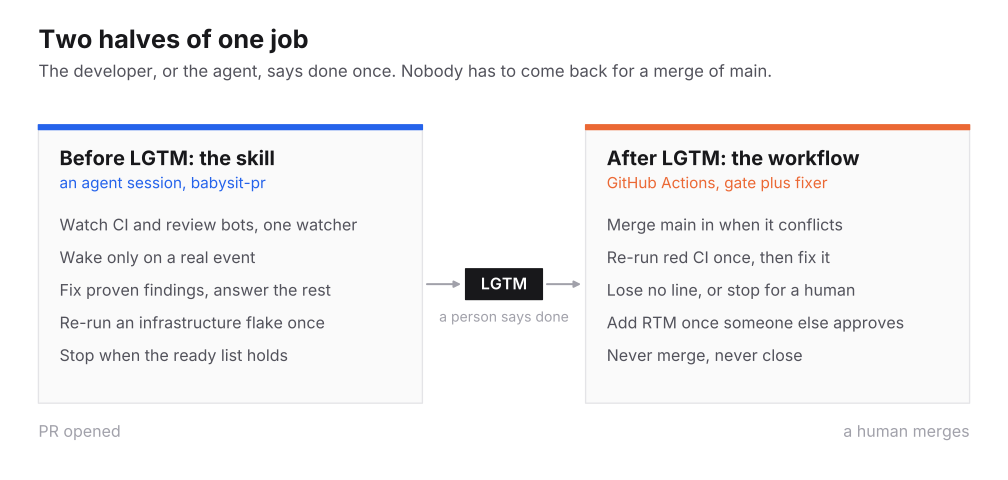
Podział następuje po tym, kto czeka. Przed LGTM autor wciąż jest na żądaniu połączenia, zwykle sesja agenta, a umiejętność utrzymuje tę sesję wykonującą użyteczną pracę zamiast ogłaszania zwycięstwa, gdy kod się kompiluje. Po LGTM autor przeszedł dalej, więc praca trafia do czegoś, co ich nie potrzebuje: przepływu pracy, który działa, niezależnie od tego, czy ktoś patrzy.
LGTM oznacza „looks good to me" (wygląda mi dobrze). W większości zespołów recenzent mówi to o czymś czyjejś kodzie. Tutaj autor umieszcza to na własnym żądaniu połączenia jako etykietę, która oznacza „jestem gotowy, nic mi już do zrobienia". To jest słowo osoby: agent dodaje to tylko, gdy została poinstruowana, aby przekazać żądanie połączenia. Ta etykieta to zdecydowanie dla wszystkiego po niej, i to jest rzecz, która sprawia, że programista czuje się komfortowo, pozwalając botowi wysyłać zmiany do swojej gałęzi.
Dołącz do naszego newslettera
Otrzymuj najnowsze wskazówki, trendy i oferty za darmo.
Przed LGTM: umiejętność Claude Code prowadzi żądanie połączenia do gotowości
Umiejętność zaczęła się jako umiejętność babysit-pr w tstack
Theo Browne’a. Zachowałem jego obserwatora i jego podstawowe reguły i zmieniłem, gdzie się zatrzymuje.
Jeden obserwator na żądanie połączenia
pr-wait odpytuje jedno żądanie połączenia i drukuje jedną linię na rzeczywiste zdarzenie: sprawdzenie nie powiodło się, wszystkie sprawdzenia zakończyły się, ktoś skomentował lub przejrzał, główna gałąź zmieniła się poniżej plików, których dotyka to żądanie połączenia, gałąź zalegała lub weszła w konflikt, żądanie połączenia się scaliło. W Claude Code działa w ramach narzędzia Monitor, więc każda linia budzi agenta raz. Zdarzenie, które nie wymaga działania, kończy turę bez wiadomości. „Wciąż czekam" to nie wiadomość, a agent, który to mówi pięćdziesiąt razy, zapełnia własny kontekst niczym.
Sortuj czerwone zadanie CI przed dotknięciem kodu
Istnieją cztery rodzaje czerwonych, a tylko jeden to naprawa kodu:
- Żądanie połączenia je przerwało. Napraw najmniejszą zmianą.
- Runner wpadł. Ponownie uruchom nieudane zadania jeden raz. Druga awaria na tym samym head nie jest wpadą.
- Główna gałąź jest czerwona. Nie naprawiaj głównej gałęzi na czyjejś gałęzi funkcji. Zrób raport i czekaj.
- Sprawdzenie procesu jest czerwone, na przykład żądanie połączenia nie łączy zatwierdzonego issue. To krok dla osoby.
Agenci pozostawieni sami traktują wszystkie cztery jako pierwsze, a żądanie połączenia otrzymuje obejście dla testu, który jest uszkodzony na głównej gałęzi.
Udowodnij ustalenie recenzji przed naprawieniem go
Ustalenie recenzji, które agent akceptuje, otrzymuje najpierw nieudany test, następnie naprawę. Ustalenie, które odrzuca, otrzymuje pisaną przyczynę. To ta sama reguła co nasza umiejętność sprawdzonej recenzji, i to co zatrzymuje boty recenzji przed sterowaniem żądaniem połączenia pod względem ilości.
Utrzymuj żądanie połączenia w rozmiarze jego celu
Pętle recenzji rozwijają żądanie połączenia o jedną taninę opatrzną poprawkę: ochronę dla przypadku brzegowego, którą nikt nie uderza, test dla zachowania, które się nie zmieniło, wyłącznik kompatybilności. Umiejętność naprawia rzeczywiste błędy w zamierzonym przypadku i odrzuca resztę na piśmie. Warte są rzeczy stają się issues.
Gotowość to lista kontrolna
Każde zadanie CI gating zielone na obecnym head, każdy bot recenzji zakończył się na tym head, nic nie czeka na człowieka, brak nierozwiązanego wątku, brak konfliktu. Gdy to się utrzymuje, agent to raportuje i przestaje obserwować.
Po LGTM: przepływ pracy GitHub Actions rozwiązuje konflikty merge
Przepływ pracy ma dwa zadania.
Bramka decyduje, czego każde żądanie połączenia potrzebuje
Bramka jest tania: bez agenta, bez kasowania kodu żądania połączenia. Działa przy każdym push do głównej gałęzi, każdym ukończeniu CI, każdej etykiecie i recenzji, i co 30 minut, a jedno zapytanie GraphQL daje jej każde otwarte żądanie połączenia LGTM. Dla każdego funkcja czysta decyduje, co robić. Dodaj RTM, jeśli jest zatwierdzone przez kogoś innego niż autor, zielone i wolne od konfliktów. Zostaw to sam, jeśli recenzja jest uruchomiona. Ponownie uruchom czerwone CI jeden raz. Wyślij konflikt lub CI, które jest wciąż czerwone po jego ponownym uruchomieniu, do naprawiającego.
Agent naprawiający scala główną gałąź
Naprawiacz to zadanie agenta dla jednego żądania połączenia na jednym head. Scala główną gałąź do gałęzi bez zatwierdzania, daje agentowi pliki konfliktowe i dzienniki niepowodzenia, i pozwala mu edytować tylko pliki konfliktowe i pliki, które już zmienia żądanie połączenia. Następnie zadaje jedno pytanie.
Czy to żądanie połączenia może wylądować bez zmiany linii napisanej przez autora?
Jeśli tak, wyrok to MODERNIZE. Agent rozwiązuje konflikt wokół linii autora, walidator sprawdza wynik, a przepływ pracy push zwykły commit merge. Jeśli nie, ponieważ główna gałąź usunęła funkcję, którą edytuje żądanie połączenia, lub kod żądania połączenia sam w sobie nie przejdzie CI, wyrok to REWORK. Nic nie jest push, LGTM spada, a autor otrzymuje komentarz z najmniejszą przepisaniem. Jeśli główna gałąź już robi to, co żądanie połączenia robi, wyrok to CLOSE, i osoba to zamyka.
Walidator utrzymuje każdą linię napisaną przez autora
Walidator to to, co utrzymuje regułę. Odrzuca każde merge, które opuszcza linię, którą żądanie połączenia dodało, lub linię, którą główna gałąź dodała do pliku konfliktowego. Odrzuca edycje poza dozwolonymi plikami, pozostałymi markerami konfliktów i zmianami w plikach CI lub bezpieczeństwa. Agent, który próbuje „naprawić" kod autora, kończy się na etykiecie pytającej o człowieka, nigdy z pushrem. Przepływ pracy pushuje bez siły, i tylko jeśli gałąź się nie zmieniła od momentu rozpoczęcia próby. Jedna próba na head i base, dwie na head, trzy komentarze na żądanie połączenia dziennie.
Nigdy nie scala
RTM, „ready to merge" (gotowe do scalenia), to stwierdzenie bramki, że żądanie połączenia ma wszystko, czego potrzebuje: LGTM autora, zatwierdzenie kogoś innego, zielone CI i brak konfliktu. Osoba wykonuje scalanie. To utrzymało projekt mały, i utrzymało spór o to, czy bot powinien scalić z drogi.
Co się zmienia dla autora, recenzenta i ktokolwiek scala
Autor mówi gotowy raz. Nie wracają trzy dni później, aby scalić główną gałąź i czekać na CI ponownie, a żądanie połączenia agenta nie gnije, ponieważ sesja, która go otworzyła, skończyła się.
Recenzent otwiera żądanie połączenia, które jest zielone i mergowalne na dzisiejszej głównej gałęzi, więc ich zatwierdzenie to ostatni krok, a nie początek następnej rundy.
Ktokolwiek scala pracuje z jednej listy. RTM pozostaje raz, gdy bramka go doda, a jeśli główna gałąź przerywa żądanie połączenia po tym, przepływ pracy to naprawia i etykieta pozostaje.
A autor zachowuje kontrolę nad swoim kodem. Najgorszą rzeczą, którą bot może zrobić z gałęzią, to dodać commit merge, który walidator sprawdził linia po linii.
Dlaczego nasz stary resolver konfliktów merge nigdy się nie uruchomił
Mieliśmy resolver konfliktów przed tym. Detektor znalazł skonfiktowane żądania połączenia i skomentował je, a resolver uruchomił się, gdy ktoś dodał etykietę o to proszącą. W tym samym okresie detektor uruchomił się około 2500 razy. Resolver uruchomił się zero razy.
Nie myślę, że ktoś był leniwy. Programista, który uważa, że żądanie połączenia jest gotowe, nie wraca do niego, aby nacisnąć przycisk. Automatyzacja, która czeka, aby być poproszonym, nie będzie poproszona. Dlatego ta zaczyna się od LGTM, momentu, gdy autor mówi, że jest gotowy, i robi resztę bez nich.
Co jeszcze nie działa?
Dwie rzeczy, i wolę je powiedzieć tutaj niż mieć je odkryte.
Przepływ pracy jest w trybie suchych przebiegów
Jego bramka tylko loguje to, co by zrobiła, aż zmienna repozytorium powie coś innego. Zanim zaszło tak daleko, recenzja, która utrzymuje tylko ustalenia, które może udowodnić z nieudanym testem, znalazła jedenaście błędów. Kilka jest warte wiedzy, jeśli budujesz swoje. Wyszukiwanie etykiet GitHub zabytkowe, więc żądanie połączenia, które zwraca, może stracić etykietę sekundy temu, a decyzja musi sprawdzić etykiety na żywo. „Ten head już miał ponowny start" znacznik napisany przed wywołaniem ponownego startu sukces pozwala jednej awarii API używać jedynego ponownego uruchomienia głowy. I kontrola „nie strać linii", która nie podąża zmianami nazw, widzi każdą linię zmienionego pliku jako utraconą.
Runners agentów były w dół
Od 19 października każde zadanie ukierunkowane na nasze runners agentów nie mogło uzyskać maszyny: 406 anulowanych, 24 wciąż w kolejce, gdy sprawdzałem. Bramka działa gdzie indziej i jest w porządku, ale naprawiacz potrzebuje agenta runner, a martwy wygląda dokładnie jak cichy dzień. Nic nie uległo awarii głośno. Zadania się ukołowały, a następnie się anulowały. Jeśli to budujesz, alertuj na przebiegi naprawiające, które siedzą w kolejce.
Więc liczby powyżej to obraz sprzed. Teraz mamy 27 otwartych żądań połączenia LGTM, 7 z nich z czerwonym CI i żaden z RTM. To są liczby, które to powinno zmienić, i zgłoszę to, co to zrobiło.
Jak zainstalować umiejętność babysit-pr
github.com/LivinTribunal/babysit-pr-skill ma:
SKILL.md, umiejętność, z krótką sekcją „konfiguruj raz" dla twojej CI przepływów pracy, botów recenzji i checks procesów.scripts/pr-wait, obserwator. Potrzebuje Python i uwierzytelnionegogh.docs/after-lgtm.md, projekt przepływu pracy po-LGTM: etykiety, bramka, naprawiacz, reguła, że nigdy nie zmienia linii autora, i jedenaście błędów.
Przepływ pracy to projekt, a nie plik do skopiowania, ponieważ nasz działa przeciwko etykietom, runnerom i CI jednej firmy. Zbuduj swoje z dokumentu, wyślij w trybie tylko do logowania, przeczytaj dzień jej decyzji, a następnie włącz to.
To łączy się z wzorem architekta , który decyduje, kto pisze kod, i grain , który decyduje, jak kod wygląda. babysit-pr to co się dzieje po tym, gdy każdy z nich otwiera żądanie połączenia. Jeśli dostraiasz sam agenta, test A/B CLAUDE.md i limit kontekstu, który zmniejszył użycie tokenu o 17% obejmują instrukcje i koszt.