


Kilka dni temu Anthropic na stałe włączył Fable do planów Max. Czas mówi wszystko: stało się to zaraz po tym, jak OpenAI wypuściło GPT-5.6 Sol i — co ważniejsze — zaraz po tym, jak Kimi K3 udostępnił swoje wagi. Potrzeba było open source’owego modelu, by zmusić największe laboratorium AI do konfrontacji z rzeczywistością i zakończyć marketingowy szum wokół jego flagowca. Już za to należy się toast od każdego, kto płaci te faktury.
Ale “wliczone w subskrypcję” to nie to samo co “tanie”, a już na pewno nie to samo co “tanie na zawsze”. Dlatego, gdy Fable był jeszcze rozliczany za zużycie, przebudowaliśmy nasz workflow tak, aby drogi model był mechanicznie zablokowany przed pisaniem kodu. Myśli, planuje i recenzuje. Tańsze modele piszą. Ten wpis pokazuje, jak to działa i co faktycznie dało w każdym transkrypcie, jaki mamy — 606 rzeczywistych sesji obejmujących produkcyjne monorepo SaaS, aplikację do obsługi dronów, stronę marketingową i agentów CI, którzy im służą.
Część 1 — pułapka i zasada
Nasze szczere stanowisko wyjściowe: nie jesteśmy już w stanie działać bez modeli czołowych. Nikt w zespole nie utrzymałby obecnego tempa pracy bez nich — a ta zależność to dokładnie ta dźwignia, którą trzymają wielkie laboratoria. Naszym zdaniem dzisiejsze subskrypcje AI dostarczają wyraźnie więcej obliczeń, niż kosztują; to ceny typu land grab, a takie ceny się kończą. Kiedy się skończą, ten, kto zbudował kulturę inżynierską wokół “nielimitowanych tokenów modeli czołowych”, zapłaci tyle, ile zażądano.
Są dwie linie obrony. Pierwsza to utrzymywanie wiarygodnej drogi wyjścia: otwarte modele, takie jak DeepSeek i Kimi, wymusiły tegoroczną korektę cen, a pozostaną dźwignią tylko wtedy, gdy naprawdę utrzymamy nasze workflow przenośne na nie. Druga to dyscyplina workflow: wydawaj tokeny modeli czołowych tylko tam, gdzie nic tańszego nie działa. Ten wpis dotyczy drugiej — bo to tę możesz zacząć w poniedziałek.
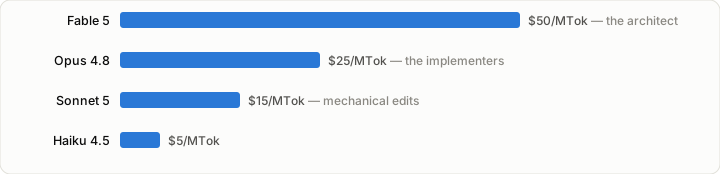
Ta zasada jest tak stara, że ma nazwany po niej budynek: architekt nie kładzie cegieł. Przewaga modelu czołowego nad modelem średniej klasy jest ogromna w projektowaniu, dekompozycji i recenzji — a bliska zeru przy wpisywaniu zmiany nazwy w czterdziestu plikach. Więc podziel role. Drabinka cen mówi to samo w dolarach:
Jak działa wzorzec fable-architect
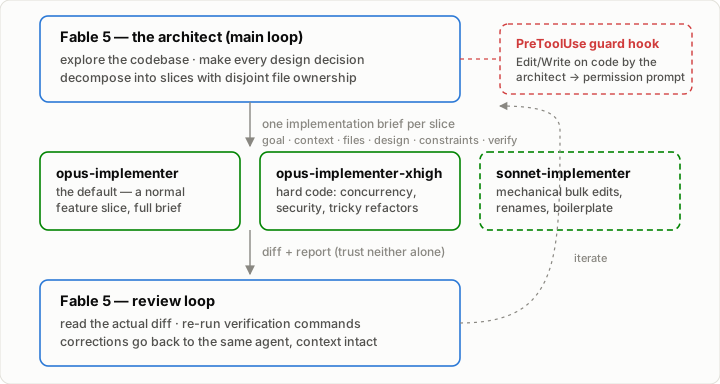
Umiejętność fable-architect to plik markdown o długości ~100 linii plus jeden hook powłoki, ładowany za każdym razem, gdy sesja Claude Code działa na modelu czołowym. Wymusza podział pracy:
- Architekt robi: dopytuje o wymagania, eksploruje bazę kodu, podejmuje każdą decyzję projektową — podejście, przepływ danych, nazwy, sygnatury, przypadki brzegowe — dzieli pracę na niezależne wycinki, recenzuje zwrócone diffy, uruchamia weryfikację i pisze całą prozę (plany, briefy, treści PR-ów, komunikaty commitów).
- Architekt nigdy nie robi: nie pisze ani nie edytuje pliku źródłowego. Żadnego kodu na czacie poza krótkimi sygnaturami wewnątrz briefu.
Trzy rzeczy sprawiają, że działa to w praktyce, a nie na slajdzie.
1. Brief to interfejs
Każdy wycinek dostaje jeden brief implementacyjny. Wykonawca startuje z czystym oknem kontekstu — wszystko, czego nie ma w briefie, musi odkryć na nowo albo zgadnąć. To ograniczenie jest zaletą: zmusza architekta do dokończenia decyzji przed delegowaniem. Brief zawiera decyzje, nie opcje.
## Brief implementacyjny: <slice>
Cel:           jedno zdanie, obserwowalny rezultat
Kontekst:      co już ustaliła eksploracja — fragmenty, najbliższy
               wzorzec do naśladowania, kotwice liniowe, pułapki
Pliki:         ścieżki do utworzenia/modyfikacji — wyłączna własność tego wycinka
Projekt:       zdecydowane podejście — przepływ danych, nazwy, sygnatury, przypadki brzegowe
Ograniczenia:  obowiązujące reguły projektu: styl, warstwy, bezpieczeństwo
Poza zakresem: czego nie ruszać, w tym plików należących do innych wycinków
Delegowanie:   czy ten wycinek może tworzyć podwykonawców i ilu
Weryfikacja:   dokładne polecenia i oczekiwany rezultat
Dwie z tych linii są nowsze od pozostałych i istnieją, bo warstwa wykonawców zmieniła się pod nami — zobacz aktualizację poniżej.
2. Wymuszanie, nie przeczucia
Hook strażnika PreToolUse obserwuje sesję: jeśli architekt próbuje edytować plik inny niż proza, uruchamia się prośba o zgodę. Zatwierdzenie tej prośby jest udokumentowanym wyjątkiem dla trywialnych edycji (literówka, podbicie wersji — przypadki, w których narzut delegowania kosztuje więcej niż wpisanie tekstu). Tarcie to polityka. Bez hooka “drogi model nie powinien kodować” wytrzymuje dokładnie do pierwszego terminu.
3. Pętla recenzji zamyka lukę jakościową
Architekt czyta raport agenta oraz faktyczny diff — nie ufając żadnemu z osobna — i ponownie uruchamia kluczowe polecenia weryfikacyjne, gdy twierdzenie ma znaczenie. Znalazłeś problem? Korekta wraca do tego samego agenta, który wciąż ma pełny kontekst roboczy. Żadnego ręcznego poprawiania, żadnego świeżego restartu.
Zwróć uwagę, że to weryfikacja architekta i ona zostaje. To, co zaczęliśmy usuwać, to weryfikacja, którą wpisywaliśmy do briefów — instrukcje każące wykonawcy sprawdzić się samodzielnie. Nowsze modele wykonawcze robią to bez pytania, a kazanie im robić to ponownie kupuje drugie przejście, za które już zapłaciłeś.

Gotowy na rozwój swojej firmy?
Rozpocznij bezpłatny okres próbny już dziś i zobacz rezultaty w ciągu kilku dni.
Co zmierzyliśmy
Aby sprawdzić, czy to realny mechanizm ekonomiczny, czy tylko przyjemny rytuał, przeanalizowaliśmy każdy transkrypt Claude Code w naszych projektach, deduplikując żądania API i wyceniając każdy token według aktualnych cen katalogowych. Trzy hipotezy, zapisane przed spojrzeniem na liczby dla poszczególnych sesji:
- H1 — Wykonawcy piszą. Jeśli prawda, podagenci-wykonawcy powinni produkować więcej tokenów wyjściowych niż główna pętla architekta w sesjach z delegowaniem.
- H2 — Delegowanie jest tańsze. Jeśli prawda, przecena pracy wykonawców według stawek modelu-architekta powinna wypaść istotnie drożej niż to, co faktycznie zapłaciliśmy.
- H3 — Jakość się utrzymuje. Ta trudna: kod delegowany nie powinien wymagać więcej przeróbek niż kod wpisany przez architekta.
Zasady. Jedno żądanie API rozciąga się na wiele linii transkryptu, które powtarzają ten sam obiekt zużycia — grupowaliśmy po ID żądania, liczyliśmy tokeny wejściowe i cache raz na żądanie i braliśmy maksymalny zrzut wyjścia (naiwne sumowanie po liniach zawyża 2–3×). Koszty używają aktualnych cen katalogowych Anthropic — Fable $10/$50, Opus $5/$25, Sonnet $3/$15 za milion tokenów wejściowych/wyjściowych — przy odczytach cache na poziomie 10% ceny wejścia i zapisach cache według stawek dla danego TTL. 31 z 354 sesji w interaktywnym magazynie kwalifikuje się jako sesje fable-architect według konserwatywnego klasyfikatora; liczby pokazują osiem najdroższych. Podajemy proporcje i procenty, a nie nasze bezwzględne wydatki.
Część 2 — rachunki
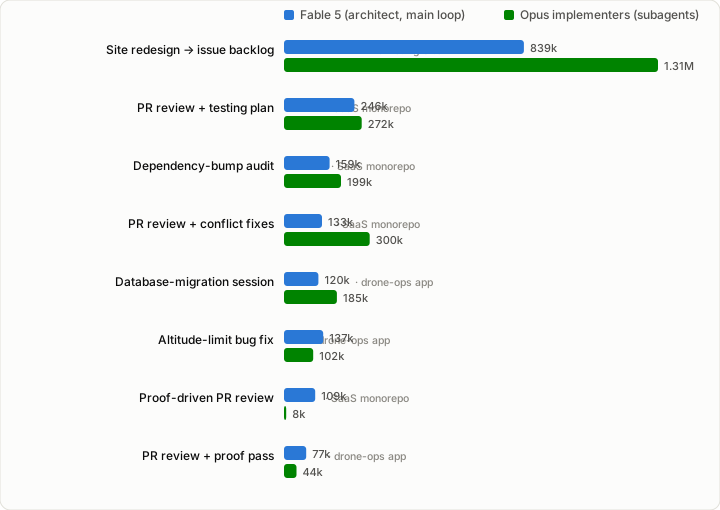
H1 — Wynik mieszany… mówiło pierwsze rozliczenie. W największych sesjach z delegowaniem hipoteza trzyma się zdecydowanie — do 2,3× więcej wyjścia wykonawców niż wyjścia architekta. Ale w sumie we wszystkich 31 sesjach fable-architect architekt nadal wyprodukował więcej niż wykonawcy: 3,59 mln wobec 3,15 mln tokenów. Częściowo to uczciwe — wyjście architekta obejmuje wszystkie plany, briefy i prozę recenzencką, co jest dokładnie jego zadaniem — a częściowo wyglądało to na sesje delegujące jeden wycinek, a resztę zostawiające sobie. Potem przypomnieliśmy sobie, że nasz redesign strony wcale nie wyglądał na zdominowany przez architekta, i poszliśmy szukać tokenów, których rozliczanie podagentów nie widziało.
Dołącz do naszego newslettera
Otrzymuj najnowsze wskazówki, trendy i oferty za darmo.
Drugi kanał: tracker zgłoszeń jako magistrala delegowania
Rozliczanie podagentów ma martwy punkt: widzi tylko delegowanie zachodzące wewnątrz sesji. Sesja redesignu strony — największa pozycja na powyższym wykresie — okazała się czymś zupełnie innym: pojedynczą sesją pętli architekta, która działała bez przerwy 107 godzin (292 zaplanowane wybudzenia), rozbiła redesign na zgłoszenia w GitHubie, oznaczyła je dla naszego pipeline’u CI, a potem nadzorowała: odpytywała uruchomienia, recenzowała pull requesty pipeline’u, zakładała kolejne zgłoszenia, gdy QA ujawniało błędy.
Pisanie działo się tam, gdzie nasze analizowanie per sesja nawet nie spojrzało: w osobnej flocie self-hosted runnerów, gdzie etapy pipeline’u plan → implementacja → ocena luk → recenzja wykonały się jako 252 niezależne sesje Opus w ciągu 4,5 dnia, dotykając 48 różnych zgłoszeń i PR-ów.
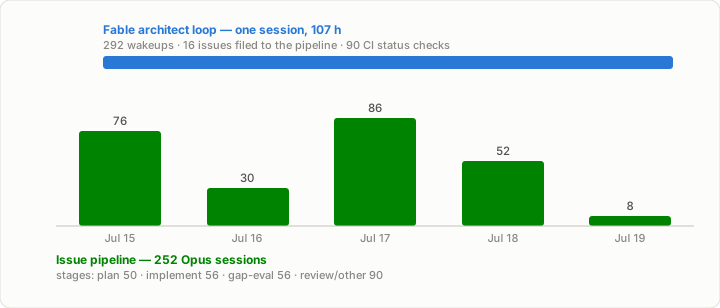
H1, raz jeszcze — potwierdzona w skali projektu. Policz oba kanały, a obraz się odwraca: pipeline wpisał 10× więcej tokenów wyjściowych niż pętla architekta, która go zleciła (9,07 mln wobec 877 tys.), wszystko po stawkach Opusa. Uruchomienie tej fali implementacji na modelu architekta kosztowałoby 2,1× więcej — przy jednym redesignie, w jednym tygodniu, jeszcze przed doliczeniem podagentów z sesji. Zgłoszenie to po prostu brief o grubszym ziarnie: ten sam interfejs, ta sama ekonomia, o jeden poziom wyżej.
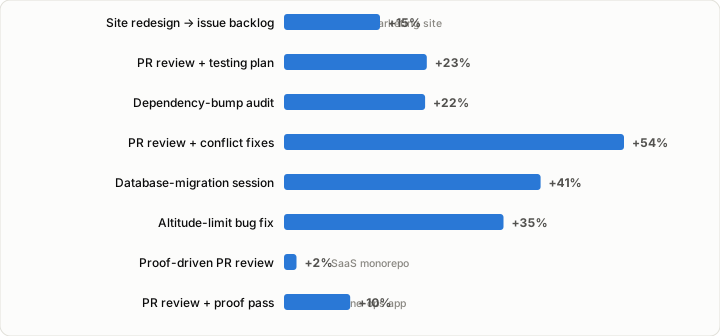
H2 — Potwierdzona, z niespodzianką. Przecena dokładnych wolumenów tokenów wykonawców po stawkach modelu architekta czyni każdą sesję droższą — od +2% do +54%, 17% w ośmiu największych. Prawdziwe pieniądze, ale mniejsze, niż sugeruje dwukrotna różnica w cenie wyjścia. Niespodzianka: pieniądze nie idą na wyjście. W największej sesji odczyty cache architekta kosztowały około 13× więcej niż wszystko, co wpisał — dominujący wydatek to drogi model trzymający i ponownie czytający duży kontekst orkiestracji, a nie pisanie. Delegowanie ogranicza rachunek za wyjście; następną dźwignią jest utrzymywanie kontekstu architekta w ryzach.
H3 — Niezmierzona tutaj. Rozliczanie tokenów nie widzi jakości kodu. Co możemy powiedzieć na podstawie obserwacji: pętla recenzji jest nośna — raporty i diffy rozjeżdżają się wystarczająco często, że czytanie obu jest nie do negocjacji — a korekty kierowane z powrotem do agenta z ciepłym kontekstem zbiegają szybko. Jeśli to zreplikujesz i porządnie zmierzysz przeróbki, chcemy to zobaczyć, zwłaszcza jeśli nas obali.
Czego nauczyły nas szersze dane
- Adopcja to gradient, nie przełącznik. W aplikacji do obsługi dronów — mniejszej i szybciej zmieniającej się — 18% sesji działa według wzorca fable-architect; w starszym monorepo SaaS to 9%. Projekt, który delegował najagresywniej, robił to w obu ziarnach naraz: briefy wykonawcze w sesji oraz 252 sesje pipeline’u zlecane przez tracker zgłoszeń.
- Flota CI nie uruchamia tej umiejętności — bo jest wykonawcą. Nasze automatyczne sesje runnerów nigdy nie tworzą podagenta-wykonawcy i początkowo wyglądało to na brak adopcji. Prompty mówią co innego: każda z nich to etap pipeline’u — weryfikacja, recenzja, ocena luk — a około sześciu na dziesięć pracuje nad konkretnym zgłoszeniem lub PR-em. W skali projektu runnery pipeline’u są warstwą wykonawczą.
- Najtańsza warstwa nie miała jeszcze pierwszego dnia w pracy. Wszystkie 78+ uruchomień wykonawczych było klasy Opus; warstwa mechanicznych edycji na Sonnecie została dodana dopiero niedawno i nie była wywoływana. Jakiekolwiek oszczędności to mierzy, są dolną granicą.
Sedno tkwi w interfejsie: brief wchodzi, diff wychodzi — zgłoszenie wchodzi, PR wychodzi. W dniu, w którym wchodzi podwyżka cen, wymieniasz murarza, a nie proces.
Pełne ujawnienie. Modele zweryfikowane na podstawie ciągów z transkryptów, nie założone. Dwa razy się poprawialiśmy (zawyżenie tokenów liczone per linia, a potem tabela cen z placeholderami). Założenie kontrfaktyczne zakłada, że architekt wydałby takie same wolumeny tokenów jak wykonawcy — przedziały błędu biegną w obie strony. Sesje pipeline’u żyją w magazynie transkryptów, którego nasze pierwsze dwa przejścia analityczne nie objęły zakresem; granica rozliczeniowa ukryła przed nami kanał delegowania o 9 mln tokenów, a twój prawdopodobnie też taki ma. Projekty jednego inżyniera, głównie praca typu review-and-fix i funkcje — to nie kontrolowany benchmark. Korpus zamyka się też przed premierą Opusa 5: każda liczba powyżej to Fable jako architekt nad wykonawcami klasy Opus 4. Ceny szczebli nie zmieniły się, gdy pojawił się Opus 5, więc zmierzone proporcje się utrzymują — ale zobacz następną sekcję, żeby wiedzieć, co się zmieniło.
Aktualizacja — drabinka przesunęła się pod nami
Opus 5 pojawił się po zamknięciu tych pomiarów i nic w drabince cen się nie zmieniło: Opus to nadal $5/$25 za milion tokenów wejściowych/wyjściowych, Fable nadal $10/$50, a powyższy wykres nadal jest poprawny. Zmieniły się możliwości na każdym szczeblu. Anthropic pozycjonuje Opusa 5 jako skokową zmianę w głębokim rozumowaniu i długodystansowej pracy agentowej — czyli dokładnie w tym, z czego zrobiona jest rola architekta, za połowę ceny warstwy architekta.
To wskazuje wprost na naszą własną niespodziankę z H2. Jeśli dominującym kosztem architekta są odczyty cache, a odczyty cache rozliczane są po 10% ceny wejścia, to architekt działający na Opusie 5 ponownie czyta swój kontekst orkiestracji po $0.50 za milion tokenów zamiast $1.00 u Fable. Pozycja, która kosztowała 13× więcej niż wszystko, co architekt wpisał, zmniejsza się o połowę. Nie zmierzyliśmy tego — to arytmetyka przy tym samym założeniu równych wolumenów tokenów, które zaznaczyliśmy przy kontrfaktycznym 2,1×, i to następna rzecz, którą zamierzamy przetestować. Jeśli się utrzyma, ciekawe pytanie przestaje brzmieć które modele piszą, a zaczyna czy architekt w ogóle potrzebuje najwyższego szczebla.
Trzy rzeczy w nowej warstwie wykonawczej zmieniają sam wzorzec, nie tylko jego cenę:
- Chętnie sięga po podagentów — odwrotnie niż jego poprzednik, którego trzeba było namawiać do delegowania. Wykonawca, który po cichu tworzy własnych wykonawców, mnoży rachunek, gdy nikt nie patrzy. Stąd linia
Delegation:w briefie: wycinek teraz mówi, czy może się rozgałęziać i jak szeroko. - Weryfikuje własną pracę bez pytania. Instrukcje weryfikacyjne pisane dla starszych modeli kupują teraz zbędne drugie przejście, więc znikają z briefów. Pętla recenzji architekta pozostaje nietknięta.
- Rozszerza zakres.
Out of scope:przestaje być formułką i staje się linią, która utrzymuje wycinek jako wycinek.
A szczebel, którego nigdy nie używaliśmy, wyostrzył się, gdy nie patrzyliśmy: Sonnet 5 dorównuje niemal jakości Opusa w pracy nad kodem przy $3/$15, z ceną wprowadzającą poniżej tego do końca sierpnia. “Jakiekolwiek oszczędności to mierzy, są dolną granicą” było asekuracją, gdy to pisaliśmy. Teraz brzmi jak niedopowiedzenie.
Część 3 — dokąd to świadomie zmierza
Świadomie sterujemy w stronę podziału, do którego — naszym zdaniem — każdy zespół inżynierski w końcu zostanie zmuszony: drogie modele czołowe tylko do burzy mózgów, architektury i recenzji; coraz tańsze modele do samego programowania. Dziś nasi wykonawcy są klasy Opus. Nic w workflow się nie zmienia, gdy staną się klasy Sonnet, klasy DeepSeek albo klasy Kimi — interfejs jest agnostyczny wobec modeli z założenia. W tym tkwi cała wartość strategiczna: w dniu, gdy skończy się dotacja i faktura się podwoi, zespoły z tą dyscypliną zmieniają jedną linię konfiguracji. Zespoły bez niej renegocjują całą swoją strukturę kosztów pod presją.
Fable-architect to mały krok — adopcja jest częściowa, a najtańsza warstwa nie doczekała się pierwszego uruchomienia. Ale to krok, który buduje mięsień: pisanie briefów w pełni specyfikujących wycinek, recenzowanie diffów, których sam nie wpisałeś, traktowanie uwagi drogiego modelu jak budżet. A fala redesignu pokazuje, dokąd ten mięsień prowadzi: gdy briefy działają, działają też zgłoszenia, a drogi model przestaje w ogóle zajmować się implementacją.
Co możesz zrobić w poniedziałek
- Podziel role w swoim środowisku agentowym. Jedna reguła na poziomie sesji: model czołowy planuje i recenzuje; deleguj wszystkie edycje plików do tańszego agenta-wykonawcy. W Claude Code to umiejętność plus definicje podagentów — jedno popołudnie konfiguracji.
- Uczyń granicę mechaniczną. Dodaj hook przed edycją, który kwestionuje własne zapisy plików drogiego modelu. Zasada, której złamanie nic nie kosztuje, zostanie złamana do piątku.
- Pisz briefy według stałego szablonu. Cel, kontekst, pliki, projekt, ograniczenia, poza zakresem, budżet delegowania, weryfikacja. Szablon to dyscyplina — a budżet delegowania powstrzymuje wykonawcę przed cichym zatrudnianiem własnych.
- Recenzuj zarówno raport, jak i diff. Nigdy nie ufaj żadnemu z osobna; uruchom ponownie polecenia weryfikacyjne, które mają znaczenie.
- Zmierz własny podział. Twoje transkrypty już zawierają dane — grupuj po żądaniu, wyceniaj po modelu i zobacz, kto faktycznie pisze. Nasze pokazały nam niewykorzystaną tanią warstwę i kanał delegowania o 9 mln tokenów, o którym nie wiedzieliśmy.
- Rozszerz interfejs z briefów na zgłoszenia. Brief deleguje godzinę pracy; zgłoszenie deleguje dzień. Gdy twoje zgłoszenia zawierają kryteria akceptacji, na których pipeline może działać, drogi model może zgłaszać pracę do trackera i nadzorować, zamiast siedzieć w pętli przy każdym wycinku.
- Trzymaj ciepłą drogę wyjścia. Uruchamiaj tani albo otwarty model jako wykonawcę przy jednym wycinku niskiego ryzyka tygodniowo. Przenośność, której nigdy nie ćwiczysz, to przenośność, której nie masz.
- Przeceniaj architekta, nie tylko murarza. Każde wydanie modelu przesuwa szczeble, nie ruszając drabinki. Jeśli większość twoich wydatków na architekta to kontekst, a nie pisanie, tańsza warstwa architekta jest warta więcej niż tańsza warstwa wykonawcy — sprawdź, którą z nich, według twoich transkryptów, kupujesz.
Laboratoria będą nam wciąż powtarzać, że ich najlepsze modele są warte każdej ceny i — irytująco — w pracy wymagającej osądu mają w większości rację. Ruch nie polega na wstrzymaniu się. Polega na tym, żeby przestać płacić ceny modeli czołowych za pętle for.
