


A versão curta
- Durante cinco semanas, mantive meu agente de codificação em um esquema dividido: o modelo principal, Opus e depois Fable, lê, decide e revisa, e um agente worker escreve o código a partir de um briefing escrito. Eu chamo isso de padrão arquiteto e agora é uma skill pública: architect-skill no GitHub , licenciada sob MIT.
- O modelo principal parou de digitar. Ao longo de 49 sessões de arquiteto, ele editou um arquivo de código-fonte 6 vezes em 1.467 prompts. Em 275 sessões simples nas mesmas semanas, ele editou 244 arquivos em 3.081 prompts. Isso é 0.4 contra 7.9 a cada 100 prompts.
- O total de tokens por prompt não caiu. Ele subiu, e muito, por duas semanas, e depois voltou ao patamar das sessões simples. O que mudou foi quem os gastou: a fatia de tokens de worker do Opus passou de 100% para cerca de 4%, e desde 14 de setembro um prompt em uma sessão de arquiteto custa 364k tokens ponderados no modelo principal, 205k nos workers Sonnet e 80k nos workers Opus.
- É essa divisão que uma assinatura leva em conta. O Claude Max mede seu limite semanal de todos os modelos à taxa de cada modelo, então um token de Sonnet o consome a 40% de um token de Opus, e o Fable tem um limite semanal próprio, separado e mais restrito, que nenhum worker toca.
- Também tentei rotear os workers para o DeepSeek através de um Claude Code headless. A preço de lista, o mesmo tráfego custaria $10 em vez de $202 no Sonnet ou $505 no Opus. Em uma assinatura, essa economia não existe, porque a assinatura já estava paga. Eu abandonei a ideia. Se você paga por token, leia essa seção de qualquer forma, porque os números são o ponto.
Este é o terceiro post de uma série. O primeiro mediu o que uma configuração fez com uma janela de contexto, 17% menos tokens , e o segundo explica quanto custa uma janela de contexto e por quê. Este aqui é sobre a outra alavanca: não o tamanho do contexto, mas qual modelo o está segurando.
O que é o padrão
Uma sessão de agente de codificação faz dois tipos de trabalho. Ela pensa: lê o código, descobre o que mudar, decide nomes, assinaturas e casos de borda, verifica o diff. E ela digita: escreve o código, roda o arquivo de teste, corrige o lint. O pensamento é onde um modelo de ponta justifica seu preço. A digitação, não. A maior parte dela é determinada pela decisão que veio antes, e um modelo menor executa um plano já decidido quase tão bem quanto um grande.
Então a skill divide a sessão. O modelo principal é o arquiteto. Ele faz tudo no loop principal, exceto editar um arquivo de código-fonte:
- Interrogar o requisito e explorar o código.
- Tomar as decisões de design: abordagem, fluxo de dados, nomes, assinaturas, casos de borda. O padrão existente mais próximo a espelhar. A menor mudança que corrige a causa raiz.
- Decompor em slices que possuem conjuntos de arquivos disjuntos.
- Escrever um briefing de implementação por slice.
- Revisar o diff que retorna, rodar os gates, fazer o commit.
O worker é um subagente com uma janela de contexto nova. Ele recebe o briefing e nada mais, escreve o código, roda os arquivos de teste que o briefing nomeia e devolve um relatório curto e estruturado. Depois o contexto dele é descartado. Ele nunca passa a fazer parte do histórico da sessão principal, o que importa mais do que parece: tudo o que a sessão principal lê é reenviado em cada chamada seguinte, então um worker que lê doze arquivos e um log de teste no próprio contexto mantém tudo isso fora da conta do arquiteto.
O briefing é o contrato inteiro. O meu tem sete campos e a skill é basicamente sobre preenchê-los bem:
## Briefing de implementação: <slice>
Objetivo: uma frase, resultado observável
Contexto: o que a exploração encontrou: trechos, o padrão a espelhar, âncoras de linha, armadilhas
Arquivos: caminhos a criar/modificar, propriedade exclusiva desta slice
Design: a abordagem decidida: fluxo de dados, nomes, assinaturas, casos de borda
Restrições: regras do projeto que se aplicam: estilo, camadas, segurança
Fora de escopo: o que não tocar, incluindo arquivos de propriedade de outras slices
Verificar: comandos exatos e resultado esperado
Um briefing contém decisões, não opções. Se eu ainda estou pesando duas abordagens, não estou pronto para delegar.
Há uma exceção. A delegação tem um custo fixo: escrever o briefing, a inicialização do worker, ler o relatório, revisar o diff. Uma correção de typo, um valor de configuração, um incremento de versão, apagar uma chave morta, uma correção de uma linha e seu teste de regressão: nesses casos o arquiteto edita diretamente, porque o briefing custaria mais do que a edição. O critério é o custo, não a contagem de linhas. No momento em que a edição exige um julgamento de design ou toca um caminho que o repositório sinaliza como crítico, ela vai para um worker.

Pronto para expandir seu negócio?
Comece seu teste gratuito hoje e veja resultados em dias.
Por que uma assinatura muda a aritmética
Se você paga por token, o caso é simples. O Opus 5 é listado a $5 por milhão de tokens de entrada e $25 por milhão de saída; o Sonnet 5 a $2 e $10. Cada token de implementação que passa do Opus para o Sonnet custa 40% do que custava.
Eu pago uma assinatura, e aí o caso é diferente e, creio, mais forte. O Claude Max tem dois limites semanais, não um: um limite entre todos os modelos, consumido por cada token à taxa daquele modelo, e um limite separado e mais restrito que só o Fable consome. O Opus não tem limite próprio. Isso dá à divisão dois efeitos. O trabalho que um worker Sonnet faz consome o limite compartilhado a 40% da taxa que um worker Opus consumiria, então mover dois terços dos tokens de uma sessão para o Sonnet faz a semana durar mais mesmo que a contagem total de tokens fique inalterada. E quando o arquiteto é o Fable, cada token que ele deixa de gastar digitando é um token que sobra no limite que acaba primeiro. Então, mesmo que o padrão arquiteto gastasse exatamente o mesmo número de tokens que uma sessão simples, quem os gasta ainda decidiria quando a semana termina.
Esse “mesmo que” acabou fazendo muito trabalho.
O que as transcrições dizem
O Claude Code escreve cada sessão em uma transcrição JSONL, e cada execução de worker em um arquivo irmão dentro do diretório da sessão. Tenho todas elas desde 19 de agosto: 324 sessões interativas com três ou mais prompts, das quais 49 usaram o padrão, ou seja, geraram um agente implementador ou enviaram um briefing para um. Os tokens são ponderados da forma como a conta é feita: entrada nova a 1, escritas de cache a 1.25 ou 2, leituras de cache a 0.1. Execuções de CI ficam de fora.
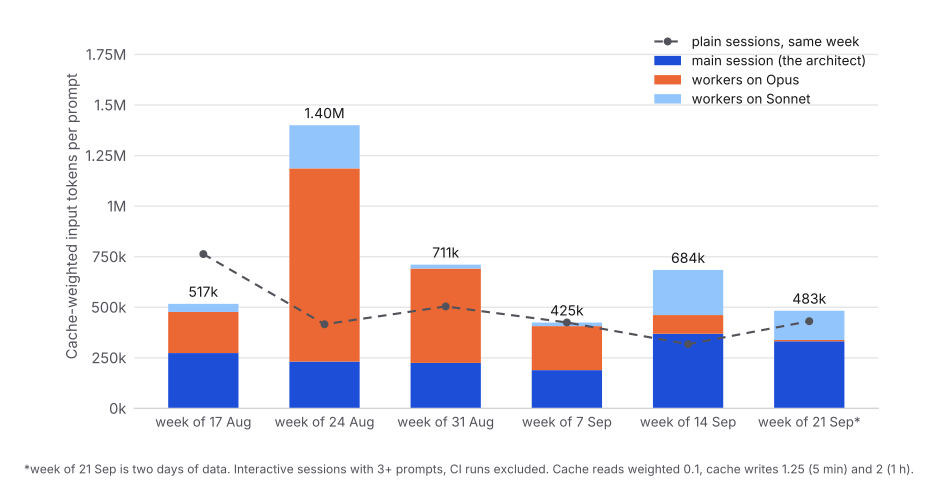
Leia da esquerda para a direita e não é uma história de sucesso nas duas primeiras semanas.
Na semana de 24 de agosto, uma sessão de arquiteto custou 1.40M de tokens ponderados por prompt. Sessões simples na mesma semana custaram 0.42M. Três vezes e meia mais, e quase todo o excesso era laranja: workers Opus. Eu tinha dado aos workers um bom modelo e nenhuma regra, e eles se comportaram como um bom modelo sem regras. A mediana de execução de worker Opus naquela semana foi de 176 turnos. Vários rodaram a suíte de testes completa do backend, o que coloca cerca de 100 KB de saída em um contexto que é reenviado a cada turno seguinte. Uma sessão com seis workers em 14 de setembro, depois de eu já ter começado a apertar as coisas, ainda queimou 245M de tokens de entrada ao longo de 1.585 turnos para produzir cerca de seis mil linhas de diff. O cache de prompt estava funcionando com 91.6% de acerto o tempo todo. A conta era volume, não preço.
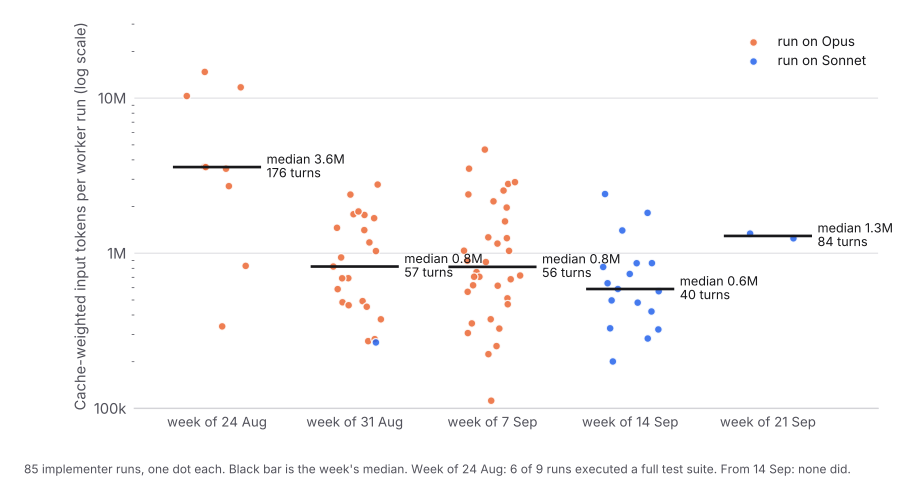
A faixa dos workers mostra onde as regras surtiram efeito. Três delas fizeram a maior parte do trabalho, e eu as escrevi nas definições dos agentes em vez de no briefing, para que valham quer eu me lembre delas ou não:
- Um worker nunca roda uma suíte de teste completa. Ele roda os arquivos de teste que seu briefing nomeia. O arquiteto roda os gates.
maxTurnsé limitado na definição do agente, 140 para o Sonnet e 160 para o Opus. Uma slice que precisa de 250 turnos recebeu um briefing errado.- Uma slice fica abaixo de cerca de doze arquivos, e o briefing abaixo de cerca de 8 KB. O briefing também é reenviado a cada turno.
Na semana de 31 de agosto, a mediana de execução de worker era de 57 turnos e 0.8M de tokens ponderados. A partir de 14 de setembro, quando mudei a rota padrão para o Sonnet, passou a ser 40 turnos e 0.6M, e nenhum worker rodou uma suíte completa desde então.
O total por prompt acompanhou: 711k, 425k, 684k, 483k nas últimas quatro semanas, contra sessões simples em 505k, 425k, 318k, 431k. Sessões de arquiteto agora custam aproximadamente o que custam as sessões simples. Um pouco mais em duas das quatro semanas, um pouco menos em uma. O que elas compram com isso são os dois gráficos seguintes.
Junte-se à nossa newsletter
Receba gratuitamente as últimas dicas, tendências e ofertas.
O modelo principal parou de digitar
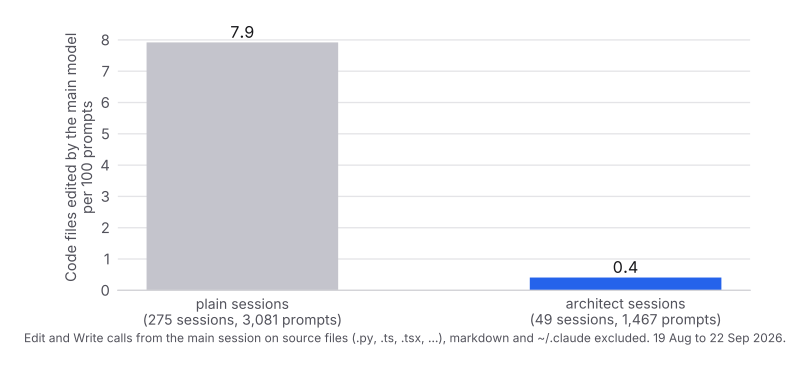
Este é o número que eu queria mudar, e ele mudou. Em sessões simples, o modelo principal fez 244 chamadas de Edit ou Write em arquivos de código-fonte ao longo de 3.081 prompts. Em sessões de arquiteto, fez 6 ao longo de 1.467. As 6 são todas exceções de pequenas edições que consigo justificar.
Enquanto isso, os workers foram produtivos. As 85 execuções de worker fizeram 2.510 edições em arquivos de código-fonte. Contando o loop principal e os workers juntos, uma sessão de arquiteto produziu 2.516 edições de código a partir de 1.467 prompts; as sessões simples produziram 943 a partir de 3.081. Por edição de código, uma sessão de arquiteto gastou 403k tokens ponderados no total e 330k no modelo da família Opus. Uma sessão simples gastou 1.410k e 1.324k. Quero ter cuidado com essa comparação, porque as duas populações não fazem o mesmo trabalho: uma sessão é classificada como arquiteto por delegar código, então sessões de arquiteto são pesadas em codificação por construção, e sessões simples incluem pesquisa, revisões e depuração que nunca editam nada. Leia isso como “o padrão faz muito código ser escrito por token”, não como uma afirmação de eficiência quatro vezes maior.
A afirmação mais limpa é a divisão entre modelos. Desde 14 de setembro, um prompt em uma sessão de arquiteto custa 364k tokens ponderados no loop principal, 205k nos workers Sonnet e 80k nos workers Opus. A fatia dos workers Opus em todos os tokens de worker era de 100% em agosto e de cerca de 4% na semana de 21 de setembro. Em um plano Max, isso é o limite semanal compartilhado sendo consumido à taxa do Sonnet em vez da do Opus por quase todo o trabalho de implementação, e nada disso tocando o limite do Fable.
Duas coisas não melhoraram, e prefiro dizer isso a deixar os gráficos insinuarem o contrário. O contexto da própria sessão principal não encolheu: sessões de arquiteto compactaram 8.7 vezes a cada 100 prompts contra 4.7 das sessões simples, porque o arquiteto lê muito antes de escrever o briefing. E o padrão é mais lento em tempo de relógio em tarefas pequenas, porque a inicialização e o relatório de um worker são minutos que você não paga quando simplesmente faz a edição. A exceção das pequenas edições existe porque a primeira versão da skill não tinha uma, e eu me vi escrevendo um briefing de 3 KB para uma mudança de duas linhas.
O desvio pelo DeepSeek
Depois que os workers passaram a ser Sonnet, a próxima pergunta óbvia era se eles precisavam ser um modelo Claude. De 13 a 18 de setembro, apontei o worker para o DeepSeek V4.1 Flash através de um Claude Code headless com ANTHROPIC_BASE_URL definido para um endpoint compatível, primeiro via OpenRouter e depois nativamente. Mesmo formato de briefing, mesmo formato de relatório, mesmo arquiteto. 2.732 chamadas, 431M de tokens de entrada dos quais 88% eram leituras de cache, 1.7M de tokens de saída.
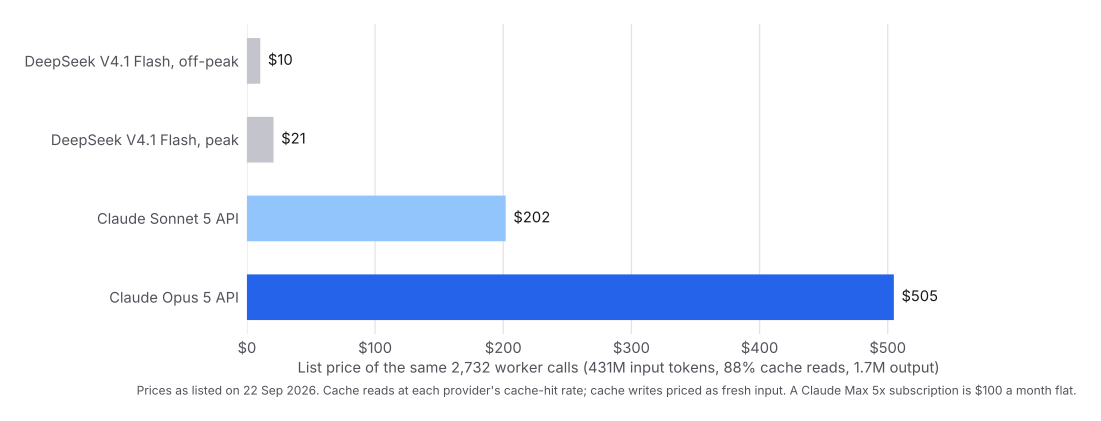
A preços de lista em 22 de setembro, esse tráfego custa cerca de $10 no DeepSeek fora de pico, $21 em pico, $202 na API do Sonnet e $505 na API do Opus. Se eu pagasse por token, esta seria a manchete do post e eu teria mantido a solução.
Eu não pago por token, e esse é o argumento inteiro. Uma assinatura Max custa $100 por mês, quer eu use 30% do limite semanal, quer 100%. Mover o tráfego dos workers para o DeepSeek não reduziu essa conta em um centavo. Adicionou uma segunda conta de $10 a $21 por semana em cima dela, para economizar capacidade em um plano cuja capacidade eu já tinha pago. Eu tinha confundido “mais barato que a API” com “mais barato do que eu pago”, e essas coisas não são a mesma quando o que você paga é fixo. A comparação certa para quem tem assinatura é DeepSeek contra uma segunda assinatura, e aí um segundo plano Claude ou um plano ChatGPT com Codex custa aproximadamente o mesmo que um mês de uso moderado do DeepSeek e vem com seu próprio limite semanal, seu próprio modelo e nenhuma medição para vigiar.
A qualidade foi a outra metade. Cinco slices de backend voltaram limpas e foram commitadas como estavam. Uma slice de frontend removeu um símbolo exportado e deixou todos os seus consumidores intactos, então a árvore não compilou e uma slice posterior teve que limpar isso. Essa é exatamente a falha que um modelo que executa uma especificação tem e que um modelo que infere a forma de um componente a partir de seus irmãos não tem, e a skill agora diz isso: mudanças em superfícies de API compartilhadas vão para o Sonnet, e a regra do worker diz “nunca remover ou renomear um símbolo exportado sem migrar todos os consumidores na mesma execução”. O DeepSeek Flash é um bom executor. O padrão arquiteto precisa de um worker que perceba quando o briefing subestimou os consumidores, e isso é a única coisa que um briefing não pode fornecer.
Então a tabela de roteamento hoje tem duas linhas. Trabalho mecânico, trabalho de backend contra um briefing detalhado com testes a satisfazer, trabalho de frontend que segue uma gramática de design existente, e qualquer mudança em uma superfície de API compartilhada vão para o sonnet-implementer. Trabalho cuja dificuldade está no raciocínio vai para o opus-implementer: uma condição de corrida assíncrona, uma refatoração em vários pontos cuja correção depende de pontos que o briefing não consegue enumerar, uma migração de backfill que nenhum teste isolado comprova. Roteie pela forma, nunca pelo risco. O risco muda quão duramente o diff será revisado e se um humano o assina. Ele nunca muda quem o escreve.
O ciclo de revisão, que é onde o padrão se paga ou não
O relatório de um worker é uma alegação. O ciclo de revisão da skill é curto e cada linha veio de eu ter me queimado:
- Leia o relatório e o
git diffreal. Confira o diffstat que o worker cita contra o que você vê. - Rode novamente a verificação principal você mesmo quando a alegação importa.
- Encontrou um problema? Envie a correção para o mesmo worker. Ele ainda tem o contexto dele e continua de onde parou. Não corrija à mão, não crie um novo worker.
- Duas correções falhas significam que o briefing estava subespecificado, não que o modelo é pequeno demais. Decomponha, coloque o trecho que faltava no Contexto, rode de novo. Não suba para um modelo maior, porque ele vai implementar o mesmo mal-entendido com mais fluência.
- Rode os gates com escopo antes de aceitar qualquer coisa: os testes tocados, o linter nos arquivos tocados, qualquer script de convenção que o repositório carregue.
Nas transcrições, enviei cerca de uma correção por execução de worker, 52 em 85 execuções, e 7 execuções Opus atingiram seu limite de 160 turnos, todas em uma slice que eu hoje dividiria. Esses são os dois números que eu observo. Se as correções por execução sobem, meus briefings estão ficando preguiçosos. Se os workers atingem o limite, minhas slices estão grandes demais.
O que tirar disso
Se você paga por token: coloque o modelo caro nas decisões e na revisão, coloque um barato na implementação, e precifique seu tráfego de worker a preço de lista antes de escolher qual barato usar. O gráfico de quatro barras é o argumento.
Se você paga uma assinatura: o padrão não corta sua contagem de tokens. Ele move os tokens de implementação para o modelo que consome o limite semanal compartilhado mais devagar, guarda o limite do Fable para o trabalho que só o Fable deveria fazer, e impede que seu modelo mais caro gaste seus turnos digitando. Não adicione uma API medida de lado para “economizar” capacidade que você já comprou. Se você ficar sem capacidade de worker, compre uma segunda assinatura.
De qualquer forma, as regras que fizeram isso funcionar foram as entediantes. Nenhuma suíte de teste completa em um worker. Limite os turnos. Slices pequenas, briefings curtos. Corrija o mesmo worker uma vez, depois conserte o briefing.
A skill, as três definições de agente e o hook de guarda estão em github.com/LivinTribunal/architect-skill sob MIT. A skill companheira que diz ao worker como escrever código que combina com o repositório onde ele cai é a grain-skill , e o post sobre ela é código na direção da fibra .
Método
Tudo o que o post descreve está em github.com/LivinTribunal/architect-skill : a própria skill, o modelo de briefing, a tabela de roteamento, as três definições de agente implementador com seus limites de turnos e regras de contexto, e o hook de guarda. Instale e você tem a configuração da qual os números abaixo vieram.
As sessões são transcrições JSONL do Claude Code de 19 de agosto a 22 de setembro de 2026, entrypoint cli, três ou mais prompts de usuário. Uma sessão é classificada como arquiteto se ela gerou opus-implementer, opus-implementer-xhigh ou sonnet-implementer, rodou um worker ds-slice, invocou a skill arquiteto, ou enviou uma mensagem contendo um briefing de implementação para um agente de propósito geral, que é como as primeiras semanas funcionavam antes de existirem os agentes nomeados. As execuções de worker são as transcrições dos subagentes sob o diretório de cada sessão. O uso é deduplicado por id de requisição e ponderado como entrada nova 1, escrita de cache de cinco minutos 1.25, escrita de cache de uma hora 2, leitura de cache 0.1. “Edição de código” é uma chamada de Edit ou Write em um arquivo de código-fonte .py, .ts, .tsx, .js, .sql ou similar, excluindo markdown e qualquer coisa sob ~/.claude. Os preços do DeepSeek são o preço de lista nativo em 22 de setembro de 2026, fora de pico e em pico, com leituras de cache à taxa de acerto de cache e escritas de cache precificadas como entrada nova; os preços da API Claude são os preços de lista publicados do Opus 5 e do Sonnet 5, com leituras de cache a um décimo da entrada. A semana de 21 de setembro tem dois dias de dados.
