


A versão curta
- Peguei uma issue real do backlog da FlowHunt e fiz o Claude Code implementá-la 13 vezes no Opus 5.5, sob sete configurações diferentes de instruções. Cada execução partiu do mesmo commit, em seu próprio clone com seu próprio banco de dados, e passou pelo nosso CI real no GitHub. Duas revisões cegas do Opus avaliaram cada resultado.
- O CLAUDE.md de 33 KB do repositório não comprou qualidade mensurável. As execuções com ele tiveram 2.0 achados bloqueadores e graves por revisão. Uma execução sem nenhum arquivo de instruções teve os mesmos 2.0. Um arquivo de 5.5 KB teve 1.0.
- Uma etapa de planejamento separada piorou as coisas. As duas configurações que rodaram um prompt de planejamento e depois um prompt de implementação custaram mais do que suas gêmeas com prompt simples, e produziram quatro dos cinco bloqueadores em todas as 26 revisões.
- A vencedora foi um CLAUDE.md de 8 KB, três skills, workers Sonnet e um prompt simples. Suas duas execuções custaram em média $6.68 a preço de tabela da API. A configuração completa com os prompts do pipeline custou em média $11.49, cerca de 1.7 vez mais, e teve mais achados.
- O que sobreviveu de toda a estrutura que eu havia construído foi o briefing: uma descrição curta e já decidida de uma fatia de trabalho que o modelo principal escreve para um worker mais barato. Planos para o próprio modelo principal não compensaram. O modelo planeja bem sozinho.
Este texto dá sequência ao post sobre o padrão arquiteto , que mediu quem deveria digitar o código. Este aqui pergunta quanto o modelo principal precisa que lhe digam antes de começar.
Por que eu fiz isso
Nosso monorepo havia acumulado muitas instruções para agentes. O CLAUDE.md raiz tinha 33 KB: comandos de build, cadência de testes, estilo de código, arquitetura, caminhos críticos, regras de segurança, regras de permissão e de créditos, as duas superfícies de agente, abertura de issues, convenções de PR. Dez skills ficavam em .claude/skills/. Além disso, nosso pipeline de CI (chamamos de harnext) passava uma issue por um tagueador, uma etapa de triagem, uma etapa de planejamento que escrevia um plano como comentário na issue, e uma etapa de implementação que lia o plano de volta e escrevia o código, cada uma com seu próprio system prompt longo.
Cada linha disso foi adicionada por um motivo, geralmente depois que um agente errou algo. A pergunta que ninguém havia feito era se aquilo ainda ajudava. Um CLAUDE.md é carregado em toda sessão e reenviado a cada turno. Se o modelo fosse fazer a coisa certa de qualquer forma, esses tokens são um imposto e, como explica o texto sobre quanto custa uma janela de contexto , um imposto sobre cada turno se acumula mais rápido do que parece.

Pronto para expandir seu negócio?
Comece seu teste gratuito hoje e veja resultados em dias.
O teste
A issue era uma sequência de e-mails temporizada para novos cadastros: um admin define passos como “dia 0: boas-vindas” e “dia 5: seu teste termina em breve”, e uma tarefa em segundo plano envia e-mail para cada conta no dia certo, para quando a pessoa assina um plano pago e ignora contas criadas antes do lançamento. Isso exige uma migração, um repositório, um serviço, uma tarefa do Celery beat, endpoints REST, ferramentas MCP para agentes e uma interface de console em 11 idiomas. É uma feature realista de primeira semana, e tem vários casos extremos fáceis de deixar passar.
Cada execução era uma sessão headless do Claude Code no Opus 5.5, em sandbox com seu próprio clone e banco de dados, com um script que enviava seu commit para um PR em rascunho e devolvia o resultado do CI para a sessão, por até três rodadas. O custo é o total_cost_usd do próprio Claude Code para a sessão principal mais cada subagente, a preço de tabela da API. Eu pago uma assinatura, então isso é uma medida de trabalho, não da minha fatura.
As sete configurações:
| Configuração | Execuções | |
|---|---|---|
| A | CLAUDE.md completo de 33 KB e dez skills, prompts do pipeline (planejar, depois implementar) | 2 |
| B | CLAUDE.md e skills completos, prompt simples | 3 |
| C | Sem CLAUDE.md, sem skills, prompt simples | 2 |
| D | CLAUDE.md completo mais a skill architect, prompt simples | 2 |
| E | CLAUDE.md de 8 KB, architect, grain-ponytail e unslop, prompts do pipeline | 1 |
| F | CLAUDE.md de 5.5 KB, sem skills, prompt simples | 1 |
| G | CLAUDE.md de 8 KB, architect, grain-ponytail e unslop, prompt simples | 2 |
A a D vieram primeiro. E a G foram construídas a partir do que elas mostraram, e a terceira execução de B rodou ao lado delas como controle. O arquivo de 8 KB é o de 5.5 KB mais uma lista curta das skills e de quando carregá-las, e as regras de roteamento de modelo que fazem a skill architect delegar para o Sonnet.
Cada resultado foi então para dois revisores Opus, que viram apenas uma letra, o diff, o repositório e a issue. Eles listaram toda mudança que pediriam antes de aprovar, classificaram como bloqueador, grave, menor ou detalhe, e verificaram cada critério de aceitação contra um arquivo e uma linha.
Custo
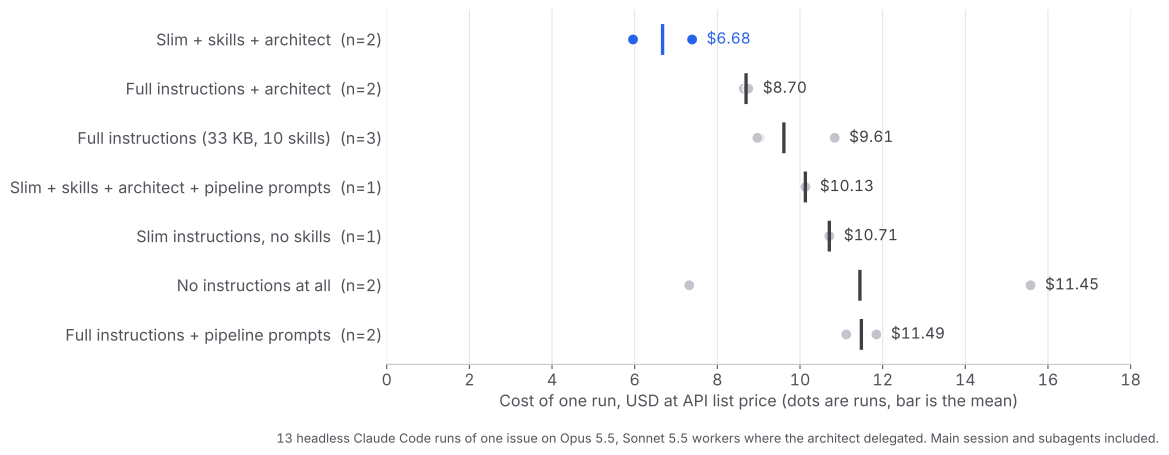
A configuração vencedora, G, custou $5.96 e $7.39. A configuração completa com prompts do pipeline, A, custou $11.12 e $11.85. A diferença está principalmente nos turnos e no que cada turno carrega. As sessões principais de A rodaram 172 e 144 turnos no Opus, com 24 a 28 milhões de tokens de entrada. As de G rodaram 79 e 95 turnos, com 13 a 16 milhões, e repassaram cerca de 60 turnos a mais para workers Sonnet, que custam uma fração da tarifa. G também terminou seu trabalho em cerca de 21 minutos, contra 45 de A.
Duas coisas nesse gráfico me surpreenderam. Não ter instrução alguma não é a opção barata: suas duas execuções custaram $7.32 e $15.58, e a mais cara também falhou no CI e escreveu o maior diff do teste. E o arquivo de 5.5 KB sem skills, F, não foi mais barato que a configuração completa. Ele escreveu mais código, 1,601 linhas de produto, e pagou por isso. A economia em G não vem só do arquivo curto. Ela vem do arquivo curto mais as duas skills que mudam como o trabalho é feito.
Junte-se à nossa newsletter
Receba gratuitamente as últimas dicas, tendências e ofertas.
Qualidade
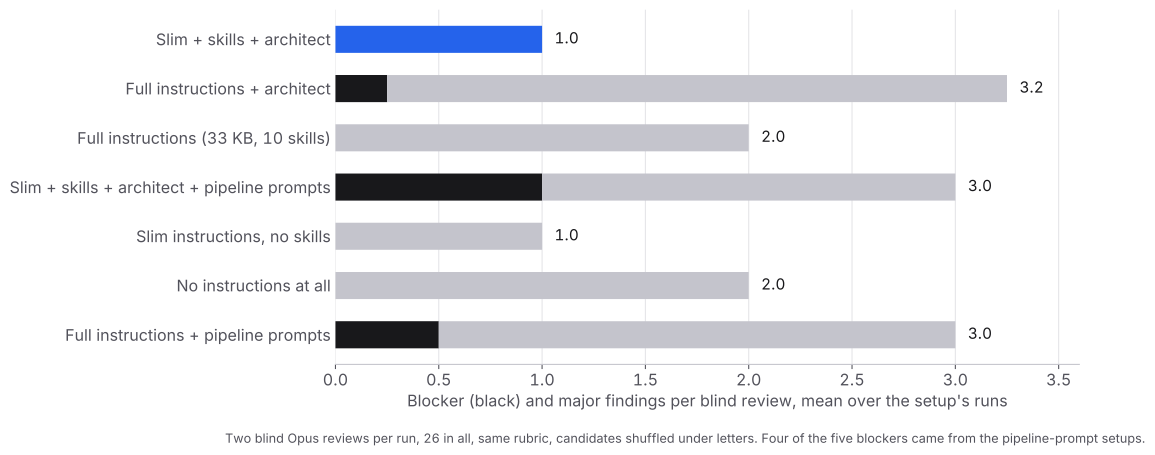
A configuração mais barata também teve o menor número de achados sérios: nenhum bloqueador, e 1.5 e 0.5 achados graves por revisão em suas duas execuções. O CLAUDE.md completo, B, ficou em 2.0 graves nas suas três execuções, o mesmo que nenhum CLAUDE.md.
Este é o resultado que mais me importa. O arquivo tem longas seções sobre segurança, permissões e créditos, escritas porque um agente uma vez as ignorou. Com ou sem o arquivo, os revisores encontraram o mesmo número de problemas sérios, e os mesmos tipos voltaram em todas as configurações: um cadastro que paga e depois cancela, um e-mail perdido ou enviado duas vezes quando um worker falha no meio, um editor que sobrescreve conteúdo que não consegue exibir. São lacunas de raciocínio sobre estado ao longo do tempo. Nenhuma lista de regras no CLAUDE.md cobria isso, porque você não pode escrever uma regra para um caso extremo em que ainda não pensou.
O que cobriu isso foi uma mudança na skill architect entre as rodadas. Antes de o modelo principal escrever qualquer briefing, ele agora escreve uma tabela: cada critério de aceitação, o que acontece quando o estado do qual ele depende muda ao longo do tempo, e o comportamento decidido. Cada linha então entra no briefing com um teste nomeado. As execuções de G escreveram 774 e 818 linhas de teste, contra 510 a 670 de B.
A etapa de planejamento
A e E são as duas configurações que rodaram os prompts do nosso pipeline de CI: um prompt de planejamento que escreve um plano, e depois um prompt de implementação que lê o plano e o executa. Compare cada uma com sua gêmea que recebeu um prompt simples. A custou $11.49 por execução, contra $9.61 de B, e teve bloqueadores onde B não teve nenhum. E custou $10.13, contra $6.68 de G, e teve um bloqueador em cada uma de suas revisões, onde G não teve nenhum.
Acho que a razão é que um plano é um documento que o modelo escreve para si mesmo e depois precisa reler como uma instrução externa. A segunda sessão trata o plano como uma especificação, segue-o onde ele está errado e gasta turnos conciliando-o com o que encontra no código. Um modelo com essa capacidade planeja melhor dentro da própria sessão que está prestes a fazer o trabalho, onde o plano e o código estão no mesmo contexto.
A parte do planejamento que sobreviveu é o briefing. Quando o modelo principal entrega uma fatia a um worker Sonnet, o worker começa com um contexto vazio e constrói exatamente o que lhe dizem. Essa passagem de bastão precisa de uma descrição escrita e já decidida: o objetivo, os arquivos, o padrão a espelhar, os casos extremos, o teste a escrever. Um plano para si mesmo é custo indireto. Um briefing para outra pessoa é a única forma de o trabalho chegar lá.
O que a grain-ponytail fez
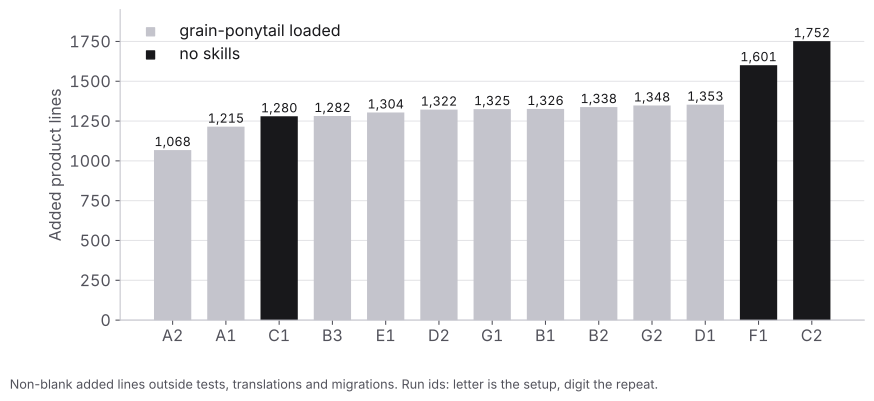
A skill do post código a favor da fibra diz ao modelo para espelhar o exemplo existente mais próximo e entregar o mínimo de código que funcione. Toda execução que a tinha carregada escreveu entre 1,068 e 1,353 linhas de produto. Os dois maiores diffs, 1,601 e 1,752, vieram de execuções sem skills. Uma execução sem skills ficou em 1,280, então a skill não decide o tamanho sozinha, mas removeu a cauda.
É também o caso mais claro de que tipo de instrução ainda compensa. “Espelhe o exemplo mais próximo” muda o que o modelo faz em cada arquivo que escreve. “Use snake_case para funções” apenas repete algo que ele já faz.
O que as revisões ainda pegaram
A execução vencedora não estava limpa. Depois do teste, fiz rebase do trabalho de G2 sobre a main e o passei pela nossa verificação completa de PR, que revisa o diff, prova cada achado com um teste que falha e conduz a mudança em um navegador real. Ela descobriu que o editor de passos descartava todos os blocos, exceto o primeiro de HTML, quando um admin editava um passo criado via MCP, e que uma liberação de claim malsucedida podia enviar e-mail duas vezes para alguns usuários. Ambos foram corrigidos, com testes, antes de o PR ir para revisão humana.
Os revisores cegos também sinalizaram mais over-engineering nas execuções com architect do que nas com instruções completas: 2.5 itens por revisão em G, contra 0 a 1.0 nas execuções de A e B. Menos achados sérios, mais detalhes. Eu aceitaria essa troca, mas é uma troca.
O que eu mudei
- O CLAUDE.md de 33 KB virou um AGENTS.md de 12 KB que o Codex também lê, e o CLAUDE.md agora apenas o importa. Ele mantém os comandos, a cadência de testes, a arquitetura e as regras que um modelo não consegue inferir do código, como quais caminhos são críticos e que as duas superfícies de agente devem andar em sincronia.
- A etapa de planejamento saiu do pipeline. A triagem entrega a issue direto para uma etapa de implementação cujo prompt encolheu para seis passos: ler a issue, criar a branch, carregar as skills architect e grain-ponytail, testar, fazer commit, abrir um PR em rascunho.
- A skill architect ganhou a tabela de casos extremos, um campo Tests no briefing e uma passada final que confere o diff inteiro contra a issue, e não contra os briefings. Essa versão é pública em github.com/LivinTribunal/architect-skill .
A mudança no repositório está em revisão no momento em que escrevo.
O que tirar disso
Se o seu CLAUDE.md cresceu um incidente por vez, ele provavelmente está pagando por regras que o modelo já segue. Corte-o até ficar apenas com o que o modelo não consegue descobrir lendo o código, e meça antes e depois em uma tarefa real, em vez de confiar que mais orientação é mais seguro.
Mantenha as instruções que mudam como o trabalho é feito: quem digita o código, como uma fatia é briefada, qual padrão existente copiar. Abandone o pipeline de planejar e depois executar se o seu modelo principal é um modelo de fronteira atual. Escreva briefings para workers, não planos para você mesmo.
Método
13 execuções headless do Claude Code 2.1.289 em 5 de outubro de 2026, modelo principal Opus 5.5, workers Sonnet 5.5 onde a skill architect delegava. Todas as execuções partiram de um commit do monorepo da FlowHunt, cada uma em um clone APFS com seu próprio banco Postgres, isolada em sandbox das outras execuções e dos próprios arquivos do experimento. Um broker enviava o commit de cada execução para um PR em rascunho contra uma branch base congelada e retomava a sessão com o resultado do CI, por até três rodadas. O custo é o total_cost_usd máximo por sessão, somado entre a sessão principal e seus subagentes. Linhas de produto são linhas adicionadas não vazias fora de testes, traduções e migrações.
Cada resultado recebeu duas revisões cegas do Opus com uma única rubrica: correção, critérios de aceitação, grain, campos privados e estado oculto, over-engineering, segurança e permissões, testes, migrações. Os candidatos foram embaralhados sob letras, e os revisores podiam ler o repositório, mas não executar nada. Os achados por revisão são a média das execuções de uma configuração. Com uma a três execuções por configuração, trate a média de uma configuração isolada como ruidosa. As conclusões acima são as que se mantiveram nas duas rodadas.
