


A versão curta
- Os agentes de código de IA são bons a adicionar código e maus a notar que o código já existe. Deixados sozinhos, dão a um repositório um segundo helper por cada primeiro, e cada leitor tem de verificar ambos para confiar em qualquer um.
- A solução são dois hábitos escritos para que um agente os siga. Fibra: encontrar o exemplo existente mais próximo do mesmo tipo de coisa e espelhar a sua forma, lugar e nomes. Cauda de cavalo: subir uma escada desde “isto precisa de existir” até “o mínimo que funciona” e parar no primeiro degrau que aguenta.
- Ambos são agora uma skill pública, licenciada MIT: grain-skill no GitHub . Tem as regras de autoria, uma passagem de revisão com tags fixas, e a forma da linha de fecho que faz o agente nomear o que espelhou.
- No nosso repositório principal desde agosto: 386 issues e pull requests carregam um comentário de plano que nomeia o exemplar a espelhar, ao longo de 1.333 commits numa árvore de cerca de 18.000 ficheiros. 35 sítios no código carregam um comentário
ponytail:que nomeia uma simplificação deliberada e o seu caminho de upgrade. - A descoberta incómoda: o agente invocou a skill como skill zero vezes. As regras funcionaram porque também as coloquei no CLAUDE.md do projeto, nas definições dos agentes workers e na checklist de revisão. Coloque a regra onde o agente já lê.
Já escrevi sobre isto uma vez e não gostei do resultado, porque descrevia o princípio e não o mecanismo. Esta é a versão com o mecanismo.
A falha para que isto serve
Três exemplos do nosso backend, todos reais, todos de pull requests escritos por agentes que passaram os seus testes.
Uma nova rota REST que ia buscar o serviço de aplicação diretamente a uma factory. Todas as rotas irmãs no repositório vão de rota para controller, para serviço, para repositório, com cada salto injetado. Esta colapsou a cadeia em rota para serviço. Funcionou. Também significou que o único sítio onde a validação de pedidos e a formatação de respostas vivem para essa funcionalidade não existia, e o próximo agente a mexer na funcionalidade tinha duas formas para escolher.
Um serviço demasiado grande dividido em _payloads.py, _protocol.py e _tokens.py, cada um um módulo de async defs soltos, com o serviço a chamar protocol.discover(...) por import. A verificação de comprimento de ficheiro ficou verde. A coisa que a injeção de dependências existe para prevenir voltou logo: um colaborador escolhido no momento do import, não substituível sem fazer patch ao módulo, ausente do construtor que documenta de que depende o serviço.
Um segundo normalizer. Já existia um. O agente não o encontrou, escreveu outros oito linhas que faziam quase o mesmo, e agora duas funções com comportamentos diferentes em casos-limite reivindicam ambas canonicalizar o mesmo campo.
Nenhum destes é um bug no sentido em que um teste o apanha. Cada um é um agente a escolher o código que conseguia gerar em vez do código que existia. Faça isso ao longo de algumas centenas de pull requests e o repositório deixa de ter uma forma.

Pronto para expandir seu negócio?
Comece seu teste gratuito hoje e veja resultados em dias.
Fibra
O código novo deve ser indistinguível do código à sua volta. A skill transforma essa frase em cinco passos que um agente dá antes de escrever.
Encontre o exemplar primeiro. Para um endpoint, serviço, repositório, query hook, store slice ou componente, localize o mais próximo que existe e copie a sua forma, localização de ficheiro e nomenclatura. Não invente estrutura quando existe um padrão. No nosso repositório, o slice branding é o exemplar nomeado para o backend porque é pequeno, limpo e atravessa todas as camadas, e a tabela da skill diz, para cada tipo de artefacto, que ficheiro abrir e o que espelhar.
Respeite as camadas. A apresentação chama a aplicação, que chama o domínio, e a infraestrutura implementa o domínio. Um novo import que atravesse essas linhas falha a verificação de arquitetura. Leia o documento das camadas, não o rederive.
Fibra local contra fibra do repositório. Combine com as suas irmãs. Mas se as irmãs elas próprias divergirem da cadeia canónica, siga a cadeia canónica e note a divergência em vez de copiar o desvio. “Combina com as outras cinco rotas deste ficheiro” não chega se as seis ignorarem uma camada que o slice canónico usa. Comparou de forma demasiado local.
Reutilize o helper canónico. Se um helper, tipo ou padrão já vive no repositório, use-o. Dois normalizers obrigam cada leitor a comparar ambos.
Os nomes carregam significado. Reutilize o vocabulário que já existe no código. Um novo nome para um conceito existente é um bug à espera de um leitor.
O teste no fim é o que dou aos revisores: se consegue perceber quais linhas o agente escreveu puramente pela sua forma, ele lutou contra a fibra.
Cauda de cavalo (ponytail)
Preguiçoso significa eficiente, não descuidado. O melhor código é o código que nunca se escreve. Compreenda o problema por completo primeiro, cada ficheiro que a mudança toca, o fluxo real ponta a ponta, e só depois suba esta escada e pare no primeiro degrau que aguenta.
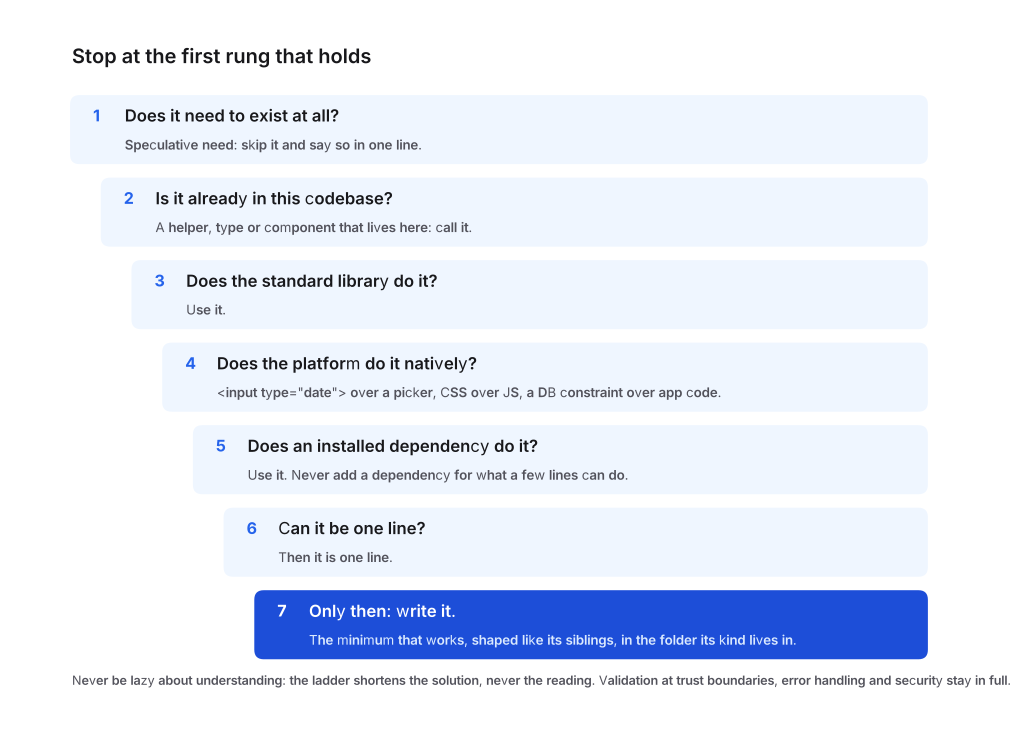
Duas regras viajam com a escada.
Uma correção de bug é uma causa-raiz, não um sintoma. Um ticket nomeia um sintoma. Faça grep a todos os chamadores da função que está prestes a tocar. Uma guarda na função partilhada é um diff mais pequeno do que uma guarda em cada chamador, e corrigir apenas o caminho que o ticket nomeia deixa os chamadores irmãos avariados.
Mantenha o diff mínimo. O diff é o que a revisão lê. Sem refactorings de passagem, sem renomeações, sem reformatação, sem melhorias de “já que estou aqui”, sem tocar em ficheiros que a tarefa não exigia. Cada uma enterra a mudança real. Se o diff é maior do que o problema, corte-o. As melhorias que detetou são um issue de seguimento, não commits extra neste branch.
E os limites, porque “preguiçoso” é a palavra com maior probabilidade de ser mal interpretada. Nunca simplifique eliminando validação de input numa fronteira de confiança, tratamento de erros que previne perda de dados, segurança, bases de acessibilidade, ou qualquer coisa que o utilizador pediu. Nunca seja preguiçoso a compreender: a escada encurta a solução, nunca a leitura. Um diff pequeno no sítio errado é um segundo bug. Lógica não trivial deixa atrás de si uma verificação executável, a coisa mais pequena que falha se a lógica se quebrar.
Quando o agente toma um degrau de propósito e conhece o teto, di-lo no código:
# ponytail: global lock, per-account locks if throughput matters
Há 35 desses no nosso repositório agora. Cada um é uma decisão que um leitor futuro teria de outra forma de reconstruir, e um marcador de onde olhar quando o teto for atingido.
Junte-se à nossa newsletter
Receba gratuitamente as últimas dicas, tendências e ofertas.
Fazer um agente fazê-lo de facto
Um princípio num documento não é um comportamento. Três mecanismos fizeram destes dois comportamentos, e eu ordená-los-ia nesta ordem.
O briefing carrega o exemplar. Em o padrão arquiteto o modelo principal escreve um briefing para um worker, e o campo Design do briefing nomeia o padrão existente mais próximo a espelhar e a mudança mínima de causa-raiz. O worker não tem de encontrar a fibra. Ela é-lhe entregue. Em todo o nosso repositório é isso que os 491 comentários de plano em 386 issues e pull requests são: um passo de planeamento que nomeia o que espelhar antes de alguém escrever.
O agente fecha com o que espelhou. O relatório de cada implementador termina com uma linha, mirrored: <path>, ou nomeia o novo padrão e porque nenhuma irmã servia. Isto é barato e é o melhor auxiliar de revisão que já adicionei. Uma linha mirrored: a apontar para o tipo errado de ficheiro diz-lhe que o diff está errado antes de o abrir. Uma linha em falta diz-lhe que o agente não olhou.
A revisão impõe a mesma fasquia, numa ordem fixa. A nossa skill de revisão tem duas passagens com tags fixas, e são as tags que tornam as conclusões comparáveis entre revisores e entre agentes.
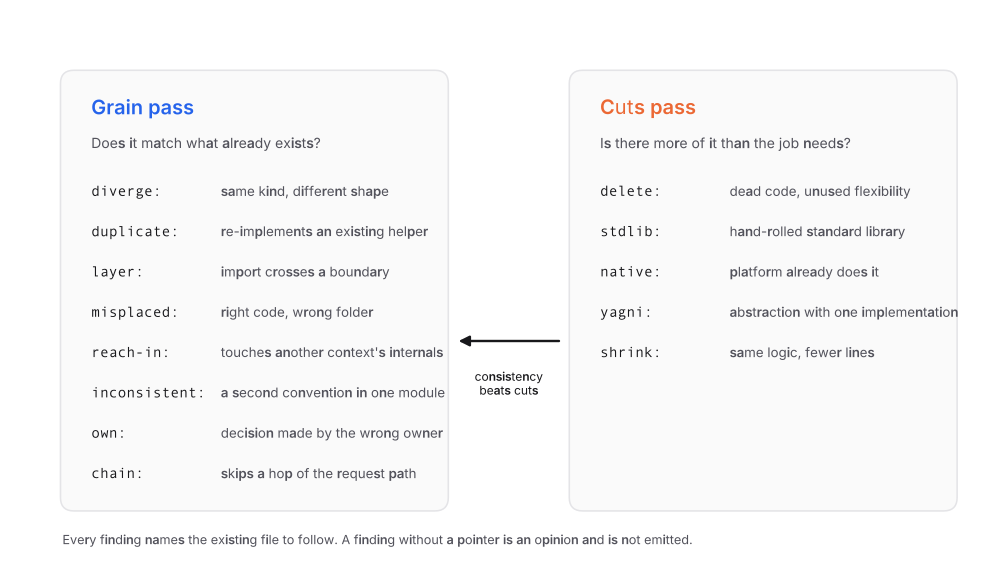
Estrutura primeiro. Isto diverge do exemplar mais próximo, duplica um helper existente, atravessa uma camada, está no sítio errado, mexe nas entranhas internas de outro módulo, usa nomes inconsistentes, assume a propriedade de algo que devia injetar, ou quebra a cadeia de chamadas canónica? Depois os cortes. O que poderia ser eliminado, substituído pela biblioteca padrão, substituído por uma funcionalidade nativa, descartado por ser especulativo, ou encolhido?
A ordem é uma regra, não uma preferência. Consistência vale mais do que cortes. Um corte que deixa o código a divergir das suas irmãs não é uma vitória, porque o leitor tem agora de aprender duas formas para poupar oito linhas. Corra a estrutura primeiro e a passagem de cortes só toca em código que já corresponde.
O que aconteceu no repositório, incluindo a parte que não funcionou
Desde 1 de agosto o nosso repositório principal recebeu 1.333 commits, a maioria escritos por agentes sob revisão. 386 dos issues e pull requests desse período carregam um comentário de plano que nomeia o exemplar a espelhar, 491 desses comentários no total. A cadeia canónica é a forma predefinida de um novo endpoint, e as duas rotas legacy que ignoram o controller estão listadas no documento como uma divergência a ser retirada, não como um segundo estilo.
Os 35 comentários ponytail: são um número mais pequeno do que eu esperava e penso que está certo. A maioria das simplificações não vale um comentário. As que valem são as que têm um teto.
Agora a parte que preferia não relatar. Lancei a fibra e a cauda de cavalo como uma skill do Claude Code: uma descrição no índice de skills, um corpo que carrega a pedido, e uma linha no CLAUDE.md a dizer para a invocar antes de escrever código. Ao longo de cinco semanas de transcrições o agente invocou-a pelo nome zero vezes. A linha de fecho mirrored: apareceu em sete respostas.
As regras ainda assim assentaram. Assentaram porque o mesmo texto estava também em três sítios que o agente lê sem escolher: o CLAUDE.md do projeto, que está em contexto desde o primeiro turno; as definições dos agentes workers, que dizem “espelha a forma, localização e nomenclatura do exemplo existente mais próximo” e “recorre à solução mais preguiçosa que realmente funciona” como regras, não como uma skill a considerar; e a checklist de revisão, cujas tags chumbam um pull request que as ignore. O corpo da skill tornou-se a referência canónica para onde esses três apontam. Como gatilho, não fez nada.
Então a lição que passaria a quem está a empacotar convenções para um agente é esta. Uma skill é um bom sítio para a versão longa de uma regra. É um mau sítio para a regra em si, porque o agente tem de decidir carregá-la e na maior parte das vezes não o fará. Coloque a versão de um parágrafo no ficheiro que está sempre em contexto, coloque a versão imperativa na definição do agente que escreve o código, e coloque a verificação na revisão que faz o gating do merge. Depois aponte os três para a skill para o detalhe.
A versão pública em github.com/LivinTribunal/grain-skill está organizada dessa forma: um SKILL.md curto com as regras que um agente consegue guardar na cabeça, o documento completo com a escada e os anti-padrões, as tags de revisão, e um README que diz qual parágrafo vai para o seu CLAUDE.md e qual vai para a definição do seu implementador. Substitua o exemplo trabalhado pelo seu próprio exemplar canónico e está feito.
