


A Versão Curta
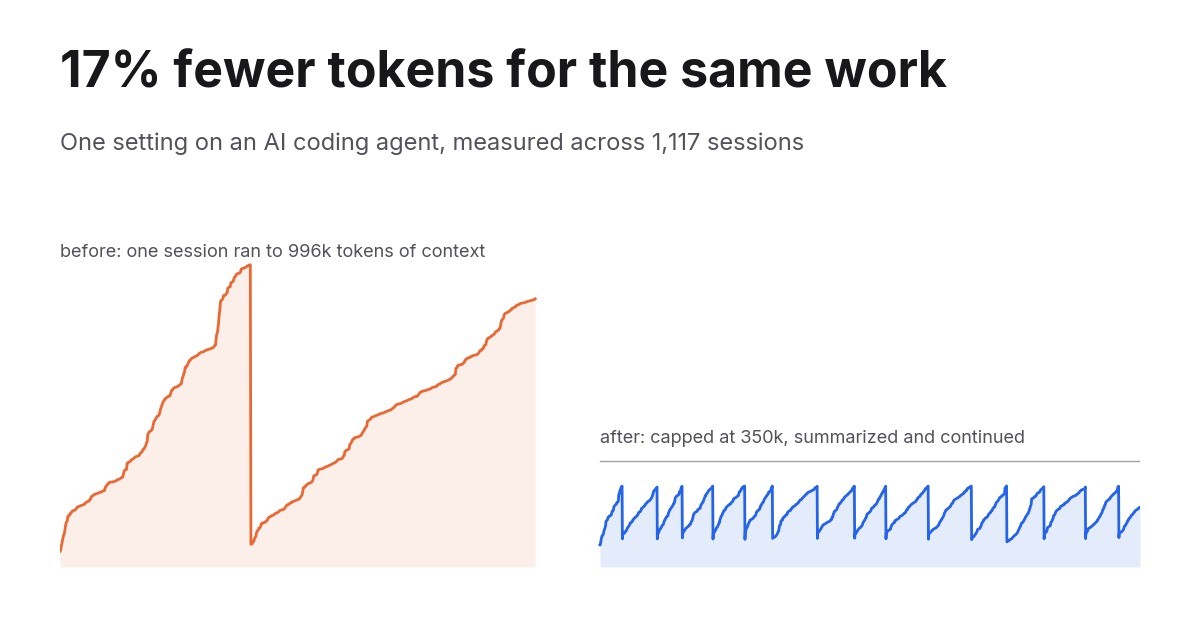
- Eu rodo um agente de codificação com IA o dia inteiro em um modelo com janela de contexto de 1M tokens. As sessões costumavam crescer até quase preenchê-la.
- Adicionei uma linha à configuração dele, limitando uma sessão a 350.000 tokens de contexto antes que ela se resuma e continue.
- Medido em 1.117 transcrições de sessões: 17% menos tokens para o mesmo número de prompts e, nas sessões longas em que o limite realmente faz efeito, 55% menos.
Abaixo estão o método, todos os gráficos e o que isso custa em troca, para você decidir se se aplica à sua configuração.
Por Que uma Janela de 1M Custa Mais do Que Parece
Uma conversa com um modelo não tem estado. Cada requisição carrega todo o histórico: o prompt de sistema, cada definição de ferramenta, cada arquivo que o agente leu, cada resultado de ferramenta, cada mensagem. Não um delta. Tudo, todas as vezes.
Então uma sessão que chegou a 900.000 tokens paga por 900.000 tokens de entrada na chamada seguinte e na próxima depois dessa. O turno 400 não faz mais trabalho do que o turno 4. Simplesmente custa muitas vezes mais.
O cache de prompt suaviza isso. Tokens que o modelo já viu são cobrados a cerca de um décimo do preço normal de entrada. Esse desconto é real, é o que torna as sessões longas viáveis e é também por isso que ninguém olha para o problema. Nos meus dados, 98% de todos os tokens de entrada eram leituras de cache. Um décimo de um número muito grande ainda era a maior linha da fatura.
A questão não é se o seu histórico está em cache. É o tamanho que ele pode atingir antes que algo o reinicie.

Pronto para expandir seu negócio?
Comece seu teste gratuito hoje e veja resultados em dias.
O Que Eu Mudei
O agente é o Claude Code rodando Opus na janela de contexto de 1M. A configuração é autoCompactWindow em ~/.claude/settings.json. Quando uma sessão atinge esse número de tokens, o agente resume a conversa e continua a partir do resumo.
{
  "autoCompactWindow": 350000
}
Eu nunca a havia definido, então as sessões rodavam até se aproximarem da janela completa. Ao longo de quatro dias, testei três valores:
| Data | Configuração |
|---|---|
| 14 de setembro | 250.000 |
| 15 de setembro | 300.000 |
| 18 de setembro | 350.000 |
Como Eu Medi
O Claude Code grava cada sessão em uma transcrição JSONL em ~/.claude/projects/, incluindo o uso de tokens de cada chamada de API. Eu analisei todas as 1.117, cobrindo cinco semanas de 19 de agosto a 22 de setembro, removi duplicatas pelo ID da requisição e mantive apenas sessões interativas. Execuções no GitHub Actions usam a mesma conta, mas não podem ser afetadas por uma configuração no meu laptop, então ficaram de fora.
Totais brutos de tokens enganam por si só. Uma semana movimentada supera uma semana tranquila, não importa o que você mude. Então cada número abaixo é ponderado por cache, que é o que o medidor de fato lê: entrada nova a 1x, gravações de cache a 1,25x (cache de 5 minutos) ou 2x (cache de 1 hora), leituras de cache a 0,1x. E toda comparação é normalizada pelo trabalho realizado, seja os prompts que digitei, seja as chamadas de API que o agente fez.
Junte-se à nossa newsletter
Receba gratuitamente as últimas dicas, tendências e ofertas.
Duas Sessões, o Mesmo Agente
Este é o mecanismo em uma única imagem. À esquerda, uma sessão real de 3 de setembro, antes do limite. À direita, uma sessão real de 15 de setembro, depois dele.
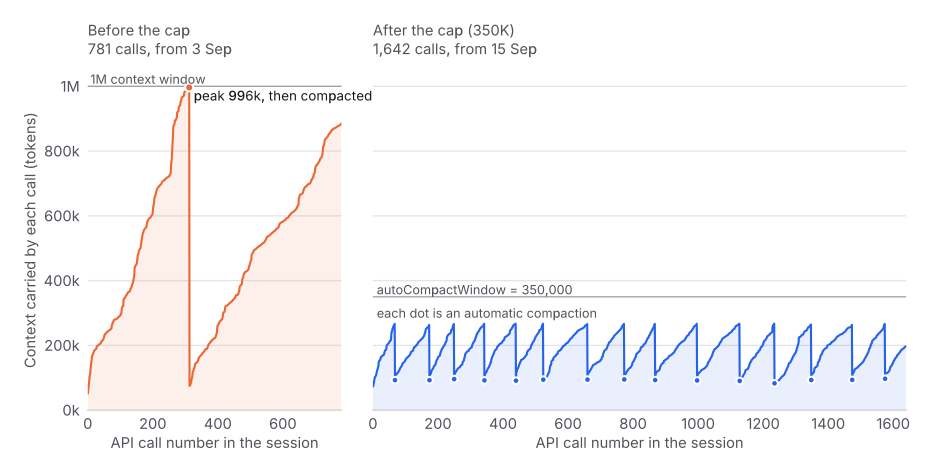
A sessão da esquerda durou 781 chamadas. Ela subiu até 996.000 tokens de contexto, bateu na parede da janela de 1M, compactou uma vez e depois voltou direto para 880.000. Na segunda metade daquela sessão, cada chamada relia mais de meio milhão de tokens.
A sessão da direita durou 1.642 chamadas, mais que o dobro, e nunca carregou mais de 270.000. Ela compactou quinze vezes. Cada compactação é um ponto.
Os Números Semanais
Apenas sessões interativas. As barras são tokens de entrada ponderados por cache por chamada de API, que é o número único mais justo porque não se importa com o quanto eu trabalhei em uma dada semana.
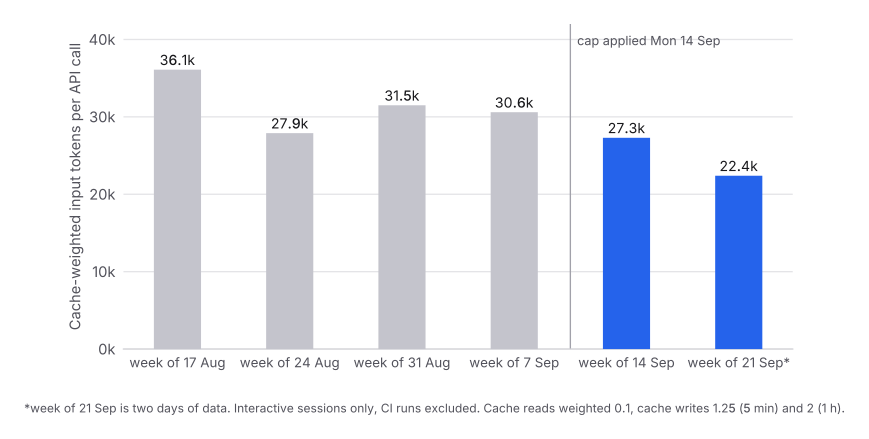
A comparação mais limpa do conjunto de dados é a semana de 7 de setembro contra a semana de 14 de setembro, porque não fui eu que as escolhi. Elas simplesmente caíram uma de cada lado da mudança, e eu digitei quase exatamente o mesmo número de prompts em cada uma.
| Semana de | Prompts | Chamadas de API | Entrada ponderada por cache | Por chamada |
|---|---|---|---|---|
| 7 de set | 971 | 11.364 | 348,1M | 30,6k |
| 14 de set | 968 | 10.555 | 288,5M | 27,3k |
971 prompts contra 968. Entrada efetiva caiu de 348,1M para 288,5M. Isso é 17% menos para a mesma quantidade de prompts. Os dois dias da semana seguinte ficaram em 22,4k por chamada, ainda mais baixo.
Para Onde o Dinheiro Estava Indo
Divida cada chamada de API pela quantidade de contexto que ela carregava, e o mecanismo fica visível diretamente.
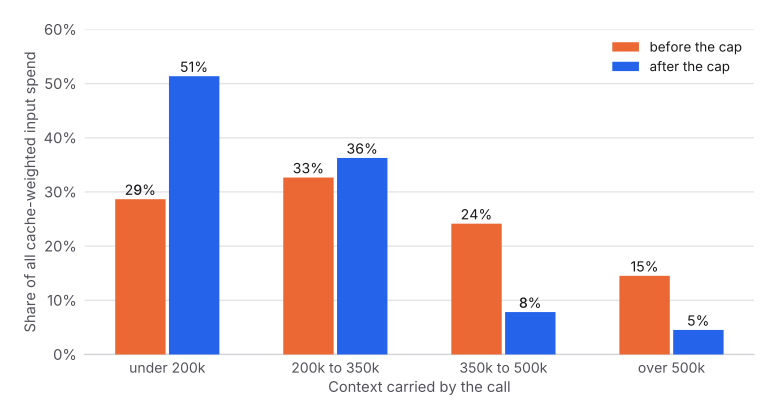
Antes do limite, 39% de tudo o que gastei foi para chamadas arrastando mais de 350.000 tokens de histórico atrás de si. Essas chamadas não faziam mais trabalho do que as outras. Era o mesmo trabalho, carregando mais bagagem. Depois do limite, essa participação é de 12%.
O Teto Se Manteve
Um ponto por sessão, posicionado no maior contexto que aquela sessão já carregou.
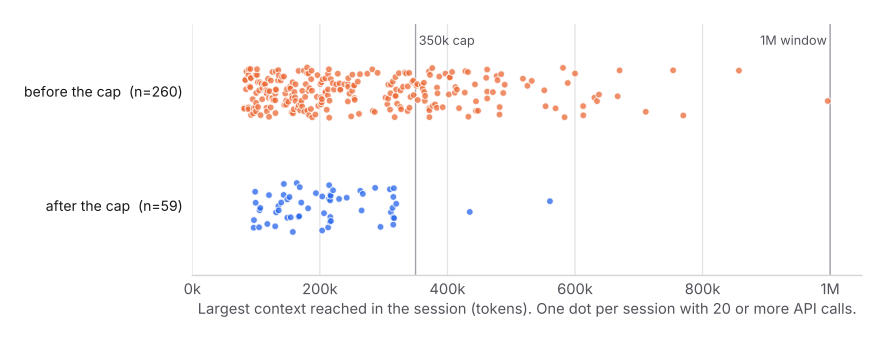
Duas sessões nos dois primeiros dias ainda passaram do limite, chegando a 434.000 e 561.000, e eu não descobri por quê. Desde que a configuração de 350.000 entrou em vigor em 18 de setembro, nenhuma sessão a ultrapassou. A cauda de sessões vivendo entre 500k e 1M, que é onde estava a maior parte do desperdício, desapareceu.
Quanto Teria Custado Sem o Limite
Para colocar um total nisso, eu reproduzi cada sessão iniciada após a mudança como se o contexto descartado nunca tivesse sido resumido e ainda estivesse sendo relido em cada chamada posterior, limitado à janela de 1M.
| Entrada ponderada por cache | |
|---|---|
| Real, 73 sessões, 9.675 chamadas, 55 compactações | 216,8M |
| As mesmas sessões sem o limite | 479,2M |
| Evitado | 262,5M, ou 55% |
A sessão à direita do primeiro gráfico responde por 118,5M disso sozinha. Um refactor longo que, de outra forma, teria gastado suas últimas centenas de chamadas relendo perto de um milhão de tokens em cada uma.
Trate os 55% como o extremo otimista. Sem o limite, eu não teria realmente deixado uma sessão se arrastar a 900k por horas; eventualmente eu a teria limpo manualmente, o que também reinicia o custo. O extremo conservador é o número observado por chamada, de 30,6k para 22,4k, ou seja, aproximadamente 20% a 27%. A verdade está em algum lugar entre esses dois.
O Que Isso Custa Para Você
Isso não é gratuito, e qualquer um que o recomende deveria dizer isso.
Espera. 67 compactações desde a mudança, com mediana de cerca de três minutos cada. Aproximadamente 3,4 horas assistindo um resumo ser escrito, distribuídas ao longo de oito dias.
Algum retrabalho. A compactação descarta muita coisa. Na configuração de 350K, a compactação mediana levava uma sessão de 318.000 tokens para 24.000. O agente perde detalhes e às vezes os reconstrói: arquivos relidos dentro da mesma sessão passaram de 11,5% das leituras antes da primeira compactação para 20,5% depois. A amostra por trás desse segundo número é pequena, então leia-o como uma direção, não como uma medição.
A escolha do limiar importa. Em 250K, 36% das minhas sessões longas passaram por uma compactação. Em 350K, 12% passaram, e o teto ainda se manteve. Defina-o baixo demais e você paga os três minutos e o retrabalho repetidamente por uma economia que já havia garantido.
Como Configurar
Claude Code. Adicione autoCompactWindow a ~/.claude/settings.json. Em um modelo com contexto de 1M, 350.000 foi o melhor dos três valores que testei. Em um modelo de 200K, reduza proporcionalmente e comece em torno de 120.000 a 140.000. Novas sessões passam a usá-lo; uma sessão já em execução mantém o valor antigo.
Outros agentes. Procure a mesma ideia com outro nome: um gatilho de compactação, um limite de contexto, um limiar de resumir-e-continuar. Se não houver nenhum, a versão manual é limpar a sessão com mais frequência do que parece natural. O instinto de manter uma única sessão longa viva o dia todo porque ela “conhece o projeto” é o caro.
Seja o que for que você use, dois hábitos fazem mais do que qualquer configuração. Mantenha o estado durável em arquivos, e não na conversa, para que o agente possa reler um único arquivo a baixo custo em vez de carregar para sempre cada resposta anterior. E empurre o trabalho com muita leitura para subagentes com seu próprio contexto de vida curta, para que os vinte arquivos que eles leem nunca entrem na sessão principal.
Se Você Está em um Limite Semanal
Se você paga uma assinatura com limite de uso semanal em vez de uma fatura por token, esta é a alavanca com a melhor relação entre esforço e efeito que já encontrei. Uma linha de JSON, nenhuma mudança em como você trabalha, e o mesmo limite se estende de forma mensurável. No meu caso, o mesmo volume semanal de prompts custou 17% menos, e as sessões longas custaram cerca da metade.
Leia a Seguir
As janelas de contexto são vendidas como capacidade. Elas se comportam como um medidor em funcionamento, cobrando em cada turno por tudo o que você já colocou ali. Se você quer a mecânica por trás disso em vez de apenas a configuração, o texto complementar percorre o que de fato preenche uma janela de contexto, por que uma sessão longa custa muito mais do que o trabalho que realiza e como o cache, a limpeza e a compactação mudam cada um a aritmética.
