


Há alguns dias, a Anthropic tornou o Fable parte permanente dos planos Max. O momento conta a história: ele chegou logo depois de a OpenAI lançar o GPT-5.6 Sol e — mais relevante ainda — logo depois de o Kimi K3 liberar seus pesos. Foi preciso um modelo open-source para forçar o maior laboratório de IA a encarar a realidade e encerrar o alarido de marketing em torno do seu carro-chefe. Só isso já merece um brinde de qualquer um que paga essas faturas.
Mas “incluído na sua assinatura” não é o mesmo que “barato”, e definitivamente não é o mesmo que “barato para sempre”. Por isso, enquanto o Fable ainda era medido por uso, reconstruímos nosso fluxo de trabalho para que o modelo caro ficasse mecanicamente impedido de escrever código. Ele pensa, planeja e revisa. Modelos mais baratos digitam. Este post mostra como isso funciona e o que de fato resultou em todas as transcrições que temos — 606 sessões reais abrangendo um monorepo de SaaS em produção, um app de operações de drones, um site de marketing e os agentes de CI que os atendem.
Parte 1 — A armadilha e o princípio
Eis nossa posição inicial honesta: não conseguimos mais operar sem modelos de fronteira. Ninguém na equipe conseguiria sustentar a produção atual sem eles — e essa dependência é exatamente a alavanca que os grandes laboratórios detêm. Na nossa leitura, as assinaturas de IA de hoje entregam bem mais computação do que custam; são preços de conquista de mercado, e preços de conquista de mercado acabam. Quando acabarem, quem construiu sua cultura de engenharia em torno de “tokens de fronteira ilimitados” paga o que pedirem.
Há duas defesas. A primeira é manter uma saída crível: modelos abertos como DeepSeek e Kimi são o que forçou a correção de preços desta semana, e eles só continuam sendo alavanca se de fato mantivermos nossos fluxos de trabalho portáveis para eles. A segunda é disciplina de fluxo de trabalho: gastar tokens de fronteira apenas onde nada mais barato funciona. Este post é sobre a segunda — porque é a que você pode começar na segunda-feira.
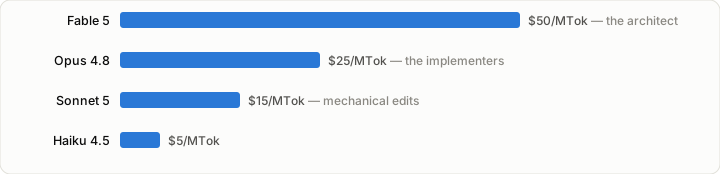
O princípio é velho o bastante para ter um prédio batizado em sua homenagem: o arquiteto não assenta tijolos. A vantagem de um modelo de fronteira sobre um modelo de camada intermediária é enorme em design, decomposição e revisão — e próxima de zero ao digitar um rename em quarenta arquivos. Então divida os papéis. A escada de preços diz a mesma coisa em dólares:
Como o padrão fable-architect funciona
A skill fable-architect é um arquivo markdown de ~100 linhas mais um hook de shell, carregado sempre que uma sessão do Claude Code roda no modelo de fronteira. Ela impõe uma divisão de trabalho:
- O arquiteto faz: interrogar o requisito, explorar a base de código, tomar toda decisão de design — abordagem, fluxo de dados, nomes, assinaturas, casos de borda — decompor o trabalho em fatias independentes, revisar os diffs retornados, executar a verificação e escrever toda a prosa (planos, briefings, corpos de PR, mensagens de commit).
- O arquiteto nunca faz: escrever ou editar um arquivo-fonte. Nenhum código no chat além de assinaturas curtas dentro de um briefing.
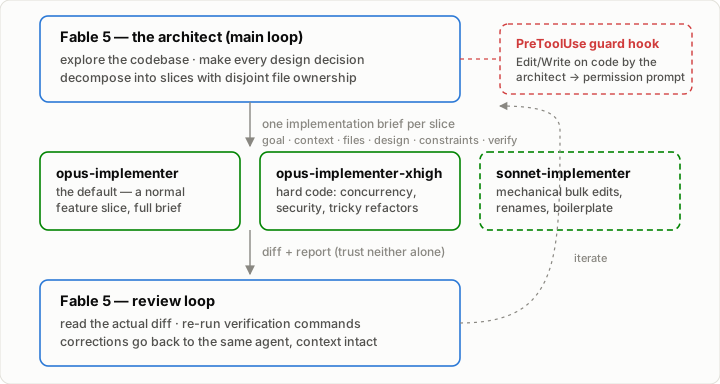
Três coisas fazem isso funcionar na prática, e não em um slide.
1. O briefing é a interface
Cada fatia recebe um briefing de implementação. O implementador começa com uma janela de contexto nova — qualquer coisa que não esteja no briefing ele precisa redescobrir ou adivinhar. Essa restrição é uma vantagem: obriga o arquiteto a terminar de decidir antes de delegar. Um briefing contém decisões, não opções.
## Briefing de implementação: <fatia>
Objetivo:      uma frase, resultado observável
Contexto:      o que a exploração já encontrou — trechos, o padrão
               mais próximo a espelhar, âncoras de linha, armadilhas
Arquivos:      caminhos a criar/modificar — propriedade exclusiva desta fatia
Design:        a abordagem decidida — fluxo de dados, nomes, assinaturas, bordas
Restrições:    regras do projeto aplicáveis: estilo, camadas, segurança
Fora de escopo: o que não tocar, incluindo arquivos de outras fatias
Delegação:     esta fatia pode gerar subimplementadores, e quantos
Verificação:   comandos exatos e resultado esperado
Duas dessas linhas são mais novas que o resto, e existem porque a camada de implementadores mudou debaixo de nós — veja a atualização abaixo.
2. Imposição, não boas intenções
Um hook de guarda PreToolUse vigia a sessão: se o arquiteto tenta editar um arquivo que não é de prosa, um prompt de permissão é disparado. Aprovar o prompt é a exceção documentada para edições triviais (um erro de digitação, um bump de versão — casos em que a sobrecarga da delegação custa mais que digitar). O atrito é a política. Sem o hook, “o modelo caro não deveria codar” dura exatamente até o primeiro prazo.
3. O ciclo de revisão fecha a lacuna de qualidade
O arquiteto lê o relatório do agente e o diff real — não confiando em nenhum dos dois isoladamente — e executa de novo os comandos de verificação principais quando a afirmação importa. Encontrou um problema? A correção volta para o mesmo agente, que ainda mantém todo o seu contexto de trabalho. Sem consertos manuais, sem respawn novo.
Observe que esta é a verificação do arquiteto, e ela permanece. O que começamos a remover é a verificação que costumávamos escrever nos briefings — instruções dizendo ao implementador para se autoconferir. Modelos implementadores mais novos fazem isso sem que se peça, e mandá-los fazer de novo compra uma segunda passada que você já pagou.

Pronto para expandir seu negócio?
Comece seu teste gratuito hoje e veja resultados em dias.
O que medimos
Para verificar se este é um mecanismo econômico real ou apenas um ritual agradável, mineramos todas as transcrições do Claude Code dos nossos projetos, deduplicando requisições de API e precificando cada token pelas tarifas de lista atuais. Três hipóteses, registradas antes de olhar os números por sessão:
- H1 — Os implementadores fazem a digitação. Se verdadeiro, subagentes implementadores deveriam produzir mais tokens de saída do que o loop principal do arquiteto em sessões delegadas.
- H2 — Delegar é mais barato. Se verdadeiro, reprecificar o trabalho dos implementadores pelas tarifas do modelo arquiteto deveria resultar em algo significativamente mais caro do que o que de fato pagamos.
- H3 — A qualidade se mantém. A difícil: código delegado não deveria precisar de mais retrabalho do que código digitado pelo arquiteto.
Regras do jogo. Uma requisição de API abrange muitas linhas de transcrição que repetem o mesmo objeto de uso — agrupamos por ID de requisição, contamos tokens de entrada e de cache uma vez por requisição e pegamos o snapshot máximo de saída (a soma ingênua por linha superestima de 2 a 3×). Os custos usam os preços de lista atuais da Anthropic — Fable $10/$50, Opus $5/$25, Sonnet $3/$15 por milhão de tokens de entrada/saída — com leituras de cache a 10% do preço de entrada e escritas de cache às suas tarifas por TTL. 31 das 354 sessões de armazenamento interativo se qualificam como sessões fable-architect sob um classificador conservador; os números mostram as oito mais caras. Relatamos proporções e percentuais, não nosso gasto absoluto.
Parte 2 — Os recibos
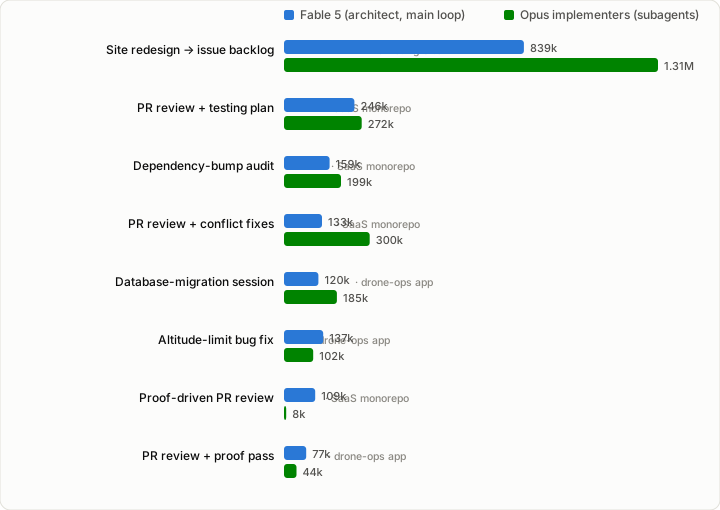
H1 — Misto… disse a primeira contabilidade. Nas maiores sessões de delegação a hipótese se sustenta de forma decisiva — até 2,3× mais saída dos implementadores do que do arquiteto. Mas nas 31 sessões fable-architect como um todo o arquiteto ainda produziu mais que os implementadores, 3,59M contra 3,15M de tokens. Em parte isso é justo — a saída do arquiteto inclui todos os planos, briefings e prosa de revisão, que é exatamente o trabalho dele — e em parte parecia sessões que delegavam uma fatia e mantinham o resto. Então lembramos que o redesign do nosso site não tinha parecido nada pesado em arquiteto, e fomos procurar os tokens que a contabilidade de subagentes não conseguia ver.
Junte-se à nossa newsletter
Receba gratuitamente as últimas dicas, tendências e ofertas.
O segundo canal: o rastreador de issues como barramento de delegação
A contabilidade de subagentes tem um ponto cego: ela só vê a delegação que acontece dentro de uma sessão. A sessão de redesign do site — a maior linha do gráfico acima — acabou sendo algo totalmente diferente: uma única sessão de loop de arquiteto que rodou por 107 horas seguidas (292 despertadores agendados), dividiu o redesign em issues do GitHub, marcou-as para nosso pipeline de CI e então supervisionou: consultando execuções, revisando os pull requests do pipeline, abrindo issues de acompanhamento conforme o QA revelava bugs.
A digitação aconteceu em um lugar que nossa mineração por sessão nem tinha olhado: uma frota separada de runners auto-hospedados, onde os estágios plano → implementação → avaliação de lacunas → revisão do pipeline executaram como 252 sessões independentes do Opus ao longo de 4,5 dias, tocando 48 issues e PRs distintos.
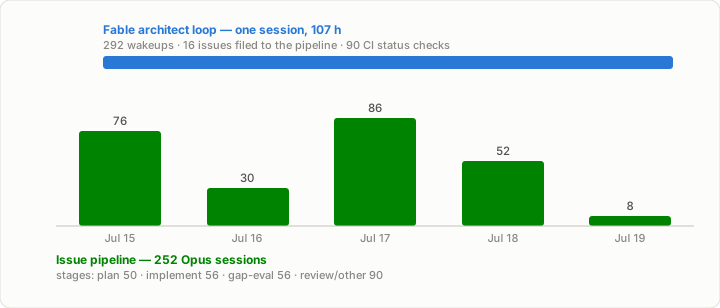
H1, revisitada — Confirmada em escala de projeto. Conte os dois canais e o quadro se inverte: o pipeline digitou 10× mais tokens de saída do que o loop de arquiteto que o despachou (9,07M contra 877k), tudo a tarifas de Opus. Rodar essa onda de implementação no modelo do arquiteto teria custado 2,1× mais — em um único redesign, em uma única semana, antes de contar os subagentes dentro da sessão. Uma issue é apenas um briefing de granularidade mais grossa: mesma interface, mesma economia, um nível acima.
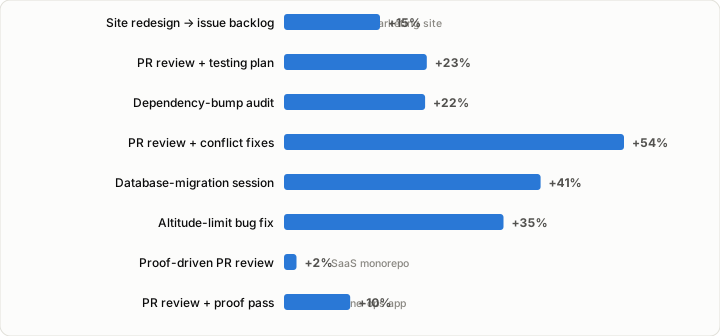
H2 — Confirmada, com uma reviravolta. Reprecificar os volumes exatos de tokens dos implementadores pelas tarifas do modelo arquiteto torna toda sessão mais cara — de +2% a +54%, 17% nas oito principais. Dinheiro real, mas menor do que a diferença de 2× no preço de saída sugere. A reviravolta: a saída não é para onde o dinheiro vai. Na maior sessão, as leituras de cache do arquiteto custaram cerca de 13× mais do que tudo o que ele digitou — o gasto dominante é o modelo caro mantendo e relendo um grande contexto de orquestração, não digitando. A delegação limita a conta de saída; a próxima alavanca é manter enxuto o contexto do arquiteto.
H3 — Não medida aqui. A contabilidade de tokens não vê qualidade de código. O que podemos dizer por observação: o ciclo de revisão é estrutural — relatórios e diffs discordam com frequência suficiente para que ler os dois seja inegociável — e correções encaminhadas de volta a um agente com contexto quente convergem rápido. Se você replicar isso e medir o retrabalho adequadamente, queremos ver, especialmente se nos refutar.
O que os dados mais amplos nos ensinaram
- A adoção é um gradiente, não um interruptor. No app de operações de drones — menor e mais ágil — 18% das sessões usam o padrão fable-architect; no monorepo de SaaS mais antigo, são 9%. O projeto que mais delegou o fez nas duas granularidades ao mesmo tempo: briefings de implementação dentro da sessão e 252 sessões de pipeline despachadas pelo rastreador de issues.
- A frota de CI não roda a skill — porque ela é o implementador. Nossas sessões automatizadas de runner nunca geram um subagente implementador, e à primeira vista isso parecia não adoção. Os prompts dizem o contrário: cada uma é um estágio de pipeline — verificar, revisar, avaliar lacunas — e cerca de seis em cada dez trabalham contra uma issue ou PR específica. Em escala de projeto, os runners do pipeline são a camada de implementadores.
- A camada mais barata ainda não teve seu primeiro dia de trabalho. Todas as 78+ execuções de implementador eram classe Opus; a camada de edições mecânicas do Sonnet só foi adicionada recentemente e nunca foi invocada. Quaisquer economias que isto meça são um piso.
A interface é o ponto: briefing entra, diff sai — issue entra, PR sai. No dia em que o aumento de preço chegar, você troca o pedreiro, não o processo.
Divulgação completa. Modelos verificados a partir de strings de transcrição, não presumidos. Nos corrigimos duas vezes (uma supercontagem de tokens por linha e, depois, uma tabela de preços provisória). O contrafactual assume que o arquiteto teria gasto os mesmos volumes de tokens que os implementadores — as barras de erro correm nas duas direções. As sessões de pipeline vivem em um armazenamento de transcrições que nossas duas primeiras passagens de mineração não abrangeram; uma fronteira contábil escondeu de nós um canal de delegação de 9M de tokens, e o seu provavelmente também tem um. Projetos de um único engenheiro, majoritariamente revisão-e-correção e trabalho de features — não é um benchmark controlado. O corpus também se encerra antes do lançamento do Opus 5: todos os números acima são Fable como arquiteto sobre implementadores classe Opus-4. Os preços dos degraus não mudaram quando o Opus 5 chegou, então as proporções medidas permanecem — mas veja a próxima seção para o que mudou.
Atualização — a escada se moveu debaixo de nós
O Opus 5 foi lançado depois que estas medições se encerraram, e nada na escada de preços mudou: o Opus continua $5/$25 por milhão de tokens de entrada/saída, o Fable continua $10/$50, e o gráfico acima continua correto. O que mudou foi a capacidade em cada degrau. A Anthropic posiciona o Opus 5 como um salto em raciocínio profundo e trabalho agêntico de longo horizonte — ou seja, exatamente no trabalho de que o papel de arquiteto é feito, pela metade do preço da camada de arquiteto.
Isso aponta direto para a nossa própria reviravolta da H2. Se o custo dominante do arquiteto são leituras de cache, e leituras de cache custam 10% do preço de entrada, então um arquiteto rodando no Opus 5 relê seu contexto de orquestração a $0,50 por milhão de tokens em vez de $1,00 do Fable. O item de linha que custava 13× tudo o que o arquiteto digitou cai pela metade. Não medimos isso — é aritmética sob a mesma suposição de volume de tokens igual que sinalizamos para o contrafactual de 2,1×, e é a próxima coisa que pretendemos testar. Se se confirmar, a pergunta interessante deixa de ser quais modelos e passa a ser se o arquiteto precisa do degrau mais alto.
Três coisas sobre a nova camada de implementadores mudam o próprio padrão, não apenas seu preço:
- Ela recorre a subagentes com facilidade — o oposto do seu antecessor, que precisava ser convencido a delegar. Um implementador que silenciosamente gera seus próprios implementadores multiplica a conta sem ninguém olhando. Daí a linha
Delegação:no briefing: uma fatia agora declara se pode se ramificar, e com que largura. - Ela verifica o próprio trabalho sem que se peça. Instruções de verificação escritas para modelos mais antigos agora compram uma segunda passada redundante, então saem dos briefings. O ciclo de revisão do arquiteto permanece intacto.
- Ela expande o escopo.
Fora de escopo:deixa de ser chavão e se torna a linha que mantém uma fatia como fatia.
E o degrau que nunca usamos ficou mais afiado enquanto não olhávamos: o Sonnet 5 chega perto da qualidade do Opus em trabalho de codificação a $3/$15, com preço introdutório abaixo disso até o fim de agosto. “Quaisquer economias que isto meça são um piso” era uma ressalva quando escrevemos. Agora parece um eufemismo.
Parte 3 — Para onde isso está deliberadamente indo
Estamos conduzindo, de propósito, em direção a uma divisão que achamos que toda equipe de engenharia acabará sendo forçada a adotar: modelos de fronteira caros apenas para brainstorming, arquitetura e revisão; modelos cada vez mais baratos para a programação em si. Hoje nossos implementadores são classe Opus. Nada no fluxo de trabalho muda quando eles passarem a ser classe Sonnet, classe DeepSeek ou classe Kimi — a interface é agnóstica a modelos por construção. Esse é todo o valor estratégico: no dia em que o subsídio acabar e a fatura dobrar, equipes com essa disciplina mudam uma linha de configuração. Equipes sem ela renegociam toda a sua estrutura de custos sob pressão.
Fable-architect é um passo de bebê — a adoção é parcial e a camada mais barata ainda não viu sua primeira execução. Mas é o passo que constrói o músculo: escrever briefings que especificam completamente uma fatia, revisar diffs que você não digitou, tratar a atenção do modelo caro como um orçamento. E a onda de redesign mostra aonde o músculo leva: uma vez que os briefings funcionam, as issues funcionam, e o modelo caro deixa de comparecer à implementação por completo.
O que você pode fazer na segunda-feira
- Divida os papéis no seu harness de agentes. Uma regra no nível da sessão: o modelo de fronteira planeja e revisa; delegue todas as edições de arquivos a um agente implementador mais barato. No Claude Code, isso é uma skill mais definições de subagentes — uma tarde de configuração.
- Torne a fronteira mecânica. Adicione um hook de pré-edição que conteste as próprias escritas de arquivo do modelo caro. Uma regra que não custa nada quebrar será quebrada até sexta-feira.
- Escreva briefings com um template fixo. Objetivo, contexto, arquivos, design, restrições, fora de escopo, orçamento de delegação, verificação. O template é a disciplina — e o orçamento de delegação é o que impede um implementador de contratar silenciosamente o seu próprio.
- Revise tanto o relatório quanto o diff. Nunca confie em nenhum dos dois isoladamente; execute de novo os comandos de verificação que importam.
- Meça a sua própria divisão. Suas transcrições já contêm os dados — agrupe por requisição, precifique por modelo e veja quem está de fato digitando. As nossas nos mostraram uma camada barata não usada e um canal de delegação de 9M de tokens que não conhecíamos.
- Amplie a interface de briefings para issues. Um briefing delega uma hora de trabalho; uma issue delega um dia dele. Uma vez que suas issues carreguem critérios de aceite sobre os quais um pipeline possa agir, o modelo caro pode arquivar trabalho no rastreador e supervisionar em vez de ficar no loop a cada fatia.
- Mantenha uma saída aquecida. Rode um modelo barato ou aberto como implementador para uma fatia de baixo risco por semana. Portabilidade que você nunca exercita é portabilidade que você não tem.
- Reprecifique o arquiteto, não só o pedreiro. Cada lançamento de modelo move os degraus sem mover a escada. Se a maior parte do seu gasto com arquiteto é contexto e não digitação, uma camada de arquiteto mais barata vale mais que uma camada de implementador mais barata — verifique qual delas suas próprias transcrições dizem que você está comprando.
Os laboratórios vão continuar dizendo que seus modelos de topo valem qualquer preço e — irritantemente — para trabalho de julgamento eles estão em grande parte certos. O movimento não é abster-se. É parar de pagar preços de fronteira por laços for.
