


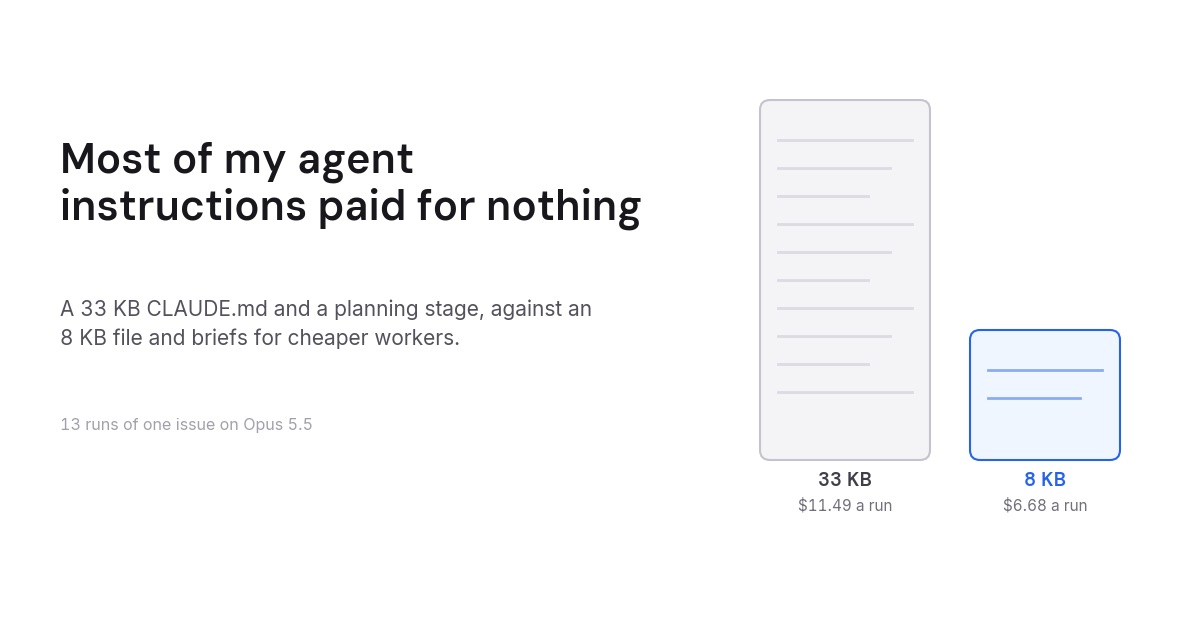
Versiunea scurtă
- Am luat o problemă reală din backlogul FlowHunt și am pus Claude Code să o implementeze de 13 ori pe Opus 5.5, în șapte configurații diferite de instrucțiuni. Fiecare rulare a pornit de la același commit, în propriul clone cu propria bază de date, și a trecut prin CI-ul nostru real de GitHub. Două recenzii oarbe făcute de Opus au notat fiecare rezultat.
- CLAUDE.md-ul de 33 KB al repository-ului nu a cumpărat calitate măsurabilă. Rulările cu el au obținut 2,0 constatări de tip blocker și major per recenzie. O rulare fără niciun fișier de instrucțiuni a obținut același rezultat. Un fișier de 5,5 KB a obținut 1,0.
- O etapă separată de planificare a înrăutățit lucrurile. Ambele configurații care rulau un prompt de planificare și apoi un prompt de implementare au costat mai mult decât gemenele lor cu prompt simplu și au produs patru din cele cinci blocker-e din toate cele 26 de recenzii.
- Câștigătoare a fost o configurație cu CLAUDE.md de 8 KB, trei abilități, workeri Sonnet și un prompt simplu. Cele două rulări ale ei au costat în medie 6,68 $ la prețul de listă al API-ului. Configurația completă cu prompturile de pipeline a costat în medie 11,49 $, de aproximativ 1,7 ori mai mult, și a avut mai multe constatări.
- Ce a supraviețuit din toată structura pe care o construisem este brief-ul: o descriere scurtă și decisă a unei singure felii de lucru, pe care modelul principal o scrie pentru un worker mai ieftin. Planurile pentru modelul principal însuși nu s-au rentat. Modelul planifică bine de unul singur.
Aceasta urmează postării tiparul architect , care a măsurat cine ar trebui să tasteze codul. Aceasta întreabă cât de mult trebuie să i se spună modelului principal înainte de a începe.
De ce am făcut testul
Monorepo-ul nostru adunase o mulțime de instrucțiuni pentru agenți. CLAUDE.md-ul rădăcină avea 33 KB: comenzi de build, ritmul testelor, stilul de cod, arhitectura, căile critice, reguli de securitate, reguli de permisiuni și credite, cele două suprafețe de agent, raportarea problemelor, convenții de PR. Zece abilități stăteau în .claude/skills/. Peste asta, pipeline-ul nostru de CI (îl numim harnext) rula o problemă printr-un tagger, o etapă de triaj, o etapă de planificare care scria un plan ca comentariu la problemă și o etapă de implementare care citea planul înapoi și scria codul, fiecare cu propriul system prompt lung.
Fiecare linie din asta a fost adăugată cu un motiv, de obicei după ce un agent a greșit ceva. Întrebarea pe care nu o pusese nimeni era dacă mai ajută. Un CLAUDE.md este încărcat în fiecare sesiune și retrimis la fiecare tură. Dacă modelul ar fi făcut oricum lucrul corect, tokenii aceia sunt o taxă, iar după cum explică cât costă o fereastră de context , o taxă la fiecare tură se adună mai repede decât pare.

Pregătit să îți dezvolți afacerea?
Începe perioada de probă gratuită astăzi și vezi rezultate în câteva zile.
Testul
Problema era o secvență de emailuri programate pentru înregistrările noi: un admin definește pași ca „ziua 0: bun venit” și „ziua 5: perioada de probă se termină curând”, iar o sarcină de fundal trimite email fiecărui cont în ziua potrivită, se oprește odată ce persoana cumpără un plan plătit și sare peste conturile create înainte de lansare. Are nevoie de o migrație, un repository, un serviciu, o sarcină Celery beat, endpoint-uri REST, unelte MCP pentru agenți și o interfață de consolă în 11 limbi. Este o funcționalitate realistă de prima săptămână și are mai multe cazuri limită ușor de ratat.
Fiecare rulare a fost o sesiune headless de Claude Code pe Opus 5.5, izolată în propriul clone și propria bază de date, cu un script care împingea commit-ul către un PR draft și reintroducea rezultatul CI în sesiune, până la trei runde. Costul este total_cost_usd al Claude Code pentru sesiunea principală plus fiecare subagent, la prețul de listă al API-ului. Eu plătesc un abonament, deci aceasta este o măsură a muncii, nu a facturii mele.
Cele șapte configurații:
| Configurație | Rulări | |
|---|---|---|
| A | CLAUDE.md complet de 33 KB și zece abilități, prompturi de pipeline (planifică, apoi implementează) | 2 |
| B | CLAUDE.md complet și abilități, prompt simplu | 3 |
| C | Fără CLAUDE.md, fără abilități, prompt simplu | 2 |
| D | CLAUDE.md complet plus abilitatea architect, prompt simplu | 2 |
| E | CLAUDE.md de 8 KB, architect, grain-ponytail și unslop, prompturi de pipeline | 1 |
| F | CLAUDE.md de 5,5 KB, fără abilități, prompt simplu | 1 |
| G | CLAUDE.md de 8 KB, architect, grain-ponytail și unslop, prompt simplu | 2 |
A până la D au venit primele. E până la G au fost construite din ce au arătat acelea, iar a treia rulare B a mers alături de ele ca martor. Fișierul de 8 KB este cel de 5,5 KB plus o listă scurtă a abilităților și a momentului când să le încarci, plus regulile de rutare a modelelor care fac abilitatea architect să delege către Sonnet.
Fiecare rezultat a mers apoi la doi recenzori Opus care vedeau doar o literă, diff-ul, repository-ul și problema. Ei au listat fiecare schimbare pe care ar cere-o înainte de aprobare, au notat blocker, major, minor sau nit și au verificat fiecare criteriu de acceptare față de un fișier și o linie.
Cost
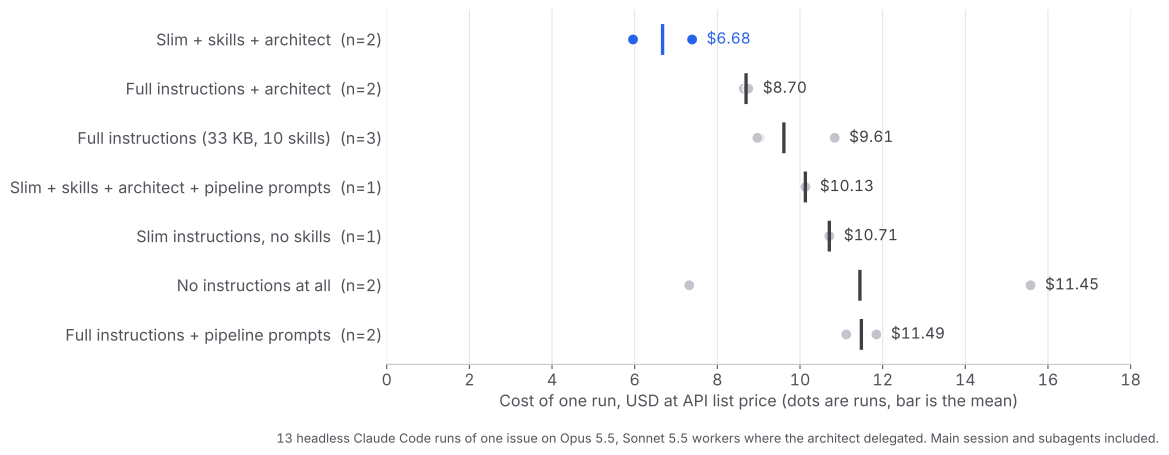
Configurația câștigătoare, G, a costat 5,96 $ și 7,39 $. Configurația completă cu prompturi de pipeline, A, a costat 11,12 $ și 11,85 $. Diferența constă în principal în ture și în ce cară fiecare tură. Sesiunile principale ale lui A au rulat 172 și 144 de ture pe Opus, cu 24 până la 28 de milioane de tokeni de intrare. Ale lui G au rulat 79 și 95 de ture cu 13 până la 16 milioane și au dat aproximativ 60 de ture în plus workerilor Sonnet, care se facturează la o fracțiune din tarif. G și-a terminat lucrul în circa 21 de minute, față de 45 la A.
Două lucruri de pe acest grafic m-au surprins. Fără nicio instrucțiune nu este varianta ieftină: cele două rulări ale ei au costat 7,32 $ și 15,58 $, iar cea scumpă a picat și CI-ul și a scris cel mai mare diff al testului. Iar fișierul de 5,5 KB fără abilități, F, nu a fost mai ieftin decât configurația completă. A scris mai mult cod, 1.601 linii de produs, și a plătit pentru asta. Economia din G nu vine doar din fișierul scurt. Vine din fișierul scurt plus cele două abilități care schimbă modul în care se face treaba.
Abonează-te la newsletter-ul nostru
Primește cele mai recente sfaturi, tendințe și oferte gratuit.
Calitate
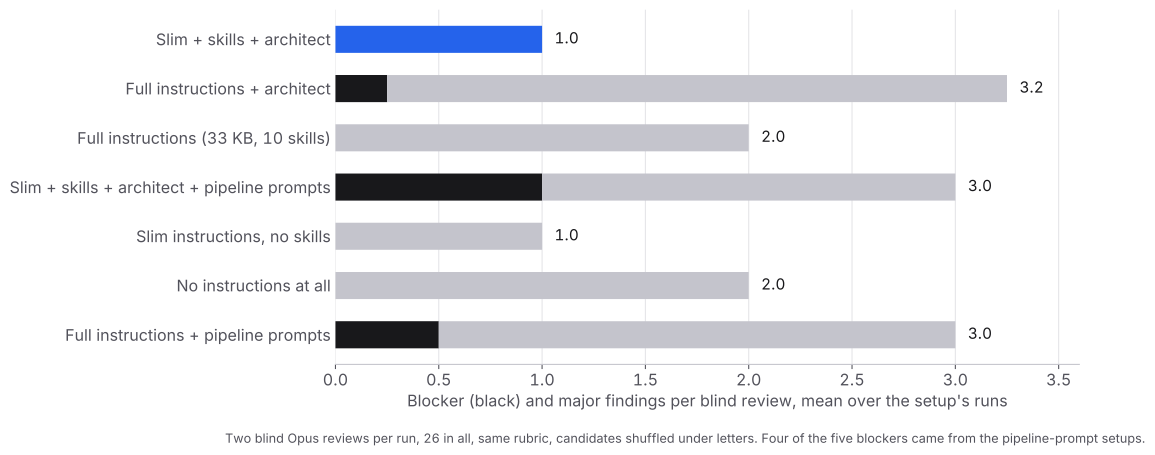
Configurația cea mai ieftină a avut și cele mai puține constatări grave: niciun blocker și 1,5, respectiv 0,5 constatări majore per recenzie în cele două rulări ale ei. CLAUDE.md-ul complet, B, s-a situat la 2,0 constatări majore în toate cele trei rulări ale sale, la fel ca varianta fără CLAUDE.md deloc.
Acesta este rezultatul care mă interesează cel mai mult. Fișierul are secțiuni lungi despre securitate, permisiuni și credite, scrise pentru că un agent le-a sărit odată. Cu sau fără fișier, recenzorii au găsit același număr de probleme grave, iar aceleași tipuri au revenit de la o configurație la alta: un utilizator înregistrat care plătește și apoi anulează, un email pierdut sau trimis de două ori când un worker eșuează pe la jumătate, un editor care suprascrie conținut pe care nu îl poate afișa. Sunt lacune de raționament privind starea care evoluează în timp. Nicio listă de reguli din CLAUDE.md nu le acoperea, pentru că nu poți scrie o regulă pentru un caz limită la care nu te-ai gândit încă.
Ce le-a acoperit a fost o schimbare făcută abilității architect între runde. Înainte ca modelul principal să scrie vreun brief, el scrie acum un tabel: fiecare criteriu de acceptare, ce se întâmplă când starea de care depinde se schimbă în timp și comportamentul decis. Fiecare rând intră apoi în brief cu un test numit explicit. Rulările lui G au scris 774 și 818 linii de test, față de 510 până la 670 la B.
Etapa de planificare
A și E sunt cele două configurații care au rulat prompturile pipeline-ului nostru de CI: un prompt de planificare care scrie un plan, apoi un prompt de implementare care citește planul și îl execută. Compară fiecare cu geamăna ei care a primit în schimb un prompt simplu. A a costat 11,49 $ per rulare, față de 9,61 $ la B, și a avut blocker-e acolo unde B nu a avut niciunul. E a costat 10,13 $, față de 6,68 $ la G, și a avut un blocker în fiecare dintre recenziile sale, acolo unde G nu a avut niciunul.
Cred că motivul este că un plan este un document pe care modelul îl scrie pentru sine și apoi trebuie să îl recitească drept instrucțiune externă. A doua sesiune tratează planul ca pe o specificație, îl urmează acolo unde este greșit și consumă ture reconciliindu-l cu ce găsește în cod. Un model atât de capabil planifică mai bine în interiorul sesiunii care urmează să facă treaba, acolo unde planul și codul sunt în același context.
Partea din planificare care a supraviețuit este brief-ul. Când modelul principal dă o felie unui worker Sonnet, workerul pornește cu un context gol și construiește exact ce i se spune. Acea predare are nevoie de o descriere scrisă și decisă: obiectivul, fișierele, tiparul de oglindit, cazurile limită, testul de scris. Un plan pentru tine însuți este cheltuială în plus. Un brief pentru altcineva este singurul mod în care treaba ajunge mai departe.
Ce a făcut grain-ponytail
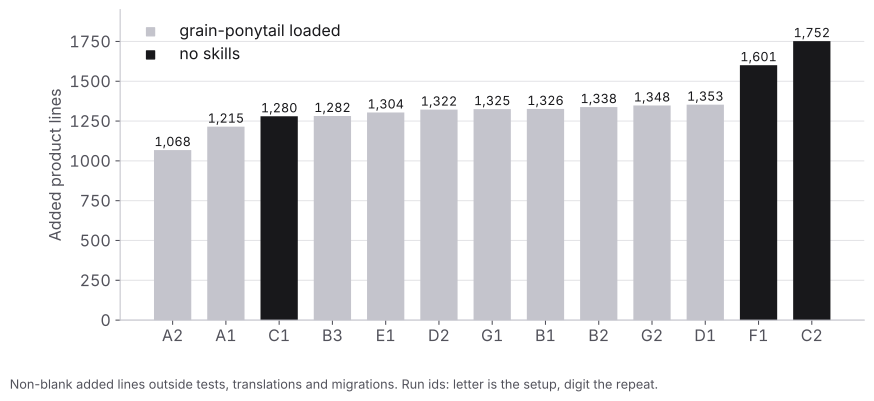
Abilitatea din cod care urmează firul îi spune modelului să oglindească cel mai apropiat exemplu existent și să livreze cel mai puțin cod care funcționează. Fiecare rulare care a avut-o încărcată a scris între 1.068 și 1.353 de linii de produs. Cele mai mari două diff-uri, 1.601 și 1.752, au venit din rulări fără abilități. O rulare fără abilități a rămas la 1.280, deci abilitatea nu decide singură dimensiunea, dar a eliminat coada distribuției.
Este și cel mai clar caz de instrucțiune care încă merită plătită. „Oglindește cel mai apropiat exemplu” schimbă ce face modelul în fiecare fișier pe care îl scrie. „Folosește snake_case pentru funcții” repetă ceva ce face deja.
Ce au mai prins recenziile
Rularea câștigătoare nu a fost curată. După test am rebazat munca lui G2 pe main și am trecut-o prin verificarea noastră completă de PR, care recenzează diff-ul, demonstrează fiecare constatare cu un test care pică și conduce schimbarea într-un browser real. A descoperit că editorul de pași elimina toate blocurile cu excepția primului bloc HTML atunci când un admin edita un pas creat prin MCP și că o eliberare de claim eșuată putea trimite email unor utilizatori de două ori. Ambele au fost corectate, cu teste, înainte ca PR-ul să ajungă la recenzia umană.
Recenzorii orbi au semnalat de asemenea mai multă supra-inginerie în rulările cu architect decât în cele cu instrucțiuni complete: 2,5 elemente per recenzie la G, față de 0 până la 1,0 la rulările lui A și B. Mai puține constatări grave, mai multe nit-uri. Aș accepta acest schimb, dar este un schimb.
Ce am schimbat
- CLAUDE.md-ul de 33 KB a devenit un AGENTS.md de 12 KB pe care îl citește și Codex, iar CLAUDE.md acum doar îl importă. Păstrează comenzile, ritmul testelor, arhitectura și regulile pe care un model nu le poate deduce din cod, cum ar fi care căi sunt critice și că cele două suprafețe de agent trebuie să rămână sincronizate.
- Etapa de planificare a dispărut din pipeline. Triajul dă problema direct unei etape de implementare al cărei prompt s-a redus la șase pași: citește problema, creează branch-ul, încarcă abilitățile architect și grain-ponytail, testează, fă commit, deschide un PR draft.
- Abilitatea architect a primit tabelul de cazuri limită, un câmp Tests în brief și o trecere finală care verifică tot diff-ul față de problemă, nu față de brief-uri. Acea versiune este publică la github.com/LivinTribunal/architect-skill .
Schimbarea din repository este în revizie la momentul scrierii.
Ce să reții din asta
Dacă CLAUDE.md-ul tău a crescut câte un incident pe rând, probabil plătește pentru reguli pe care modelul le urmează deja. Taie-l până la ce nu poate modelul să afle citind codul și măsoară înainte și după pe o sarcină reală, în loc să te încrezi că mai multă îndrumare este mai sigură.
Păstrează instrucțiunile care schimbă modul în care se face treaba: cine tastează codul, cum se dă brief-ul pentru o felie, ce tipar existent să copiezi. Renunță la pipeline-ul planifică-apoi-execută dacă modelul tău principal este unul frontier de generație actuală. Scrie brief-uri pentru workeri, nu planuri pentru tine însuți.
Metodă
13 rulări headless de Claude Code 2.1.289 pe 5 octombrie 2026, model principal Opus 5.5, workeri Sonnet 5.5 acolo unde abilitatea architect a delegat. Toate rulările au pornit de la un singur commit al monorepo-ului FlowHunt, fiecare într-un clone APFS cu propria bază de date Postgres, izolat de celelalte rulări și de fișierele experimentului însuși. Un broker împingea commit-ul fiecărei rulări către un PR draft față de un branch de bază înghețat și relua sesiunea cu rezultatul CI, până la trei runde. Costul este total_cost_usd maxim per sesiune, însumat peste sesiunea principală și subagenții ei. Liniile de produs sunt linii adăugate neblanke din afara testelor, traducerilor și migrațiilor.
Fiecare rezultat a primit două recenzii oarbe făcute de Opus cu o singură grilă: corectitudine, criterii de acceptare, respectarea tiparelor, câmpuri private și stare ascunsă, supra-inginerie, securitate și permisiuni, teste, migrații. Candidații au fost amestecați sub litere, iar recenzorii puteau citi repository-ul, dar nu puteau rula nimic. Constatările per recenzie sunt mediate peste rulările unei configurații. Cu una până la trei rulări per configurație, tratați media unei singure configurații ca fiind zgomotoasă. Concluziile de mai sus sunt cele care s-au susținut în ambele runde.
