


Pe scurt
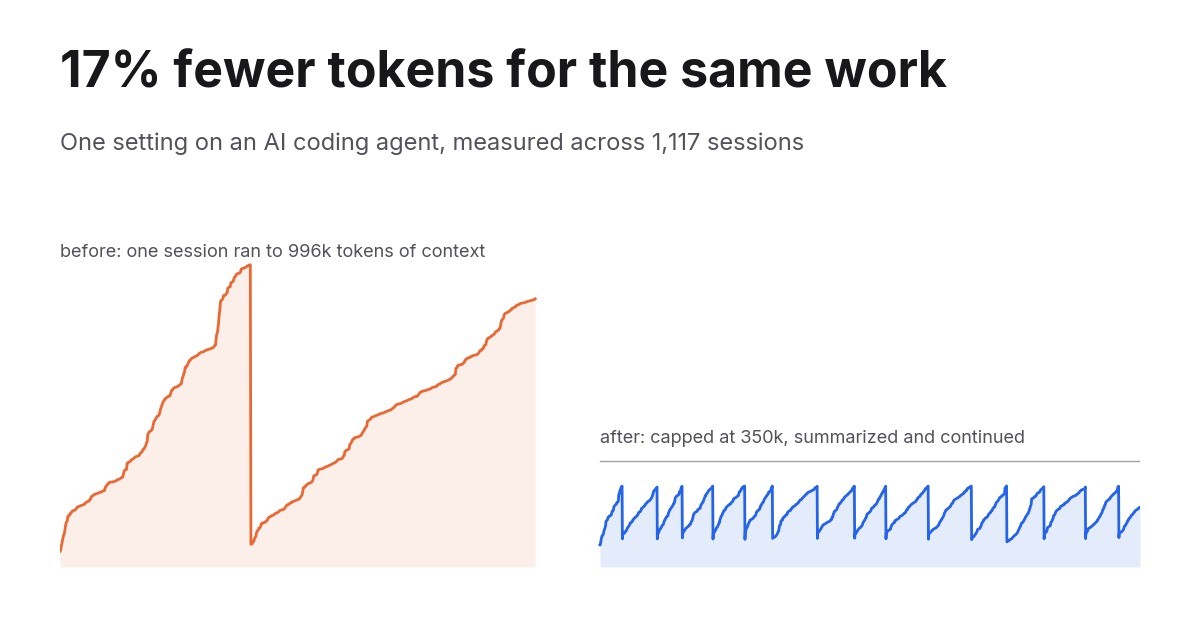
- Rulez un agent de cod AI toată ziua pe un model cu o fereastră de context de 1M de tokenuri. Sesiunile creșteau până aproape o umpleau.
- Am adăugat o linie în configurația lui, limitând o sesiune la 350.000 de tokenuri de context înainte ca aceasta să se rezume singură și să continue.
- Măsurat pe 1.117 transcrieri de sesiuni: cu 17% mai puține tokenuri pentru același număr de prompturi, iar în sesiunile lungi, unde plafonul chiar contează, cu 55% mai puține.
Mai jos este metoda, fiecare grafic și ce te costă în schimb, ca să poți decide dacă se aplică în configurația ta.
De ce o fereastră de 1M costă mai mult decât pare
O conversație cu un model este fără stare. Fiecare cerere cară tot istoricul: promptul de sistem, fiecare definiție de unealtă, fiecare fișier citit de agent, fiecare rezultat de unealtă, fiecare mesaj. Nu o diferență. Tot, de fiecare dată.
Așa că o sesiune care a ajuns la 900.000 de tokenuri plătește 900.000 de tokenuri de intrare la apelul următor și la cel de după el. Tura 400 nu face mai multă muncă decât tura 4. Doar costă de multe ori mai mult.
Cache-ul de prompturi atenuează asta. Tokenurile pe care modelul le-a văzut deja sunt facturate la aproximativ o zecime din prețul normal de intrare. Reducerea este reală, ea face sesiunile lungi viabile, și tot ea este motivul pentru care nimeni nu se uită la problemă. În datele mele, 98% din toate tokenurile de intrare erau citiri din cache. O zecime dintr-un număr foarte mare era tot cea mai mare linie de pe factură.
Întrebarea nu este dacă istoricul tău este cache-uit. Ci cât de mare are voie să devină înainte ca ceva să îl reseteze.

Pregătit să îți dezvolți afacerea?
Începe perioada de probă gratuită astăzi și vezi rezultate în câteva zile.
Ce am schimbat
Agentul este Claude Code, rulând Opus pe fereastra de context de 1M. Setarea este autoCompactWindow din ~/.claude/settings.json. Când o sesiune ajunge la acel număr de tokenuri, agentul rezumă conversația și continuă din rezumat.
{
  "autoCompactWindow": 350000
}
Nu o setasem niciodată, așa că sesiunile rulau până se apropiau de fereastra completă. Timp de patru zile am încercat trei valori:
| Data | Setarea |
|---|---|
| 14 septembrie | 250.000 |
| 15 septembrie | 300.000 |
| 18 septembrie | 350.000 |
Cum am măsurat
Claude Code scrie fiecare sesiune într-o transcriere JSONL sub ~/.claude/projects/, inclusiv consumul de tokenuri al fiecărui apel API. Le-am parsat pe toate 1.117, acoperind cinci săptămâni, de pe 19 august până pe 22 septembrie, am eliminat duplicatele după ID-ul cererii și am păstrat doar sesiunile interactive. Rulările din GitHub Actions folosesc același cont, dar nu pot fi afectate de o setare de pe laptopul meu, așa că sunt excluse.
Totalurile brute de tokenuri sunt înșelătoare în sine. O săptămână aglomerată bate o săptămână liniștită, indiferent ce schimbi. Deci fiecare cifră de mai jos este ponderată cu cache-ul, adică exact ce citește contorul: intrare nouă la 1x, scrieri în cache la 1,25x (cache de 5 minute) sau 2x (cache de 1 oră), citiri din cache la 0,1x. Iar fiecare comparație este normalizată prin munca efectuată, fie prompturile pe care le-am tastat, fie apelurile API făcute de agent.
Abonează-te la newsletter-ul nostru
Primește cele mai recente sfaturi, tendințe și oferte gratuit.
Două sesiuni, același agent
Acesta este mecanismul într-o singură imagine. În stânga, o sesiune reală din 3 septembrie, înainte de plafon. În dreapta, o sesiune reală din 15 septembrie, după el.
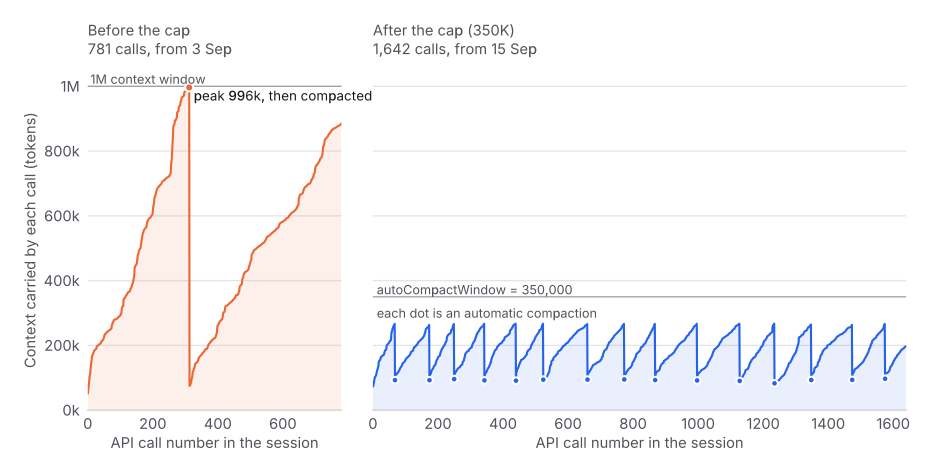
Sesiunea din stânga a rulat 781 de apeluri. A urcat la 996.000 de tokenuri de context, a lovit zidul ferestrei de 1M, s-a compactat o dată și apoi a urcat direct înapoi la 880.000. Pentru a doua jumătate a acelei sesiuni, fiecare apel recitea mai mult de jumătate de milion de tokenuri.
Sesiunea din dreapta a rulat 1.642 de apeluri, de peste două ori mai mult, și nu a purtat niciodată mai mult de 270.000. S-a compactat de cincisprezece ori. Fiecare compactare este un punct.
Cifrele săptămânale
Doar sesiuni interactive. Barele reprezintă tokenuri de intrare ponderate cu cache-ul per apel API, cel mai corect număr unic, pentru că nu îi pasă cât am lucrat într-o anumită săptămână.
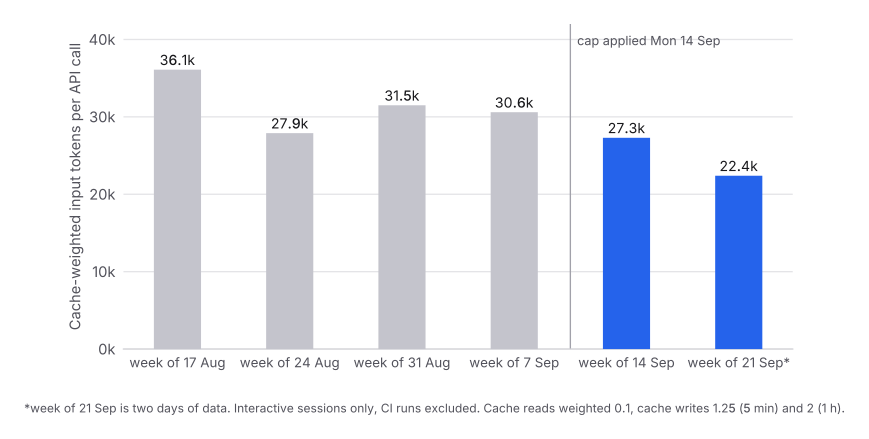
Cea mai curată comparație din setul de date este săptămâna din 7 septembrie față de săptămâna din 14 septembrie, pentru că nu le-am ales eu. Pur și simplu au căzut de o parte și de alta a schimbării, iar eu am tastat aproape exact același număr de prompturi în fiecare.
| Săptămâna din | Prompturi | Apeluri API | Intrare ponderată cu cache-ul | Per apel |
|---|---|---|---|---|
| 7 sep | 971 | 11.364 | 348,1M | 30,6k |
| 14 sep | 968 | 10.555 | 288,5M | 27,3k |
971 de prompturi față de 968. Intrare efectivă în scădere de la 348,1M la 288,5M. Asta înseamnă cu 17% mai puțin pentru aceeași cantitate de prompturi. Cele două zile din săptămâna următoare au venit la 22,4k per apel, chiar mai jos.
Unde se duceau banii
Împarte fiecare apel API după cât context căra și mecanismul devine vizibil direct.
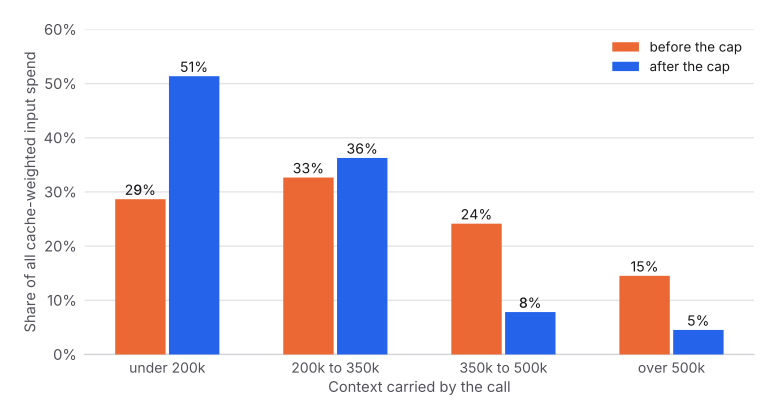
Înainte de plafon, 39% din tot ce am cheltuit s-a dus în apeluri care târau după ele mai mult de 350.000 de tokenuri de istoric. Acele apeluri nu făceau mai multă muncă decât celelalte. Era aceeași muncă, cu mai mult bagaj. După plafon, ponderea este de 12%.
A rezistat plafonul
Un punct per sesiune, plasat la cel mai mare context pe care l-a purtat vreodată acea sesiune.
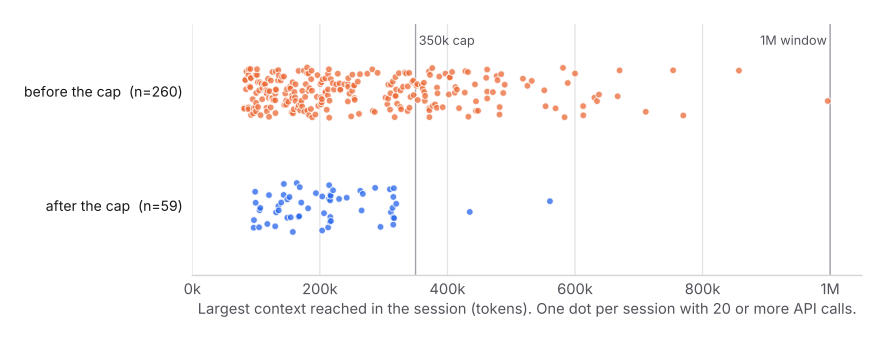
Două sesiuni din primele două zile au depășit totuși plafonul, ajungând la 434.000 și 561.000, și nu am aflat de ce. De când setarea de 350.000 a fost pusă pe 18 septembrie, nicio sesiune nu a depășit-o. Coada sesiunilor care trăiau între 500k și 1M, adică acolo unde era cea mai multă risipă, a dispărut.
Cât ar fi costat fără plafon
Ca să pun un total pe asta, am rejucat fiecare sesiune care a început după schimbare ca și cum contextul eliminat nu ar fi fost niciodată rezumat și ar fi fost recitit la fiecare apel ulterior, limitat la fereastra de 1M.
| Intrare ponderată cu cache-ul | |
|---|---|
| Real, 73 de sesiuni, 9.675 de apeluri, 55 de compactări | 216,8M |
| Aceleași sesiuni fără plafon | 479,2M |
| Evitat | 262,5M, adică 55% |
Sesiunea din dreapta primului grafic reprezintă singură 118,5M din asta. Un refactoring lung care altfel și-ar fi petrecut ultimele câteva sute de apeluri recitind aproape un milion de tokenuri fiecare.
Tratează 55% ca pe capătul optimist. Fără plafon nu aș fi lăsat chiar o sesiune să macine la 900k ore în șir; până la urmă aș fi golit-o manual, ceea ce resetează și el costul. Capătul conservator este cifra observată per apel, de la 30,6k la 22,4k, deci aproximativ 20%–27%. Adevărul este undeva între cele două.
Ce te costă
Nu este gratuit, și oricine îl recomandă ar trebui să spună asta.
Așteptare. 67 de compactări de la schimbare, cu o mediană de aproximativ trei minute fiecare. Aproximativ 3,4 ore de privit cum se scrie un rezumat, răspândite pe opt zile.
Ceva muncă refăcută. Compactarea elimină mult. La setarea de 350K, compactarea mediană a dus o sesiune de 318.000 de tokenuri la 24.000. Agentul pierde detalii și uneori le reconstruiește: fișierele recitite în aceeași sesiune au crescut de la 11,5% din citiri înainte de prima compactare la 20,5% după. Eșantionul din spatele celei de-a doua cifre este mic, așa că citește-o ca pe o direcție, nu ca pe o măsurătoare.
Alegerea pragului contează. La 250K, 36% din sesiunile mele lungi au ajuns la o compactare. La 350K, 12% au făcut-o, iar plafonul s-a menținut. Setează-l prea jos și plătești cele trei minute și munca refăcută în mod repetat pentru o economie pe care deja o aveai.
Cum să îl configurezi
Claude Code. Adaugă autoCompactWindow în ~/.claude/settings.json. Pe un model cu context de 1M, 350.000 a fost cea mai bună dintre cele trei valori încercate. Pe un model de 200K, scalează în jos și începe în jur de 120.000–140.000. Sesiunile noi o preiau; o sesiune deja pornită păstrează valoarea veche.
Alți agenți. Caută aceeași idee sub alt nume: un declanșator de compactare, o limită de context, un prag de rezumare și continuare. Dacă nu există niciunul, versiunea manuală este să golești sesiunea mai des decât ți se pare natural. Instinctul de a ține o singură sesiune lungă vie toată ziua, pentru că „cunoaște proiectul”, este cel scump.
Orice ai folosi, două obiceiuri fac mai mult decât orice setare. Păstrează starea durabilă în fișiere, nu în conversație, astfel încât agentul să poată reciti ieftin un fișier în loc să care pentru totdeauna fiecare răspuns anterior. Și trimite munca bazată pe citire către subagenți cu propriul lor context de scurtă durată, ca cele douăzeci de fișiere pe care le citesc să nu intre deloc în sesiunea principală.
Dacă ești pe o limită săptămânală
Dacă plătești un abonament cu limită de utilizare săptămânală, nu o factură per token, aceasta este pârghia cu cel mai bun raport efort-efect pe care l-am găsit. O linie de JSON, nicio schimbare în modul în care lucrezi, iar aceeași limită se întinde măsurabil mai mult. În cazul meu, același volum săptămânal de prompturi a costat cu 17% mai puțin, iar sesiunile lungi au costat cam jumătate.
Citește în continuare
Ferestrele de context sunt vândute ca o capacitate. Ele se comportă ca un contor care merge, taxând la fiecare tură pentru tot ce ai pus vreodată în el. Dacă vrei mecanica din spatele acestui lucru, nu doar setarea, articolul companion parcurge ce anume umple o fereastră de context, de ce o sesiune lungă costă mult mai mult decât munca pe care o face și cum caching-ul, golirea și compactarea schimbă fiecare aritmetica.
