


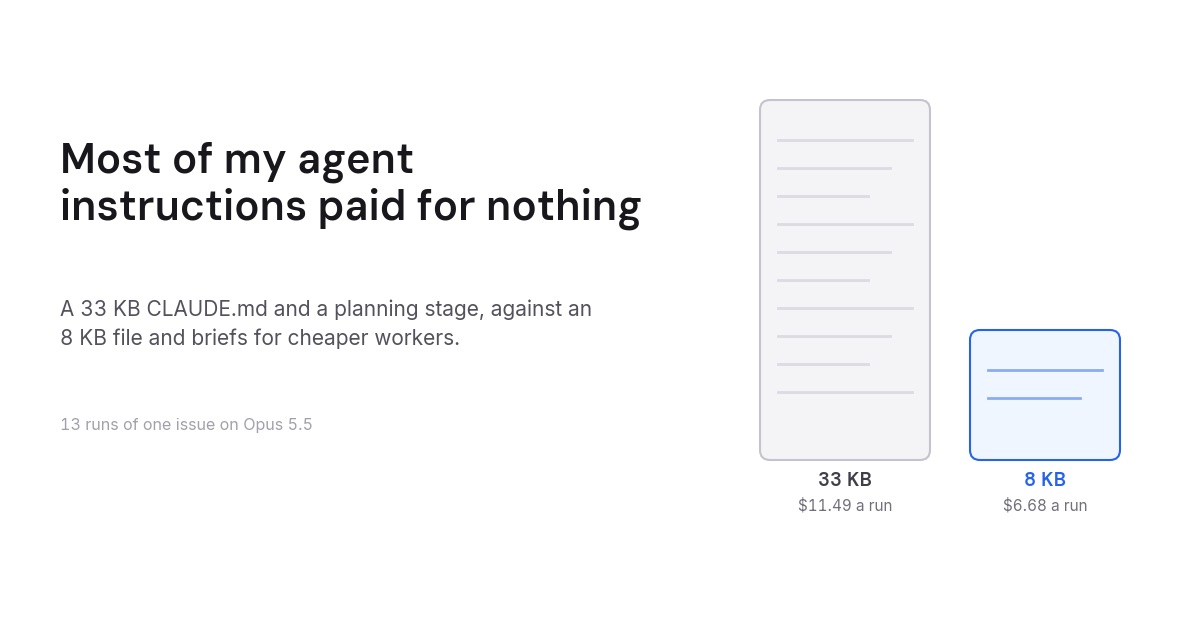
Krátka verzia
- Vzal som jeden reálny issue z backlogu FlowHuntu a nechal som Claude Code implementovať ho 13-krát na Opus 5.5 v siedmich rôznych nastaveniach pokynov. Každé spustenie začalo z rovnakého commitu, vo vlastnom klone s vlastnou databázou, a prešlo naším skutočným GitHub CI. Každý výsledok ohodnotili dve slepé recenzie od Opusu.
- 33 KB CLAUDE.md v repozitári neprinieslo merateľnú kvalitu. Spustenia s ním mali 2,0 nálezov typu blocker a major na recenziu. Spustenie úplne bez súboru s pokynmi malo to isté. Súbor s 5,5 KB mal 1,0.
- Samostatná fáza plánovania veci zhoršila. Obe nastavenia, ktoré spustili plánovací prompt a potom implementačný prompt, stáli viac než ich dvojčatá s obyčajným promptom a vyprodukovali štyri z piatich blockerov vo všetkých 26 recenziách.
- Víťazom bol 8 KB CLAUDE.md, tri skilly, Sonnet workeri a obyčajný prompt. Jeho dve spustenia stáli v priemere 6,68 $ v cenníku API. Plné nastavenie s pipeline promptami stálo v priemere 11,49 $, teda približne 1,7-krát toľko, a malo viac nálezov.
- Z celej tej štruktúry, ktorú som postavil, prežil brief: krátky, rozhodnutý opis jedného kusu práce, ktorý hlavný model napíše pre lacnejšieho workera. Plány pre samotný hlavný model sa nevyplatili. Model si plánovanie zvládne sám.
Toto nadväzuje na článok architect pattern , ktorý meral, kto by mal písať kód. Tento sa pýta, koľko toho treba hlavnému modelu povedať, než začne.
Prečo som to spustil
Náš monorepo nazbieral veľa pokynov pre agentov. Koreňový CLAUDE.md mal 33 KB: build príkazy, kadenciu testov, štýl kódu, architektúru, kritické cesty, bezpečnostné pravidlá, pravidlá oprávnení a kreditov, dve plochy agentov, zakladanie issues, konvencie pre PR. Pod .claude/skills/ bolo desať skillov. Navyše náš CI pipeline (hovoríme mu harnext) previedol issue cez tagger, triage krok, plánovací krok, ktorý zapísal plán ako komentár k issue, a implementačný krok, ktorý si plán načítal späť a napísal kód — každý s vlastným dlhým systémovým promptom.
Každý riadok z toho bol pridaný z nejakého dôvodu, zvyčajne po tom, čo agent niečo pokazil. Otázku, či to ešte pomáha, si nikto nepoložil. CLAUDE.md sa načítava do každej session a znovu odosiela v každom kole. Ak by model urobil správnu vec aj tak, tie tokeny sú daň, a ako vysvetľuje what a context window costs , daň v každom kole sa nasčíta rýchlejšie, než sa na prvý pohľad zdá.

Pripravení rozšíriť svoje podnikanie?
Začnite svoju 30-dňovú skúšobnú verziu ešte dnes a vidzte výsledky behom pár dní.
Test
Išlo o časovanú e-mailovú sekvenciu pre nové registrácie: admin definuje kroky ako „deň 0: vitajte“ a „deň 5: vaša skúšobná verzia čoskoro končí“ a úloha na pozadí pošle e-mail každému účtu v správny deň, zastaví sa, keď si daný človek kúpi platený plán, a vynechá účty vytvorené pred spustením. Potrebuje migráciu, repository, service, úlohu pre Celery beat, REST endpointy, MCP nástroje pre agentov a konzolové UI v 11 jazykoch. To je realistická funkcia na prvý týždeň a má niekoľko edge caseov, ktoré sa ľahko prehliadnu.
Každé spustenie bola headless session Claude Code na Opus 5.5, v sandboxe s vlastným klonom a databázou, so skriptom, ktorý posunul jeho commit do draft PR a vrátil výsledok CI späť do session, maximálne v troch kolách. Náklady sú vlastné total_cost_usd Claude Code za hlavnú session plus každý subagent, ocenené podľa cenníka API. Platím predplatné, takže je to miera práce, nie môjho účtu.
Tých sedem nastavení:
| Nastavenie | Spustenia | |
|---|---|---|
| A | Plný 33 KB CLAUDE.md a desať skillov, pipeline prompty (najprv plán, potom implementácia) | 2 |
| B | Plný CLAUDE.md a skilly, obyčajný prompt | 3 |
| C | Žiadny CLAUDE.md, žiadne skilly, obyčajný prompt | 2 |
| D | Plný CLAUDE.md plus skill architect, obyčajný prompt | 2 |
| E | 8 KB CLAUDE.md, architect, grain-ponytail a unslop, pipeline prompty | 1 |
| F | 5,5 KB CLAUDE.md, žiadne skilly, obyčajný prompt | 1 |
| G | 8 KB CLAUDE.md, architect, grain-ponytail a unslop, obyčajný prompt | 2 |
A až D prišli prvé. E až G vznikli z toho, čo ukázali, a tretie spustenie B išlo popri nich ako kontrola. Súbor s 8 KB je ten s 5,5 KB plus krátky zoznam skillov a kedy ich načítať, a pravidlá routovania modelov, vďaka ktorým skill architect deleguje na Sonnet.
Každý výsledok potom dostali dvaja recenzenti Opus, ktorí videli len písmeno, diff, repozitár a issue. Vypísali každú zmenu, ktorú by žiadali pred schválením, ohodnotili ju ako blocker, major, minor alebo nit a skontrolovali každé akceptačné kritérium voči súboru a riadku.
Náklady
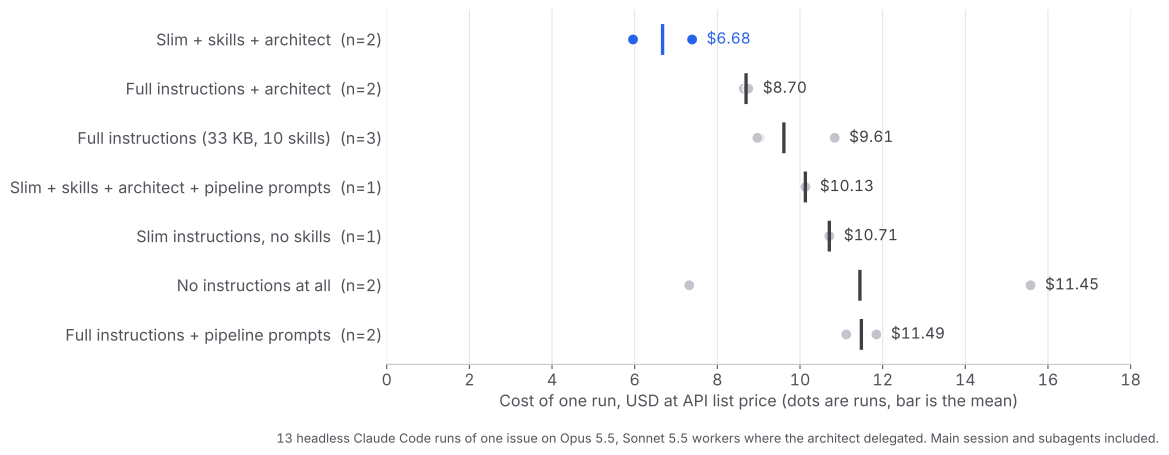
Víťazné nastavenie G stálo 5,96 $ a 7,39 $. Plné nastavenie s pipeline promptami, A, stálo 11,12 $ a 11,85 $. Rozdiel tvoria hlavne kolá a to, čo každé kolo nesie. Hlavné session u A mali 172 a 144 kôl na Opuse s 24 až 28 miliónmi vstupných tokenov. U G to bolo 79 a 95 kôl s 13 až 16 miliónmi, a približne o 60 kôl viac odovzdalo Sonnet workerom, ktoré sa účtujú za zlomok ceny. G navyše dokončilo prácu za približne 21 minút oproti 45 minútam u A.
Dve veci na tomto grafe ma prekvapili. Žiadne pokyny vôbec nie sú lacná možnosť: jeho dve spustenia stáli 7,32 $ a 15,58 $ a to drahšie navyše neprešlo CI a napísalo najväčší diff v celom teste. A súbor s 5,5 KB bez skillov, F, nebol lacnejší než plné nastavenie. Napísal viac kódu, 1 601 produktových riadkov, a za to zaplatil. Úspora v G neprichádza len z krátkeho súboru. Prichádza z krátkeho súboru plus dvoch skillov, ktoré menia to, ako sa práca robí.
Prihláste sa na newsletter
Získajte najnovšie tipy, trendy a ponuky zadarmo.
Kvalita
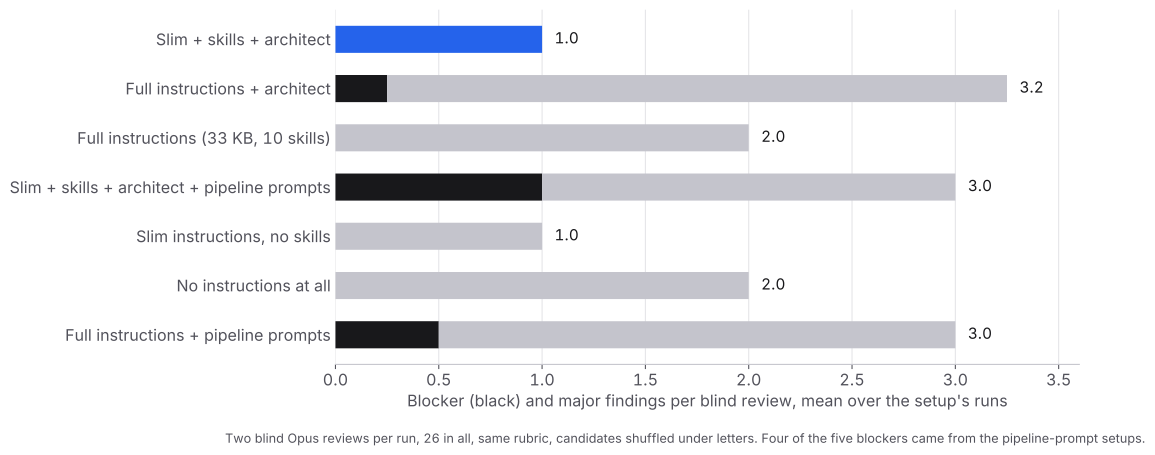
Najlacnejšie nastavenie malo aj najmenej vážnych nálezov: žiadne blockery a 1,5 a 0,5 nálezov typu major na recenziu pri svojich dvoch spusteniach. Plný CLAUDE.md, B, sa držal na 2,0 major nálezoch pri všetkých troch spusteniach, rovnako ako žiadny CLAUDE.md.
Toto je výsledok, ktorý ma zaujíma najviac. Súbor má dlhé sekcie o bezpečnosti, oprávneniach a kreditoch, napísané preto, že ich agent raz vynechal. S ním aj bez neho našli recenzenti rovnaký počet vážnych problémov a naprieč nastaveniami sa vracali tie isté druhy: registrovaný človek, ktorý zaplatí a potom zruší predplatné, e-mail stratený alebo poslaný dvakrát, keď worker zlyhá v polovici, editor, ktorý prepíše obsah, ktorý nedokáže zobraziť. To sú medzery v uvažovaní o stave v čase. Žiadny zoznam pravidiel v CLAUDE.md ich nepokrýval, pretože pravidlo pre edge case, na ktorý ste ešte nepomysleli, sa napísať nedá.
Pokryla ich zmena skillu architect medzi kolami. Skôr než hlavný model napíše akýkoľvek brief, teraz napíše tabuľku: každé akceptačné kritérium, čo sa stane, keď sa stav, od ktorého závisí, mení v čase, a rozhodnuté správanie. Každý riadok potom ide do briefu s pomenovaným testom. Spustenia G napísali 774 a 818 riadkov testov, oproti 510 až 670 u B.
Fáza plánovania
A a E sú dve nastavenia, ktoré spúšťali prompty nášho CI pipeline: plánovací prompt, ktorý napíše plán, a potom implementačný prompt, ktorý plán načíta a vykoná ho. Porovnajte každé s jeho dvojčaťom, ktoré dostalo namiesto toho obyčajný prompt. A stálo 11,49 $ na spustenie oproti 9,61 $ u B a malo blockery tam, kde B nemalo žiadne. E stálo 10,13 $ oproti 6,68 $ u G a malo blocker v každej svojej recenzii tam, kde G nemalo žiadny.
Myslím, že dôvod je ten, že plán je dokument, ktorý si model napíše sám pre seba a potom ho musí načítať späť ako vonkajší pokyn. Druhá session berie plán ako špecifikáciu, nasleduje ho aj tam, kde je nesprávny, a míňa kolá na jeho zosúlaďovanie s tým, čo nájde v kóde. Takto schopný model plánuje lepšie vnútri session, ktorá sa práve chystá robiť tú prácu, kde sú plán a kód v tom istom kontexte.
Časť plánovania, ktorá prežila, je brief. Keď hlavný model odovzdá kus práce Sonnet workerovi, worker začína s prázdnym kontextom a postaví presne to, čo mu povedia. To odovzdanie potrebuje písaný, rozhodnutý opis: cieľ, súbory, vzor na kopírovanie, edge casey, test, ktorý treba napísať. Plán pre seba je réžia navyše. Brief pre niekoho iného je jediný spôsob, ako sa práca odovzdá.
Čo urobil grain-ponytail
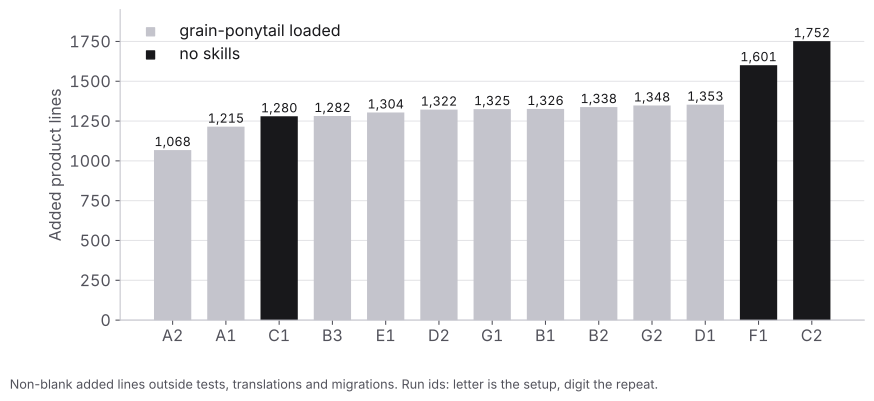
Skill z code with the grain hovorí modelu, aby kopíroval najbližší existujúci príklad a odovzdal najmenej kódu, ktorý funguje. Každé spustenie, ktoré ho malo načítaný, napísalo 1 068 až 1 353 produktových riadkov. Dva najväčšie diffy, 1 601 a 1 752, prišli zo spustení bez skillov. Jedno spustenie bez skillov zostalo na 1 280, takže skill sám o sebe neurčuje veľkosť, ale odstránil ten chvost.
Je to zároveň najjasnejší prípad toho, aký druh pokynu sa ešte vypláca. „Kopíruj najbližší príklad“ mení to, čo model robí pri každom súbore, ktorý napíše. „Používaj snake_case pre funkcie“ len opakuje niečo, čo už robí.
Čo recenzie ešte zachytili
Víťazné spustenie nebolo čisté. Po teste som rebasoval prácu G2 na main a poslal ju cez našu plnú PR kontrolu, ktorá recenzuje diff, každý nález dokazuje padajúcim testom a vedie zmenu v skutočnom prehliadači. Našla, že editor krokov zahodil každý blok okrem prvého HTML bloku, keď admin upravoval krok vytvorený cez MCP, a že neúspešné uvoľnenie claimu mohlo poslať niektorým používateľom e-mail dvakrát. Obe chyby sa opravili, s testami, než PR odišiel na ľudskú recenziu.
Slepí recenzenti tiež označili viac over-engineeringu v spusteniach s architectom než v tých s plnými pokynmi: 2,5 položky na recenziu u G oproti 0 až 1,0 u spustení A a B. Menej vážnych nálezov, viac nitov. Ten obchod by som bral, ale je to obchod.
Čo som zmenil
- 33 KB CLAUDE.md sa zmenil na 12 KB AGENTS.md, ktorý číta aj Codex, a CLAUDE.md ho teraz len importuje. Zachováva príkazy, kadenciu testov, architektúru a pravidlá, ktoré model nedokáže vyčítať z kódu, napríklad ktoré cesty sú kritické a že dve plochy agentov musia držať krok.
- Fáza plánovania z pipeline zmizla. Triage odovzdá issue priamo implementačnej fáze, ktorej prompt sa zúžil na šesť krokov: prečítaj issue, vytvor branch, načítaj skilly architect a grain-ponytail, testuj, commitni, otvor draft PR.
- Skill architect dostal tabuľku edge caseov, pole Tests v briefe a záverečný priechod, ktorý kontroluje celý diff voči issue a nie voči briefom. Tá verzia je verejná na github.com/LivinTribunal/architect-skill .
Zmena v repozitári je v čase písania v recenzii.
Čo si z toho odniesť
Ak váš CLAUDE.md rástol po jednom incidente, pravdepodobne platí za pravidlá, ktoré model už dodržiava. Zrežte ho na to, čo model nemôže zistiť čítaním kódu, a merajte pred a po na reálnej úlohe, namiesto toho, aby ste verili, že viac usmernenia je bezpečnejšie.
Nechajte si pokyny, ktoré menia to, ako sa práca robí: kto píše kód, ako sa briefuje kus práce, ktorý existujúci vzor kopírovať. Zahoďte pipeline plán-potom-vykonaj, ak je váš hlavný model súčasný frontier model. Píšte briefy pre workerov, nie plány pre seba.
Metodika
13 headless spustení Claude Code 2.1.289 dňa 5. októbra 2026, hlavný model Opus 5.5, workeri Sonnet 5.5 tam, kde ich delegoval skill architect. Všetky spustenia začali z jedného commitu monorepa FlowHunt, každé v APFS klone s vlastnou Postgres databázou, v sandboxe oddelenom od ostatných spustení aj od vlastných súborov experimentu. Broker posunul commit každého spustenia do draft PR voči zamrznutej základnej branchi a obnovil session s výsledkom CI, maximálne v troch kolách. Náklady sú maximálna total_cost_usd na session, sčítaná cez hlavnú session a jej subagentov. Produktové riadky sú neprázdne pridané riadky mimo testov, prekladov a migrácií.
Každý výsledok dostal dve slepé recenzie od Opusu s jednou rubrikou: správnosť, akceptačné kritériá, grain, privátne polia a skrytý stav, over-engineering, bezpečnosť a oprávnenia, testy, migrácie. Kandidáti boli premiešaní pod písmenami a recenzenti mohli čítať repozitár, ale nič nespúšťať. Nálezy na recenziu sú spriemerované cez spustenia daného nastavenia. Pri jednom až troch spusteniach na nastavenie berte priemer jedného nastavenia ako zašumený. Uvedené závery sú tie, ktoré vydržali v oboch kolách.
