


Den korta versionen
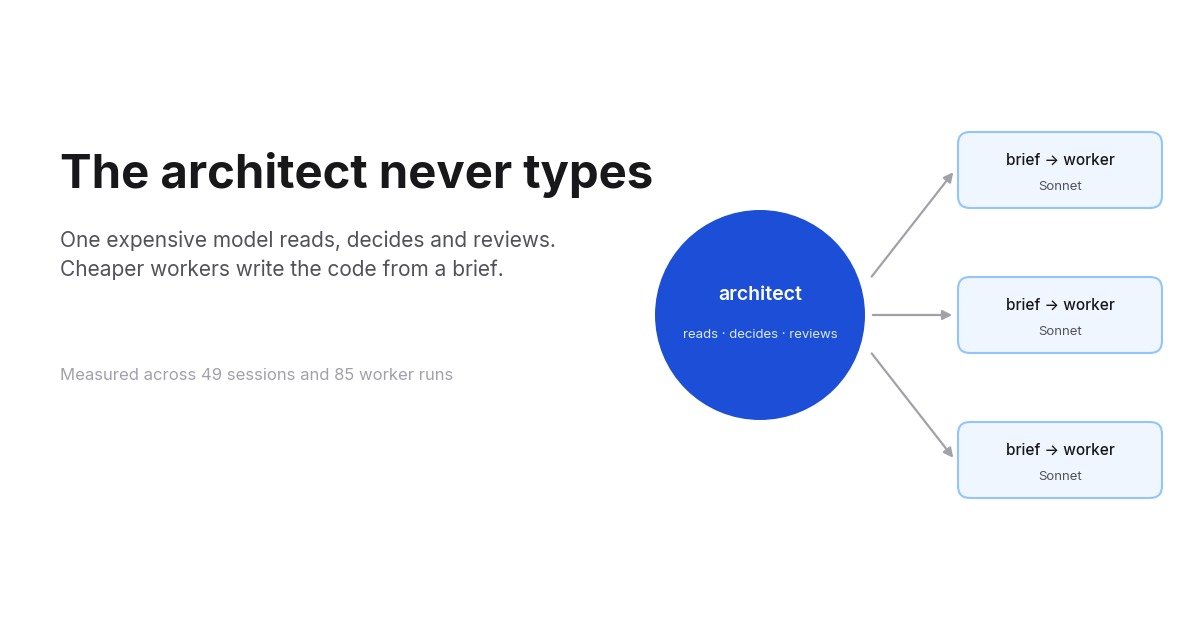
- I fem veckor körde jag min kodningsagent delad: huvudmodellen, Opus och senare Fable, läser, bestämmer och granskar, och en arbetaragent skriver koden utifrån en skriven brief. Jag kallar det arkitektmönstret och det är nu en publik skill: architect-skill på GitHub , MIT-licensierad.
- Huvudmodellen slutade skriva. Under 49 arkitektsessioner redigerade den en källfil 6 gånger på 1 467 prompts. I 275 vanliga sessioner under samma veckor redigerade den 244 filer på 3 081 prompts. Det är 0,4 mot 7,9 per 100 prompts.
- Totalt antal tokens per prompt sjönk inte. De steg, kraftigt, i två veckor, och kom sedan tillbaka till där vanliga sessioner ligger. Det som förändrades är vem som spenderade dem: Opus andel av arbetartokens gick från 100 % till omkring 4 %, och sedan 14 september kostar en prompt i en arkitektsession 364k viktade tokens på huvudmodellen, 205k på Sonnet-arbetare och 80k på Opus-arbetare.
- Den uppdelningen är vad en prenumeration bryr sig om. Claude Max mäter sin veckogräns för alla modeller till varje modells taxa, så en Sonnet-token drar den till 40 % av en Opus-token, och Fable har en egen, snävare veckogräns som ingen arbetare rör.
- Jag provade också att routa arbetarna till DeepSeek genom en headless Claude Code. Prissatt enligt listpris blev samma trafik $10 i stället för $202 på Sonnet eller $505 på Opus. På en prenumeration finns den besparingen inte, eftersom prenumerationen redan är betald. Jag släppte det. Om du betalar per token, läs det avsnittet ändå, för siffrorna är poängen.
Detta är tredje inlägget i en serie. Det första mätte vad en inställning gjorde med ett kontextfönster, 17 % färre tokens , och det andra förklarar vad ett kontextfönster kostar och varför. Det här handlar om den andra spaken: inte hur stort kontexten är, utan vilken modell som håller i den.
Vad mönstret är
En session med en kodningsagent gör två slags arbete. Den tänker: läser kodbasen, räknar ut vad som ska ändras, bestämmer namn och signaturer och kantfall, granskar diffen. Och den skriver: skriver koden, kör testfilen, fixar lint. Tänkandet är där en frontiermodell förtjänar sitt pris. Skrivandet är det inte. Det mesta avgörs av beslutet som kom före, och en mindre modell utför en bestämd plan ungefär lika bra som en stor.
Så skillen delar sessionen. Huvudmodellen är arkitekten. Den gör allt i huvudloopen utom att redigera en källfil:
- Förhör kravet och utforskar kodbasen.
- Fattar designbesluten: angreppssätt, dataflöde, namn, signaturer, kantfall. Det närmaste befintliga mönstret att spegla. Den minsta ändring som åtgärdar grundorsaken.
- Delar upp i arbetsdelar som äger disjunkta filuppsättningar.
- Skriver en implementationsbrief per arbetsdel.
- Granskar diffen som kommer tillbaka, kör grindarna, committar.
Arbetaren är en subagent med ett färskt kontextfönster. Den får briefen och inget annat, skriver koden, kör de testfiler som briefen namnger och returnerar en kort strukturerad rapport. Sedan kastas dess kontext. Den blir aldrig en del av huvudsessionens historik, vilket betyder mer än det låter: allt huvudsessionen läser skickas igen vid varje senare anrop, så en arbetare som läser tolv filer och en testlogg i sin egen kontext håller allt det borta från arkitektens räkning.
Briefen är hela kontraktet. Min har sju fält och skillen handlar mest om att fylla dem väl:
## Implementation brief: <slice>
Goal: one sentence, observable outcome
Context: what exploration found: excerpts, the pattern to mirror, line anchors, gotchas
Files: paths to create/modify, exclusive ownership for this slice
Design: the decided approach: data flow, names, signatures, edge cases
Constraints: project rules that apply: style, layers, security
Out of scope: what not to touch, including files owned by other slices
Verify: exact commands and expected outcome
En brief innehåller beslut, inte alternativ. Om jag fortfarande väger två angreppssätt mot varandra är jag inte redo att delegera.
Det finns ett undantag. Delegering har en fast overhead: skriva briefen, starta arbetaren, läsa rapporten, granska diffen. En stavfelrättning, ett konfigvärde, en versionsbump, borttagning av en död nyckel, en enradsfix och dess regressionstest: för dem redigerar arkitekten direkt, eftersom briefen skulle kosta mer än redigeringen. Testet är kostnad, inte radantal. I samma stund som redigeringen kräver en designbedömning eller rör en sökväg som repot flaggar som kritisk, går den till en arbetare.

Redo att växa ditt företag?
Starta din kostnadsfria provperiod idag och se resultat inom några dagar.
Varför en prenumeration ändrar kalkylen
Om du betalar per token är saken enkel. Opus 5 listas på $5 per miljon inputtokens och $25 per miljon output; Sonnet 5 på $2 och $10. Varje token implementation som flyttas från Opus till Sonnet kostar 40 % av vad den gjorde.
Jag betalar en prenumeration, och där är saken annorlunda och, tror jag, starkare. Claude Max har två veckogränser, inte en: en gräns över alla modeller, som varje token drar på sin modells taxa, och en separat, snävare gräns som bara Fable drar på. Opus har ingen egen gräns. Det ger uppdelningen två effekter. Arbete som en Sonnet-arbetare gör drar den delade gränsen till 40 % av taxan en Opus-arbetare skulle göra, så att flytta två tredjedelar av en sessions tokens till Sonnet gör att veckan räcker längre även om det totala antalet tokens är oförändrat. Och när arkitekten är Fable är varje token den inte spenderar på att skriva en token kvar på den gräns som tar slut först. Så även om arkitektmönstret spenderade exakt lika många tokens som en vanlig session, skulle vem som spenderar dem fortfarande avgöra när veckan tar slut.
Det där “även om” visade sig göra ett stort jobb.
Vad transkripten säger
Claude Code skriver varje session till ett JSONL-transkript, och varje arbetarkörning till en systerfil under sessionens katalog. Jag har alla sedan 19 augusti: 324 interaktiva sessioner med tre eller fler prompts, varav 49 använde mönstret, det vill säga de startade en implementeraragent eller skickade en brief till en. Tokens viktas som räkningen: färsk input 1, cacheskrivningar 1,25 eller 2, cacheläsningar 0,1. CI-körningar är uteslutna.
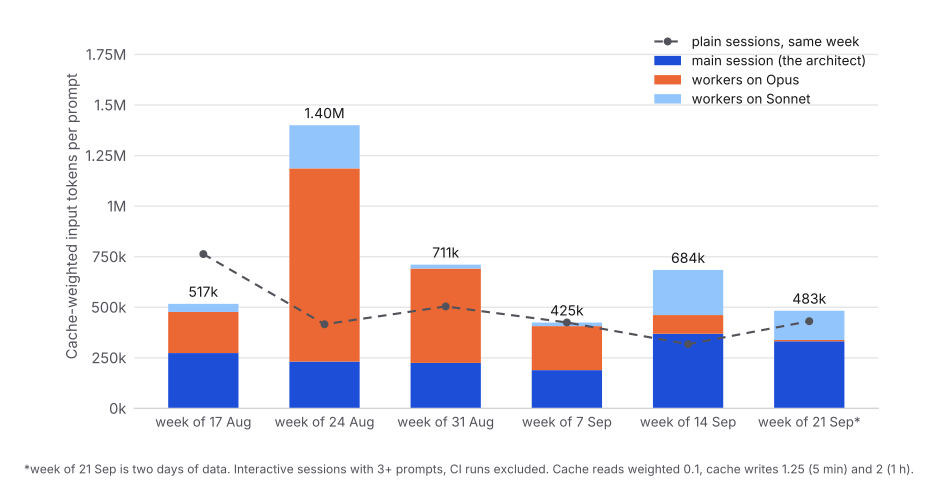
Läs den från vänster till höger och det är inte en framgångssaga de första två veckorna.
I veckan den 24 augusti kostade en arkitektsession 1,40M viktade tokens per prompt. Vanliga sessioner samma vecka kostade 0,42M. Tre och en halv gånger mer, och nästan allt överskott var orange: Opus-arbetare. Jag hade gett arbetarna en bra modell och inga regler, och de betedde sig som en bra modell utan regler. Medianen för en Opus-arbetarkörning den veckan var 176 turer. Flera körde hela backend-testsviten, vilket lägger ungefär 100 KB output i ett kontext som skickas igen vid varje tur efteråt. En session med sex arbetare den 14 september, efter att jag redan börjat strama åt, brände fortfarande 245M inputtokens över 1 585 turer för att producera ungefär sex tusen rader diff. Prompt-cachning fungerade med 91,6 % träffsäkerhet hela tiden. Räkningen var volym, inte prissättning.
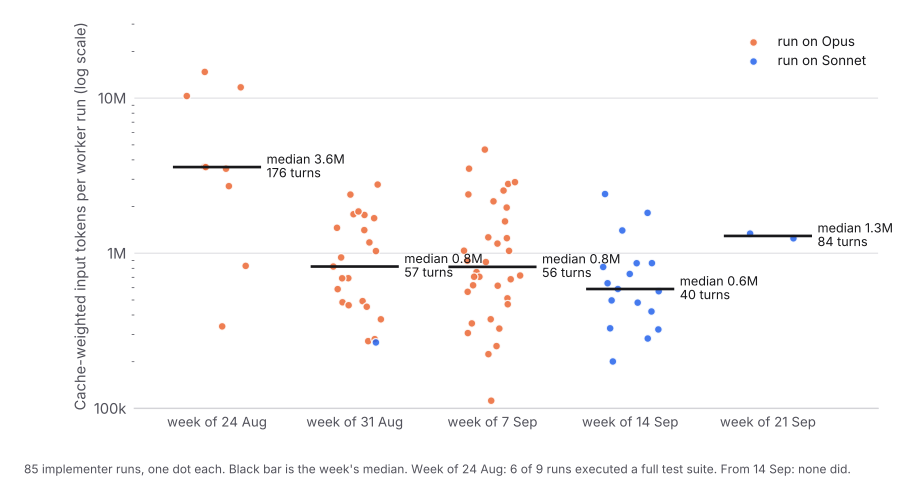
Arbetarstapeln visar var reglerna landade. Tre av dem gjorde det mesta av jobbet, och jag skrev in dem i agentdefinitionerna i stället för i briefen, så de gäller vare sig jag kommer ihåg dem eller inte:
- En arbetare kör aldrig en full testsvit. Den kör de testfiler som dess brief namnger. Arkitekten kör grindarna.
maxTurnsär begränsat i agentdefinitionen, 140 för Sonnet och 160 för Opus. En arbetsdel som behöver 250 turer var briefad fel.- En arbetsdel håller sig under ungefär tolv filer, och briefen under ungefär 8 KB. Briefen skickas också igen varje tur.
I veckan den 31 augusti var medianen för en arbetarkörning 57 turer och 0,8M viktade tokens. Från den 14 september, när jag flyttade standardrutten till Sonnet, var den 40 turer och 0,6M, och ingen arbetare har kört en full svit sedan dess.
Totalen per prompt följde efter: 711k, 425k, 684k, 483k under de senaste fyra veckorna, mot vanliga sessioner på 505k, 425k, 318k, 431k. Arkitektsessioner kostar nu ungefär vad vanliga sessioner kostar. Något mer i två av de fyra veckorna, något mindre i en. Vad de köper för det är de två nästa diagrammen.
Gå med i vårt nyhetsbrev
Få de senaste tipsen, trenderna och erbjudandena gratis.
Huvudmodellen slutade skriva
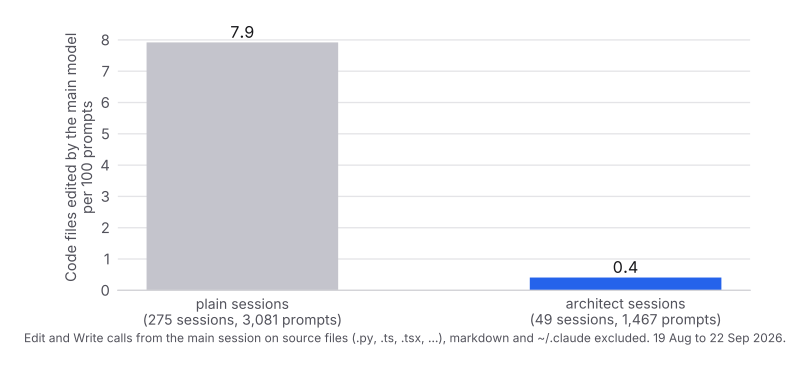
Det här är talet jag ville ändra och det ändrades. I vanliga sessioner gjorde huvudmodellen 244 Edit- eller Write-anrop på källfiler över 3 081 prompts. I arkitektsessioner gjorde den 6 över 1 467. De 6 är alla undantag för små redigeringar som jag kan redogöra för.
Under tiden var arbetarna produktiva. De 85 arbetarkörningarna gjorde 2 510 källfilsredigeringar. Räknar man huvudloop och arbetare tillsammans producerade en arkitektsession 2 516 kodredigeringar från 1 467 prompts; vanliga sessioner producerade 943 från 3 081. Per kodredigering spenderade en arkitektsession 403k viktade tokens totalt och 330k på Opus-familjens modell. En vanlig session spenderade 1 410k och 1 324k. Jag vill vara försiktig med den jämförelsen, eftersom de två populationerna inte är samma arbete: en session klassas som arkitekt genom att delegera kod, så arkitektsessioner är kodtunga per konstruktion, och vanliga sessioner inkluderar research, granskningar och felsökning som aldrig redigerar något. Läs det som “mönstret får mycket kod skriven per token”, inte som ett påstående om fyra gånger effektivitet.
Det renare påståendet är modelluppdelningen. Sedan 14 september kostar en prompt i en arkitektsession 364k viktade tokens i huvudloopen, 205k i Sonnet-arbetare och 80k i Opus-arbetare. Opus-arbetarnas andel av alla arbetartokens var 100 % i augusti och omkring 4 % i veckan den 21 september. På ett Max-abonnemang är det den delade veckogränsen som dras på Sonnets taxa i stället för Opus för nästan allt implementationsarbete, och inget av det rör Fable-gränsen.
Två saker blev inte bättre, och jag säger hellre det än låter diagrammen antyda något annat. Huvudsessionens egen kontext krympte inte: arkitektsessioner komprimerade 8,7 gånger per 100 prompts mot 4,7 för vanliga sessioner, eftersom arkitekten läser mycket innan den briefar. Och mönstret är långsammare i väggklockstid på små uppgifter, eftersom en arbetares uppstart och rapport är minuter du inte betalar när du bara gör redigeringen. Undantaget för små redigeringar finns för att den första versionen av skillen inte hade något, och jag såg mig själv skriva en 3 KB brief för en tvåradig ändring.
DeepSeek-avstickaren
När arbetarna var Sonnet var nästa uppenbara fråga om de alls måste vara en Claude-modell. Från 13 till 18 september pekade jag arbetaren mot DeepSeek V4.1 Flash genom en headless Claude Code med ANTHROPIC_BASE_URL satt till en kompatibel endpoint, först genom OpenRouter och sedan nativt. Samma briefformat, samma rapportformat, samma arkitekt. 2 732 anrop, 431M inputtokens varav 88 % var cacheläsningar, 1,7M outputtokens.
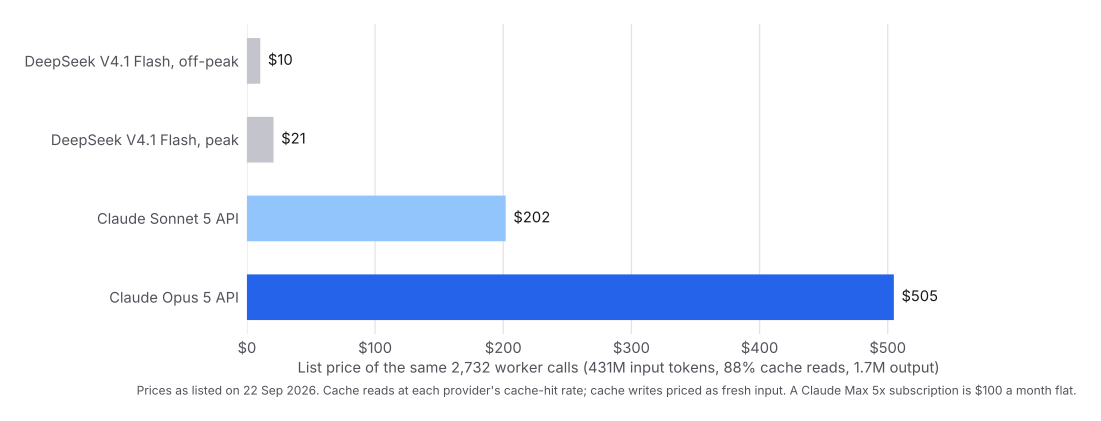
Till listpriser den 22 september kostar den trafiken omkring $10 på DeepSeek off-peak, $21 vid peak, $202 på Sonnet-API:t och $505 på Opus-API:t. Om jag betalade per token skulle detta vara inläggets rubrik och jag skulle ha behållit det.
Jag betalar inte per token, och det är hela argumentet. En Max-prenumeration kostar $100 i månaden oavsett om jag använder 30 % av veckogränsen eller 100 %. Att flytta arbetartrafik till DeepSeek sänkte inte den räkningen med en cent. Den lade till en andra räkning på $10 till $21 i veckan ovanpå den, för att spara kapacitet på en plan vars kapacitet jag redan hade betalat för. Jag hade förväxlat “billigare än API:t” med “billigare än vad jag betalar”, och de är inte samma sak när det du betalar är fast. Den rätta jämförelsen för en prenumerant är DeepSeek mot en andra prenumeration, och där kostar en andra Claude-plan eller en ChatGPT-plan med Codex ungefär lika mycket som en månad av måttlig DeepSeek-användning och kommer med sin egen veckogräns, sin egen modell och ingen mätning att hålla koll på.
Kvaliteten var den andra halvan. Fem backend-arbetsdelar kom tillbaka rena och committades som de var. En frontend-arbetsdel tog bort en exporterad symbol och lämnade varje konsument av den orörd, så trädet kompilerade inte och en senare arbetsdel fick städa upp. Det är precis det misslyckande en modell som utför en specifikation har och en modell som sluter sig till en komponents form utifrån dess syskon inte har, och skillen säger det nu: ändringar i delade API-ytor går till Sonnet, och arbetarregeln lyder “ta aldrig bort eller döp om en exporterad symbol utan att migrera varje konsument i samma körning”. DeepSeek Flash är en bra utförare. Arkitektmönstret behöver en arbetare som märker när briefen underskattade konsumenterna, och det är det enda en brief inte kan leverera.
Så dagens routingtabell har två rader. Rutinarbete, backend-arbete mot en detaljerad brief med tester att uppfylla, frontend-arbete som följer en befintlig designgrammatik, och varje ändring av en delad API-yta går till sonnet-implementer. Arbete vars svårighet ligger i resonemanget går till opus-implementer: ett asynkront race, en refaktorering på flera ställen vars korrekthet beror på ställen som briefen inte kan räkna upp, en backfill-migrering som ingen enskild test bevisar. Routa efter form, aldrig efter risk. Risk ändrar hur hårt diffen granskas och om en människa signerar den. Den ändrar aldrig vem som skriver den.
Granskningsloopen, där mönstret förtjänar eller förlorar sitt värde
En arbetares rapport är ett påstående. Skillens granskningsloop är kort och varje rad kommer från att ha blivit bränd:
- Läs rapporten och den faktiska
git diff. Korsgranska den diffstatistik arbetaren citerar mot den du ser. - Kör om den viktigaste verifieringen själv när påståendet spelar roll.
- Hittade du ett problem? Skicka rättelsen till samma arbetare. Den har fortfarande sin kontext och fortsätter där den slutade. Fixa inte för hand, starta inte om.
- Två misslyckade rättelser betyder att briefen var underspecificerad, inte att modellen är för liten. Dela upp, lägg in det saknade utdraget i Context, kör igen. Klättra inte till en större modell, för den kommer att implementera samma missförstånd mer flytande.
- Kör de avgränsade grindarna innan du accepterar något: de berörda testerna, linter på de berörda filerna, vilket konventionsskript repot än har.
I transkripten skickade jag ungefär en rättelse per arbetarkörning, 52 över 85 körningar, och 7 Opus-körningar nådde sin gräns på 160 turer, alla på en arbetsdel jag nu skulle dela upp. Det är de två talen jag följer. Om rättelser per körning ökar blir mina briefar latare. Om arbetare når taket är mina arbetsdelar för stora.
Vad du ska ta med dig
Om du betalar per token: sätt den dyra modellen på beslut och granskning, sätt en billig på implementation, och prissätt din arbetartrafik enligt listpris innan du väljer vilken billig. Diagrammet med fyra staplar är argumentet.
Om du betalar en prenumeration: mönstret sänker inte ditt tokental. Det flyttar implementationstokens till den modell som drar den delade veckogränsen långsammast, behåller Fable-gränsen för det arbete bara Fable bör göra, och hindrar din dyraste modell från att spendera sina turer på att skriva. Lägg inte till ett mätt API vid sidan om för att “spara” kapacitet du redan köpt. Om du får slut på arbetarkapacitet, köp en andra prenumeration.
Hur som helst var reglerna som fick det att fungera de tråkiga. Inga fulla testsviter i en arbetare. Begränsa turerna. Små arbetsdelar, korta briefar. Rätta samma arbetare en gång, fixa sedan briefen.
Skillen, de tre agentdefinitionerna och guard-hooken finns på github.com/LivinTribunal/architect-skill under MIT. Den medföljande skillen som berättar för arbetaren hur den skriver kod som matchar repot den landar i är grain-skill , och inlägget om den är kod med fiberriktningen .
Metod
Allt som inlägget beskriver finns i github.com/LivinTribunal/architect-skill : skillen själv, briefmallen, routingtabellen, de tre implementeraragentdefinitionerna med sina turtak och kontextregler, och guard-hooken. Installera den och du har uppsättningen som siffrorna nedan kommer från.
Sessioner är Claude Code JSONL-transkript från 19 augusti till 22 september 2026, entrypoint cli, tre eller fler användarprompts. En session klassas som arkitekt om den startade opus-implementer, opus-implementer-xhigh eller sonnet-implementer, körde en ds-slice-arbetare, anropade arkitektskillen, eller skickade ett meddelande som innehöll en implementationsbrief till en general-purpose-agent, vilket är hur de tidiga veckorna fungerade innan de namngivna agenterna fanns. Arbetarkörningar är subagenttranskripten under varje sessions katalog. Användning avdubblas per request id och viktas färsk input 1, femminuters cacheskrivning 1,25, en timmes cacheskrivning 2, cacheläsning 0,1. “Kodredigering” är ett Edit- eller Write-anrop på en .py-, .ts-, .tsx-, .js-, .sql- eller liknande källfil, exklusive markdown och allt under ~/.claude. DeepSeek-prissättning är nativt listpris den 22 september 2026, off-peak och peak, med cacheläsningar till cache-hit-taxan och cacheskrivningar prissatta som färsk input; Claude API-priser är de publicerade listpriserna för Opus 5 och Sonnet 5 med cacheläsningar till en tiondel av input. Veckan den 21 september är två dagars data.
