


Den korta versionen
- Jag tog ett verkligt ärende från FlowHunts backlog och lät Claude Code implementera det 13 gånger på Opus 5.5, under sju olika instruktionsuppsättningar. Varje körning startade från samma commit, i sin egen klon med sin egen databas, och gick genom vår riktiga GitHub-CI. Två blinda Opus-granskningar betygsatte varje resultat.
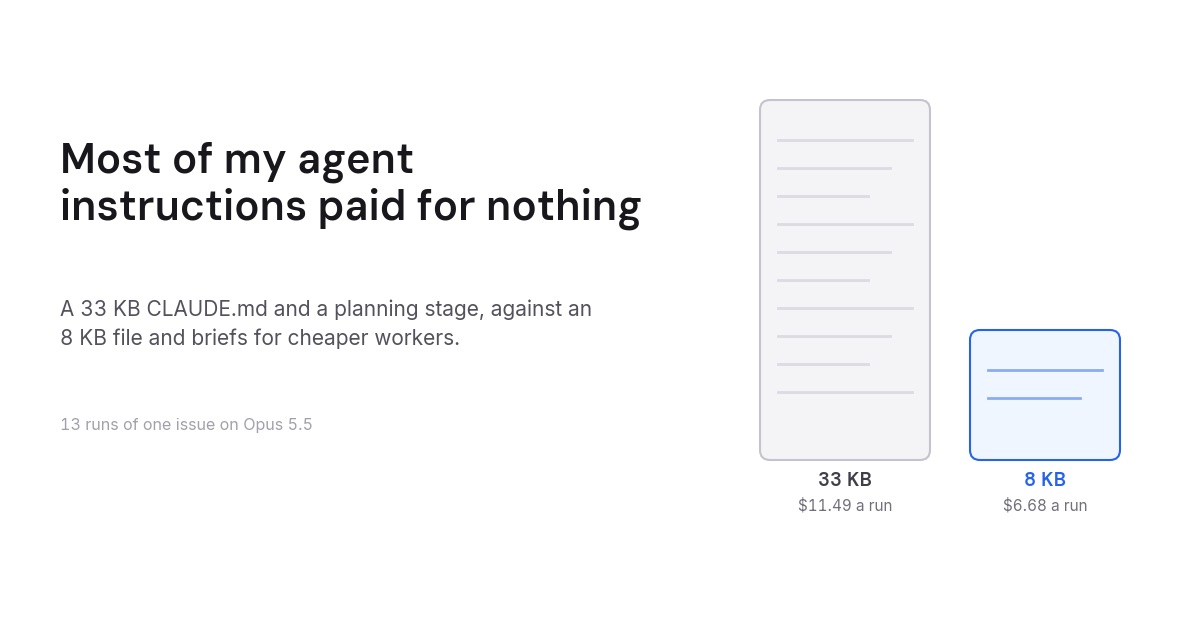
- Repots CLAUDE.md på 33 kB köpte ingen mätbar kvalitet. Körningar med den fick 2,0 blockerande och allvarliga anmärkningar per granskning. En körning helt utan instruktionsfil fick samma. En fil på 5,5 kB fick 1,0.
- Ett separat planeringssteg gjorde saker sämre. Båda uppsättningarna som körde en planeringsprompt och sedan en implementationsprompt kostade mer än deras tvillingar med vanlig prompt, och de stod för fyra av de fem blockerarna i alla 26 granskningar.
- Vinnaren var en CLAUDE.md på 8 kB, tre skills, Sonnet-arbetare och en vanlig prompt. Dess två körningar kostade i snitt 6,68 dollar enligt API-listpris. Den fulla uppsättningen med pipeline-prompterna kostade i snitt 11,49 dollar, ungefär 1,7 gånger så mycket, och hade fler anmärkningar.
- Det som överlevde av all struktur jag hade byggt är briefen: en kort, beslutad beskrivning av en avgränsad del av arbetet som huvudmodellen skriver för en billigare arbetare. Planer för huvudmodellen själv lönade sig inte. Modellen planerar bra på egen hand.
Det här följer på inlägget om architect pattern , som mätte vem som bör skriva koden. Det här inlägget frågar hur mycket huvudmodellen behöver få veta innan den börjar.
Varför jag körde det
Vårt monorepo hade samlat på sig en massa agentinstruktioner. Rot-CLAUDE.md var 33 kB: byggkommandon, testkadens, kodstil, arkitektur, kritiska sökvägar, säkerhetsregler, behörighets- och kreditregler, de två agentytskikten, ärendehantering, PR-konventioner. Tio skills låg under .claude/skills/. Ovanpå det körde vår CI-pipeline (vi kallar den harnext) ett ärende genom en taggare, ett triagesteg, ett planeringssteg som skrev en plan som en ärendekommentar, och ett implementationssteg som läste planen tillbaka och skrev koden, var och en med sin egen långa systemprompt.
Varje rad i det där lades till av en anledning, oftast efter att en agent hade gjort något fel. Frågan ingen hade ställt var om det fortfarande hjälpte. En CLAUDE.md laddas in i varje session och skickas igen vid varje tur. Om modellen ändå skulle ha gjort rätt sak är de tokens en skatt, och som vad ett kontextfönster kostar förklarar, växer en skatt på varje tur snabbare än det ser ut.

Redo att växa ditt företag?
Starta din kostnadsfria provperiod idag och se resultat inom några dagar.
Testet
Ärendet var ett tidsstyrt e-postflöde för nya registreringar: en administratör definierar steg som “dag 0: välkommen” och “dag 5: din provperiod tar snart slut”, och en bakgrundsuppgift mejlar varje konto på rätt dag, stoppar när personen köper ett betalpaket och hoppar över konton som skapades före lanseringen. Det kräver en migrering, ett repository, en service, en Celery beat-uppgift, REST-endpoints, MCP-verktyg för agenter och ett konsolgränssnitt på 11 språk. Det är en realistisk funktion för vecka ett, och den har flera kantfall som är lätta att missa.
Varje körning var en headless Claude Code-session på Opus 5.5, sandboxad till sin egen klon och databas, med ett skript som pushade dess commit till en draft-PR och matade tillbaka CI-resultatet till sessionen, upp till tre rundor. Kostnaden är Claude Codes egen total_cost_usd för huvudsessionen plus varje subagent, prissatt enligt API-listpris. Jag betalar en prenumeration, så det här är ett mått på arbete, inte på min räkning.
De sju uppsättningarna:
| Uppsättning | Körningar | |
|---|---|---|
| A | Fullständig CLAUDE.md på 33 kB och tio skills, pipeline-prompter (planera, sedan implementera) | 2 |
| B | Fullständig CLAUDE.md och skills, vanlig prompt | 3 |
| C | Ingen CLAUDE.md, inga skills, vanlig prompt | 2 |
| D | Fullständig CLAUDE.md plus architect-skillen, vanlig prompt | 2 |
| E | CLAUDE.md på 8 kB, architect, grain-ponytail och unslop, pipeline-prompter | 1 |
| F | CLAUDE.md på 5,5 kB, inga skills, vanlig prompt | 1 |
| G | CLAUDE.md på 8 kB, architect, grain-ponytail och unslop, vanlig prompt | 2 |
A till D kom först. E till G byggdes utifrån vad de visade, och den tredje B-körningen gick vid sidan av dem som kontroll. Filen på 8 kB är den på 5,5 kB plus en kort lista över skillsen och när de ska laddas, samt modellroutningsreglerna som gör att architect-skillen delegerar till Sonnet.
Varje resultat gick sedan till två Opus-granskare som bara såg en bokstav, diffen, repot och ärendet. De listade varje ändring de skulle begära innan de godkände, graderade blocker, allvarlig, mindre eller nit, och kontrollerade varje acceptanskriterium mot en fil och rad.
Kostnad
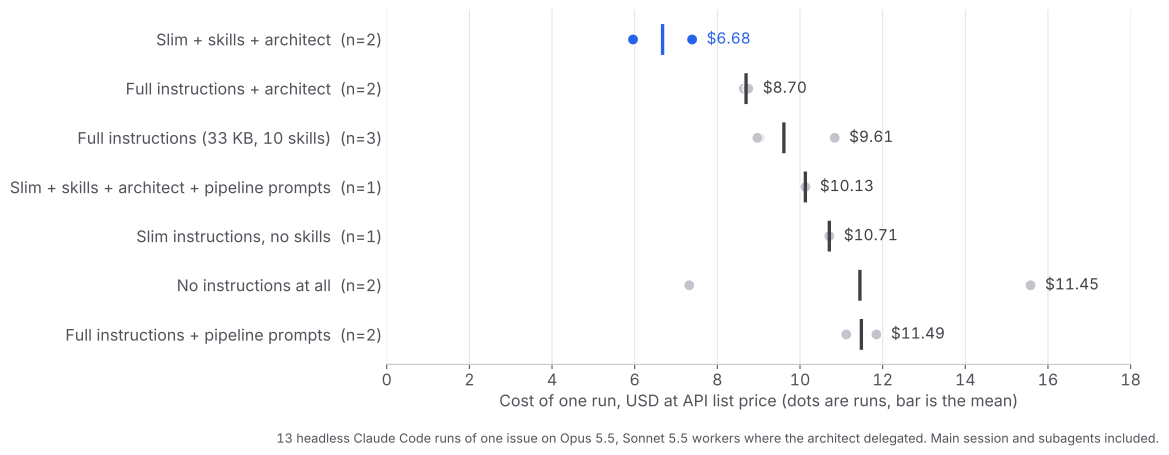
Den vinnande uppsättningen, G, kostade 5,96 och 7,39 dollar. Den fulla uppsättningen med pipeline-prompter, A, kostade 11,12 och 11,85 dollar. Gapet består mest av turer och vad varje tur bär med sig. A:s huvudsessioner körde 172 och 144 turer på Opus med 24 till 28 miljoner indatatokens. G:s körde 79 och 95 turer med 13 till 16 miljoner, och lämnade ungefär 60 fler turer till Sonnet-arbetare, som faktureras till en bråkdel av priset. G blev också klar med sitt arbete på ungefär 21 minuter mot A:s 45.
Två saker på det här diagrammet förvånade mig. Inga instruktioner alls är inte det billiga alternativet: dess två körningar kostade 7,32 och 15,58 dollar, och den dyra misslyckades dessutom med CI och skrev testets största diff. Och filen på 5,5 kB utan skills, F, var inte billigare än den fulla uppsättningen. Den skrev mer kod, 1 601 produktrader, och betalade för det. Besparingen i G kommer inte bara från den korta filen. Den kommer från den korta filen plus de två skills som ändrar hur arbetet görs.
Gå med i vårt nyhetsbrev
Få de senaste tipsen, trenderna och erbjudandena gratis.
Kvalitet
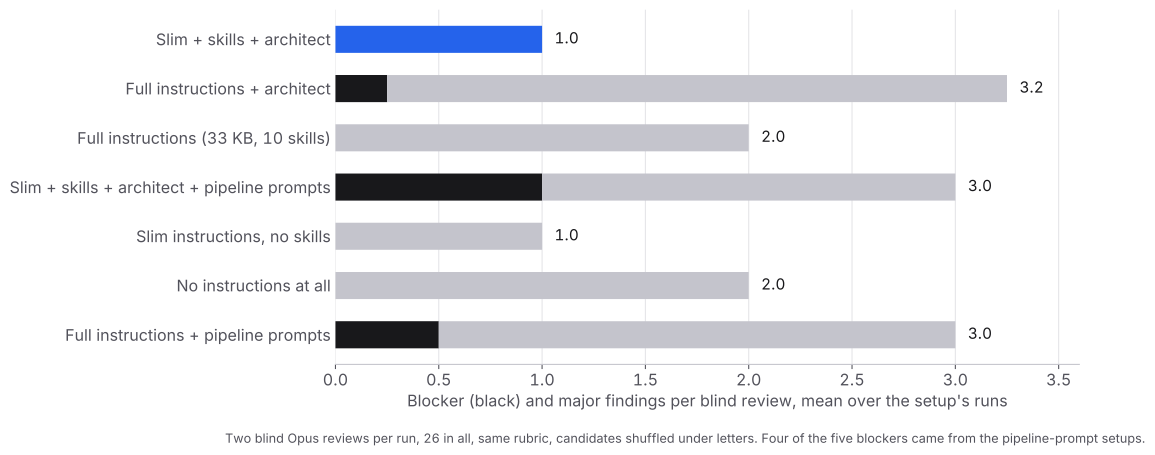
Den billigaste uppsättningen hade också minst antal allvarliga anmärkningar: inga blockerare, och 1,5 respektive 0,5 allvarliga per granskning på sina två körningar. Den fulla CLAUDE.md, B, låg på 2,0 allvarliga på alla tre sina körningar, samma som ingen CLAUDE.md alls.
Det här är resultatet jag bryr mig mest om. Filen har långa avsnitt om säkerhet, behörigheter och krediter, skrivna för att en agent en gång hoppade över dem. Med eller utan filen hittade granskarna samma antal allvarliga problem, och samma typer återkom över uppsättningarna: en registrering som betalar och sedan avbryter, ett e-postmeddelande som tappas bort eller skickas två gånger när en arbetare misslyckas halvvägs, en editor som skriver över innehåll den inte kan visa. Det är resonemangsluckor om tillstånd över tid. Ingen regellista i CLAUDE.md täckte dem, för man kan inte skriva en regel för ett kantfall man ännu inte har tänkt på.
Det som täckte dem var en ändring i architect-skillen mellan omgångarna. Innan huvudmodellen skriver någon brief skriver den nu en tabell: varje acceptanskriterium, vad som händer när tillståndet det beror på ändras över tid, och det beslutade beteendet. Varje rad går sedan in i briefen med ett namngivet test. G:s körningar skrev 774 och 818 testrader, mot 510 till 670 för B.
Planeringssteget
A och E är de två uppsättningarna som körde vår CI-pipelines prompter: en planeringsprompt som skriver en plan, sedan en implementationsprompt som läser planen och utför den. Jämför var och en med sin tvilling som fick en vanlig prompt i stället. A kostade 11,49 dollar per körning mot B:s 9,61 och hade blockerare där B inte hade några. E kostade 10,13 mot G:s 6,68 och hade en blockerare i var och en av sina granskningar där G inte hade någon.
Jag tror att orsaken är att en plan är ett dokument som modellen skriver till sig själv och sedan måste läsa tillbaka som en utomstående instruktion. Den andra sessionen behandlar planen som en specifikation, följer den där den är fel och lägger turer på att förena den med vad den hittar i koden. En modell med den här förmågan planerar bättre inne i sessionen som ska göra arbetet, där planen och koden finns i samma kontext.
Den del av planeringen som överlevde är briefen. När huvudmodellen lämnar en avgränsad del till en Sonnet-arbetare startar arbetaren med en tom kontext och bygger exakt det den blir tillsagd. Den överlämningen behöver en skriftlig, beslutad beskrivning: målet, filerna, mönstret att spegla, kantfallen, testet att skriva. En plan för sig själv är overhead. En brief till någon annan är det enda sättet arbetet tar sig över.
Vad grain-ponytail gjorde
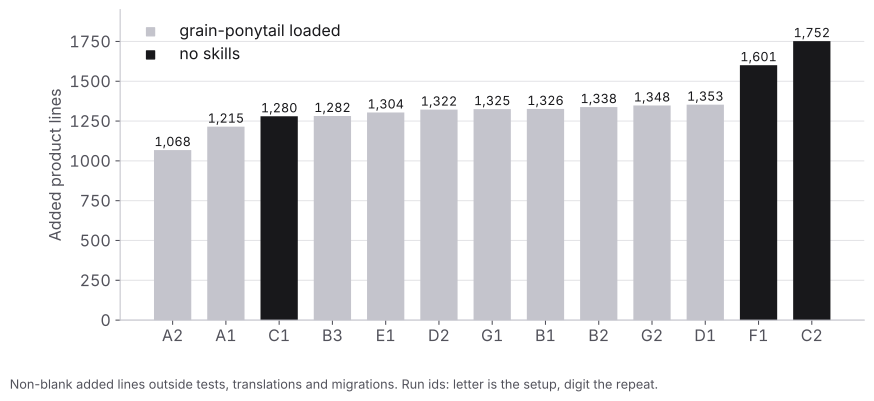
Skillen från code with the grain säger åt modellen att spegla närmaste befintliga exempel och leverera minsta möjliga kod som fungerar. Varje körning som hade den laddad skrev mellan 1 068 och 1 353 produktrader. De två största diffarna, 1 601 och 1 752, kom från körningar utan skills. En körning utan skills stannade på 1 280, så skillen avgör inte storleken på egen hand, men den tog bort svansen.
Det är också det tydligaste exemplet på vilken sorts instruktion som fortfarande lönar sig. “Spegla närmaste exempel” ändrar vad modellen gör i varje fil den skriver. “Använd snake_case för funktioner” upprepar något den redan gör.
Vad granskningarna fortfarande fångade
Den vinnande körningen var inte felfri. Efter testet rebasade jag G2:s arbete på main och körde det genom vår fullständiga PR-kontroll, som granskar diffen, bevisar varje anmärkning med ett fallerande test och driver ändringen i en riktig webbläsare. Den hittade att stegredigeraren tappade varje block utom det första HTML-blocket när en administratör redigerade ett steg som skapats via MCP, och att en misslyckad anspråksfrisläppning kunde mejla vissa användare två gånger. Båda åtgärdades, med tester, innan PR:en gick upp för mänsklig granskning.
Blindgranskarna flaggade också mer överkonstruktion i architect-körningarna än i de med fullständiga instruktioner: 2,5 poster per granskning för G mot 0 till 1,0 för körningarna av A och B. Färre allvarliga anmärkningar, fler nitar. Jag skulle ta den affären, men det är en affär.
Vad jag ändrade
- CLAUDE.md på 33 kB blev en AGENTS.md på 12 kB som Codex också läser, och CLAUDE.md importerar nu bara den. Den behåller kommandona, testkadensen, arkitekturen och de regler en modell inte kan sluta sig till från koden, som vilka sökvägar som är kritiska och att de två agentytskikten måste hållas i takt.
- Planeringssteget är borta från pipelinen. Triage lämnar ärendet direkt till ett implementationssteg vars prompt krympte till sex steg: läs ärendet, skapa en branch, ladda architect- och grain-ponytail-skillsen, testa, committa, öppna en draft-PR.
- Architect-skillen fick kantfallstabellen, ett Tests-fält i briefen och en sista genomgång som kontrollerar hela diffen mot ärendet i stället för mot briefarna. Den versionen är offentlig på github.com/LivinTribunal/architect-skill .
Repoändringen ligger under granskning när detta skrivs.
Vad man kan ta med sig
Om din CLAUDE.md växte fram en incident i taget betalar den förmodligen för regler som modellen redan följer. Skär ner den till det modellen inte kan ta reda på genom att läsa koden, och mät före och efter på en verklig uppgift i stället för att lita på att mer vägledning är säkrare.
Behåll de instruktioner som ändrar hur arbetet görs: vem som skriver koden, hur en avgränsad del briefas, vilket befintligt mönster som ska kopieras. Släpp planera-sedan-utföra-pipelinen om din huvudmodell är en aktuell frontier-modell. Skriv briefar till arbetare, inte planer till dig själv.
Metod
13 headless-körningar av Claude Code 2.1.289 den 5 oktober 2026, huvudmodell Opus 5.5, arbetare Sonnet 5.5 där architect-skillen delegerade. Alla körningar startade från en commit av FlowHunt-monorepot, var och en i en APFS-klon med sin egen Postgres-databas, sandboxad från de andra körningarna och från experimentets egna filer. En broker pushade varje körnings commit till en draft-PR mot en fryst basbranch och återupptog sessionen med CI-resultatet, upp till tre rundor. Kostnaden är maximal total_cost_usd per session, summerad över huvudsessionen och dess subagenter. Produktrader är icke-tomma tillagda rader utanför tester, översättningar och migreringar.
Varje resultat fick två blinda granskningar av Opus med en enda rubric: korrekthet, acceptanskriterier, grain, privata fält och dolt tillstånd, överkonstruktion, säkerhet och behörigheter, tester, migreringar. Kandidaterna blandades under bokstäver, och granskarna kunde läsa repot men inte köra något. Anmärkningar per granskning är medelvärden över en uppsättnings körningar. Med en till tre körningar per uppsättning bör man se en enskild uppsättnings medelvärde som brusigt. Slutsatserna ovan är de som höll i båda omgångarna.
